IA First · Episódio 21
Treinando Modelos Proprietários: Quando Vale a Pena e o Que Você Não Está Vendo na Conta
Quando treinar ou fazer fine-tuning de um modelo próprio compensa, e os custos de dataset, MLOps, equipe e infraestrutura que a planilha esquece.
Neste artigo · 10 seções
A pergunta que aparece cedo demais
Em algum momento, em toda empresa que coloca IA em produção, alguém da liderança pergunta: "a gente não deveria treinar nosso próprio modelo?" A pergunta vem geralmente carregada de boas intenções: independência de provedor, dado proprietário, custo em escala, vantagem competitiva. Tudo razoável no abstrato.
O problema é que a pergunta costuma chegar antes de a empresa estar pronta pra responder honestamente. O time olha o custo de inferência, projeta pra escala futura, vê um número alto, e conclui que treinamento próprio compensa. Calcula o custo de GPUs pra treinar uma vez, compara com o custo anual de API, e o número fecha no PowerPoint. Aí começa o projeto, e seis meses depois, a conta real é três vezes maior, o modelo tem performance pior que o base + RAG, e ninguém quer admitir que foi caminho errado.
Esse artigo é sobre o que está faltando nessa conta. Quando faz sentido treinar modelo próprio, quando não faz, e quais custos ocultos transformam a estimativa otimista numa surpresa cara. Não é argumento contra fine-tuning ou modelos próprios; é convite pra fazer a conta de verdade antes de embarcar.
O que significa "modelo próprio"
Antes de discutir trade-offs, vale separar três coisas que costumam ser misturadas em conversa.
Treinar do zero. Pegar dados, partir de pesos aleatórios ou de um modelo base, e treinar um modelo grande de linguagem. Custo medido em milhões de dólares, infraestrutura medida em milhares de GPUs, tempo medido em meses. Faz sentido pra um número ínfimo de empresas no mundo. Pra praticamente todo mundo lendo isso, não faz.
Fine-tuning de modelo open source. Pegar um modelo open source (Llama, Mistral, Qwen) e ajustar com seus dados. Custo dramaticamente menor, infraestrutura mais acessível, tempo em dias ou semanas. É o que a maioria das empresas chama de "treinar modelo próprio".
Fine-tuning gerenciado de modelo proprietário. Usar serviços como OpenAI fine-tuning, Anthropic, ou serviços de cloud (Vertex, Bedrock) pra fazer fine-tuning sem se preocupar com infraestrutura. Custo previsível, sem precisar gerenciar GPU, mas com menos controle sobre o resultado.
Quando alguém na empresa fala "treinar modelo próprio", quase sempre se refere a uma das duas últimas. Vamos focar nessas.
Quando faz sentido considerar
Existem quatro cenários onde considerar modelo próprio (especialmente fine-tuning de open source) é razoável.
Domínio muito específico onde modelos genéricos têm desempenho ruim. Vocabulário muito particular, padrões de raciocínio que o modelo base não captura, formato de saída muito estruturado. Áreas como direito jurídico-específico, medicina especializada, código em linguagens de nicho. Aqui, um modelo base + prompt pode chegar em 70% de qualidade, e fine-tuning pode levar pra 90%.
Privacidade ou compliance que impede uso de provedor externo. Setores regulados onde dados não podem sair do perímetro da empresa por contrato ou lei. Algumas operações financeiras, dados de saúde sensíveis, dados governamentais. Aqui, a alternativa não é "modelo proprio é melhor"; é "modelo próprio é a única opção viável".
Volume tão alto que o custo de API supera o de hospedagem. Em escala muito grande (milhões de chamadas por dia), o custo por token via API pode superar o custo de manter infraestrutura própria com modelo open source. Mas o ponto de equilíbrio é mais alto do que a maioria estima. Vamos voltar nisso.
Latência crítica que a API não atende. Casos de tempo real onde milissegundos importam (trading, sistemas embarcados, edge computing) podem justificar inferência local com modelo dedicado.
Fora desses quatro, modelo próprio quase sempre é solução em busca de problema. Vale parar e olhar honestamente: você está se encaixando num desses cenários, ou está reproduzindo um argumento que ouviu numa apresentação?
A conta que aparece no PowerPoint
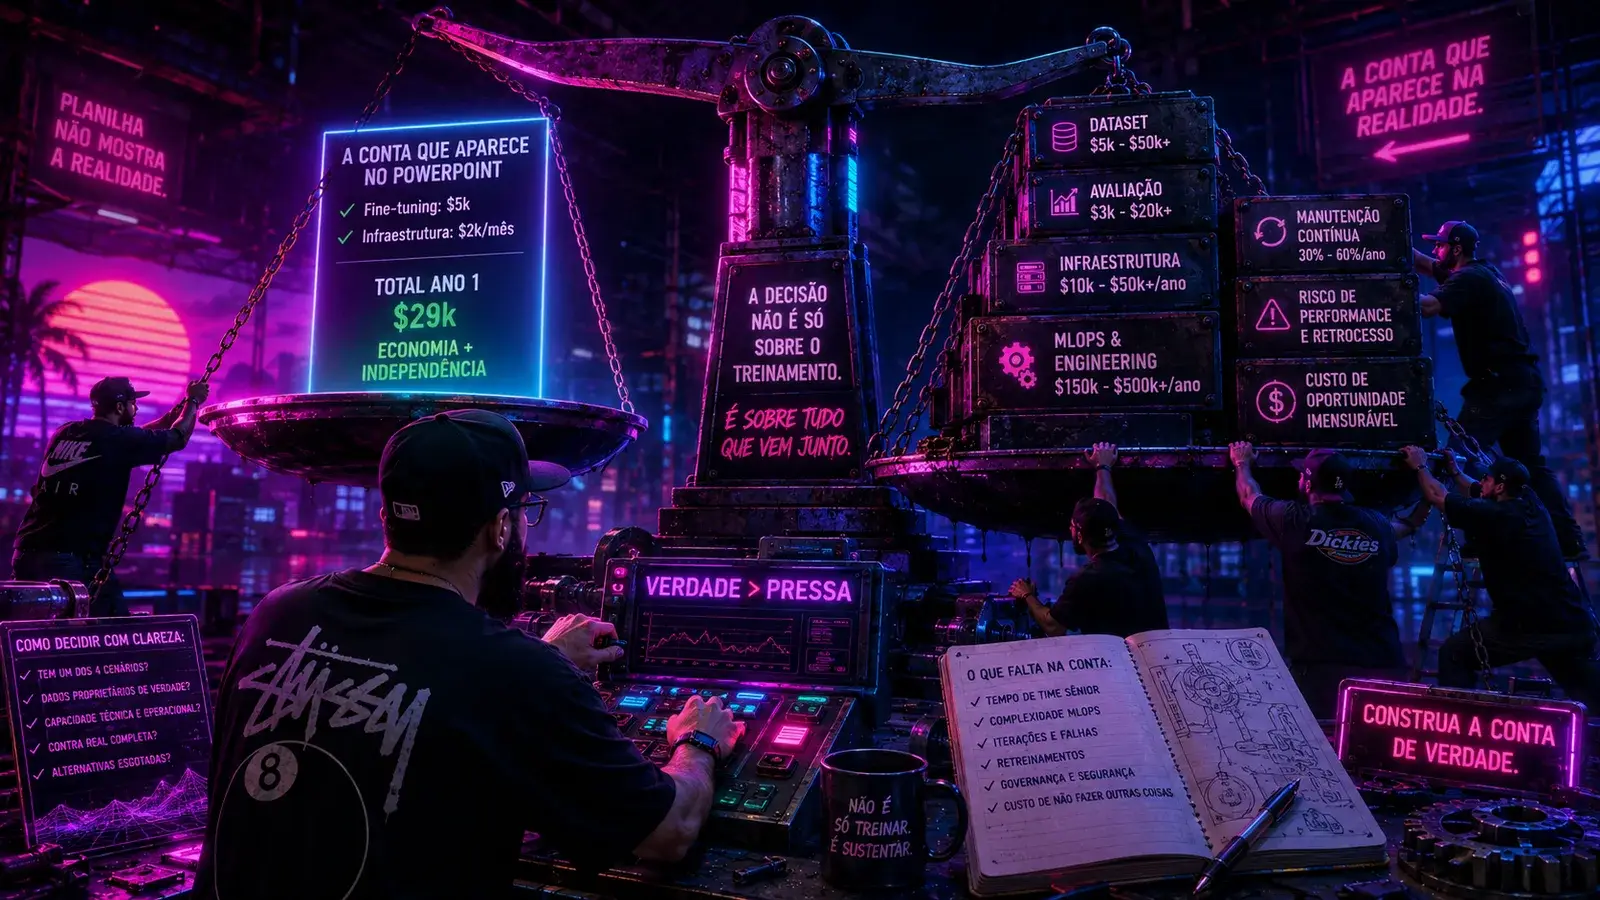
A conta típica que justifica treinamento próprio se parece com isso:
Custo atual de API:
- 50 milhões de tokens/mês
- $5 por milhão = $250/mês × 12 = $3.000/ano por feature
- 10 features = $30.000/ano

Custo de treinamento próprio:
- Fine-tuning inicial: $5.000
- Infraestrutura de inferência: $2.000/mês = $24.000/ano
- Total ano 1: $29.000

Conclusão: economia de $1.000/ano + independência
A conta soma certo. O problema é o que falta nela.
A conta que aparece na realidade
Vamos refazer com o que costuma faltar.
Custo de dataset
Fine-tuning sem dataset de qualidade não funciona. Você precisa de pelo menos algumas centenas de exemplos rotulados, idealmente milhares, com gabarito confiável. Onde isso vem?
Rotulação humana. Equipe interna ou serviço terceirizado. Custo varia de $0,10 a $5 por exemplo dependendo da complexidade. Pra 5.000 exemplos com revisão dupla, conta tipicamente $5.000 a $50.000.
Curadoria interna. Time de produto ou engenharia revisa logs e cria gabaritos. Custo escondido em horas de gente sênior. Tipicamente subestimado em 3x.
Aumento sintético. Usar LLM grande pra gerar exemplos. Mais barato, mas exige validação porque modelo grande também erra. Custo em tokens de geração, mais tempo de revisão.
Datasets nunca são "uma vez só". Modelos retreinam, padrões evoluem, casos novos aparecem. Custo de manter dataset rolando é entre 30% e 60% do custo inicial, ano após ano.
Custo de avaliação
Modelo treinado precisa de eval set robusto pra confirmar que melhorou em relação ao base. Não dá pra usar o mesmo dataset de treinamento (overfitting). Precisa de set separado, representativo, mantido. Custo similar ao de dataset de treinamento, mas em volume menor.
Mais ainda: cada nova versão do modelo precisa de avaliação completa antes de substituir a versão anterior em produção. Pipeline de avaliação automatizado é projeto em si. Sem ele, você está atualizando às cegas.
Custo de pipeline de MLOps
Treinar uma vez e colocar em produção é a parte fácil. Manter o sistema rodando é a parte cara.
Pipeline de retreinamento. Quando os dados evoluem ou o modelo base melhora, você precisa retreinar. Pipeline automatizado pra isso (orquestração, versionamento de dataset, treinamento, avaliação, promoção) é trabalho de engenharia. Setup inicial: 2 a 6 meses de um engenheiro especializado. Manutenção: 20% do tempo de uma pessoa, contínuo.
Versionamento. Modelos têm versões, datasets têm versões, código de treinamento tem versões. Reproduzir uma versão antiga exige todo esse histórico amarrado. Ferramentas como MLflow, Weights & Biases, ou solução própria, todas exigem setup e disciplina.
Monitoramento. Drift de modelo, regressão de qualidade, mudanças no comportamento das requisições. Tudo precisa de instrumentação que não existe out-of-the-box pro modelo próprio (diferente de provedores que dão dashboards prontos).
Custo de infraestrutura de inferência
A conta de "$2.000/mês de GPU" raramente bate.
Capacidade reservada vs. on-demand. Se você roda modelo próprio em GPU on-demand, custo varia. Se reserva pra ter latência consistente, paga capacidade ociosa nos momentos de baixo uso.
Redundância. Produção exige pelo menos duas zonas de disponibilidade. Custo dobra.
Picos de tráfego. Capacidade dimensionada pro pico, não pra média. Em sistemas com pico 10x da média, infraestrutura é dimensionada pro pico mesmo que use 30% do tempo.
Operação. Quem cuida quando a GPU falha às 3h da manhã? Time de SRE precisa entender ML, ou time de ML precisa estar de plantão.
Em volumes médios (centenas de milhares de chamadas por dia), API tipicamente vence em custo total. O ponto de equilíbrio com hospedagem própria é geralmente em volumes muito mais altos do que a empresa imagina.
Custo de time
Esse é o mais subestimado de todos. Operar modelo próprio em produção exige conhecimento que provedor abstrai.
Engenheiro de ML/MLOps. Pra desenhar pipelines de treinamento, avaliação, deploy e monitoramento. Salário no mercado é tipicamente 30-50% maior que engenheiro de software backend, e a oferta é escassa.
Engenheiro de dados especializado. Pra manter o pipeline de curadoria de dataset, qualidade de dados, integração com sistemas de origem.
Time de revisão e curadoria. Pessoas que entendem o domínio e podem rotular ou revisar dados. Geralmente parte de operação, não de tech.
Conhecimento institucional. Quem sabe por que o modelo foi treinado daquele jeito, com aquele dataset? Documentação ajuda, mas pessoas saem da empresa.
Levando isso pra conta da realidade:
Cenário "treinar modelo próprio" no ano 1:

Equipe (1 engenheiro de ML sênior, 1 engenheiro de dados, 30% de outras pessoas):
$300.000+ no ano (mercado brasileiro, cargas integradas)

Dataset inicial: $20.000 (rotulação) + tempo interno
Manutenção de dataset: $15.000/ano
Infraestrutura de inferência: $40.000/ano (mais realista pra alta disponibilidade)
Ferramentas e licenças: $10.000/ano
Custo de oportunidade (time não fazendo outras coisas): difícil estimar, mas real

Total ano 1: $385.000+

Custo de API equivalente em volume médio:
$30.000 a $80.000/ano

Diferença: $300.000+/ano pra justificar com algum benefício além de "modelo próprio"
Em volumes muito altos, esse cálculo se inverte. Mas o ponto importante é: a conta original que parecia mostrar economia de $1.000 estava ignorando $300.000 de custo escondido.
O que falta de benefício
Mesmo se a conta fechasse melhor, há benefícios que modelos próprios não entregam.
Acesso a melhorias contínuas. Provedores melhoram seus modelos sem você fazer nada. Você integrou GPT-4 e dois meses depois GPT-4o saiu, melhor e mais barato. Modelo próprio fica congelado na versão treinada até você retreinar.
Capacidade emergente. Modelos grandes têm habilidades que aparecem com escala. Modelos pequenos fine-tuned são bons na tarefa específica do treinamento, mas perdem flexibilidade. Pedir uma tarefa adjacente que não estava no dataset costuma falhar.
Suporte e ecosystem. Provedores investem em SDKs, ferramentas, integrações, documentação. Tudo isso é trabalho que você precisa fazer ou substituir se for self-hosted.
Quando modelo próprio realmente compensa
Em três cenários relativamente claros:
Volume genuinamente alto e estável. Empresas com bilhões de chamadas por mês, perfil de uso previsível, e equipe de ML já constituída. Aqui, hospedagem própria pode dar economia significativa. Mas "alto" aqui significa muito mais do que parece. Se sua conta é $30k/mês, não é alto. Se é $300k/mês, está começando a justificar.
Domínio onde melhoria é mensurável e crítica. Você tem evidência (não opinião) de que fine-tuning leva a ganho de qualidade que modelos genéricos não atingem, e esse ganho tem valor de negócio claro. "Achamos que vai melhorar" não conta; precisa ter benchmark e business case.
Restrição regulatória que força. Se compliance ou contrato exige modelo no perímetro da empresa, o cálculo deixa de ser opcional. Mas mesmo assim, vale considerar se o caso de uso pede modelo grande mesmo, ou se um modelo pequeno open source roda local com qualidade suficiente.
Como decidir sem se enganar
Algumas perguntas que protegem contra decisão por hype:
Você tem dataset de qualidade pra treinar? Se a resposta envolve "vamos montar", o projeto começa pelo dataset, não pelo modelo. E a montagem do dataset pode levar mais tempo que o esperado.
Você tem evidência empírica de que fine-tuning supera o que prompt + RAG já entrega? Não opinião, evidência. Se ainda não testou prompt + RAG bem feito, comece por aí.
Você tem capacidade técnica pra operar? Treinar é a parte fácil. Operar em produção exige time. Sem o time, o projeto vai dar errado independente do quão boa seja a ideia.
A conta que justifica inclui custo de equipe, infraestrutura redundante, dataset contínuo, e pipeline de retreinamento? Se inclui só GPU e treinamento inicial, refaça.
Você está disposto a manter isso por anos, mesmo quando o entusiasmo passar? Modelos próprios são compromisso de longo prazo. Decidir treinar é decidir manter.
Se as respostas a essas perguntas não te dão confiança forte, provavelmente não é hora ainda. Não significa "nunca". Significa que o caminho mais seguro é começar com prompt + RAG, escalar com isso, e revisitar a decisão de treinamento próprio quando os números e a estrutura justificarem de fato.
Conclusão
Modelo próprio é uma decisão estratégica e de longo prazo, não um upgrade técnico. A conta que aparece nos primeiros slides quase nunca inclui o que pesa de verdade: dataset contínuo, equipe especializada, infraestrutura redundante, pipeline de retreinamento e custo de oportunidade. Quando todos esses entram, o ponto em que treinar compensa fica muito mais alto do que parece.
Isso não significa que treinamento próprio é sempre erro. Significa que merece análise honesta, não decisão por entusiasmo. Em alguns contextos (volume realmente alto, domínio muito específico com evidência clara, restrição regulatória) faz todo sentido. Na maioria dos contextos, o mesmo investimento em melhorar prompt, RAG e arquitetura de produto entrega mais valor com menos risco.
A pergunta honesta que protege a empresa: "se daqui a três anos descobrirmos que modelo próprio não compensou, conseguimos voltar atrás sem destruir o produto?" Se a resposta é sim, o risco é controlado. Se é não, a aposta é alta demais pra ser feita sem evidência forte.
Insights & Takeaways
-
A conta que justifica modelo próprio costuma ignorar custo de dataset contínuo, equipe especializada, infraestrutura redundante e pipeline de retreinamento. Esses itens somam tipicamente 5 a 10 vezes o custo de treinamento inicial.
-
"Modelo próprio" geralmente significa fine-tuning de open source ou fine-tuning gerenciado, não treinamento do zero. Treinar do zero é viável pra um número minúsculo de empresas no mundo.
-
Modelo próprio compensa com clareza em três cenários: volume genuinamente alto e estável, domínio com ganho mensurável e crítico, ou restrição regulatória. Fora desses, costuma ser solução em busca de problema.
-
Provedores entregam melhorias contínuas e capacidades emergentes que modelos próprios fine-tuned perdem. Essa "atualização gratuita" tem valor que não aparece na conta direta.
-
Antes de treinar, esgote prompt + RAG bem feito. Se eles entregam o resultado de negócio, treinar não traz benefício suficiente pra justificar o compromisso de manter modelo próprio por anos.