IA First · Episódio 7
Do Prompt ao Produto: Desenhando Features de IA Com User Journey e Não Com Hype
Feature de IA começa na jornada do usuário, não no modelo: onde IA ajuda ou atrapalha, output verificável, fallback, confiança e métrica de produto.
Neste artigo · 10 seções
- O problema que ninguém quer admitir
- "Vamos colocar IA" não é uma feature
- User journey primeiro, modelo depois
- Onde IA ajuda, onde atrapalha e onde só deixa tudo mais lento
- A anatomia de uma feature de IA bem desenhada
- Features boas vs. features ruins: padrões que se repetem
- UX de IA: confiança é a métrica que ninguém mede
- O mapeamento que o time deveria fazer antes de escrever código
- Conclusão
- Insights & Takeaways
O problema que ninguém quer admitir
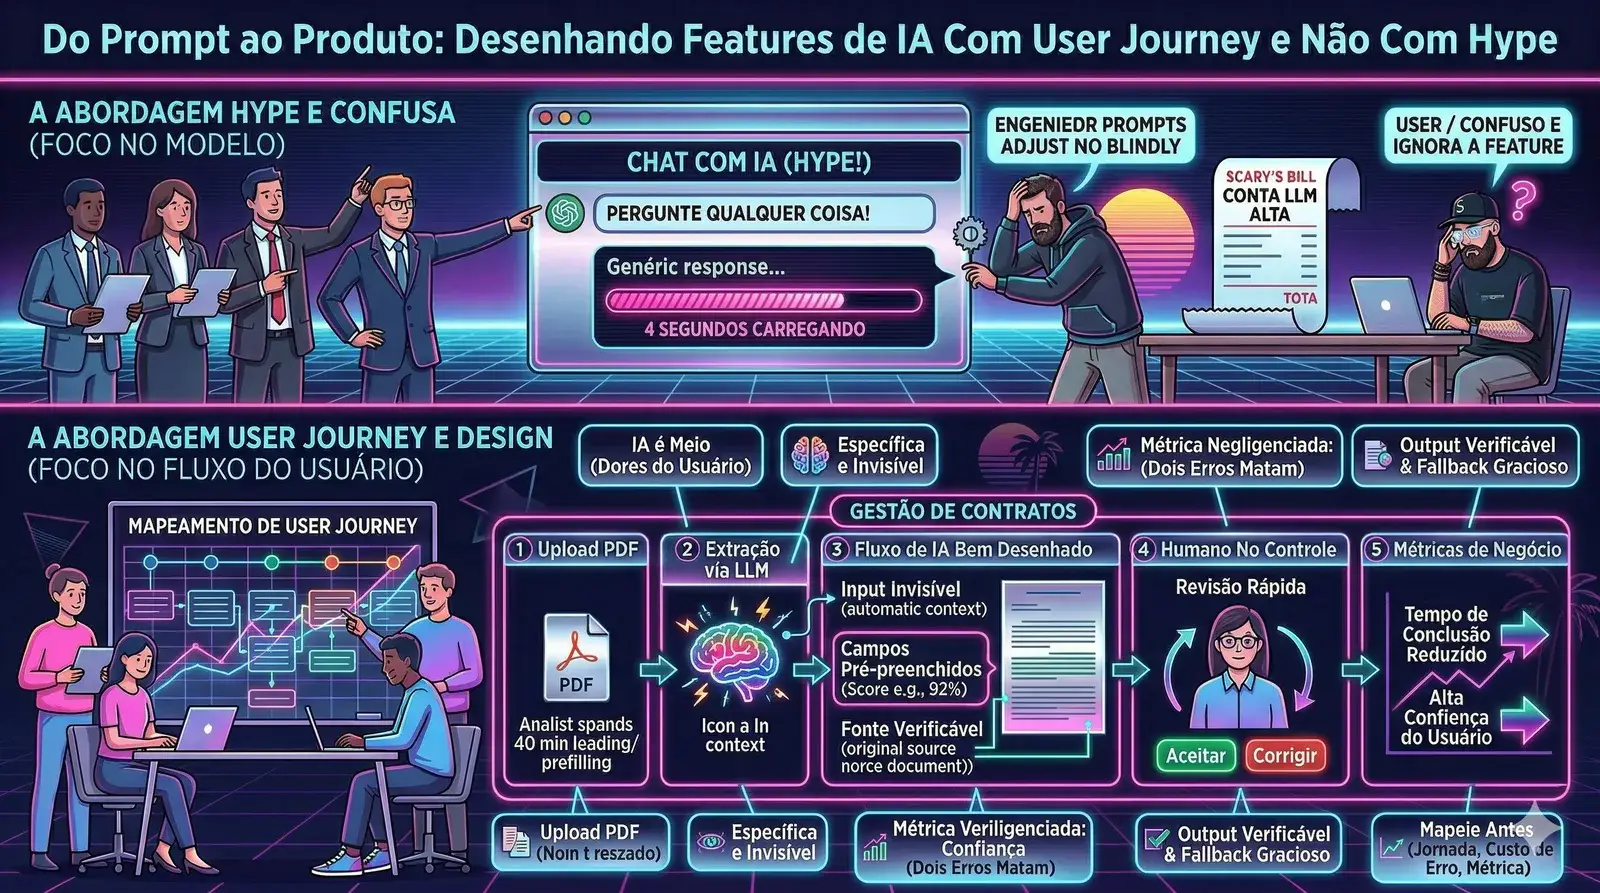
Tem uma cena que se repete em toda empresa que resolve "usar IA". Alguém da liderança volta de um evento, de um webinar, de um almoço com outro C-level, e chega com a frase: "a gente precisa colocar IA no produto". Duas semanas depois, o time de engenharia está integrando um endpoint da OpenAI num fluxo que ninguém mapeou, com um prompt que ninguém testou com usuários reais, numa feature que ninguém sabe explicar por que existe.
O resultado? Uma caixa de texto mágica que responde coisas genéricas, demora 4 segundos pra carregar, e que os usuários ignoram depois de duas tentativas. O time gasta sprint atrás de sprint ajustando prompts no escuro, o produto fica com uma feature que não move nenhuma métrica, e a conta do provedor de LLM chega no final do mês como um susto.
Esse artigo é sobre como evitar isso. Não é sobre prompts, modelos ou frameworks de agentes. É sobre design de produto. Sobre entender onde IA resolve um problema real no fluxo do usuário, e onde ela é só um brinquedo caro que adiciona fricção.
"Vamos colocar IA" não é uma feature
A primeira coisa que precisa ficar clara: IA é um meio, não um fim. Parece óbvio quando você lê, mas na prática quase todo mundo inverte isso.
Uma feature de produto começa com um problema do usuário. Sempre. O usuário demora 20 minutos pra classificar tickets manualmente. O analista precisa ler 40 páginas de contrato pra achar uma cláusula específica. O operador erra a configuração de um pedido porque o formulário tem 35 campos. Esses são problemas reais. IA pode ou não ser a melhor solução pra cada um deles.
Quando o ponto de partida é "vamos colocar IA", o time pula a etapa de entender o problema e vai direto pra solução. Aí acontece o que sempre acontece: a feature vira um martelo procurando prego. Alguém sugere "e se a gente colocar um chat com IA aqui?", e pronto, virou escopo, virou sprint, virou deploy. Sem hipótese, sem métrica de sucesso, sem critério de rollback.
A diferença entre um time que entrega IA que funciona e um que entrega IA de demonstração é essa: o primeiro começa pelo user journey, o segundo começa pelo modelo.
User journey primeiro, modelo depois
Vamos ser didáticos aqui. Imagine um produto de gestão de contratos. O fluxo atual do usuário é mais ou menos assim:
O ponto de dor está claro: o analista gasta de 20 a 40 minutos por contrato fazendo trabalho mecânico entre os passos B e E. Ele lê, classifica, copia dados, cola em campos. É repetitivo, propenso a erro, e consome gente qualificada em tarefa de baixo valor.
Agora, a pergunta certa não é "onde colocar IA?". A pergunta certa é: "qual etapa específica do fluxo se beneficia de automação, e com qual grau de confiança o usuário precisa confiar na resposta?"
Veja a diferença entre duas abordagens:
A abordagem hype seria enfiar um chatbot no meio do fluxo. "Pergunte qualquer coisa sobre o contrato!" Parece legal numa demo. Na prática, o analista não quer conversar com o contrato. Ele quer que os campos já venham preenchidos pra ele só revisar.
A abordagem orientada por journey seria outra. Você automatiza a extração (passos B a E) e apresenta os resultados já preenchidos para o analista revisar no passo F. O fluxo muda:
Menos passos, menos fricção, e o humano continua no controle. O analista não precisa confiar cegamente; ele vê o que foi extraído, vê de onde veio, e corrige se precisar. Isso é design de feature com IA. Sem chat, sem mágica, sem "pergunte qualquer coisa".
Onde IA ajuda, onde atrapalha e onde só deixa tudo mais lento
Nem todo ponto do journey precisa de IA. Parece bobo, mas é o erro mais comum. Tem uma regra simples que ajuda a filtrar.
IA tende a funcionar bem quando a tarefa é repetitiva, tem dados suficientes pra contexto, tolera margem de erro razoável e o custo de errar é baixo ou reversível. Classificar tickets por categoria, sugerir respostas pra chat de suporte, resumir documentos longos, gerar um rascunho inicial de texto. Tudo isso se encaixa.
IA tende a atrapalhar quando a tarefa exige precisão absoluta, quando o usuário não tem como verificar a resposta, ou quando o domínio é tão específico que o modelo não tem contexto suficiente. Calcular valores financeiros, gerar cláusulas contratuais sem revisão, tomar decisões regulatórias automáticas. Aqui, um erro não é "ah, corrige depois". Um erro pode ser um processo, uma multa, um cliente perdido.
E tem o terceiro caso, que é o mais traiçoeiro: IA que não atrapalha, mas também não ajuda. Ela simplesmente deixa tudo mais lento. Sabe aquele autocomplete de IA num campo de busca que demora 2 segundos pra sugerir algo que o usuário já ia digitar em 0.5 segundo? Ou aquele resumo automático de um e-mail de três linhas? Não é que esteja errado. É que é inútil. Adiciona latência sem adicionar valor.
A régua deveria ser: se você tirar a IA desse ponto do fluxo e nada de valor se perde, ela não deveria estar ali.
A anatomia de uma feature de IA bem desenhada
Vamos destrinchar o que uma feature de IA precisa ter pra funcionar em produção, não em demo.
Primeiro, input claro e controlado. O usuário não pode ter que adivinhar o que fornecer. Se a feature precisa de contexto, pegue o contexto do sistema, não peça pro usuário escrever um prompt. A maioria das boas features de IA é invisível pro usuário final. Ele faz upload de um arquivo e os campos aparecem preenchidos. Ele abre um ticket e a sugestão de categoria já está lá. Sem caixa de texto livre, sem "descreva o que você quer".
Segundo, output verificável. O usuário precisa conseguir checar se a resposta faz sentido. Isso significa mostrar a fonte, o trecho original, o score de confiança, ou qualquer indicador que permita revisão rápida. Se o output não é verificável, você está pedindo confiança cega num sistema probabilístico. Boa sorte com isso.
Terceiro, fallback gracioso. O que acontece quando a IA não sabe, quando a confiança é baixa, quando o serviço está fora? Se a resposta é "mostra um erro genérico", a feature vai gerar frustração toda vez que falhar. O fallback precisa ser pensado como parte do fluxo: volta pro manual, mostra campos vazios pra preenchimento, sugere que o usuário revise com mais atenção.
Quarto, loop de feedback embutido. O usuário aceitou a sugestão? Corrigiu? Rejeitou? Essa informação precisa voltar pro sistema. Sem isso, você não melhora nada. É como lançar código sem monitoramento.
Quinto, métricas de negócio conectadas. "O modelo tem 92% de acurácia" não quer dizer nada se você não sabe se isso reduziu o tempo de processamento, se diminuiu erro humano, se o usuário ficou satisfeito. A feature precisa estar conectada a uma métrica que importa pra alguém que paga a conta.
Visualmente, uma feature de IA bem desenhada segue esse fluxo interno:
Nada disso é complicado. Mas é o tipo de coisa que não aparece numa demo de "olha, integrei a API do GPT em 2 horas".
Features boas vs. features ruins: padrões que se repetem
Depois de ver dezenas de implementações de IA em produto, alguns padrões ficam claros.
Features que funcionam tendem a ser específicas. Elas resolvem um problema bem definido, num ponto bem definido do fluxo. "Classificar automaticamente tickets de suporte em 5 categorias" é específica. "Assistente de IA que ajuda em tudo" não é. Quanto mais genérica a feature, mais difícil medir sucesso, mais difícil melhorar, e mais provável que o usuário não entenda o que fazer com ela.
Features que falham tendem a ser genéricas e assíncronas ao fluxo. Um painel separado de "IA" que o usuário precisa abrir, um bot que exige que o usuário formule uma pergunta bem feita, uma feature que interrompe o fluxo pra oferecer algo que ninguém pediu. Tudo isso adiciona fricção em vez de remover.
Tem um teste simples que ajuda a separar uma da outra. Coloca a feature no fluxo e cronometra. O usuário completou a tarefa mais rápido? Com menos erro? Se a resposta é não pras duas, a feature provavelmente não deveria existir.
Outro padrão que se repete: features de IA que dão certo quase sempre começam como assistência, não como automação total. O modelo sugere, o humano decide. Com o tempo, conforme a confiança sobe e os edge cases ficam mapeados, você pode aumentar o grau de automação. Mas começar já com "a IA decide sozinha" num domínio que você mal entende é receita pra incidente.
UX de IA: confiança é a métrica que ninguém mede
Tem uma métrica que quase nenhum time acompanha quando lança feature de IA: confiança do usuário.
A coisa é a seguinte. Se o modelo erra uma vez e o usuário não percebe, tudo bem por enquanto. Se o modelo erra uma vez e o usuário percebe, a confiança cai. Se erra duas vezes, o usuário desliga a feature e não volta. Você gastou meses construindo algo que foi abandonado em duas interações.
Confiança é assimétrica. Leva semanas pra construir e segundos pra destruir. Por isso, features de IA novas precisam ser conservadoras. Melhor mostrar "não sei" do que inventar uma resposta errada. Melhor pré-preencher com confiança alta e deixar campos vazios quando a confiança é baixa, do que preencher tudo e errar em 20% dos casos.
Isso muda a forma como você desenha a UX. Em vez de "a IA faz tudo", o design precisa comunicar claramente o que a IA fez, onde ela tem certeza, onde ela não tem, e como o usuário corrige. Transparência não é um nice-to-have. É o que mantém a feature viva depois da primeira semana.
Na prática, isso significa coisas como: destacar visualmente campos preenchidos pela IA vs. pelo usuário; mostrar o trecho do documento original de onde veio a informação; usar indicadores visuais de confiança (não precisa ser um número, pode ser cor, ícone, ou simplesmente a presença ou ausência da sugestão); oferecer um botão de "isso está errado" que seja fácil de clicar e que alimente o loop de feedback.
O mapeamento que o time deveria fazer antes de escrever código
Antes de abrir a IDE, antes de escolher modelo, antes de testar prompts, o time deveria sentar e mapear quatro coisas.
Primeira: qual é a jornada atual do usuário, passo a passo, sem IA? Quanto tempo leva cada etapa? Onde tem erro? Onde tem retrabalho? Isso precisa estar documentado, nem que seja num quadro branco fotografado. Sem isso, você não tem baseline.
Segunda: em qual etapa específica a IA pode reduzir tempo, erro ou esforço cognitivo? Não "onde podemos colocar IA", mas "onde o benefício é mensurável". Se você não consegue quantificar o benefício esperado, talvez o benefício não exista.
Terceira: qual é o custo de erro nessa etapa? Se a IA erra aqui, o que acontece? O usuário percebe e corrige em 2 segundos? Ou um valor errado vai parar num relatório regulatório? Isso define o grau de autonomia que faz sentido.
Quarta: como você vai medir sucesso? Não "acurácia do modelo", mas métricas de produto. Tempo de conclusão da tarefa. Taxa de aceitação das sugestões. Taxa de correção. NPS da feature. Impacto em churn. Se você não define isso antes, vai ficar eternamente naquela conversa de "a IA é legal mas não sei se tá funcionando".
Esse mapeamento deveria ser um artefato compartilhado entre produto, engenharia e design. Não é um documento de 50 páginas. É uma tabela com quatro colunas, uma por pergunta, preenchida em uma sessão de trabalho.
Conclusão
A diferença entre uma feature de IA que sobrevive em produção e uma que vira dead code em três meses é quase sempre a mesma: o time que acerta começa pela jornada do usuário, o time que erra começa pelo modelo.
IA em produto é um problema de design antes de ser um problema de engenharia. O prompt é a parte fácil. O difícil é saber por que aquele prompt existe, o que acontece quando ele falha, e como você mede se ele está entregando valor. Se você não responde essas três perguntas antes de escrever a primeira linha de código, está construindo uma demo, não um produto.
E demos, como a gente sabe, não pagam a conta de ninguém.
Insights & Takeaways
-
IA é meio, não fim. Comece sempre pela dor do usuário na jornada, não pela tecnologia. Se você não consegue descrever o problema sem mencionar IA, provavelmente não tem um problema real.
-
Feature de IA boa é específica e invisível. O melhor uso de LLM em produto é quando o usuário nem percebe que tem IA ali, ele só percebe que a tarefa ficou mais rápida ou mais fácil.
-
Confiança do usuário é a métrica mais negligenciada. Dois erros consecutivos matam a adoção de qualquer feature de IA. Desenhe pro caso de baixa confiança primeiro, depois expanda.
-
Output verificável e fallback gracioso não são opcionais. Se o usuário não consegue checar a resposta e o sistema não sabe falhar bem, você está construindo uma bomba-relógio com latência de API.
-
Mapeie jornada, ponto de intervenção, custo de erro e métrica de sucesso antes de abrir a IDE. Esse exercício de uma hora economiza meses de retrabalho.