IA First · Episódio 22
Arquiteturas Híbridas: Misturando Modelos Grandes, Pequenos e Regras Clássicas
Como combinar modelos grandes, modelos pequenos e regras determinísticas com roteamento e cascata para cortar custo e latência sem perder qualidade.
Neste artigo · 10 seções
- O reflexo que custa caro
- Os três tipos de componente e o que cada um resolve
- Roteamento por dificuldade: o padrão central
- O padrão cascata: tentar barato primeiro
- Regras determinísticas onde elas são insubstituíveis
- Composição: combinando os três numa única feature
- O trade-off central: previsibilidade vs. flexibilidade
- Quando não vale a pena complicar
- Conclusão
- Insights & Takeaways
O reflexo que custa caro
Tem um reflexo comum em times que adotam IA: usar o modelo mais capaz pra tudo. A lógica parece sólida. "Se o modelo grande resolve, por que complicar?" Aí toda chamada, da classificação binária mais trivial à geração de relatório complexo, passa pelo mesmo modelo top de linha. Funciona. A demo fica boa. E a conta no fim do mês fica alta, a latência fica pior do que precisaria, e o sistema fica frágil em pontos onde determinismo seria mais seguro.
A questão que esse reflexo ignora é simples: nem todo problema dentro de um sistema de IA precisa do mesmo tipo de solução. Classificar se um texto está em português ou inglês não precisa de um modelo de bilhões de parâmetros. Validar se um CPF tem formato válido não precisa de IA nenhuma; precisa de uma regex. Gerar uma resposta empática a uma reclamação complexa, aí sim, precisa de capacidade.
Arquitetura híbrida é o reconhecimento de que um sistema de IA maduro é uma composição de componentes de naturezas diferentes: modelos grandes onde a complexidade justifica, modelos pequenos onde a tarefa é estreita, e regras determinísticas onde previsibilidade importa mais que flexibilidade. Esse artigo é sobre como desenhar essa composição sem cair nem no "tudo no modelo grande" nem no extremo oposto de over-engineering.
Os três tipos de componente e o que cada um resolve
Antes de combinar, vale entender o que cada peça faz bem.
Modelos grandes (os top de linha, com muitos parâmetros) são fortes em tarefas abertas, ambíguas, que exigem raciocínio, síntese, ou geração de linguagem natural sofisticada. Respondem bem a situações que não foram explicitamente previstas. O custo é alto por chamada e a latência é maior. A previsibilidade é menor: a mesma entrada pode gerar saídas diferentes.
Modelos pequenos (modelos compactos, ou modelos fine-tuned pra tarefa específica) são fortes em tarefas estreitas e bem definidas: classificação, extração de campos simples, detecção de intenção, reformulação curta. Custam uma fração do modelo grande, respondem mais rápido, e quando fine-tuned pra uma tarefa, podem igualar ou superar o modelo grande naquele escopo específico. Fora do escopo, degradam rápido.
Regras determinísticas (código clássico, regex, lookup tables, validações, máquinas de estado) são imbatíveis em previsibilidade. Mesma entrada, mesma saída, sempre. Custo computacional desprezível, latência mínima, auditoria trivial. O limite é que só funcionam onde o problema é estruturado e enumerável. Não lidam com ambiguidade nem com linguagem natural aberta.
A arte da arquitetura híbrida é colocar cada problema no componente certo:
Roteamento por dificuldade: o padrão central
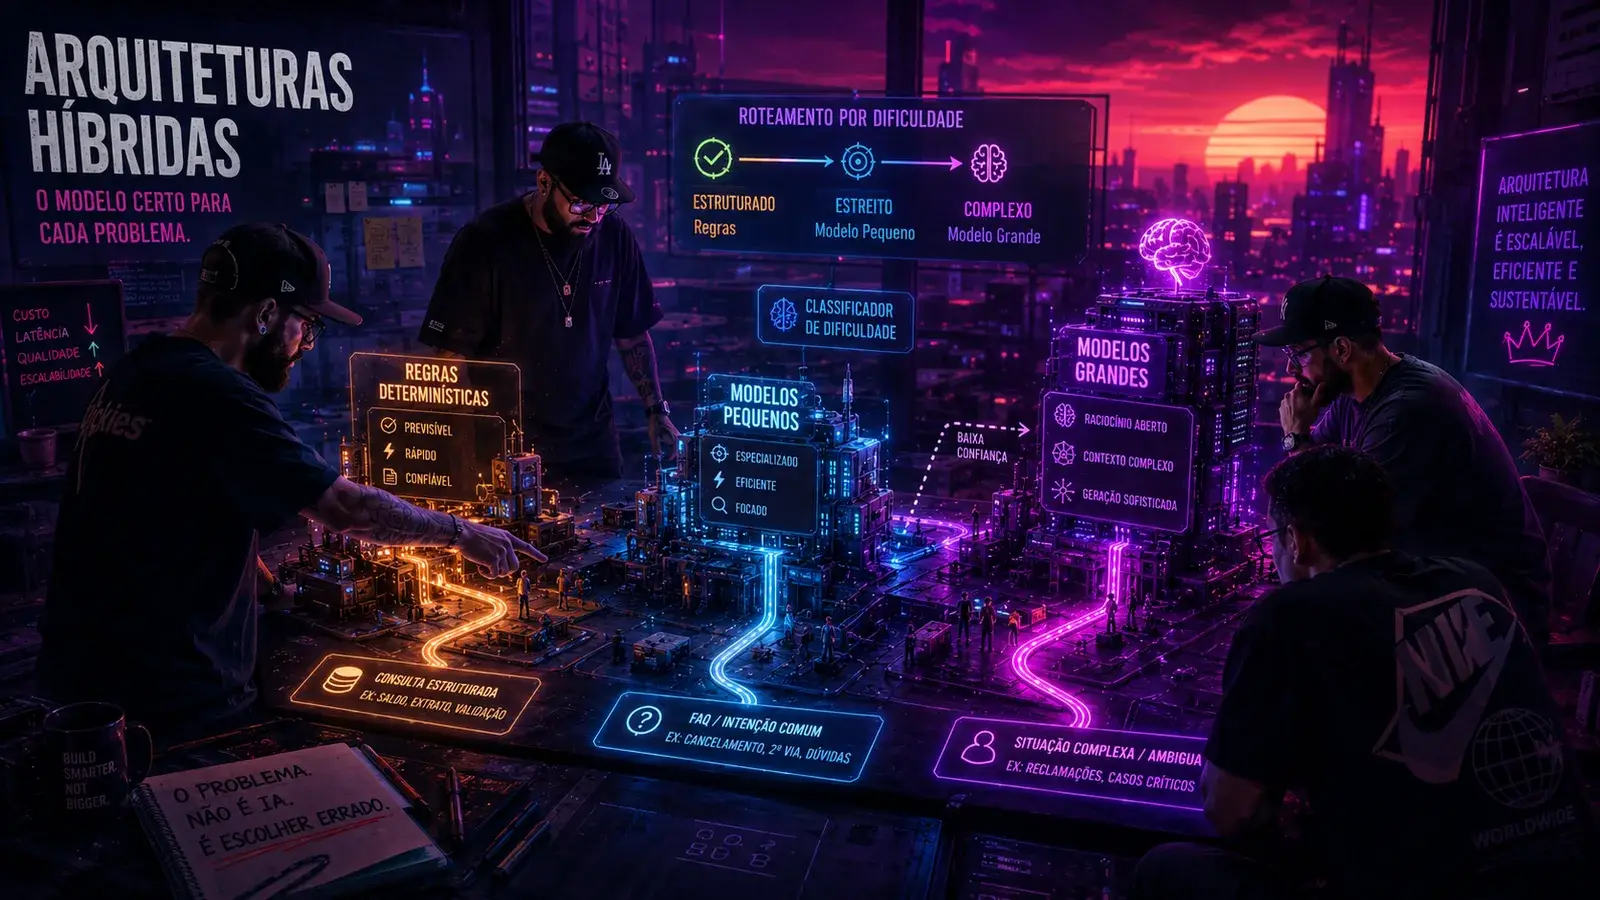
O padrão mais útil em arquitetura híbrida é roteamento por dificuldade. Em vez de mandar tudo pro mesmo lugar, você classifica a entrada e roteia pro componente adequado.
Imagine um sistema de atendimento. As mensagens dos usuários têm dificuldades muito diferentes. "Qual meu saldo?" é uma consulta estruturada que uma regra + query resolve. "Como cancelo minha assinatura?" é uma pergunta de FAQ que um modelo pequeno com a base de conhecimento responde. "Estou tentando entender por que fui cobrado duas vezes e o atendimento anterior não resolveu, preciso de ajuda urgente" é uma situação complexa, com contexto emocional e histórico, que pede o modelo grande.
O roteador decide qual caminho seguir:
Repara na seta pontilhada: se o modelo pequeno tem confiança baixa na resposta, escala pro modelo grande. Isso é o padrão cascata, que vamos detalhar.
O roteador em si pode ser implementado de várias formas, com trade-offs:
Roteador por regra. Palavras-chave, padrões, heurísticas. "Se a mensagem contém 'saldo' ou 'extrato', vai pra consulta estruturada." Rápido, barato, previsível, mas frágil a variações de linguagem.
Roteador por modelo pequeno. Um classificador leve (pode até ser fine-tuned) que recebe a entrada e decide a rota. Mais robusto a variações, custo baixo, mas adiciona uma chamada extra.
Roteador por modelo grande. O modelo grande decide a rota e às vezes já responde. Mais flexível, mas perde o benefício de custo, já que você pagou o modelo grande só pra rotear.
Na prática, roteador por regra pra casos óbvios + roteador por modelo pequeno pro resto costuma ser o melhor equilíbrio.
O padrão cascata: tentar barato primeiro
Cascata é um caso específico de roteamento que merece destaque porque é onde mais se economiza sem perder qualidade.
A ideia: tente o componente mais barato primeiro. Se ele resolve com confiança suficiente, aceita. Se não, escala pro próximo nível.
Um exemplo concreto de cascata em extração de dados de documentos. A maioria dos documentos segue um template conhecido. Pra esses, uma regra (regex, parser estruturado) extrai os campos com 100% de precisão e custo zero. Documentos que não batem com o template conhecido vão pra um modelo pequeno fine-tuned pra extração. Os poucos documentos que o modelo pequeno extrai com baixa confiança vão pro modelo grande, que lida com os casos mais difíceis e raros.
Se 70% dos documentos são resolvidos pela regra, 25% pelo modelo pequeno e só 5% precisam do modelo grande, o custo médio por documento despenca em relação a mandar 100% pro modelo grande, sem perda mensurável de qualidade.
O segredo da cascata é o critério de escalonamento. "Confiança suficiente" precisa ser definido com cuidado. Escalar cedo demais desperdiça a economia. Escalar tarde demais (aceitar respostas ruins do componente barato) degrada qualidade. Calibrar esse threshold com dados reais, não com chute, é o que faz a cascata funcionar.
Regras determinísticas onde elas são insubstituíveis
Tem uma tendência, em times empolgados com IA, de querer resolver tudo com modelo. Vale resistir a isso em certos pontos.
Validações estruturais. Formato de CPF, CNPJ, e-mail, telefone, data. Isso é regex, não IA. Usar modelo aqui é mais lento, mais caro, e menos confiável que uma validação determinística que existe há décadas.
Regras de negócio críticas. "Transações acima de X exigem aprovação." "Cliente do plano Y não tem acesso ao recurso Z." Essas regras precisam ser determinísticas, auditáveis e imutáveis até decisão explícita de mudança. Deixar isso pro julgamento de um modelo probabilístico é introduzir incerteza onde você não pode ter incerteza.
Decisões com consequência regulatória ou financeira direta. Cálculo de valores, aplicação de juros, decisão de limite. Mesmo que o modelo "quase sempre acerte", o "quase" é inaceitável onde o erro vira problema legal ou prejuízo. Regra determinística com IA assistindo (sugerindo, explicando) é diferente de IA decidindo.
Guardrails de segurança. Filtros de conteúdo proibido, limites de escopo, bloqueios. A primeira camada de proteção deveria ser determinística. Modelo pode complementar, mas não deveria ser a única barreira.
O padrão saudável aqui é IA proporciona, regra dispõe. O modelo pode analisar, sugerir, enriquecer. Mas a decisão final em pontos críticos passa por uma regra que você controla, audita e versiona.
Composição: combinando os três numa única feature
Os padrões anteriores se combinam dentro de uma mesma feature. Vamos ver um exemplo completo: análise de um pedido de reembolso.
Repara como cada componente faz o que faz melhor. A regra valida formato e aplica política objetiva (reembolso de valor baixo, dentro do prazo, aprova direto, sem IA nenhuma). O modelo pequeno classifica e lida com casos padrão. O modelo grande entra só nos casos complexos e disputados, que são minoria. O humano valida onde a consequência justifica.
Esse desenho é dramaticamente mais barato, mais rápido e mais auditável que "manda todo pedido de reembolso pro GPT-4 analisar". E é mais confiável nos pontos que importam, porque a política objetiva é aplicada por regra, não por julgamento probabilístico.
O trade-off central: previsibilidade vs. flexibilidade
Toda decisão de arquitetura híbrida é, no fundo, um balanço entre previsibilidade e flexibilidade.
Mais regras determinísticas significa mais previsibilidade: você sabe exatamente o que o sistema vai fazer pra cada entrada conhecida. O preço é rigidez: entradas que não foram previstas caem no vazio ou exigem mais código.
Mais modelo grande significa mais flexibilidade: o sistema lida com situações não previstas, ambíguas, novas. O preço é imprevisibilidade, custo e dificuldade de auditoria.
Não existe ponto ótimo universal. O equilíbrio certo depende do contexto:
Em fluxos críticos, regulados, de alto impacto, o peso vai pra previsibilidade. Mais regra, modelo como assistente, humano no loop.
Em fluxos exploratórios, de baixo risco, com muita variação de entrada, o peso vai pra flexibilidade. Mais modelo, regra só pros guardrails essenciais.
O erro é aplicar o mesmo equilíbrio pra tudo. Um sistema maduro tem partes muito determinísticas (onde precisa ser) e partes muito flexíveis (onde pode ser), conscientemente desenhadas assim, não por acidente.
Quando não vale a pena complicar
Arquitetura híbrida adiciona complexidade. Roteador, cascata, múltiplos componentes, calibração de thresholds. Isso tem custo de desenvolvimento e manutenção. Nem sempre compensa.
Não vale a pena quando o volume é baixo. Se a feature faz 100 chamadas por dia, a economia de roteamento é irrelevante e a complexidade não se paga. Use o modelo que resolve, simples.
Não vale a pena na fase de validação. Quando você ainda está descobrindo se a feature tem valor, otimizar arquitetura é prematuro. Faça funcionar com o caminho mais simples, valide, e otimize depois se escalar.
Não vale a pena quando a diferença de custo entre componentes é pequena pro seu caso. Se o modelo grande e o pequeno custam quase o mesmo no seu volume, a cascata adiciona complexidade sem economia proporcional.
A regra é a mesma de sempre em arquitetura: introduza complexidade quando o problema justifica, não antes. Roteamento e cascata brilham em escala e em sistemas maduros. Em feature nova de baixo volume, é over-engineering.
Conclusão
Arquitetura híbrida não é uma técnica de IA; é arquitetura de software aplicada a um sistema que tem IA como um dos componentes. O princípio é antigo: use a ferramenta certa pra cada problema. O que muda é que agora as ferramentas incluem modelos de capacidades e custos muito diferentes, além das regras determinísticas de sempre.
O sistema bem desenhado não é o que usa o modelo mais poderoso em todo lugar. É o que coloca cada problema no componente que o resolve com o melhor equilíbrio de custo, latência, previsibilidade e qualidade. Regra onde dá pra ser determinístico. Modelo pequeno onde a tarefa é estreita. Modelo grande onde a complexidade justifica. Humano onde a consequência exige.
A pergunta que orienta bem cada decisão: "esse problema específico precisa mesmo de um modelo grande, ou eu estou usando um canhão pra matar mosquito porque é mais fácil que pensar no design?" Quase sempre, pensar no design compensa.
Insights & Takeaways
-
Nem todo problema dentro de um sistema de IA precisa do mesmo tipo de solução. Regra determinística onde é estruturado, modelo pequeno onde a tarefa é estreita, modelo grande onde a complexidade justifica. Usar o modelo grande pra tudo é caro, lento e frágil.
-
Roteamento por dificuldade é o padrão central. Classifique a entrada e mande pro componente adequado. Roteador por regra pra casos óbvios + modelo pequeno pro resto costuma ser o melhor equilíbrio.
-
Cascata (tentar barato primeiro, escalar se a confiança for baixa) é onde mais se economiza sem perder qualidade. O segredo está em calibrar o threshold de escalonamento com dados reais, não com chute.
-
Regras determinísticas são insubstituíveis em validações estruturais, regras de negócio críticas, decisões com consequência regulatória e guardrails de segurança. Nesses pontos, IA proporciona, regra dispõe.
-
Arquitetura híbrida adiciona complexidade que só compensa em escala e em sistemas maduros. Em feature nova de baixo volume ou fase de validação, é over-engineering. Introduza a complexidade quando o problema justificar.