IA First · Episódio 3
Prompt Engineering Que Funciona em Produção, Não Só em Playground
Prompt em produção é código: versionamento semântico, testes de regressão, ambientes, canary, A/B test e observabilidade por versão de prompt.
Neste artigo · 14 seções
- O buraco entre playground e produção
- Por que prompt hardcoded é um desastre esperando para acontecer
- Versionar prompt não é luxo, é requisito
- Testes automatizados para prompt: o que medir
- Como estruturar prompt para facilitar teste e observabilidade
- Ambientes separados: dev, staging, produção
- Deploy progressivo e A/B test
- Observabilidade: como saber se o prompt está funcionando em produção
- Guardrails: validação de saída antes de chegar no usuário
- Integração com CI/CD: prompt como código
- Casos reais onde falta de disciplina quebrou produção
- Como começar a aplicar isso no seu time
- Conclusão: prompt engineering é engenharia de verdade
- Insights & Takeaways
O buraco entre playground e produção
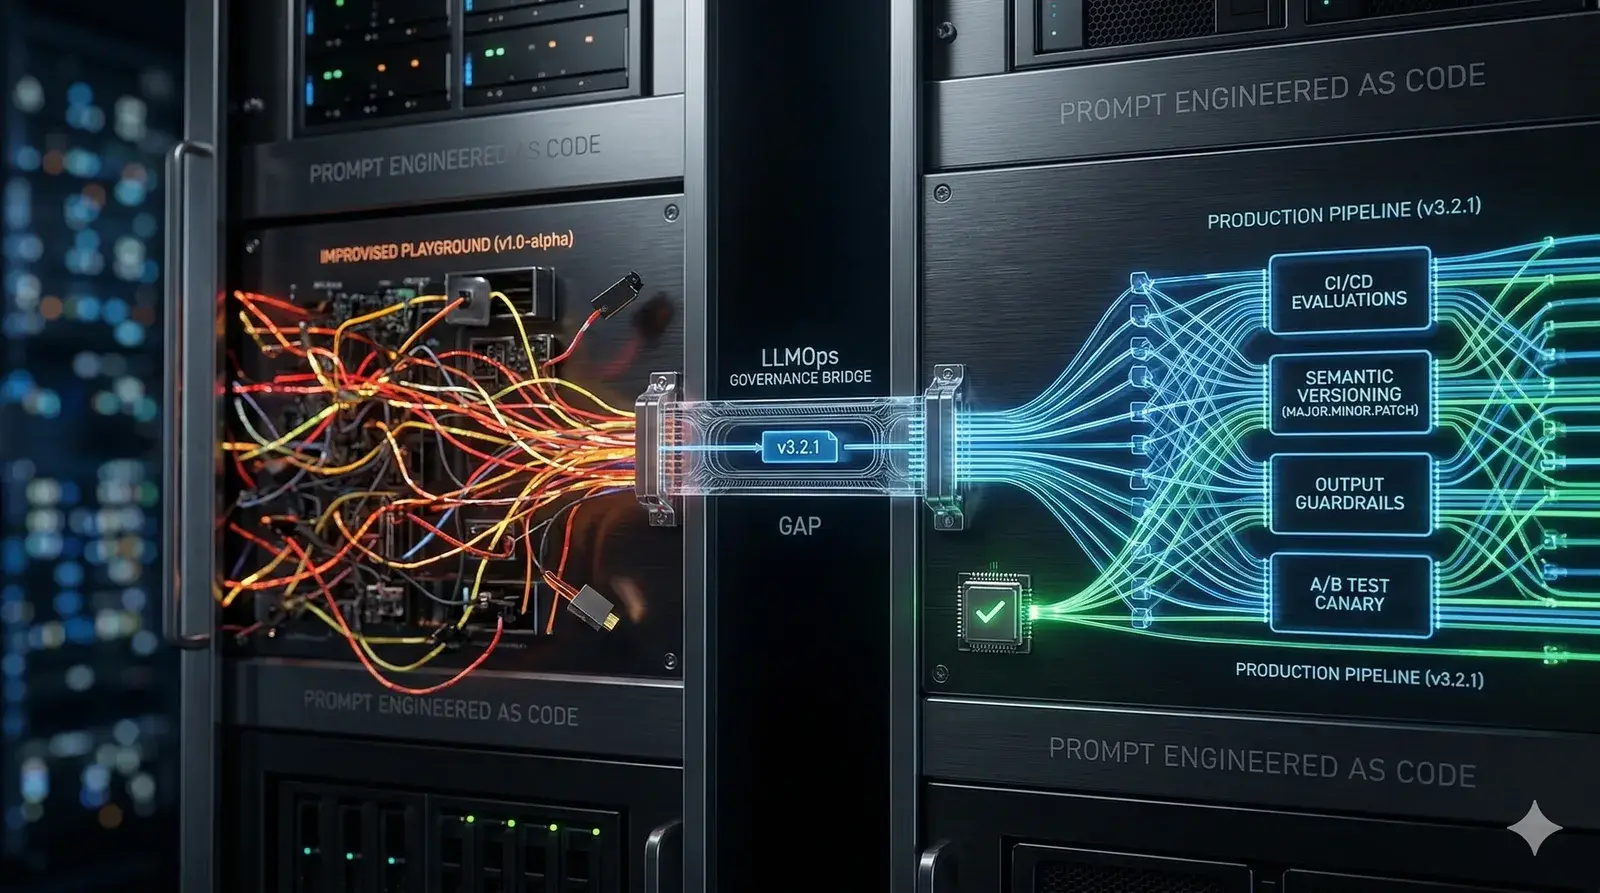
Todo mundo já viu aquela demo linda onde o prompt resolve tudo perfeitamente. Você testa no ChatGPT, no Claude, rodadas e rodadas até ficar redondo. Aí chega a hora de pôr isso em produção e descobrir que o prompt que funcionava ontem não funciona mais hoje, que mudança em uma linha quebra dez fluxos diferentes e que não existe forma rápida de saber o que deu errado.
O gap entre playground e produção é justamente isso: falta de disciplina de engenharia sobre algo que deveria ser tratado como código, não como mensagem de WhatsApp. Quando você coloca IA em produção, prompt vira artefato crítico do sistema, e como todo artefato crítico, precisa de versionamento, teste, observabilidade e estratégia de rollback.
Esse artigo é para mostrar, de forma bem didática, como transformar prompt de texto improvisado em componente versionado, testado e confiável o suficiente para aguentar produção.
Por que prompt hardcoded é um desastre esperando para acontecer
Hardcodar prompt direto no código parece rápido no começo. Só que aí vem o primeiro ajuste, depois o segundo, e logo você tem dez variações do mesmo prompt espalhadas pelo repositório, cada uma com comportamento diferente e sem rastreabilidade de quando e por que mudou.
Esse modelo cria alguns problemas concretos. Primeiro, impossibilidade de rollback: se um ajuste de prompt quebra o comportamento esperado, você não consegue voltar para a versão anterior sem mexer em código. Segundo, falta de rastreabilidade: se a qualidade da resposta cai, você não sabe se foi mudança no prompt, no modelo, nos dados de contexto ou em combinação de fatores. Terceiro, experimentação travada: qualquer teste de A/B ou validação de melhoria exige deploy de código novo, o que transforma cada iteração de prompt em ciclo de release completo.
Empresas que adotam IA em escala falam justamente isso: sem separar prompt do código e sem versionar, o time não consegue iterar com segurança.
Versionar prompt não é luxo, é requisito
Versionamento de prompt funciona exatamente como versionamento de código: toda mudança precisa de identificador único, descrição de motivo e rastreabilidade de impacto.
A abordagem mais prática é usar versionamento semântico: MAJOR.MINOR.PATCH. Mudança que quebra contrato ou comportamento esperado aumenta o MAJOR. Adição de capacidade sem quebrar compatibilidade aumenta o MINOR. Ajuste fino de redação ou exemplo aumenta o PATCH. Com isso, qualquer pessoa que olha a versão do prompt entende o nível de risco da mudança sem precisar ler diff completo.
Além disso, cada versão deve trazer metadados mínimos: quem mudou, quando, por que e qual métrica esperava melhorar. Sem esse contexto, versionamento vira apenas numeração sem utilidade real. Plataformas de LLMOps já oferecem isso pronto, permitindo armazenar prompts fora do código com versionamento, ambientes separados e possibilidade de promover versão de dev para staging e produção de forma controlada.
Testes automatizados para prompt: o que medir
Prompt não é poesia, é interface com modelo probabilístico. Logo, você precisa testar se ele continua gerando saída útil, segura e consistente.
Testes de prompt em produção cobrem algumas dimensões:
Regressão funcional: rodar versão nova contra conjunto fixo de entradas e comparar com saídas esperadas ou com baseline da versão anterior. Objetivo é garantir que melhoria em um caso não piora outros dez.
Validação de formato: se o prompt pede JSON estruturado ou lista com campos específicos, validação automática confirma que a saída obedece o schema. Output que não passa em parse já é falha, independente do conteúdo.
Detecção de alucinação e segurança: usar LLM-as-a-judge ou regras determinísticas para checar se a resposta inventa fato, foge do escopo ou viola política de uso. Esse tipo de guardrail evita que output inseguro chegue ao usuário.
Métricas de custo e latência: toda mudança de prompt altera consumo de token e tempo de resposta. Teste automatizado captura isso e sinaliza se a melhoria de qualidade veio com aumento inaceitável de custo ou latência.
Ferramentas de LLMOps permitem rodar essas validações como parte do pipeline de CI/CD, bloqueando merge de prompt que falha em critério definido.
Como estruturar prompt para facilitar teste e observabilidade
Prompt bem estruturado não é só mais fácil de ler, é mais fácil de testar, versionar e debugar.
Algumas práticas que ajudam:
Separar instruções, contexto, tarefa e formato de saída: em vez de um bloco único de texto, dividir o prompt em seções claras. Instruções definem papel e comportamento geral, contexto traz dados específicos da requisição, tarefa diz o que deve ser feito e formato de saída especifica estrutura esperada. Essa separação permite trocar contexto e tarefa sem mexer em instruções gerais, facilitando reutilização.
Usar delimitadores explícitos: marcar seções com ### ou XML tags ajuda tanto o modelo a interpretar quanto o engenheiro a identificar onde cada parte começa e termina. Em casos de debugging, você consegue isolar qual seção do prompt está gerando confusão.
Incluir exemplos few-shot dentro do versionamento: se o prompt usa exemplos para guiar o modelo, esses exemplos precisam estar versionados junto com o resto. Mudança em exemplo pode alterar comportamento tanto quanto mudança em instrução.
Forçar raciocínio explícito: pedir que o modelo explique o raciocínio antes de dar resposta ajuda tanto em acurácia quanto em observabilidade. Você consegue ler o trace e entender por que ele chegou naquela conclusão.
Ambientes separados: dev, staging, produção
Assim como você não testa código direto em produção, não deveria testar prompt direto em produção.
A estratégia de ambientes funciona da seguinte forma:
Dev: time experimenta livremente, cria variações, testa ideias sem impacto em usuário. Versões de prompt nesse ambiente são instáveis e não devem ir para produção sem validação.
Staging: espelho de produção onde versões promissoras passam por teste de regressão completo, validação de schema, checagem de custo e análise de latência. Só passa para produção prompt que rodou em staging sem regressão.
Produção: ambiente com versão pinada, rastreada e com rollback automático em caso de degradação de métrica crítica. Mudança aqui acontece de forma controlada, progressiva e monitorada.
Plataformas modernas de LLMOps permitem que cada ambiente aponte para versão diferente do mesmo prompt, e a promoção entre ambientes seja feita via interface, não via deploy de código.
Deploy progressivo e A/B test
Colocar versão nova de prompt direto em 100% do tráfego é arriscado. Melhor validar comportamento em produção com tráfego real, mas de forma controlada.
Canary release: liberar versão nova para 5-10% do tráfego, monitorar métricas por algumas horas ou dias e só expandir se tudo estiver dentro do esperado. Se métrica crítica degrada, rollback automático antes que afete todo mundo.
A/B test: rodar duas versões simultaneamente e comparar performance lado a lado em mesmas condições. Isso permite decisão baseada em dado, não em intuição. Métricas típicas incluem taxa de sucesso da tarefa, satisfação do usuário, custo por interação e tempo de resposta.
Feature flags ajudam a controlar qual versão serve qual segmento de usuário, permitindo rollout gradual ou rollback imediato sem tocar em código.
Observabilidade: como saber se o prompt está funcionando em produção
Prompt em produção precisa de telemetria contínua, não de revisão manual semanal.
Observabilidade de prompt cobre alguns pontos:
Correlação entre versão de prompt e métricas de performance: cada trace de chamada ao modelo deve carregar metadado de qual versão de prompt foi usada. Com isso, você filtra traces por versão e vê exatamente como cada uma se comporta em latência, custo, taxa de erro e qualidade percebida.
Dashboards com tendências por versão: visualizar evolução de métricas ao longo do tempo, separado por versão de prompt. Pico de erro ou latência associado a uma versão específica sinaliza regressão.
Busca semântica em traces de produção: capacidade de procurar interações problemáticas por conteúdo, não só por código de erro. Isso ajuda a identificar padrões de falha que não aparecem em métrica agregada.
Alertas automáticos: configurar limites para taxa de erro, latência média, custo por requisição e score de qualidade. Quando métrica ultrapassa threshold, sistema dispara alerta e, se configurado, faz rollback automático para versão estável.
Ferramentas como Datadog LLM Observability, LangWatch, Braintrust e outras oferecem essas capacidades prontas, integrando observabilidade de prompt com telemetria geral do sistema.
Guardrails: validação de saída antes de chegar no usuário
Modelo probabilístico erra, inventa e às vezes ignora instrução. Guardrails são camadas de validação que bloqueiam saída ruim antes dela virar problema.
Tipos comuns de guardrail:
Validação de schema: checar se JSON gerado tem todos os campos obrigatórios, tipos corretos e valores dentro de range esperado. Output que não passa nisso é descartado ou reenviado para nova tentativa.
Filtros de conteúdo: bloquear respostas que contenham linguagem inadequada, dados sensíveis ou informação proibida por política. Isso pode ser feito via regex, modelo de classificação ou LLM-as-a-judge.
Checagem de grounding: validar se a resposta está baseada no contexto fornecido ou se o modelo está inventando. Particularmente crítico em RAG, onde a resposta precisa vir do documento recuperado, não do conhecimento geral do modelo.
Fallback definido: quando guardrail detecta problema, o sistema precisa saber o que fazer. Pode ser mensagem genérica de erro, retry com prompt ajustado ou escalonamento para humano.
Implementar guardrails como prompt separado, com versionamento próprio e validação dedicada, facilita manutenção e permite ajuste sem mexer no prompt principal.
Integração com CI/CD: prompt como código
Tratar prompt como código significa plugar ele no mesmo fluxo de desenvolvimento que o resto do sistema.
Pipeline típico:
-
Dev cria branch e ajusta prompt
Prompt armazenado em arquivo versionado no repositório ou em plataforma externa referenciada por ID. -
Pull request dispara teste automatizado
Suite de regressão roda contra versão nova, validando formato, acurácia, custo e latência. Se falhar, PR é bloqueado. -
Aprovação e merge
Após validação técnica e revisão de pares, mudança é aceita e versão nova entra em staging. -
Deploy para produção via feature flag ou canary
Rollout controlado com monitoramento ativo. Se métrica crítica degrada, rollback automático.
Esse fluxo traz rigor de engenharia para algo que antes era texto solto em variável hardcoded. Ferramentas como GitHub Actions, GitLab CI e outras conseguem rodar testes de prompt da mesma forma que rodam testes unitários.
Casos reais onde falta de disciplina quebrou produção
Vou dar dois exemplos que aparecem direto:
Caso 1: Prompt alterado sem versionamento
Time ajusta prompt para melhorar resposta em um cenário específico. Dois dias depois, começam reclamações de que outro fluxo parou de funcionar. Como não tinha versionamento nem teste de regressão, levou horas para identificar que o ajuste no prompt foi a causa. Rollback manual, impacto em usuário, confiança abalada.
Caso 2: Deploy sem A/B test
Prompt novo promete reduzir custo de token em 30%. Time faz deploy direto em 100% do tráfego. No dia seguinte, métrica de satisfação do usuário despenca porque o prompt mais curto está omitindo informação crítica. Rollback emergencial, mas já tinha afetado milhares de interações.
Nos dois casos, faltou o básico: versionamento, teste automatizado e rollout progressivo.
Como começar a aplicar isso no seu time
Você não precisa implementar tudo de uma vez. Dá para começar pequeno e ir expandindo conforme o time ganha confiança.
Passo 1: Tirar prompt do código
Mover prompts para arquivos separados ou para plataforma de gerenciamento. Isso já facilita versionamento e experimentação sem deploy.
Passo 2: Versionar explicitamente
Adotar convenção de versionamento semântico e documentar motivo de cada mudança.
Passo 3: Criar suite de teste mínima
Começar com dez casos de teste cobrindo cenários críticos. Rodar manualmente antes de cada mudança. Depois automatizar.
Passo 4: Implementar ambientes
Separar dev, staging e produção. Promover versão entre ambientes de forma controlada.
Passo 5: Adicionar observabilidade
Instrumentar aplicação para capturar versão de prompt usada em cada trace. Construir dashboard básico de latência, custo e taxa de erro por versão.
Passo 6: Experimentar A/B test
Escolher uma mudança de prompt e testar em 10% do tráfego antes de expandir. Comparar métricas e tomar decisão baseada em dado.
Conforme esses passos viram rotina, o time ganha velocidade e segurança para iterar em prompt sem medo de quebrar produção.
Conclusão: prompt engineering é engenharia de verdade
No fim das contas, prompt engineering que funciona em produção não é sobre escrever texto bonito. É sobre tratar prompt como artefato crítico do sistema, com versionamento, teste, observabilidade, rollback e governança.
Empresas que conseguiram escalar IA falam isso: a diferença entre demo e produção é disciplina de engenharia. Prompt versionado, testado e monitorado permite iteração rápida sem sacrificar confiabilidade.
Se você lidera time que está colocando IA em produção, esse é o momento de trazer prompt para dentro do ciclo de desenvolvimento com o mesmo rigor que você já aplica em código, infraestrutura e dados.
Insights & Takeaways
- Prompt hardcoded no código impede versionamento, rollback e experimentação segura.
- Versionamento semântico de prompt (MAJOR.MINOR.PATCH) traz clareza sobre risco e impacto de mudanças.
- Testes automatizados de prompt cobrem regressão funcional, validação de formato, custo, latência e detecção de alucinação.
- Ambientes separados (dev, staging, produção) e deploy progressivo (canary, A/B test) reduzem risco de mudança.
- Observabilidade de prompt em produção permite correlação direta entre versão e métricas de performance, facilitando debug e decisão.