IA First · Episódio 23
From Batch to Real Time: IA em Baixa Latência Para Casos Críticos
Como pôr IA em fraude, trading e decisões de milissegundos: modelo pequeno, precomputo, inferência local, decisão assíncrona e fallback determinístico.
Neste artigo · 12 seções
- O cenário onde o tempo é o produto
- O que conta como "tempo real" em IA
- Onde a latência vai em IA
- Modelos pequenos: a alavanca mais óbvia e mais subestimada
- Precomputo: tirar o trabalho do caminho crítico
- Inferência local: quando o provedor não basta
- Decisão assíncrona: o truque arquitetural
- Modelos cascateados em microssegundos vs. segundos
- Fallback: o que fazer quando o provedor falha
- Otimização do prompt: enxugar pra correr
- Conclusão
- Insights & Takeaways
O cenário onde o tempo é o produto
Tem situações onde uma resposta em três segundos é tão inútil quanto não responder. Decisão de fraude num pagamento que precisa autorizar em milissegundos pra não derrubar a experiência do cliente. Sinal de trading que vale algo agora e nada em meio segundo. Roteamento de uma chamada em call center antes que o cliente desista. Score de risco numa transação financeira que precisa concluir antes do timeout do sistema externo.
Nesses cenários, IA não é só uma feature; é uma decisão que tem que entrar num orçamento de tempo apertado, com outras coisas competindo pelo mesmo orçamento. Latência deixa de ser métrica que você acompanha pra ser restrição que define o que é possível.
E aí o time descobre uma coisa desconfortável. As APIs de LLM, mesmo as rápidas, têm latência típica de centenas de milissegundos a alguns segundos. Mais variância do que sistemas tradicionais. Sujeitas a picos do provedor. Em casos críticos, isso é simplesmente inaceitável.
Esse artigo é sobre como fazer IA em ambientes onde latência importa de verdade. Não é sobre fazer chatbot um pouco mais rápido; é sobre as decisões arquiteturais que viabilizam IA em sistemas onde milissegundos têm consequência real.
O que conta como "tempo real" em IA
Antes de discutir técnicas, vale alinhar vocabulário. "Tempo real" significa coisas muito diferentes em contextos diferentes.
Tempo real duro (hard real-time). Resposta tem que sair dentro de um prazo absoluto, sempre. Sistemas embarcados, controle industrial, alguns sistemas financeiros de alta frequência. Latência de microssegundos a poucos milissegundos. LLMs via API não atendem esse perfil. Modelos especializados, locais, otimizados, talvez.
Tempo real interativo. Resposta percebida como instantânea pelo usuário. Tipicamente abaixo de 200ms pra interações tipo digitação, abaixo de 1 segundo pra interações tipo clique. Aqui dá pra trabalhar com modelos rápidos e otimização de pipeline.
Tempo near-real-time. Resposta em poucos segundos. A maioria das interações conversacionais cabe aqui. Boa parte dos modelos modernos atende.
Batch. Resposta em minutos, horas ou mais. Processamento em lote. Sem restrição de latência, otimização vai pra custo e throughput.
A primeira pergunta que define a arquitetura é: em qual desses buckets o caso de uso cai? Misturar os critérios leva a otimizações erradas.
Onde a latência vai em IA
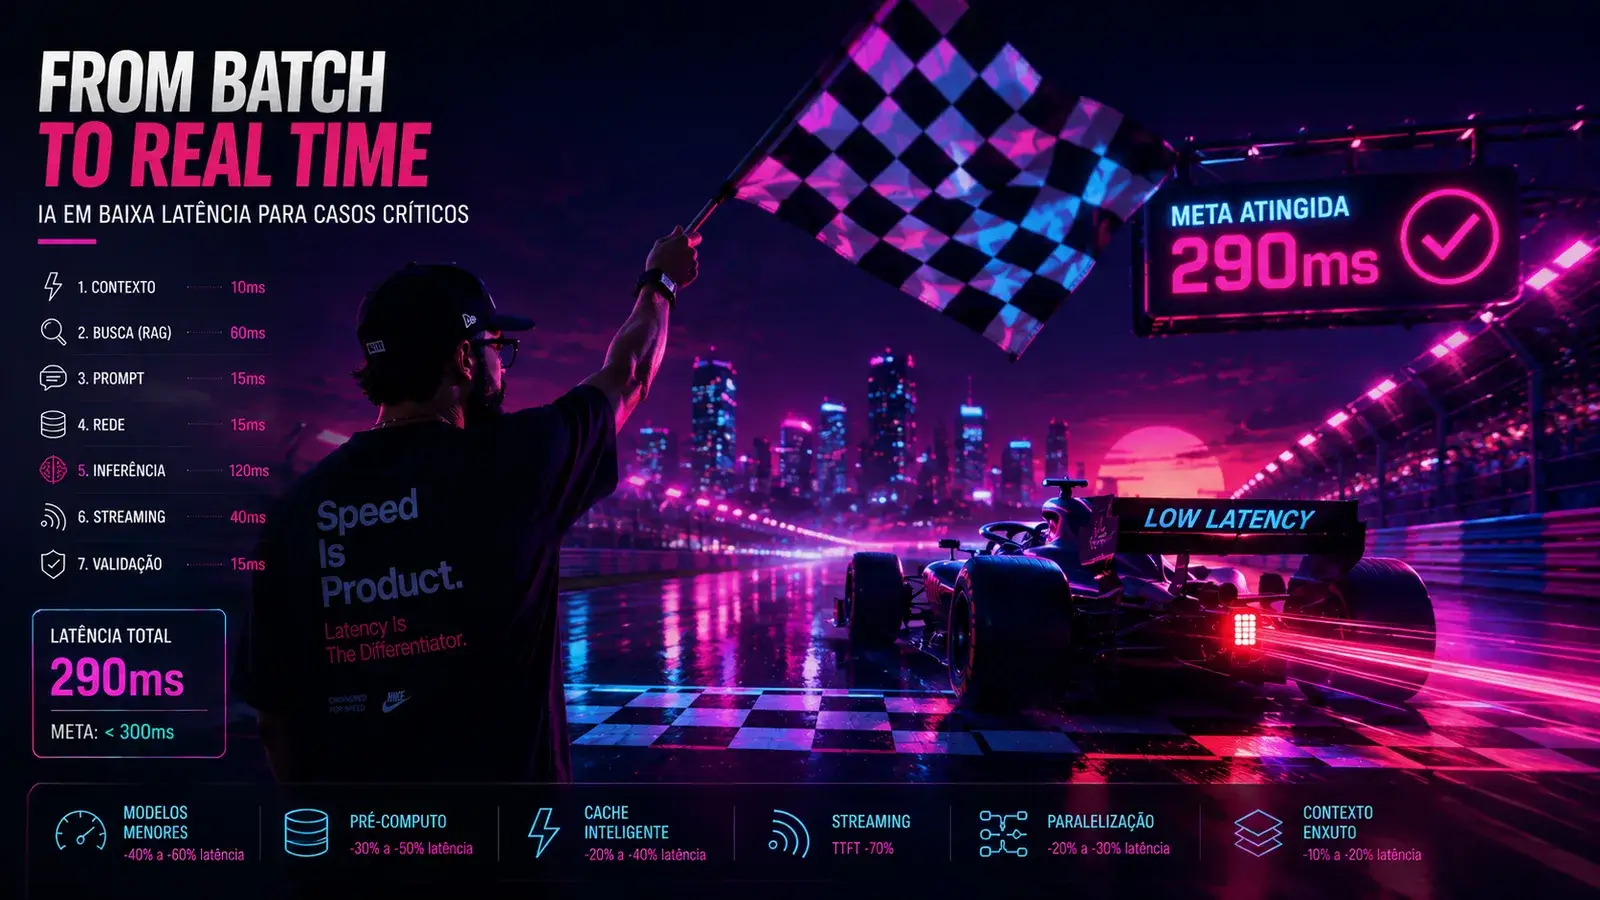
Pra reduzir latência, primeiro é preciso entender onde ela é gasta. Numa chamada típica a um sistema de IA, o tempo se distribui em várias etapas:
Cada etapa contribui pro orçamento de tempo. Vamos por partes.
Preparação de contexto é tipicamente rápido (alguns milissegundos), mas pode crescer se envolve queries pesadas em banco. Em casos críticos, essas queries precisam estar otimizadas, possivelmente em cache.
Busca em RAG é onde muitos sistemas perdem tempo. Embedding da query, busca vetorial, rerank, montagem dos chunks. Pode passar de 100ms facilmente. Em latência crítica, ou você pré-computa, ou troca por busca mais simples.
Chamada de rede ao provedor. Tipicamente 20-100ms pra estabelecer e enviar request. Multi-region ajuda; servidor próximo do provedor ajuda.
Inferência. É o componente maior. Modelos grandes gastam centenas de milissegundos pra primeira resposta, e a geração contínua é proporcional ao tamanho da saída. Pra latência baixa, modelo pequeno ou geração com saída curta.
Streaming. Importante distinguir time-to-first-token (latência até o primeiro token aparecer) de tempo total. Pra UX, primeiro token cedo já transmite responsividade. Pra decisão automatizada, o tempo total é o que importa.
Validação e parsing. Geralmente rápido se o output é estruturado e bem definido. Lento quando envolve validação semântica via outro modelo.
Cada componente desse pode ser atacado pra reduzir latência. As técnicas que vou listar são as que mais entregam ganho.
Modelos pequenos: a alavanca mais óbvia e mais subestimada
A forma mais direta de reduzir latência é usar um modelo menor. Modelos pequenos têm time-to-first-token tipicamente entre 50-200ms; modelos grandes ficam entre 300ms-2s. Em volume, esse delta determina viabilidade.
A objeção comum: "mas o modelo pequeno é menos capaz". Verdade pra tarefas abertas e complexas. Falso pra tarefas estreitas e bem definidas, que é o caso da maioria das decisões em latência crítica.
Sistemas de fraude raramente pedem "raciocine sobre essa situação complexa". Pedem "classifique essa transação como suspeita ou não, com base nessas 20 features". Pra isso, modelo pequeno fine-tuned bate modelo grande genérico, com fração da latência e do custo.
A escolha do modelo deveria começar pela latência exigida, não pela capacidade aspirada. Pergunte: qual o menor modelo que entrega qualidade aceitável pra essa tarefa? Esse é o ponto de partida.
Precomputo: tirar o trabalho do caminho crítico
Tudo que pode ser feito antes da decisão crítica deveria ser feito antes. Isso é precomputo, e é a alavanca de latência mais poderosa em sistemas de IA.
Embeddings precomputados. Em RAG, os documentos precisam ser embedados uma vez na indexação, não a cada query. Isso é óbvio. Menos óbvio: a query do usuário também pode ter embedding precomputado se o conjunto de queries comuns é pequeno e identificável.
Decisões precomputadas pra entidades. Imagine um sistema de fraude. Em vez de "calcular risco do cliente X no momento da transação", você precomputa diariamente o score de risco de todos os clientes com base no histórico, e na transação só atualiza com sinais novos. A decisão crítica em tempo real combina o score precomputado com poucos sinais frescos, em vez de calcular tudo do zero.
Features agregadas em janelas. Sinais como "número de transações na última hora" não devem ser calculados na hora; devem ser mantidos em estruturas que atualizam continuamente (streaming aggregations, time-series database, contadores) e consultados em O(1).
Cache de resposta. Pra queries que se repetem (FAQ, perguntas comuns), cachear a resposta exata. Latência cai pra acesso de cache: sub-milissegundo.
A regra geral: tudo que não depende dos bits específicos do request atual deveria estar precomputado. Quanto mais trabalho fora do caminho crítico, mais espaço no orçamento de tempo pra o que realmente precisa acontecer ali.
Inferência local: quando o provedor não basta
Em latências realmente baixas (abaixo de 100ms total, por exemplo), API externa não viabiliza. Round-trip de rede já come boa parte do orçamento. Aí entra inferência local: rodar modelo na mesma rede do consumidor.
Modelo em GPU dedicada. Modelos open source (Llama, Mistral) rodando em GPU própria. Latência de inferência de algumas dezenas de milissegundos pra modelos médios, ainda mais rápido pra modelos quantizados.
Modelo em CPU otimizada. Pra modelos pequenos (até alguns bilhões de parâmetros), inferência em CPU com bibliotecas otimizadas (llama.cpp, ONNX Runtime, vLLM) pode entregar latência suficiente. Custa menos que GPU, mas tem limite de tamanho.
Modelos especializados. Não-LLM. Classificadores tradicionais (XGBoost, modelos de árvore, redes neurais pequenas) que rodam em microssegundos. Pra muitas decisões de risco, fraude e roteamento, esses ainda são os mais usados, e por bom motivo: latência absurda, previsibilidade, custo desprezível.
A combinação típica em casos críticos: modelo especializado pra decisão principal (rápido, previsível), com modelo de linguagem entrando só onde linguagem natural está realmente envolvida, frequentemente assíncrono pra não bloquear o caminho crítico.
Decisão assíncrona: o truque arquitetural
Nem toda decisão de IA precisa estar no caminho síncrono. Em vários casos críticos, uma decisão tomada de forma rápida (regra ou modelo simples) é suficiente pra responder ao usuário, e a análise mais sofisticada acontece em paralelo.
Exemplo: aprovação de transação. A decisão imediata vai por um modelo rápido. A transação é aprovada ou recusada em milissegundos. Em paralelo, um pipeline assíncrono dispara análise mais profunda (modelo grande, agregação de mais sinais, possivelmente revisão humana). Se essa análise detectar problema, ações compensatórias são tomadas: reverter, alertar, bloquear cliente, abrir investigação.
Esse padrão tira do caminho crítico tudo que não cabe lá. Você fica com baixa latência na resposta ao usuário e ainda assim usa o modelo mais capaz, só que de forma assíncrona.
Funciona em sistemas onde a ação imediata é reversível ou onde o custo de uma decisão inicial sub-ótima é menor que o custo de adicionar latência pra todos.
Modelos cascateados em microssegundos vs. segundos
A cascata que discutimos no artigo sobre arquiteturas híbridas é particularmente útil em latência crítica, mas com uma virada interessante: a cascata trabalha em escalas de tempo diferentes.
A primeira camada é determinística e mede em microssegundos. Regras rápidas que conseguem decidir clareza em uma direção: "claramente legítima" ou "claramente fraude" passam direto.
A segunda camada é um modelo pequeno e rápido, mede em milissegundos. Lida com casos que regras não decidem claramente.
A terceira camada é a análise profunda, mede em segundos ou minutos, e acontece assincronamente sobre os casos que mesmo o modelo pequeno marcou como ambíguos. A decisão imediata na segunda camada é provisória; a terceira camada pode ajustar.
A maioria das transações cai nas duas primeiras camadas. A análise cara é reservada pros casos que realmente exigem, o que mantém o sistema viável em escala.
Fallback: o que fazer quando o provedor falha
Em latência crítica, falha do provedor não pode resultar em request travado. Timeout precisa ser agressivo e fallback precisa ser claro.
Algumas estratégias funcionam:
Timeout proporcional ao orçamento. Se a decisão tem 100ms de orçamento e a chamada de IA já gastou 80ms, aborta e cai pro fallback. Não vale a pena esperar.
Múltiplos provedores em paralelo (com primeira resposta vence). Manda a mesma chamada pra dois provedores simultaneamente; usa a resposta que voltar primeiro. Custa o dobro em tokens, mas garante latência. Justifica em casos críticos de alto valor.
Fallback determinístico. Se o modelo não responde no tempo, uma regra clássica assume. A decisão pode ser sub-ótima, mas existe, e respeita o orçamento de tempo.
Circuit breaker por latência. Se a latência do provedor está degradada por alguns minutos (medida por p95 acima de threshold), o sistema decide preventivamente parar de chamar e ir direto pro fallback. Quando a latência volta a normal, volta a chamar.
Sem essas proteções, o sistema fica refém do provedor. Em produção crítica, é inaceitável.
Otimização do prompt: enxugar pra correr
Tamanho de prompt afeta latência diretamente. Cada token de entrada precisa ser processado antes da geração começar; isso é particularmente sensível em modelos grandes.
Algumas otimizações que pagam:
System prompt enxuto. Tirar exemplos few-shot desnecessários, instruções redundantes, descrições de tools que não se aplicam ao caso atual. Cada token economizado entra no orçamento de outra parte.
Contexto RAG enxuto. Em casos críticos, recuperar menos chunks e mais precisos. Reranking que descarta chunks de baixa relevância antes de mandar pro modelo.
Tamanho máximo da resposta. Configurar max_tokens agressivo. Resposta de 100 tokens chega em menos tempo que resposta de 500 tokens, e em muitos casos 100 bastam.
Streaming pra UX. Não reduz latência total, mas reduz latência percebida. O usuário vê resposta começando a aparecer antes do total estar pronto. Útil em interfaces; irrelevante em decisões automatizadas.
Conclusão
IA em baixa latência não é "a mesma IA, só mais rápido". É um conjunto de decisões arquiteturais que partem da restrição de tempo. Modelo pequeno em vez de grande sempre que viável. Trabalho fora do caminho crítico via precomputo. Inferência local quando rede vira gargalo. Decisão assíncrona pra tirar análise sofisticada do caminho síncrono. Cascata em escalas de tempo diferentes. Fallback determinístico pra quando algo falha.
Cada uma dessas técnicas tem custo: complexidade, infraestrutura, manutenção, perda parcial de capacidade. Mas em casos onde latência define viabilidade, esse custo é o que viabiliza o produto.
A pergunta que orienta bem cada decisão: "se meu orçamento de tempo é X milissegundos, o que cabe nele de forma confiável?" Tudo que não cabe ou sai do caminho ou vira assíncrono ou vira regra. Resistir a essa disciplina é o que faz protótipos de baixa latência nunca chegarem em produção.
Insights & Takeaways
-
"Tempo real" significa coisas diferentes em contextos diferentes. Definir em qual bucket o caso de uso cai (hard real-time, interativo, near-real-time, batch) é a primeira decisão; misturar critérios leva a otimizações erradas.
-
Modelo pequeno é a alavanca de latência mais subestimada. Pra tarefas estreitas e bem definidas (a maioria das decisões críticas), modelo pequeno fine-tuned bate modelo grande genérico em latência, custo e às vezes em qualidade.
-
Precomputo tira trabalho do caminho crítico. Embeddings, decisões agregadas, features em janela, cache de respostas comuns. Tudo que não depende dos bits específicos do request deveria estar pronto antes.
-
Decisão assíncrona é o truque arquitetural que viabiliza IA em casos críticos. Decisão imediata por modelo rápido ou regra; análise profunda em paralelo, com ações compensatórias se detectar problema depois.
-
Fallback determinístico não é opcional em latência crítica. Timeout agressivo, regra clássica quando o modelo não responde no tempo, circuit breaker por latência. Sem isso, o sistema fica refém do provedor.