IA First · Episódio 13
Orquestração de Fluxos de IA: De um Prompt Solto para um Workflow Confiável
Do prompt único a um workflow de IA confiável: quando usar código, state machine, fila ou agente, e como tratar retry, idempotência e revisão humana.
Neste artigo · 10 seções
- O momento em que o prompt solto não dá mais conta
- O que realmente é orquestração de IA
- Os quatro padrões de orquestração
- Quando cada padrão faz sentido
- Confiabilidade: o que muda quando tem LLM no workflow
- Idempotência: o conceito que salva fluxos
- Human-in-the-loop: quando o workflow precisa pausar
- Observabilidade de workflows: rastreando execuções complexas
- Conclusão
- Insights & Takeaways
O momento em que o prompt solto não dá mais conta
Todo projeto de IA começa com um único prompt. Você manda a pergunta, o modelo responde, pronto. Funciona pra classificação, pra resumo, pra Q&A simples. Aí o produto evolui e alguém pede algo como: "o usuário envia um PDF, a gente extrai dados, consulta o CRM, gera um resumo, cria um ticket e notifica o gestor por e-mail".
De repente, um prompt não resolve. Você precisa de vários passos encadeados, com dados fluindo entre eles, com pontos de decisão, com tratamento de erro, com retry, com possibilidade de voltar atrás. É aqui que entra orquestração de fluxos de IA.
Esse artigo é sobre como pensar e implementar essa camada. Quando orquestração manual basta, quando frameworks ajudam, quando o problema é na verdade um state machine clássico, e o que muda em confiabilidade quando você tem LLMs no meio do workflow.
O que realmente é orquestração de IA
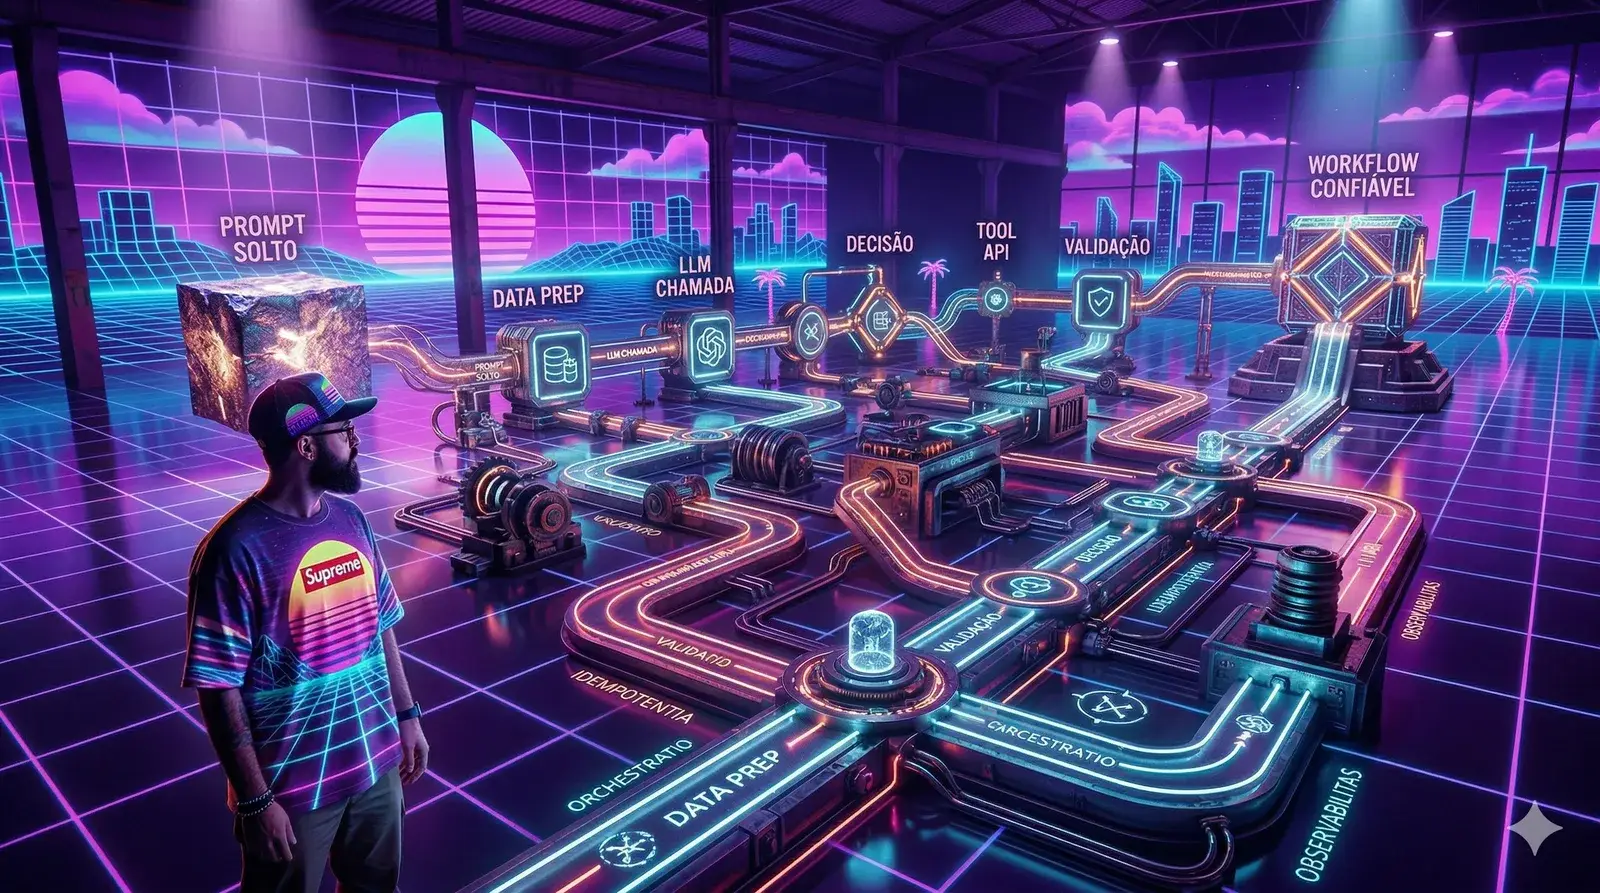
Orquestração de IA é o trabalho de coordenar múltiplas chamadas (a modelos, a tools, a serviços externos) pra entregar um resultado de negócio. O modelo deixa de ser a estrela e vira um componente num fluxo maior.
Um fluxo típico tem quatro tipos de passo:
Cada setinha ali é um ponto de falha potencial. O LLM pode retornar algo fora do schema esperado. A API externa pode estar fora. A validação pode reprovar. A persistência pode conflitar. Um workflow confiável precisa lidar com cada um desses cenários sem derrubar a experiência do usuário.
Os quatro padrões de orquestração
Na prática, existem quatro formas principais de orquestrar fluxos de IA. Cada uma serve pra um tipo de problema.
Orquestração imperativa em código é o mais direto. Você escreve o fluxo como código normal: chama o modelo, pega o resultado, faz um if, chama a próxima coisa. Funciona bem quando o fluxo é previsível, os passos são poucos, e o código do orquestrador é o seu serviço de domínio. É o equivalente a escrever um pipeline procedural. Simples, debugável, sem mágica. A maioria dos fluxos de IA em produção deveria começar assim, não com framework.
State machines são o passo seguinte quando o fluxo tem estados explícitos e transições bem definidas. "Aguardando upload", "processando extração", "aguardando revisão humana", "concluído". Pense em ferramentas como AWS Step Functions, Temporal, ou implementações caseiras. State machines brilham quando o fluxo é longo (horas ou dias), tem pausas, precisa sobreviver a reinicializações do serviço, e exige auditoria rigorosa de cada transição. LLMs entram como "atividades" dentro dos estados, não como o orquestrador.
Filas de mensagens funcionam quando o fluxo é assíncrono por natureza e os passos são desacoplados no tempo. Um evento chega numa fila, um worker processa (possivelmente chamando um LLM), publica o resultado em outra fila, outro worker pega. É robusto, escalável e tolerante a falhas. O preço é que visualizar o fluxo fica mais difícil; você precisa de tracing distribuído pra entender o caminho completo de um request.
Frameworks de agentes são o quarto padrão e o mais badalado. LangGraph, CrewAI, AutoGen e outros permitem definir fluxos onde o próprio modelo decide qual passo tomar a seguir. Em vez de você escrever if resultado == X then chama Y, o modelo recebe uma lista de ferramentas e decide qual usar iterativamente. Parece poderoso, e é, mas tem um custo: imprevisibilidade. O mesmo input pode gerar caminhos diferentes. Debugar fica difícil. Usar esse padrão pra fluxos que poderiam ser determinísticos é engenharia mal aplicada.
Minha opinião honesta: a maioria dos fluxos de IA em produto não deveria usar framework de agente. Deveria usar orquestração imperativa ou state machine. Agente é a resposta certa quando o espaço de decisão é grande demais pra enumerar, não quando o time não quis escrever os ifs.
Quando cada padrão faz sentido
Tem uma matriz simples que ajuda a escolher:
Repara que a árvore sempre tenta voltar pro mais simples. Isso é intencional. Cada camada de sofisticação adiciona custo operacional. A pergunta certa não é "qual o framework mais moderno?", é "qual o mais simples que resolve o problema?"
Confiabilidade: o que muda quando tem LLM no workflow
Um workflow tradicional lida com duas classes de falha: erros determinísticos (um serviço caiu, um dado é inválido) e falhas transitórias (timeout, rate limit). Retry com backoff resolve muita coisa.
Com LLM no meio, aparecem novos tipos de falha que retry não resolve sozinho.
O modelo retorna algo válido mas errado. A resposta está no formato certo, passa no schema, mas o conteúdo é ruim. Uma classificação errada, um resumo que omite informação crítica, uma extração que inventa um campo. Retry não ajuda aqui; o modelo vai gerar algo igualmente ruim ou até pior na segunda tentativa. A mitigação é validação semântica pós-geração: checar se a resposta é consistente com a entrada, se os campos extraídos existem no texto original, se o resumo cobre os pontos-chave.
O modelo retorna algo inválido no formato. Você pediu JSON com três campos, veio JSON com dois e uma frase em prosa no meio. Aqui o retry com instrução de correção funciona melhor. Você devolve pro modelo o erro de parsing e pede correção. Na segunda ou terceira tentativa, normalmente acerta. Mas precisa ter um limite: se depois de três tentativas ainda falha, o workflow precisa ter um caminho de fallback, não ficar num loop eterno.
O modelo decide fazer a coisa errada em fluxos agênticos. Chama a tool errada, escolhe o caminho errado, entra em loop chamando a mesma coisa repetidamente. Aqui, a proteção é arquitetural: limite máximo de passos por execução, detecção de loops (mesma chamada repetida), e timeout global do workflow.
Idempotência: o conceito que salva fluxos
Fluxos de IA geralmente envolvem ações com efeito colateral: criar registro, enviar e-mail, chamar API externa paga. Se o workflow falha no meio e precisa ser retomado, você não quer enviar o e-mail duas vezes nem criar o ticket em duplicidade.
Idempotência é garantir que executar o mesmo passo várias vezes produz o mesmo efeito que executar uma vez só. A implementação clássica é atribuir um ID único pra cada execução do passo e verificar, antes de executar, se aquele ID já foi processado. Se já foi, retorna o resultado anterior sem executar de novo.
Em fluxos com LLM, idempotência tem uma camada extra: a resposta do modelo pode variar mesmo pra entrada idêntica. Se você retry uma chamada que custou $0.08 em tokens, você vai pagar os $0.08 de novo. Pior: pode receber uma resposta diferente e quebrar a consistência do fluxo. Uma prática que ajuda é cachear o resultado do modelo por chave determinística (hash do prompt + parâmetros) durante a execução do workflow. Se o passo é retomado, usa o resultado cacheado em vez de chamar o modelo de novo.
Human-in-the-loop: quando o workflow precisa pausar
Muitos fluxos de IA em produção precisam de aprovação humana em algum ponto. "A IA extraiu esses dados, um humano revisa antes de persistir." "A IA sugere essa resposta, o atendente aprova antes de enviar." "A IA prepara o rascunho do contrato, o jurídico valida."
Isso complica a orquestração porque o workflow precisa pausar, possivelmente por horas ou dias, esperando a ação humana. Orquestração imperativa em código simples não dá conta: o processo não pode ficar com um request HTTP aberto por 48 horas esperando aprovação.
As opções viáveis são state machines duráveis (Temporal é a referência aqui; o workflow pausa, o estado fica persistido, retoma quando o evento de aprovação chega) ou fluxos baseados em fila com estado persistido em banco (mais manual, mas funciona). Em ambos os casos, o passo de "esperar humano" é um estado explícito do workflow, com timeout configurado (se ninguém aprovar em 3 dias, o que acontece?) e notificação pra quem precisa agir.
Na prática, fluxos com human-in-the-loop se parecem com isso:
Cada estado é persistido. O workflow sobrevive a reinício de serviço, deploy, crash. A ação humana é só um evento que move o estado.
Observabilidade de workflows: rastreando execuções complexas
Debugar um workflow que falhou no terceiro passo de cinco, depois de três chamadas ao modelo e duas a APIs externas, é infernal sem observabilidade adequada.
O mínimo é tracing distribuído. Cada execução de workflow tem um trace ID. Cada passo dentro do workflow é um span filho. Chamadas ao LLM e a tools ficam como spans dentro de cada passo. Ferramentas como OpenTelemetry, Datadog APM, ou Langfuse (específica pra LLM) cobrem isso.
Além do trace, o log de cada execução precisa registrar: estado inicial, estado final, cada transição com timestamp, input e output de cada passo (resumidos ou por referência pra não inflar o log), tempo gasto em cada passo, custo de tokens acumulado, e motivo de falha se falhou.
Um dashboard útil mostra: taxa de conclusão por tipo de workflow, tempo médio e p95 de execução, taxa de falha por passo (pra identificar gargalos), distribuição de tentativas de retry por passo, e custo médio por execução.
Essa última métrica é a que mais surpreende times em produção. Um workflow que parecia simples pode estar custando $0.40 por execução por causa de múltiplas chamadas ao modelo no meio. Multiplique por volume diário e a conta fica visível.
Conclusão
Orquestração de IA é, no fundo, engenharia de workflow com uma nova classe de componente no meio. Os fundamentos continuam os mesmos: definir estados, tratar falhas, garantir idempotência, persistir quando necessário, observar tudo. O que muda é a natureza do componente LLM: probabilístico, caro por chamada, com modos de falha novos (resposta válida mas semanticamente errada).
O erro mais comum que eu vejo é pular direto pra framework de agente porque está na moda. Na maioria dos casos, uma orquestração imperativa em código, com validação nos pontos certos e um state machine pros fluxos mais longos, resolve melhor, é mais previsível e custa menos pra operar. Framework de agente é ótimo quando o problema realmente exige, não como default.
E a pergunta que guia bem as decisões de arquitetura: "se esse workflow falhar no passo 4 de 6, o que acontece?" Se você consegue responder com confiança, está no caminho certo. Se a resposta é "não sei", falta camada.
Insights & Takeaways
-
Orquestração de IA é engenharia de workflow com LLM como componente. Os fundamentos (estados, retry, idempotência, observabilidade) continuam os mesmos; o que muda são os modos de falha.
-
Existem quatro padrões principais: imperativo em código, state machine durável, filas de mensagens e frameworks de agentes. Escolha sempre o mais simples que resolve. Framework de agente não é default.
-
Retry resolve falha transitória, não resolve "modelo retornou algo válido mas errado". Pra isso, validação semântica pós-geração é obrigatória em pontos críticos do fluxo.
-
Idempotência e cache de resultados de LLM por chave determinística evitam que retries custem dinheiro duas vezes e quebrem consistência do workflow.
-
Human-in-the-loop exige workflow durável que sobreviva a pausas longas. State machines como Temporal são feitos pra isso; orquestração imperativa simples não é.