IA de Alta Performance · Episódio 16
O Painel Diz 100% e Isso Não Quer Dizer Nada
GPU em 100% de utilização só diz que algum kernel rodava. Como medir saturação, achar o joelho da curva e planejar capacidade de inferência antes de comprar.
Neste artigo · 7 seções
Vale começar pela definição literal do número que todo mundo olha antes de aprovar a compra de mais GPU.
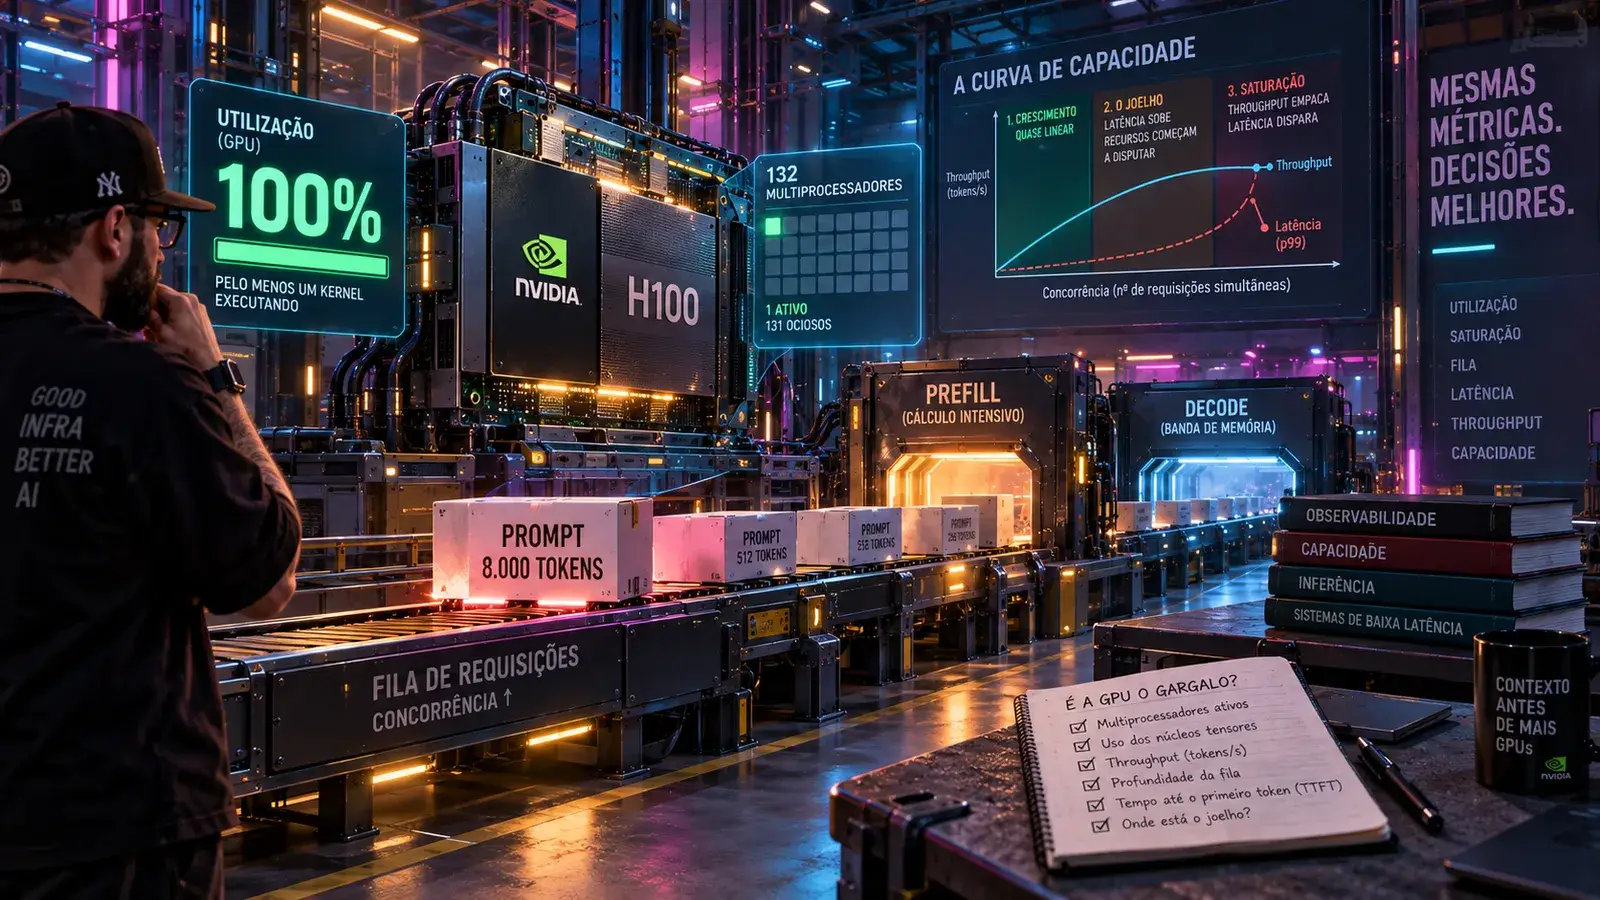
A métrica que aparece como utilização nas ferramentas da NVIDIA mede a porcentagem do tempo, na janela de amostragem, em que pelo menos um kernel estava executando na placa. Pelo menos um. Uma H100 tem 132 multiprocessadores; se um kernel minúsculo ocupar um deles do começo ao fim da janela, o painel marca 100% enquanto 131 unidades dormem.
Ou seja, o número que dá nome à conversa de capacidade é um ciclo de trabalho, não uma medida de quanto da placa está sendo usada. Ele responde "a GPU estava fazendo alguma coisa?", e não "a GPU estava fazendo o quanto pode?". São perguntas diferentes, e a distância entre as duas é onde mora a decisão de infraestrutura mais cara que um time de IA toma.
Este artigo fecha a temporada da sala de máquinas com o assunto que amarra os anteriores: como saber se a sua GPU é mesmo o gargalo, onde fica o ponto em que adicionar carga piora a vida de todo mundo, e por que planejamento de capacidade de inferência se parece muito mais com dimensionar um sistema de baixa latência do que com dimensionar um cluster web.
utilização, saturação e a diferença que muda a decisão
Existe um vocabulário antigo de análise de desempenho que resolve boa parte da confusão, e ele vem de Brendan Gregg: para cada recurso, olhe utilização, saturação e erros.
Utilização é a fração do tempo em que o recurso estava ocupado. Saturação é o tanto de trabalho que não coube e está esperando, a fila. São coisas independentes, e é justamente a segunda que dói: um recurso pode estar 100% utilizado com fila zero, servindo tudo na hora, e pode estar 100% utilizado com quatrocentas requisições empilhadas, entregando p99 de trinta segundos. O painel mostra o mesmo 100% nos dois casos.
Em GPU, essa cegueira é pior que a média por causa de como a métrica é definida. O artigo sobre ociosidade já tinha mostrado que a fração do poder computacional realmente aproveitada no decode fica abaixo de 5%, ou seja, uma placa marcando 100% de utilização durante uma hora inteira de geração de texto estava, em capacidade de cálculo, praticamente parada.
O conjunto mínimo para sair da cegueira tem três camadas. Primeiro, atividade real de silício: a fração dos multiprocessadores ativos e a fração de uso dos núcleos tensores, que as bibliotecas de monitoramento da NVIDIA expõem separadamente da utilização clássica. Segundo, a métrica de aproveitamento que a série já usa, comparando os tokens produzidos com o teto teórico do hardware. Terceiro, e mais importante para decidir, as métricas de fila: profundidade da fila de admissão, tempo médio entre chegar e entrar num lote, e a distribuição do tempo até o primeiro token.
Sem a terceira camada, você não tem como saber se está saturado. E saturação é a única coisa que justifica comprar hardware.
o joelho, e por que ele existe
Coloque num gráfico a concorrência no eixo horizontal e o throughput no vertical. A curva tem três regiões, e reconhecer em qual delas o seu serving opera vale mais do que qualquer otimização pontual.
Na primeira região, cada requisição adicional vira throughput adicional quase de graça. É a região do lote contínuo funcionando bem: a GPU tinha folga, o trabalho novo preenche a folga, a latência individual mal se mexe.
Na segunda, o crescimento perde inclinação. Cada nova sequência já disputa recursos com as que estão dentro: memória de KV cache, largura de banda, o próprio passo de decode que agora carrega mais gente. O throughput ainda sobe, a latência já sobe junto. Esse é o joelho, e ele é o número que deveria estar escrito na parede da sala.
Na terceira, o throughput empaca e a latência dispara. Em sistemas distribuídos, ele pode até cair: a curva vira para baixo e você entrega menos servindo mais gente.
Neil Gunther modelou isso numa fórmula que serve para qualquer sistema, do banco de dados ao time de pessoas. A capacidade em função da concorrência é limitada por dois termos: um de contenção, que representa a parte serializada do trabalho, a disputa por recurso compartilhado, e outro de coerência, que representa o custo de manter as partes em acordo. O primeiro achata a curva; o segundo faz ela virar para baixo. Um sistema com termo de coerência maior que zero tem um ponto de máximo, e depois dele o retorno é negativo por construção matemática, não por má implementação.
Em serving de LLM, esses dois termos têm endereço. A contenção é a disputa pelo passo de decode e pelos blocos de memória. A coerência aparece quando o modelo não cabe numa placa e cada passo exige sincronização entre GPUs, ou quando várias réplicas precisam concordar sobre roteamento e estado de cache. É por isso que dobrar o número de GPUs num modelo grande quase nunca dobra a capacidade, e às vezes piora a latência.
o gargalo errado mais comum: o prefill que atravessa a fila
Tem um caso específico de LLM que gera pânico de capacidade sem que a capacidade seja o problema.
A leitura do prompt e a geração da resposta têm perfis opostos, coisa que esta série trata desde o começo: ler é trabalho denso de cálculo, gerar é trabalho de banda de memória. Quando um prompt de oito mil tokens entra num servidor que está gerando respostas para outras trinta pessoas, aquele passo específico fica longo, e todas as sequências que estavam gerando ficam paradas esperando ele terminar.
O sintoma é característico: o tempo entre tokens de quem já estava sendo atendido piora em picos, e esses picos coincidem com admissões de prompts grandes, não com aumento de carga. Alguém olha o painel, vê 100% de utilização e um p99 feio, e conclui que faltou GPU. Não faltou. O que faltou foi política de escalonamento.
A resposta conhecida é fatiar, e o artigo do trilema já citou o mecanismo de passagem: em vez de processar o prompt inteiro num passo, quebrá-lo em pedaços e intercalar cada pedaço com os passos de geração dos outros. O trabalho total é o mesmo, mas ninguém fica bloqueado. O que faltava era o tamanho do efeito, e o Sarathi-Serve mediu o que essa mudança de escalonamento faz com a capacidade sob restrição de latência: 2,6 vezes mais capacidade num Mistral de 7B numa A100, 3,7 vezes num Yi de 34B em duas placas e 5,6 vezes num Falcon de 180B com paralelismo de pipeline.
Vale ler esses números pelo que eles significam. Nenhum hardware novo entrou, nenhum modelo foi trocado, nenhuma qualidade foi negociada. A mesma máquina passou a atender de duas a cinco vezes mais gente dentro do mesmo limite de latência, porque a ordem em que o trabalho foi organizado mudou. Antes de comprar placa, vale saber se o seu servidor já faz isso.
a ordem de investigação antes de assinar a compra
a parte impopular: recusar cedo
Depois de medir o joelho, ele vira configuração, e aí aparece a decisão que ninguém gosta de tomar. Um serviço que aceita tudo o que chega não está sendo generoso, está adiando o problema: o excesso vira fila, a fila vira latência, e a latência atinge inclusive quem chegou antes e estava sendo bem atendido.
A alternativa é um limite explícito de requisições simultâneas, ajustado no número que o teste de carga mostrou, com o que passa disso recebendo uma recusa rápida e honesta, com indicação de quando tentar de novo. Uma parte do tráfego fica sem resposta imediata e o resto continua dentro do acordo de latência. Quem vem de sistemas de baixa latência convive com isso naturalmente, porque em ambiente de mercado uma resposta atrasada muitas vezes já não vale nada, e aceitar trabalho que não vai caber sai sempre mais caro do que recusar cedo.
Capacidade, nesse desenho, deixa de ser uma descoberta feita durante o incidente e vira um número escolhido de véspera.
o método, em cinco passos
O ponto prático que fecha a temporada, e ele independe de qual servidor você usa.
Comece pelo acordo de latência: escreva o número, para cada tipo de tráfego, antes de medir qualquer coisa. Sem alvo, não existe capacidade, existe só uma curva bonita.
Depois faça o teste de carga com concorrência crescente e degraus estáveis, registrando throughput, tempo até o primeiro token e tempo entre tokens em cada degrau. O joelho é o último degrau em que a distribuição de latência ainda cabe no acordo, e é ele que vira o limite de concorrência da configuração.
Antes de tratar o resultado como teto de hardware, elimine as causas que se parecem com falta de GPU e não são: prefill bloqueando decode, desperdício de memória de KV cache, cliente lento segurando slot, cancelamento que não sobe. Cada uma dessas foi assunto de um artigo desta temporada, e cada uma move o joelho para a direita sem custar um centavo de infraestrutura.
Só então trate como capacidade, e nessa hora existem dois botões, os mesmos do trilema: mais hardware ou menos trabalho por requisição, seja por modelo menor, quantização ou contexto mais curto.
E deixe o painel de capacidade organizado por essa lógica, não por métrica bonita. Um gráfico de utilização sozinho não sustenta decisão nenhuma; ele precisa vir acompanhado de fila, aproveitamento e latência por percentil. É a mesma disciplina de instrumentar o backend desde o primeiro dia, aplicada ao recurso mais caro da casa.
Insights & Takeaways
- A métrica clássica de utilização de GPU mede o tempo em que pelo menos um kernel rodava, não o quanto da placa foi usado. Um kernel ocupando um dos 132 multiprocessadores de uma H100 já marca 100%.
- Utilização e saturação são coisas diferentes, e só a segunda justifica comprar hardware. Sem métricas de fila, profundidade e tempo de espera na admissão, não dá para saber se o sistema está saturado ou apenas ocupado.
- A curva de throughput contra concorrência tem um joelho, e a lei de escalabilidade universal explica por quê: contenção achata a curva e coerência pode virá-la para baixo. Dobrar GPUs num modelo grande raramente dobra capacidade.
- O gargalo errado mais comum é escalonamento, não capacidade: um prompt grande bloqueia o decode de todo mundo. Fatiar o prefill e intercalar com a geração rendeu de 2,6 a 5,6 vezes mais capacidade sob a mesma restrição de latência, sem trocar hardware.
- Capacidade é um número escolhido: meça o joelho, transforme em limite de concorrência e rejeite rápido o excesso. Fila silenciosa é latência distribuída para quem já estava sendo bem atendido.
Uma pergunta honesta pra fechar: até quantas requisições simultâneas o seu serving ainda cumpre o acordo de latência? Enquanto esse número não estiver escrito em algum lugar, a próxima conversa sobre comprar mais GPU vai ser decidida por um painel que mede se a placa estava fazendo alguma coisa, e não o quanto ela ainda tinha para dar.
Com este artigo, a sala de máquinas fecha. Percorremos o cache que evita gerar, o lote que nunca fecha, a memória paginada que multiplicou a lotação, a aposta que converte ociosidade em latência menor, a corrente de backpressure que protege a capacidade e, agora, o painel que decide quando de fato falta hardware. O próximo arco muda o alvo: sai da geração e entra na busca, a metade do RAG que quase ninguém mede e que responde por uma fatia teimosa da latência que todo mundo credita ao modelo.