IA First · Episódio 8
Arquitetura de Um Backend Pronto Para IA: Contexto, Logs e Telemetria Desde o Dia 1
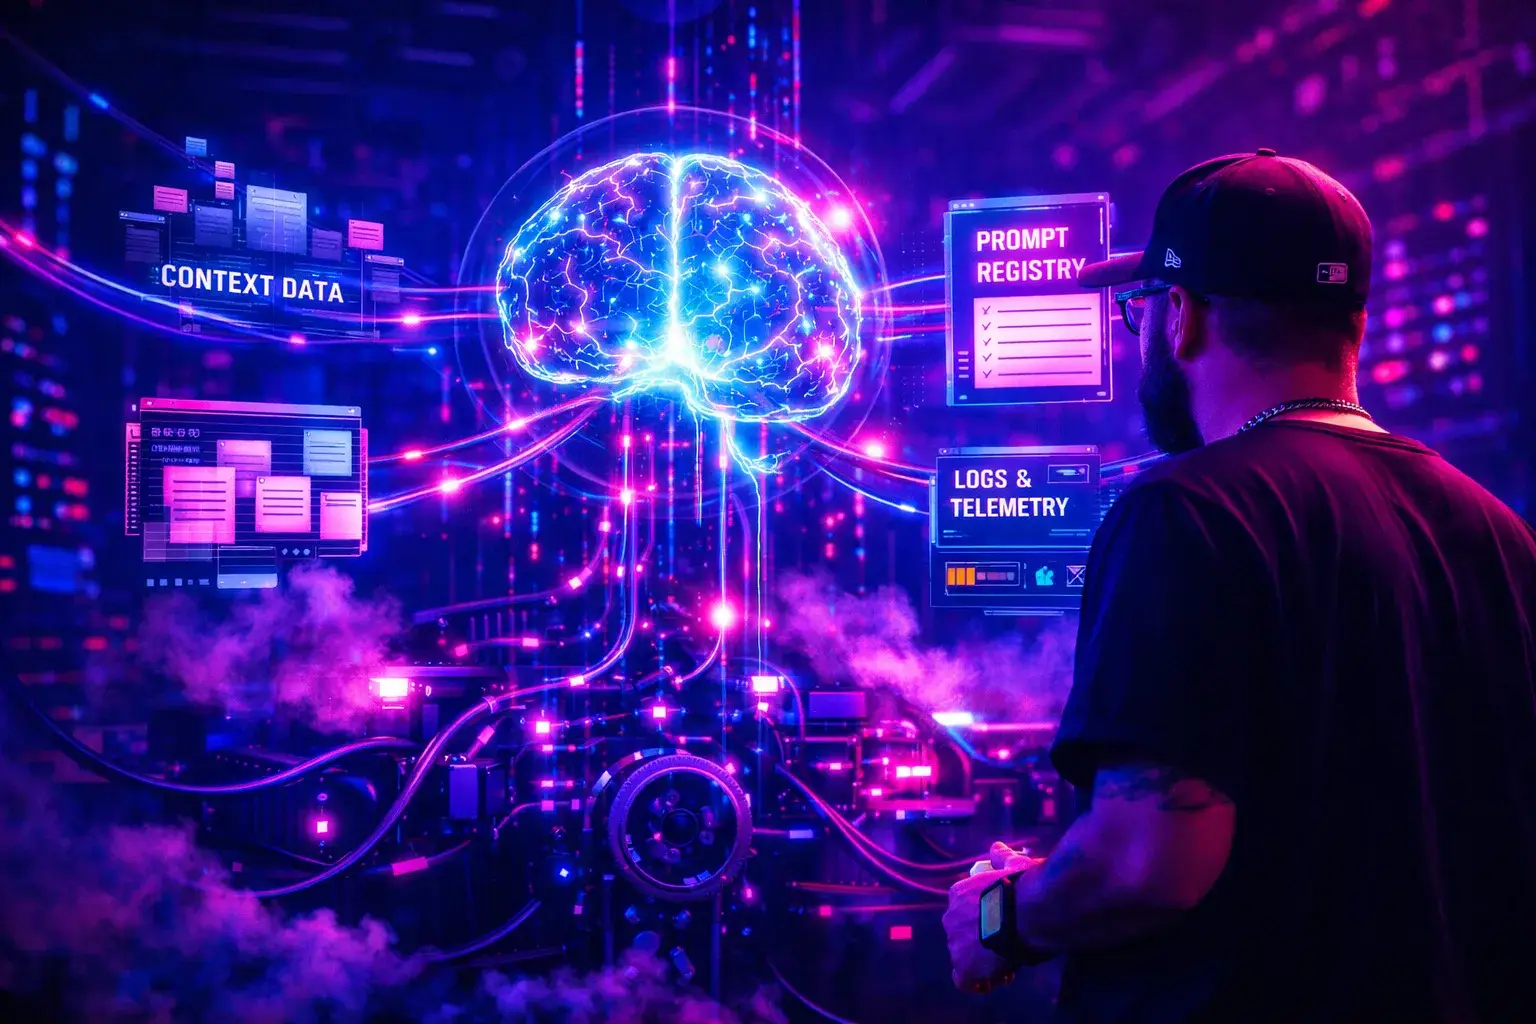
O que um backend precisa para operar IA: Context Assembler, Prompt Registry, AI Gateway, log de cada interação e telemetria de custo e qualidade.
Neste artigo · 13 seções
- Por que você vai ler esse artigo
- O backend "pré-IA" e suas limitações
- A arquitetura de referência: o que precisa existir
- Context Assembler: o componente que todo mundo esquece
- Prompt Registry: versionamento que funciona
- AI Gateway: a camada que controla tudo
- AI Interaction Log: o log que você deveria ter desde o dia 1
- Telemetria e métricas: o que medir e por quê
- Feature flags e experimentação: IA como experimento contínuo
- O custo escondido de não ter essa arquitetura
- Começando simples: o mínimo viável
- Conclusão
- Insights & Takeaways
Por que você vai ler esse artigo
Existe um padrão que se repete em quase todo projeto de IA que dá errado. Não é o modelo. Não é o prompt. É o backend.
O time integra um LLM, faz a demo funcionar, todo mundo aplaude, e aí alguém pergunta: "mas como a gente sabe se a resposta estava certa?" Silêncio. "E se precisar auditar isso daqui a 3 meses?" Mais silêncio. "Qual foi o contexto que o modelo recebeu naquela chamada que deu problema?" Ninguém sabe, porque ninguém logou.
A coisa é que a maioria dos backends não foi construída pra ter IA no meio. Foram construídos pra receber request, processar, devolver response. Determinístico. Previsível. Rastreável. Aí você joga um componente probabilístico no meio disso, um componente que pode dar respostas diferentes pra mesma entrada, que depende de contexto externo, que consome tokens que custam dinheiro, e a arquitetura simplesmente não está preparada.
Esse artigo é sobre preparar. Não é sobre escolher modelo ou otimizar prompt. É sobre o que precisa existir na sua camada de backend pra que, quando IA entrar no jogo, você consiga operar, medir, debugar e explicar o que está acontecendo.
O backend "pré-IA" e suas limitações
Um backend típico, bem feito, já tem logs, já tem métricas, já tem health checks. Mas "bem feito pra CRUD" e "bem feito pra IA" são coisas diferentes.
Num fluxo CRUD tradicional, o request chega, você valida, processa, persiste, responde. Se algo dá errado, você olha o log, vê o stack trace, encontra o bug, corrige. O comportamento é determinístico: mesma entrada, mesma saída. O log te diz o que aconteceu.
Agora coloca um LLM no meio. O request chega, você monta um contexto (que pode vir de várias fontes), constrói um prompt (que pode ter template, variáveis, histórico), faz uma chamada pra um serviço externo que é uma caixa preta, recebe uma resposta que pode variar mesmo com a mesma entrada, e entrega pro usuário. Se algo dá errado, o log tradicional te diz que a chamada HTTP retornou 200. Ótimo. Mas a resposta era alucinação pura e o contexto estava incompleto. Seu log não te conta nada disso.
O gap é esse: em sistemas com IA, o problema quase nunca é "deu erro 500". O problema é "deu 200 mas a resposta era lixo", ou "funcionou mas custou 4x mais do que deveria", ou "a resposta mudou sem ninguém mexer em nada". Um backend preparado pra IA precisa capturar essa camada de informação que não existe num log tradicional.
A arquitetura de referência: o que precisa existir
Vamos montar uma arquitetura de referência. Não é pra copiar e colar. É pra ter como mapa mental de quais componentes importam e por quê.
Cada componente conectado por setas pontilhadas ali do lado direito é o que diferencia um backend "que tem IA" de um backend "pronto pra IA". As setas pontilhadas representam fluxos de suporte, o que não está no caminho principal do request mas que precisa existir pra você operar IA de verdade. Vamos destrinchar.
Context Assembler: o componente que todo mundo esquece
Se tem um conceito que diferencia uma integração amadora de uma integração séria com LLM, é o gerenciamento de contexto.
O contexto é tudo que o modelo recebe além da pergunta direta do usuário. Pode ser dados do perfil, histórico de interações, documentos recuperados via RAG, regras de negócio, metadados do tenant. E aqui é onde as coisas complicam: o contexto define a qualidade da resposta mais do que o prompt em si.
O Context Assembler é um componente (pode ser um serviço, pode ser um módulo, pode ser uma classe, tanto faz a forma) responsável por coletar, filtrar e organizar todo o contexto necessário pra uma chamada de IA. Ele faz quatro coisas:
Coleta dados de múltiplas fontes. Busca no banco relacional, consulta um índice vetorial, puxa informações de cache, chama outro serviço. O ponto é que o contexto raramente vem de um lugar só.
Filtra por relevância e limite de tokens. Você tem um budget de contexto (context window). Não dá pra mandar tudo. O Context Assembler decide o que entra e o que fica de fora, usando score de relevância, recência, ou regras de negócio.
Aplica políticas de dados. PII precisa ser mascarada? Dados de um tenant não podem vazar pro contexto de outro? Certos campos são restritos por compliance? Isso é responsabilidade do Context Assembler, não do prompt.
E registra o que foi montado. Esse é o ponto que quase ninguém faz. Cada chamada de IA deveria ter um snapshot do contexto que foi enviado. Sem isso, quando alguém perguntar "por que o modelo respondeu isso?", a resposta vai ser "não sei, o contexto já mudou".
Na prática, o registro do contexto pode ser tão simples quanto serializar o payload que vai pro modelo e gravar com um correlation ID. Não precisa ser um sistema elaborado. Precisa existir.
Prompt Registry: versionamento que funciona
Prompt em código é o novo SQL em string concatenada. Todo mundo faz, todo mundo sabe que é errado, e eventualmente explode.
Um Prompt Registry é um repositório centralizado de templates de prompt. Pode ser uma tabela no banco, pode ser um arquivo YAML versionado no Git, pode ser um serviço separado. O formato importa menos que o princípio: prompts são artefatos de configuração, não código hardcoded.
Isso permite três coisas que você vai precisar.
Versionamento com rollback. Mudou o prompt e a qualidade caiu? Volta pra versão anterior. Simples, mas impossível quando o prompt está no meio de uma string template numa service class.
A/B testing. Quer comparar duas versões de prompt? Roteie 50% do tráfego pra cada uma e compare métricas. Se o prompt é um artefato versionado com ID, isso é trivial. Se está espalhado no código, é um projeto.
Auditoria. Quando o regulador perguntar "qual instrução o modelo recebeu quando gerou aquela resposta?", você precisa saber. Não "mais ou menos isso". O prompt exato, com a versão exata, no momento exato. O Prompt Registry acoplado ao AI Interaction Log te dá isso.
Um detalhe prático: o prompt template e o prompt renderizado são coisas diferentes. O template é "Classifique o ticket a seguir: {ticket_text}. Categorias possíveis: {categories}". O prompt renderizado é o texto final com as variáveis substituídas. O registry guarda o template e a versão; o log de interação guarda o prompt renderizado completo.
AI Gateway: a camada que controla tudo
Se o Context Assembler cuida da entrada e o Prompt Registry cuida da instrução, o AI Gateway cuida da execução. É um componente entre o seu serviço e o provedor de LLM, e faz muito mais do que um HTTP client.
O AI Gateway centraliza as chamadas ao modelo e adiciona comportamentos transversais. Pense nele como um API Gateway, mas específico pra chamadas de IA.
Roteamento. Qual modelo atende essa chamada? GPT-4o? Claude Sonnet? Um modelo local pra casos simples? O AI Gateway decide com base em regras: tipo de tarefa, tenant, custo, latência aceitável. Se amanhã você quiser trocar de provedor pra uma feature específica, muda a regra no gateway. O serviço de domínio não sabe e não precisa saber.
Retry e fallback. O provedor retornou 429? Timeout? O gateway faz retry com backoff. Se o provedor primário está fora, roteia pro secundário. Sem o gateway, cada serviço implementa (ou não implementa) sua própria lógica de resiliência.
Rate limiting e controle de custo. Você define limites por tenant, por feature, por minuto, por mês. Sem isso, um bug num loop pode gerar milhares de chamadas e a fatura chega como surpresa.
E o mais importante: logging estruturado de cada interação. Modelo usado, versão, tokens de input, tokens de output, latência, custo estimado, status. Cada chamada é um evento que alimenta sua telemetria.
Na forma mais simples, o AI Gateway pode ser uma classe wrapper no mesmo serviço. Na forma mais robusta, é um serviço separado com rate limiting distribuído, circuit breaker e dashboard próprio. Comece simples, mas comece com a abstração certa.
AI Interaction Log: o log que você deveria ter desde o dia 1
Esse é o componente mais subestimado e o que mais faz falta quando algo dá errado.
O AI Interaction Log registra cada interação entre seu sistema e o modelo de IA. Não é o log de aplicação normal. É um log específico que captura o ciclo completo de uma chamada de IA.
O que ele registra:
{
  "interaction_id": "uuid",
  "correlation_id": "uuid-do-request-original",
  "timestamp": "2026-03-28T14:32:01Z",
  "model": "claude-sonnet-4-20250514",
  "model_version": "20250514",
  "prompt_template_id": "ticket-classifier-v3",
  "prompt_template_version": "3.2.1",
  "context_snapshot_ref": "s3://ai-logs/ctx/2026/03/28/abc123.json",
  "prompt_rendered_hash": "sha256:...",
  "input_tokens": 1847,
  "output_tokens": 312,
  "latency_ms": 1423,
  "estimated_cost_usd": 0.0087,
  "temperature": 0.1,
  "response_raw_ref": "s3://ai-logs/resp/2026/03/28/abc123.json",
  "response_parsed": { "category": "billing", "confidence": 0.94 },
  "quality_score": null,
  "user_feedback": null,
  "tenant_id": "acme-corp",
  "feature_id": "ticket-classification",
  "environment": "production"
}
Repara em alguns detalhes. O contexto completo e a resposta bruta vão pra um object storage por referência, não inline. Isso evita que o log fique gigante mas mantém a rastreabilidade total. O correlation_id conecta essa interação com o request HTTP original, pra você poder rastrear do click do usuário até o token gerado pelo modelo. E o prompt_rendered_hash permite validar que o prompt que foi enviado é o que deveria ter sido enviado, sem guardar o texto completo no log (que pode conter dados sensíveis).
Sem esse log, debugar problema em produção com IA é como debugar sem stack trace. Dá pra fazer, mas é sofrimento.
Telemetria e métricas: o que medir e por quê
Logs te dizem o que aconteceu num caso específico. Métricas te dizem como o sistema está se comportando no agregado. Você precisa dos dois.
As métricas que importam pra um backend com IA se dividem em três categorias: operacional, qualidade e custo.
Métricas operacionais são as que você já conhece, com adições. Latência p50, p95 e p99 das chamadas ao modelo (separada da latência total do request). Taxa de erro do provedor. Taxa de timeout. Taxa de fallback acionado. Taxa de rate limit atingido. Essas métricas vão no seu Grafana, Datadog, ou o que você usa, como qualquer outra métrica de infraestrutura.
Métricas de qualidade são as novas. Taxa de aceitação das sugestões pelo usuário. Taxa de correção (o usuário aceitou mas editou). Taxa de rejeição. Score médio de confiança. Distribuição de categorias de resposta (pra detectar drift, quando o modelo começa a responder diferente sem ninguém mudar nada). Essas métricas geralmente precisam de um pipeline separado porque dependem de feedback do usuário que chega de forma assíncrona.
Métricas de custo são as que salvam o orçamento. Custo por feature por dia. Custo por tenant por dia. Custo por chamada (input tokens + output tokens x preço). Token efficiency, que é a razão entre tokens de contexto enviados e tokens úteis na resposta. Se você está mandando 8.000 tokens de contexto pra receber uma classificação de uma palavra, algo está errado.
O ideal é ter um dashboard que cruze as três. Tipo: "a feature X está custando $47/dia, com latência p95 de 3.2s, taxa de aceitação de 71%, e caiu 4% na última semana". Essa frase te diz mais do que qualquer relatório de 20 páginas.
Feature flags e experimentação: IA como experimento contínuo
Um ponto que quem vem do mundo DevOps já sabe, mas que a galera de ML às vezes esquece: feature flags não são opcionais quando você tem IA em produção.
Cada feature de IA deveria nascer atrás de um flag. Isso é inegociável. Porque a realidade é que você vai precisar ligar e desligar features por tenant, fazer rollout gradual (1% do tráfego, depois 5%, depois 25%), comparar versões de prompt em produção com tráfego real, desligar tudo se o provedor ficar instável, e rodar shadow mode, que é quando a IA processa mas o resultado não vai pro usuário, só vai pro log.
Shadow mode em particular é algo que pouca gente usa e que faz diferença enorme. Antes de expor uma feature de IA pro usuário, você pode rodar ela em paralelo, em shadow, e analisar as respostas sem risco. "Se a IA tivesse respondido, ela teria dito X. O humano fez Y. A diferença foi Z." Depois de uma ou duas semanas nesse modo, você tem dados reais pra decidir se vale a pena ligar.
Na arquitetura, isso se traduz em ter o AI Gateway (ou o serviço de domínio) consultando um serviço de feature flags antes de decidir: chamo o modelo? Qual versão do prompt? Mando o resultado pro usuário ou só pro log?
O custo escondido de não ter essa arquitetura
Se parece trabalho demais pra "só chamar uma API", pensa nos cenários sem ela.
Sem Context Assembler, cada serviço monta o contexto do seu jeito. Um manda PII pro modelo. Outro manda contexto demais e estoura o limite de tokens. Outro manda de menos e a resposta sai genérica. Ninguém sabe o que o outro está fazendo.
Sem Prompt Registry, os prompts estão espalhados no código, em variáveis de ambiente, em configs soltas. Quando alguém pergunta "o que mudou?", ninguém sabe. Rollback é impossível. Teste A/B é manual.
Sem AI Gateway, cada serviço faz sua chamada HTTP direta pro provedor. Retry? Depende do dev que implementou. Rate limiting? Não tem. Troca de provedor? Refactor em todo o codebase.
Sem AI Interaction Log, debugar é adivinhação. "Acho que o contexto estava errado." "Acho que o prompt mudou." "Acho que o modelo alucionou." Tudo achismo, sem dados pra comprovar.
Sem telemetria, a fatura do provedor chega no final do mês e ninguém sabe explicar. "Gastamos $12k em tokens, mas não sei em qual feature." Isso acontece com mais frequência do que qualquer tech lead gostaria de admitir.
A arquitetura que esse artigo descreve não é premature optimization. É o equivalente a ter CI/CD, monitoramento e alertas antes de ir pra produção. Ninguém discute mais se precisa de observabilidade num sistema distribuído. A mesma lógica se aplica quando o sistema tem IA.
Começando simples: o mínimo viável
Não precisa construir tudo no dia 1. Mas precisa começar com as abstrações certas.
O mínimo viável é: uma abstração pro AI Gateway (mesmo que seja uma classe no mesmo serviço) que centraliza chamadas e loga cada interação com os campos que mostrei ali em cima; um template de prompt separado do código (um arquivo YAML no repo já serve); um campo de correlation ID que conecta a chamada de IA ao request original; métricas básicas de latência, custo e taxa de erro no dashboard que já existe.
Isso dá pra montar em uma sprint. Não é um projeto de 3 meses. E quando vier a segunda feature de IA, a terceira, a décima, a base já está lá. A alternativa é construir cada uma do zero, sem padronização, sem log, sem rastreabilidade, e depois gastar o triplo do tempo tentando entender o que está acontecendo em produção.
Conclusão
Um backend pronto pra IA não é um backend com a SDK da OpenAI instalada. É um backend que sabe responder cinco perguntas a qualquer momento: qual contexto foi enviado, qual prompt foi usado, quanto custou, quanto demorou, e se o resultado foi bom. Se você não consegue responder essas cinco perguntas pra qualquer chamada de IA em produção, você está operando no escuro.
A boa notícia é que nada disso é tecnologia nova. É o mesmo mindset de observabilidade que a gente aplica pra qualquer sistema distribuído, adaptado pra um componente que tem suas particularidades: é probabilístico, é caro, e quando erra, erra de formas que não aparecem no status code. A arquitetura muda pouco. A disciplina muda muito.
Comece pelo log. O resto segue.
Insights & Takeaways
-
O problema de IA em produção quase nunca é "erro 500". É "200 com resposta errada". Seu backend precisa capturar essa camada de informação que logs tradicionais não cobrem.
-
Context Assembler, Prompt Registry, AI Gateway e AI Interaction Log são os quatro componentes que separam uma integração de IA amadora de uma operável. Não precisam ser serviços separados, mas as abstrações precisam existir.
-
Cada chamada de IA deveria ser rastreável do click do usuário até o token gerado, com contexto, prompt, modelo, custo e latência registrados. Sem isso, debugar é adivinhação.
-
Feature flags e shadow mode são obrigatórios. Rode a IA em paralelo sem expor pro usuário, analise as respostas, e só ligue quando os dados justificarem.
-
O mínimo viável cabe numa sprint: uma abstração de gateway, prompts em arquivo separado, correlation ID e métricas básicas. Comece simples, mas comece com as abstrações certas.