IA First · Episódio 4
Como Escolher Entre ChatGPT, Claude, Gemini, Mistral e Modelo Open Source Sem Virar Fanboy
Critérios para escolher LLM por custo, latência e qualidade, onde ChatGPT, Claude, Gemini, Mistral e open source vencem e como fugir do vendor lock-in.
Neste artigo · 12 seções
- O cenário atual: quem são os jogadores
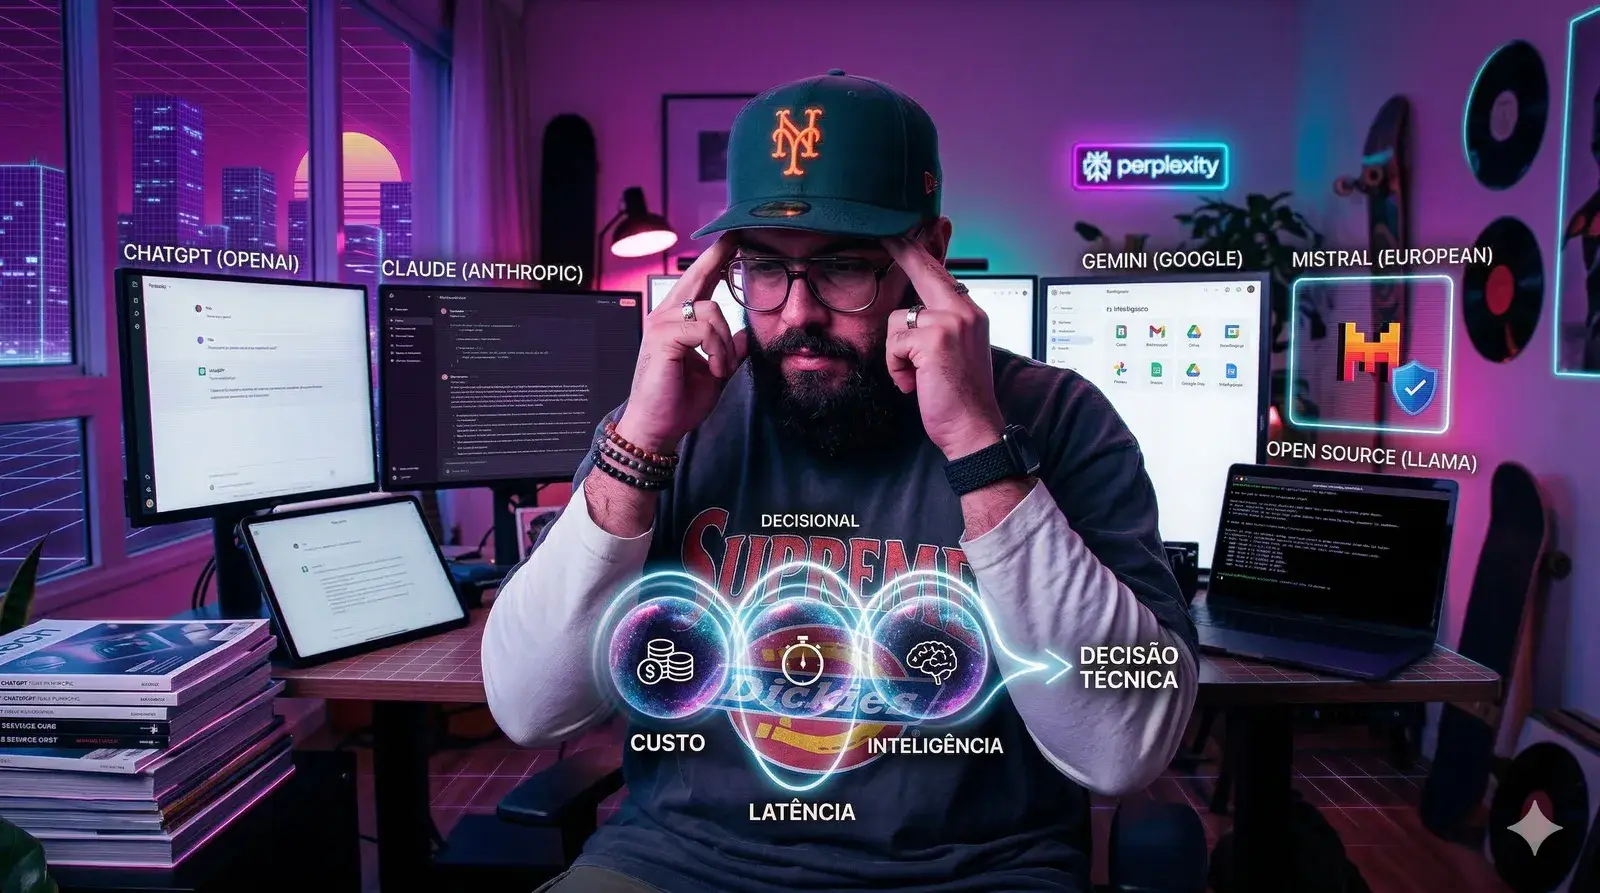
- Os três eixos de decisão: custo, latência, inteligência
- ChatGPT/OpenAI: adoção massiva e familiaridade
- Claude/Anthropic: raciocínio longo e confiabilidade
- Gemini/Google: contexto massivo e integração nativa
- Mistral: soberania europeia e flexibilidade de deploy
- Open source (Llama, DeepSeek): controle total e custo zero (ou quase)
- Vendor lock-in: o risco silencioso
- Framework prático de decisão
- Quando usar qual: guia rápido
- Conclusão: decisão técnica, não guerra santa
- Insights & Takeaways
Toda conversa sobre qual LLM usar vira torcida organizada em menos de cinco minutos. Tem o pessoal do "Claude nunca alucina", o time "GPT é o único que presta", a galera "Gemini é grátis e integra com tudo" e os puristas do open source dizendo "Llama ou nada".
O problema não é ter preferência. É tomar decisão de arquitetura baseado em thread do Twitter em vez de critério técnico.
Se você gerencia equipe de engenharia ou produto com IA, sua escolha de modelo afeta custo mensal, latência de API, qualidade da saída, capacidade de customização e vendor lock-in por anos. Esse artigo é justamente sobre como escolher sem virar fanático, com base em trade-off real.
O cenário atual: quem são os jogadores
Começo 2026, o mercado de LLM tem quatro camadas bem definidas.
Proprietários americanos de fronteira: OpenAI (ChatGPT, GPT-5), Anthropic (Claude Opus/Sonnet), Google (Gemini). São os modelos de maior capacidade, maior custo e maior adoção corporativa.
Proprietário europeu com foco enterprise: Mistral AI. Francesa, com modelos open-weight e proprietários, foco em soberania de dados e deploy on-premise.
Open source e open-weight: Meta Llama, DeepSeek, Qwen. Disponíveis para self-hosting ou via API de terceiros, com performance cada vez mais competitiva.
Modelos especializados: Copilot (Microsoft, integrado no ecossistema 365/GitHub), modelos de código (Codestral da Mistral), modelos pequenos para edge (Ministral, Gemini Nano).
A coisa já saiu da fase "tem um modelo bom e o resto é experimental". Agora você tem pelo menos cinco opções viáveis para produção, cada uma com geometria de custo, latência e capacidade diferente.
Os três eixos de decisão: custo, latência, inteligência
Toda escolha de LLM gira em torno de três variáveis que você não consegue maximizar ao mesmo tempo.
Custo: varia 100x entre modelos. Gemini Flash custa $0.15 por milhão de tokens de entrada. Claude Opus custa $15 por milhão. Mesma chamada de API, economia completamente diferente.
Latência: tempo de resposta importa muito em aplicação interativa. Modelos grandes e densos são mais lentos. Modelos com Mixture-of-Experts (MoE) como Mistral Large ou DeepSeek V3 ativam só parte dos parâmetros, ganhando velocidade.
Inteligência/Qualidade: capacidade de raciocínio, consistência de saída, habilidade de seguir instrução complexa, menor taxa de alucinação. Normalmente, modelos caros performam melhor aqui, mas a diferença diminuiu.
Você não vai achar modelo barato, rápido e perfeito. A decisão é: qual desses três eixos eu posso relaxar para o meu caso de uso?
Se você está fazendo suporte ao cliente com milhões de interações, custo vira existencial. Se está gerando código crítico para infraestrutura financeira, qualidade é inegociável. Se está num assistente de voz, latência acima de 800ms quebra a experiência.
ChatGPT/OpenAI: adoção massiva e familiaridade
ChatGPT ainda domina uso global, com cerca de 81% do tráfego de chatbot até meados de 2025 e 900 milhões de usuários ativos semanalmente.
Onde funciona bem:
- Times que já têm familiaridade com a ferramenta, reduzindo fricção de onboarding.
- Casos de uso generalistas: brainstorming, geração de conteúdo, assistente de produtividade.
- Empresas que priorizam velocidade de adoção (consumer-to-enterprise path).
Onde pode não ser a melhor escolha:
- Orgs que precisam de contexto gigante (GPT-5 tem 128K tokens, Claude vai a 200K, Gemini a 1M).
- Casos sensíveis a custo com volume altíssimo, especialmente se a tarefa pode rodar em modelo menor.
- Ambientes regulados que exigem deploy on-premise (OpenAI não oferece isso fácil).
GPT-5 é sólido, versátil e tem ecossistema gigante de ferramentas e integrações. Mas paga-se pela marca e pela conveniência.
Claude/Anthropic: raciocínio longo e confiabilidade
Claude construiu reputação em duas frentes: janela de contexto enorme (até 200K tokens no Opus, versões enterprise chegam a 500K+) e comportamento mais cauteloso, com menos tendência a inventar coisa.
Onde funciona bem:
- Tarefas que exigem análise de repositório inteiro, documentação extensa ou histórico longo de conversa.
- Código complexo, principalmente refatoração e arquitetura, onde explicabilidade importa.
- Ambientes conservadores que valorizam "honestidade" do modelo (admitir quando não sabe em vez de alucinar).
Onde pode não ser a melhor escolha:
- Tarefas simples e repetitivas onde o custo do Opus não se justifica (aí entra Sonnet ou Haiku).
- Casos que exigem velocidade extrema, já que Claude tende a ser mais lento em requisições complexas.
- Necessidade de multimodalidade avançada (vídeo, áudio), onde Gemini tem vantagem nativa.
Claude Opus 4.6 lidera em vários benchmarks de código e conhecimento, mas custa caro. Se você tem budget e problema complexo, compensa. Se o caso de uso é trivial, você está pagando demais.
Gemini/Google: contexto massivo e integração nativa
Gemini tem dois trunfos: janela de contexto de até 1 milhão de tokens (a maior do mercado) e integração nativa com Google Workspace, Cloud, Search.
Onde funciona bem:
- Empresas já no ecossistema Google (Workspace, GCP), onde a integração é zero-friction.
- Processamento de bases de código gigantes, PDFs longos, históricos massivos de dados.
- Velocidade de resposta, já que Gemini é notavelmente mais rápido que ChatGPT e Claude.
Onde pode não ser a melhor escolha:
- Tarefas que exigem raciocínio profundo e consistência máxima, onde Claude ou GPT podem ser mais confiáveis.
- Ambientes fora do ecossistema Google, onde a vantagem de integração desaparece.
- Casos sensíveis a variação de resposta (Gemini tem reputação de ser menos determinístico).
Gemini é rápido, barato (tem tier gratuito decente) e escala bem. Mas em tarefa crítica onde cada token importa, pode não ser a primeira escolha.
Mistral: soberania europeia e flexibilidade de deploy
Mistral surgiu como alternativa europeia aos big techs americanos, mas hoje compete tecnicamente em vários benchmarks.
Onde funciona bem:
- Empresas europeias ou com requisitos de soberania de dados e compliance GDPR rigoroso.
- Deploy on-premise ou em cloud privada, onde Mistral oferece self-hosting sem fricção.
- Código e desenvolvimento, especialmente com Codestral e Devstral.
- Edge computing e robótica, usando Ministral 8B rodando local sem latência de rede.
Onde pode não ser a melhor escolha:
- Casos de uso puramente consumer onde ChatGPT ou Gemini já têm market share gigante.
- Orgs que não têm capacidade de gerenciar infraestrutura própria (aí API de terceiros faz mais sentido).
Mistral Large 3 compete com GPT e Claude em benchmarks, mas com vantagem de controle total sobre deploy. Se você está em setor regulado (financeiro, saúde, defesa), isso vale ouro.
Open source (Llama, DeepSeek): controle total e custo zero (ou quase)
Modelos open source e open-weight mudaram o jogo. Llama 3.3 70B e DeepSeek V3 performam em nível competitivo com modelos proprietários em vários casos.
Onde funciona bem:
- Empresas com dados extremamente sensíveis que não podem sair da infraestrutura interna.
- Casos onde custo de inferência em escala é existencial (self-hosting elimina custo por token).
- Times que precisam fine-tuning profundo e controle sobre pesos, arquitetura e treinamento.
- Pesquisa e experimentação, onde transparência e auditabilidade importam.
Onde pode não ser a melhor escolha:
- Empresas sem expertise ou infraestrutura para gerenciar modelo próprio (complexidade operacional alta).
- Casos onde estar na fronteira absoluta de capacidade importa (modelos proprietários ainda lideram benchmarks top).
- Orgs pequenas que preferem pagar por conveniência a gerenciar stack completo.
DeepSeek V3, por exemplo, usa arquitetura MoE com 671B parâmetros totais mas só ativa 37B por token, sendo eficiente e competitivo. Llama 3.3 70B performa como esperado de um modelo desse tamanho, sólido mas não mágico.
A grande questão aqui não é técnica, é operacional: você tem gente, infra e processo para rodar isso? Se sim, open source te dá independência estratégica. Se não, você vai gastar mais em engenharia do que economizaria em API.
Vendor lock-in: o risco silencioso
Escolher modelo não é só performance hoje, é também quanto vai doer trocar amanhã.
Se você escreve código acoplado direto na API de um fornecedor, qualquer mudança de modelo vira reescrita. Aí vem aumento de preço, depreciação de endpoint, outage prolongado, e você está preso.
Como evitar:
- Usar camada de abstração (gateway de modelo) que expõe interface unificada e roteia por trás.
- Padrão OpenAI-compatible virou quasi-standard, vários providers suportam.
- Manter "blueprint" de agente separado (prompts, schemas de tool, configuração) do vendor específico.
- Ter conjunto de teste de verificação que valida comportamento, não implementação.
Ferramentas como AI gateways (TrueFoundry, LiteLLM, outros) permitem trocar modelo via configuração, sem tocar código de aplicação.
Se você está construindo produto crítico com IA, trate portabilidade como requisito de arquitetura, não como "vamos pensar nisso depois".
Framework prático de decisão
Aqui vai um roteiro direto para escolher sem viajar na maionese.
1. Defina o caso de uso e suas restrições
- Qual a tarefa? Geração de código, suporte, análise, síntese, pesquisa?
- Qual o volume esperado? Mil chamadas por dia ou milhão?
- Qual a latência aceitável? Tempo real (<1s), interativo (<5s), assíncrono (>10s)?
- Qual o budget? $100/mês ou $10K/mês?
2. Elimine opções que quebram hard constraints
- Se você precisa de on-premise, proprietários americanos saem.
- Se precisa de <500ms, modelos densos e grandes saem.
- Se custo por token tem que ser <$0.50 por interação, Opus sai.
3. Compare finalistas em teste real com seus dados
- Benchmarks públicos mentem. Rode seu caso de uso real.
- Monte eval set pequeno mas representativo.
- Teste custo, latência e qualidade medidos, não prometidos.
4. Considere estratégia de two-tier ou routing
- Modelo rápido/barato faz rascunho, modelo caro refina só quando necessário.
- Roteamento por complexidade: pergunta simples vai para Flash, complexa vai para Opus.
- Isso reduz custo médio sem degradar qualidade em casos críticos.
5. Valide portabilidade antes de escalar
- Consegue trocar de modelo mudando só configuração?
- Seus prompts são agnósticos ou dependem de quirk específico de um vendor?
- Teste trocar modelo e medir delta de qualidade. Se quebrar tudo, você tem lock-in.
Quando usar qual: guia rápido
Aqui vai mapa mental simplificado, com todas as ressalvas de "depende do contexto".
ChatGPT/GPT-5: Use quando time já conhece, caso de uso é genérico, você quer ecossistema maduro e não tem restrição de soberania.
Claude: Use quando precisa de contexto longo, trabalho com código complexo, raciocínio profundo e pode pagar pelo Opus.
Gemini: Use quando já está no Google Workspace/Cloud, precisa de velocidade, tem documentos enormes e quer custo baixo.
Mistral: Use quando precisa de soberania de dados, deploy on-premise, compliance europeu ou edge computing.
Open source (Llama, DeepSeek): Use quando tem infra e expertise, dados não podem sair do ambiente, custo de escala é proibitivo ou precisa de fine-tuning profundo.
E tem uma sexta opção, que muita gente ignora: usar mais de um ao mesmo tempo, com routing inteligente. Pergunta trivial vai para Gemini Flash. Análise de código vai para Claude Sonnet. Geração criativa vai para GPT. Cada tarefa no modelo certo, orquestrado por gateway.
Conclusão: decisão técnica, não guerra santa
A pior escolha de LLM não é "errar o modelo". É escolher por torcida, sem critério, e descobrir seis meses depois que você pagou 10x mais do que precisava, ou que está preso num vendor que subiu preço 300%.
Trate seleção de modelo como decisão de arquitetura. Defina requisitos, teste com carga real, meça custo e qualidade, valide portabilidade.
ChatGPT não é "melhor". Claude não é "mais confiável". Gemini não é "mais rápido". Open source não é "mais livre". Cada um é melhor em contextos específicos, e você só descobre isso testando no seu cenário.
Se depois de rodar seu eval set você descobrir que Gemini Flash resolve 95% dos casos a 1/10 do custo do Opus, use Gemini. Se descobrir que Claude gera código 30% melhor no seu domínio específico e isso compensa o custo extra, use Claude. Se descobrir que self-hosting Llama te dá independência estratégica que vale a complexidade, vá de open source.
Só não vire fanboy.
Insights & Takeaways
- Escolha de LLM gira em torno de três eixos: custo, latência, inteligência. Você não maximiza os três ao mesmo tempo.
- ChatGPT domina adoção, Claude lidera em contexto longo e código, Gemini ganha em velocidade e integração Google, Mistral oferece soberania europeia, open source dá controle total.
- Vendor lock-in é risco real. Use gateway de modelo e mantenha portabilidade como requisito de arquitetura.
- Benchmarks públicos mentem. Teste com seu caso de uso real, seus dados, sua carga.
- Estratégia de two-tier (modelo barato para rascunho, caro para refinamento) reduz custo sem degradar qualidade.