IA First · Episódio 5
Guardrails: Colocando Cinto de Segurança em LLM Antes Que o Jurídico Descubra
Guardrails em LLM antes do incidente: os riscos do OWASP Top 10 para LLMs, defesa em três camadas, ferramentas prontas e o que o jurídico vai cobrar.
Neste artigo · 9 seções
- O que são guardrails e por que você precisa deles agora
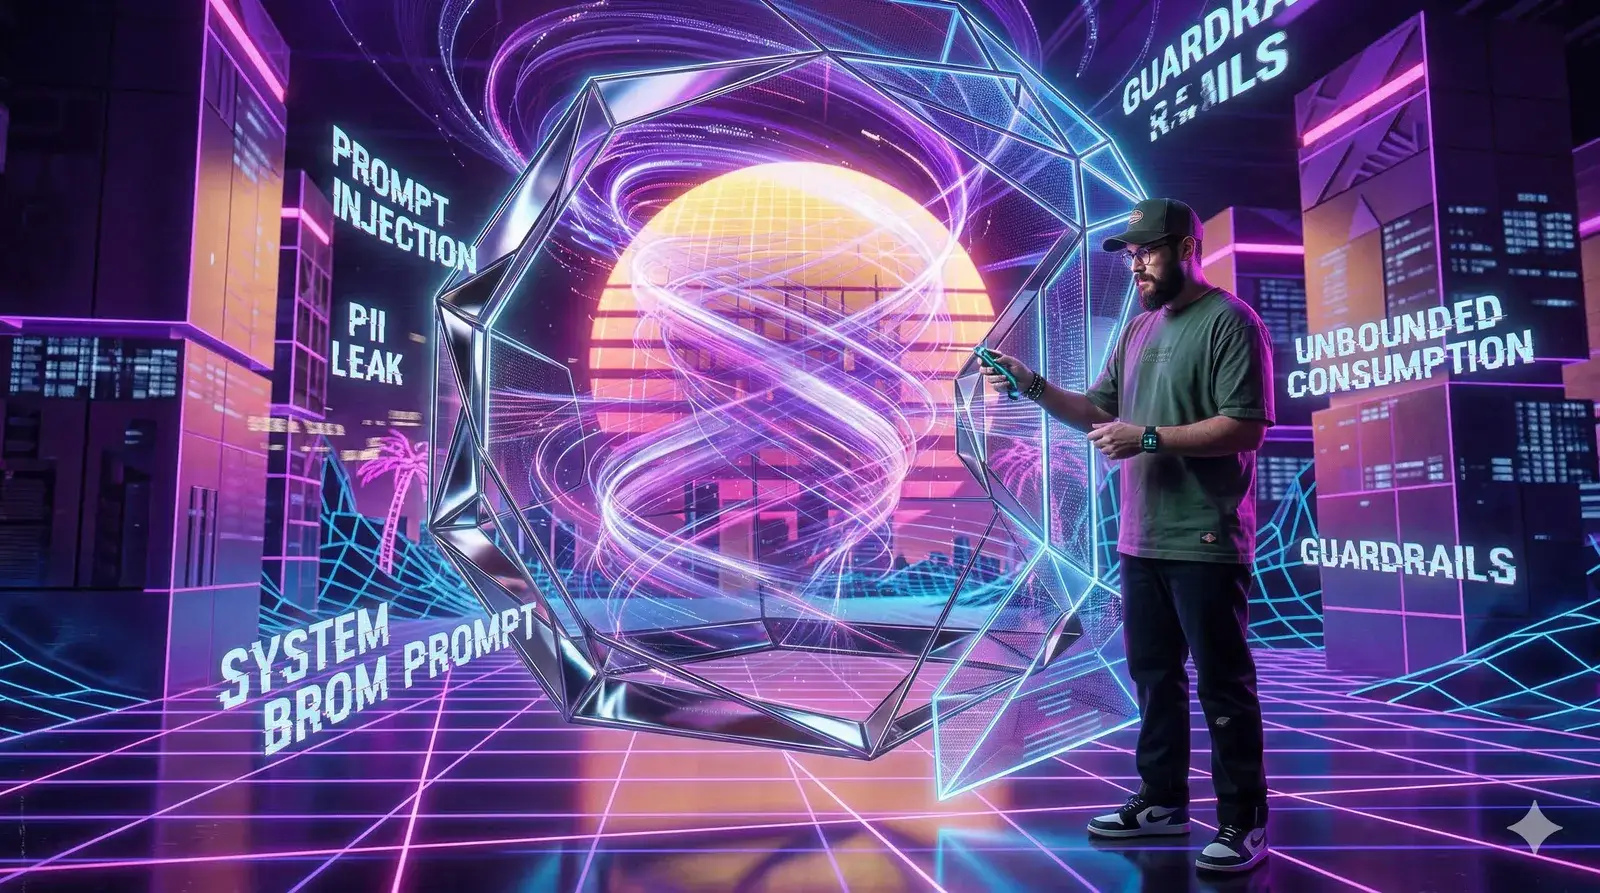
- OWASP Top 10 para LLMs: os riscos que importam
- Três camadas de defesa: como construir guardrail que funciona
- Ferramentas práticas: o que usar sem reinventar a roda
- Aspecto legal e compliance: o que jurídico vai perguntar
- Como começar sem paralisar o projeto
- Monitoramento contínuo: guardrails não são "configure e esqueça"
- Conclusão: guardrails são seguro, não opcional
- Insights & Takeaways
Quando você coloca LLM em produção sem guardrail, está basicamente esperando uma dessas coisas acontecer:
- O modelo vaza PII de cliente em resposta que vai direto para log não criptografado.
- Um usuário malicioso extrai seu system prompt inteiro, incluindo a API key hardcoded que alguém colocou lá.
- O chatbot de suporte responde uma pergunta sobre produto com conteúdo tóxico, racista ou que viola regulação da sua indústria.
- Alguém injeta prompt indireto via arquivo PDF e o modelo executa ação não autorizada, tipo deletar dados.
Não é paranoia. É o que está no OWASP Top 10 para LLMs 2025, baseado em centenas de incidentes reais documentados. E quando uma dessas coisas explode, não é só o time de engenharia que se preocupa. É jurídico, compliance, relações públicas e, dependendo da jurisdição, multa de seis dígitos para cima.
Esse artigo é sobre como colocar guardrails em LLM de forma pragmática, antes que vire problema de conselho.
O que são guardrails e por que você precisa deles agora
Guardrail é camada de validação que intercepta requisição e resposta para garantir que nada perigoso, ilegal ou simplesmente idiota chegue até o usuário ou até o sistema.
Funciona em três momentos:
- Input guardrail: valida entrada do usuário antes de chegar no modelo. Detecta prompt injection, PII em entrada, conteúdo tóxico, requisição fora do escopo.
- Processing guardrail: controla o que o modelo pode fazer durante a execução. Define limites de acesso, restringe ferramentas que o agente pode chamar, impede que ele mude o próprio comportamento.
- Output guardrail: valida a saída antes de entregar para o usuário. Bloqueia PII vazado, alucinação detectável, resposta tóxica, formato quebrado.
Sem isso, você está confiando 100% no modelo para nunca errar, nunca ser manipulado e nunca gerar coisa comprometedora. Boa sorte explicando isso para auditoria externa.
A diferença entre sistema com guardrail e sem é a mesma de carro com e sem cinto de segurança. Você até pode rodar sem por um tempo, mas quando dá merda, dá muito merda.
OWASP Top 10 para LLMs: os riscos que importam
O OWASP, mesma organização que cuida de segurança em aplicação web, publicou Top 10 específico para LLMs em 2025, com base em contribuição de mais de 500 especialistas.
Aqui estão os cinco primeiros, que cobrem 80% dos incidentes:
LLM01: Prompt Injection Continua sendo o risco número 1. Atacante manipula entrada para subverter comportamento do modelo, bypassar filtro de segurança, gerar conteúdo proibido ou acessar funcionalidade restrita. Exemplo real: pesquisador conseguiu extrair system prompt completo do ChatGPT embutido no site de companhia aérea, incluindo chave de API que dava acesso direto ao sistema de reservas.
LLM02: Sensitive Information Disclosure Modelo vaza dado pessoal, informação proprietária ou credencial. Pode vir de memorização de dado de treino, exposição de system prompt ou falta de filtro de saída. Incidente real: ferramenta de resumo jurídico fine-tunada em contratos confidenciais começou a reproduzir trechos literais de contrato de cliente quando usuário fez prompt parecido com template de treino.
LLM06: Excessive Agency Modelo tem permissão demais para executar ações. Agente com acesso a banco de dados, API externa ou sistema interno pode causar dano real se for manipulado por prompt injection. O problema não é o modelo "decidir" fazer coisa ruim. É alguém fazer o modelo executar ação não autorizada via prompt malicioso.
LLM07: System Prompt Leakage Novo em 2025. Exposição de instrução interna, lógica de negócio ou credencial embutida no system prompt. Atacante usa técnica de extração gradual em conversa de múltiplos turnos para revelar instruções escondidas. Se você tem API key, regex de validação ou regra de negócio sensível no prompt, está vazando arquitetura.
LLM10: Unbounded Consumption Modelo consome recurso sem limite. Atacante envia prompt gigante, faz requisição repetida ou aciona cadeia de chamadas que explode custo de inferência e trava sistema. Isso pode ser ataque de negação de serviço (DoS) clássico ou "denial of wallet" (DoW), onde custo de API explode porque ninguém botou rate limit.
Os outros cinco (Supply Chain, Data Poisoning, Improper Output Handling, Vector/Embedding Weaknesses, Misinformation) também importam, mas se você resolver os cinco acima, já cortou a maior superfície de ataque.
Três camadas de defesa: como construir guardrail que funciona
Guardrail não é um componente, é arquitetura em camadas.
Melhor abordagem: defesa em profundidade com três níveis de proteção, do mais rápido ao mais robusto.
Camada 1: Regras rápidas (regex, blocklist, rate limit) Primeira linha de defesa, executa em milissegundos. Bloqueia violação óbvia antes de gastar token.
- Regex para detectar PII (CPF, cartão de crédito, email, telefone) na entrada e saída.
- Blocklist de palavras e padrões conhecidos de jailbreak.
- Rate limiting por usuário e por endpoint.
- Validação de tamanho de entrada (bloqueia prompt de 100K tokens se o caso de uso normal é 500).
Isso não pega ataque sofisticado, mas corta 70% do lixo antes de chegar no modelo.
Camada 2: Classificadores leves (ML pequeno, embeddings) Segundo filtro, usa modelo pequeno e rápido para detectar nuance que regex não pega.
- Classificador de toxicidade (Perspective API, Detoxify).
- Detector de prompt injection treinado (Lakera Guard, outros).
- Similaridade semântica para checar se entrada está no domínio esperado (embeddings + threshold).
Adiciona 50-200ms de latência, mas pega tentativa de manipulação que passou pela primeira camada.
Camada 3: Validação semântica com LLM (só para caso crítico) Terceiro nível, usa outro LLM como juiz para validar se resposta está segura, correta e alinhada com política.
- LlamaGuard (Meta) para classificar entrada e saída em categorias de risco.
- Segundo LLM verifica se resposta do primeiro contém alucinação detectável, dado sensível ou conteúdo fora de política.
Isso é caro (duplica custo de inferência) e lento (adiciona 500ms-2s), então só use onde risco justifica: compliance, financeiro, saúde, legal.
A chave aqui é roteamento baseado em risco. Pergunta simples e de baixo risco passa só pelas duas primeiras camadas. Requisição de alto risco ou alta complexidade passa pelas três.
Ferramentas práticas: o que usar sem reinventar a roda
Você não precisa construir guardrail do zero. Já tem framework open source maduro e serviço gerenciado que resolvem 90% dos casos.
NVIDIA NeMo Guardrails (open source) Foco em controle de fluxo conversacional. Você define cenários de diálogo, ações permitidas e políticas de segurança em linguagem declarativa (Colang). Bom para chatbot com fluxo estruturado, assistente de domínio específico, aplicação onde você quer controle fino do que o modelo pode e não pode discutir. Integra com LangChain, LlamaIndex e qualquer LLM compatível com OpenAI API.
Guardrails AI (open source, Python) Framework para validar entrada e saída com validators customizáveis. Você define schema de saída esperado e conjunto de restrições (sem PII, sem toxicidade, formato JSON válido). Bom para caso de uso onde você sabe exatamente que formato e conteúdo espera, e quer rejeitar ou reparar automaticamente saída que viola regra.
LlamaGuard (Meta, open source) Modelo de safeguard treinado para classificar entrada e saída em categorias de risco (toxicidade, hate speech, alucinação, violação de segurança). Funciona como filtro de entrada/saída, performa comparável ou melhor que OpenAI Moderation API. Pode ser customizado para taxonomia específica da sua aplicação.
Serviços gerenciados (AWS Bedrock Guardrails, F5 AI Guardrails, outros) Se você não quer gerenciar infra própria, cloud providers oferecem guardrail como serviço. AWS Bedrock Guardrails permite configurar políticas de conteúdo, filtro de PII, controle de tópico e validação de resposta direto no console, sem código. F5 AI Guardrails foca em compliance e auditoria, com enforcement de política em runtime e log completo para auditoria regulatória.
LLM Proxy com guardrails embutidos (LiteLLM Guardrails) Camada de proxy que fica entre aplicação e modelo, aplicando guardrail de forma centralizada em todas chamadas. Vantagem: você não precisa modificar código de cada agente ou aplicação, só rotear tráfego pelo proxy.
Escolha depende do contexto. Se você tem conversação estruturada, NeMo faz sentido. Se valida formato de saída, Guardrails AI. Se precisa de classificação de segurança rápida, LlamaGuard. Se quer solução gerenciada com SLA, serviço de cloud.
Aspecto legal e compliance: o que jurídico vai perguntar
Guardrails não são só questão técnica. São evidência de governança responsável quando regulador ou auditor aparecer.
EU AI Act Entrou em aplicação geral em 2025. Sistemas de IA de alto risco (emprego, crédito, saúde, aplicação de lei) precisam demonstrar controle técnico documentado, incluindo prevenção de output discriminatório e proteção de dado pessoal. Guardrails são parte do compliance técnico. Você precisa conseguir mostrar:
- Como o sistema previne output ilegal ou discriminatório.
- Log auditável de todas decisões de enforcement.
- Teste contínuo de efetividade dos controles.
GDPR e leis estaduais de privacidade (CCPA, Colorado AI Act) PII não pode vazar em output de modelo. Se acontecer, é violação de privacidade com potencial multa pesada. Guardrails de output que detectam e bloqueiam PII antes de chegar no usuário são controle técnico direto para compliance com GDPR Article 32 (security of processing).
Litígio e responsabilidade civil Novas leis estaduais nos EUA (Colorado, Califórnia) permitem ação civil por dano causado por sistema de IA. Se seu chatbot de saúde alucina tratamento perigoso e alguém se machuca seguindo a recomendação, você vai precisar provar que tinha controle razoável em vigor. Guardrail documentado e testado é defesa.
Documentação é evidência Quando auditoria ou investigação acontecer, você vai precisar mostrar:
- Políticas de AI governando o que o sistema pode e não pode fazer.
- Controles técnicos implementados (guardrails, validação, monitoring).
- Logs de enforcement mostrando quando guardrail bloqueou violação.
- Testes adversariais demonstrando que você tentou quebrar o sistema antes de colocar em produção.
Se você não tem nada disso, conversa com jurídico fica bem mais difícil.
Como começar sem paralisar o projeto
Guardrails soam como burocracia que vai atrasar tudo. Não precisa ser assim se você priorizar certo.
Passo 1: Classifique risco do caso de uso Nem toda aplicação de IA tem o mesmo nível de risco.
- Alto risco: saúde, financeiro, jurídico, contratação, concessão de crédito, qualquer coisa regulada.
- Médio risco: suporte ao cliente com acesso a dado interno, assistente de produtividade com permissão de escrita.
- Baixo risco: brainstorming interno, geração de conteúdo sem dado sensível, rascunho de código que sempre passa por revisão humana.
Comece pelos casos de alto risco. Se você só tem baixo risco, guardrail pode ser mais simples.
Passo 2: Implemente camada 1 (regras rápidas) em tudo Regex, rate limit e validação de tamanho são triviais de implementar e já cortam ataque óbvio. Escrever regex para detectar CPF, cartão de crédito e email leva uma tarde. Colocar isso na entrada e saída de todo endpoint de LLM é padrão de higiene básica.
Passo 3: Adicione classificadores leves onde tem interação com usuário externo Se o modelo conversa com cliente, parceiro ou qualquer pessoa fora do time, adicione detector de prompt injection e toxicidade. Lakera Guard, LlamaGuard ou equivalente rodam em 50-100ms e pegam tentativa de jailbreak comum.
Passo 4: Use validação semântica com LLM só onde risco justifica o custo Se você está em healthcare, finance ou outro setor regulado, duplicar custo de inferência para ter LLM validando output vale a pena. Caso contrário, guarde essa camada para coisas específicas de alto risco, não para tudo.
Passo 5: Implemente observabilidade desde o dia 1 Guardrails sem métrica são teatro de segurança. Você precisa saber:
- Quantas requisições foram bloqueadas por qual guardrail.
- Latência adicional introduzida por cada camada.
- Taxa de falso positivo (bloqueou coisa legítima) e falso negativo (deixou passar violação).
Ferramentas como Datadog LLM Observability, LangWatch, Portkey oferecem rastreamento de guardrail out-of-the-box.
Passo 6: Teste adversarialmente antes de ir para produção Contrate ou rode internamente red team para tentar quebrar o sistema. Tente extrair system prompt. Tente injetar prompt malicioso. Tente fazer modelo vazar PII. Tente fazer ele executar ação não autorizada. Documente tudo que funcionou, ajuste guardrails, repita. Mindgard, Hidden Layer, Lakera AI e outros oferecem ferramentas de adversarial testing automatizado para LLMs.
Monitoramento contínuo: guardrails não são "configure e esqueça"
LLM e ataques evoluem. Guardrail que funciona hoje pode ser bypassado amanhã.
Você precisa de loop de feedback contínuo:
Monitorar violações em produção Toda vez que guardrail bloqueia requisição, log completo com contexto. Revise periodicamente para detectar padrão novo de ataque ou falso positivo recorrente.
Atualizar modelo de classificação Técnicas de jailbreak evoluem rápido. Modelo de detector de prompt injection de seis meses atrás já está desatualizado. Retreine com exemplos novos de ataque documentado pela comunidade de segurança.
Rastrear efetividade por tipo de guardrail Se você tem cinco guardrails diferentes, qual deles realmente pega violação e qual só adiciona latência sem benefício? Métrica de precision/recall por guardrail te ajuda a otimizar stack sem perder proteção.
Integrar guardrails no CI/CD Toda mudança de prompt, modelo ou configuração passa por teste de regressão com conjunto de casos adversariais. Se update quebra guardrail ou introduz nova vulnerabilidade, pipeline bloqueia deploy.
Segurança de LLM é operacional, não projeto de uma vez. Você precisa de pessoa, processo e ferramenta rodando continuamente, não só configuração inicial.
Conclusão: guardrails são seguro, não opcional
Colocar LLM em produção sem guardrail é negligência técnica disfarçada de agilidade.
Quando o modelo vazar PII, quando jurídico receber notificação de regulador, quando cliente processar por dano causado por alucinação do chatbot, a pergunta não vai ser "por que você não tinha IA perfeita?". Vai ser "por que você não tinha controle básico de segurança?"
Guardrails são a resposta técnica para essa pergunta. Eles não tornam modelo perfeito. Tornam sistema auditável, controlável e defensável.
Se você gerencia time que constrói produto com IA, guardrails não são feature que "vamos adicionar depois". São requisito de arquitetura que entra desde o protótipo.
O custo de adicionar depois, quando já tem tráfego em produção e incidente documentado, é 10x maior que colocar desde o começo.
E se você acha que compliance e governança são "problema de advogado", vai descobrir rápido que multa de seis dígitos vira problema de orçamento, prioridade e emprego.
Bota o cinto antes de ligar o carro.
Insights & Takeaways
- Guardrails são camadas de validação de entrada, processamento e saída que impedem LLM de causar dano legal, financeiro ou reputacional.
- OWASP Top 10 para LLMs 2025 lista prompt injection, vazamento de dado sensível, excessive agency, system prompt leakage e unbounded consumption como maiores riscos.
- Defesa em três camadas (regras rápidas, classificadores leves, validação semântica com LLM) equilibra custo, latência e proteção.
- Ferramentas como NeMo Guardrails, Guardrails AI e LlamaGuard resolvem 90% dos casos sem reinventar a roda.
- Compliance com EU AI Act, GDPR e leis estaduais exige guardrails documentados, testados e auditáveis como evidência de governança responsável.