IA First · Episódio 10
Data Lake Para IA: Do "Joga No S3" ao "Consigo Explicar de Onde Saiu Essa Resposta"
Data lake que sustenta IA auditável: catálogo, lineage, gate de qualidade, mascaramento de PII, controle de acesso e versionamento de datasets.
Neste artigo · 13 seções
- O cenário que você provavelmente reconhece
- O que muda quando o consumidor dos dados é um modelo de IA
- Data catalog: o inventário que ninguém quer manter (mas todo mundo precisa)
- Data lineage: de onde veio, por onde passou, onde parou
- Qualidade de dados: o garbage que o modelo não filtra
- PII e dados sensíveis: o que o modelo não deveria ver
- Controle de acesso: nem todo dado é pra todo modelo
- Versionamento de datasets: a reprodutibilidade que ninguém tem
- A arquitetura do data lake orientado a IA
- O impacto concreto em RAG, treinamento e auditoria
- Começando: o mínimo que faz diferença
- Conclusão
- Insights & Takeaways
O cenário que você provavelmente reconhece
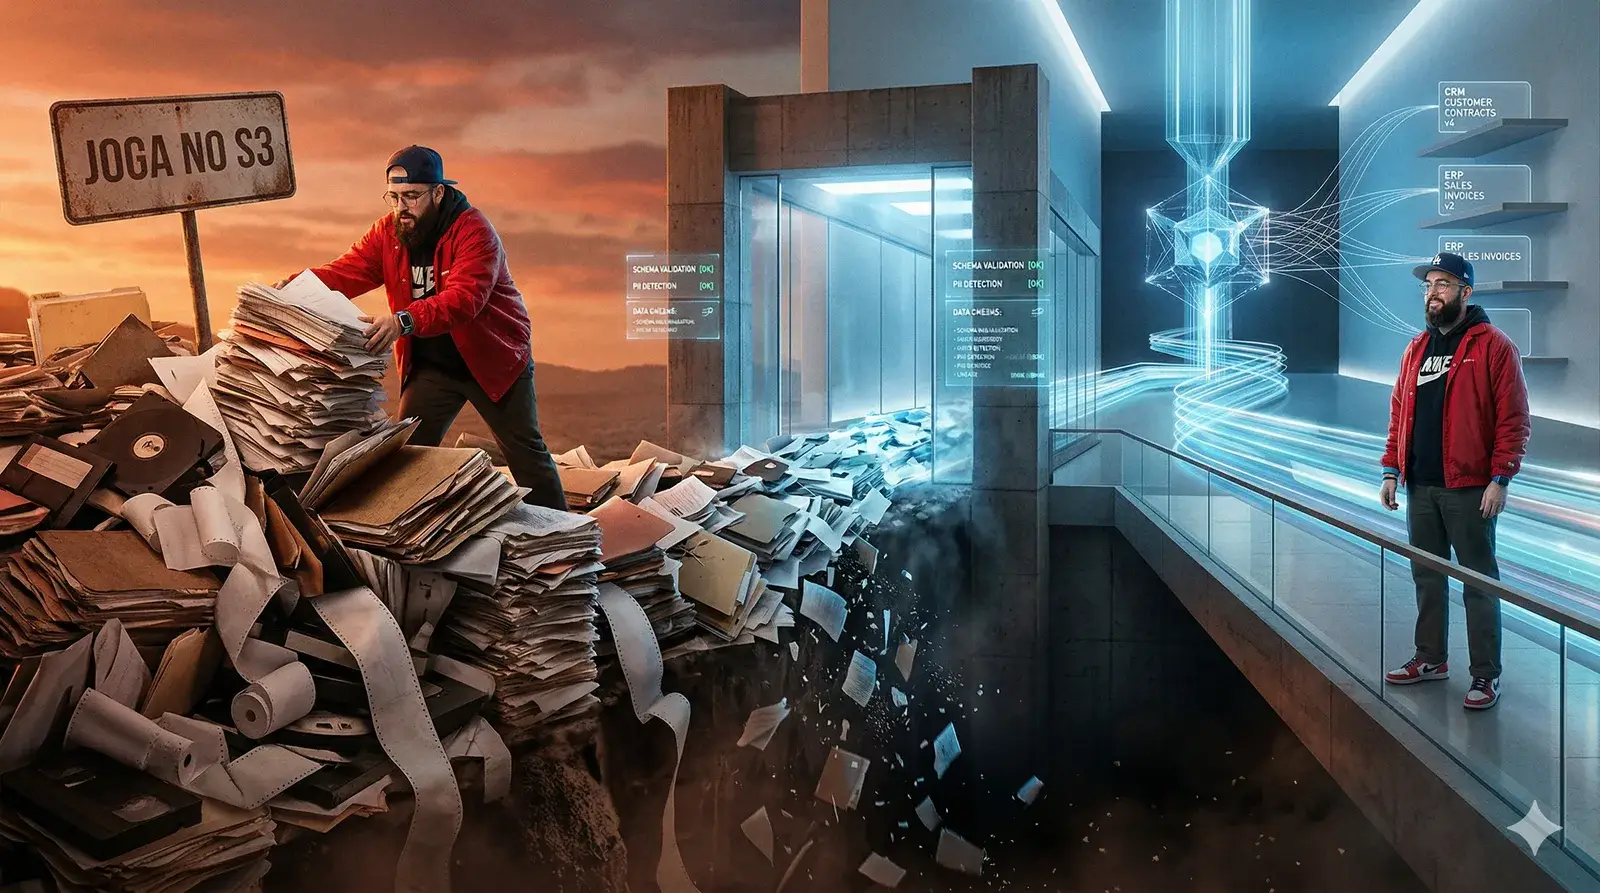
Alguém no time precisa de dados pra treinar um modelo, alimentar um pipeline de RAG ou montar um dataset de avaliação. O que acontece? Alguém exporta um CSV do banco de produção, joga num bucket S3, manda o path no Slack, e o colega de data science baixa e começa a trabalhar. Três meses depois, ninguém sabe de onde aquele CSV veio, se os dados ainda são válidos, se tinha PII ali dentro, ou qual versão do dataset foi usada pra gerar aquele modelo que está em produção hoje.
Isso é o "data lake" na maioria das empresas. Uma coleção de arquivos em cloud storage com nomes tipo dados_clientes_final_v2_REVISADO.parquet. Funciona pra experimentação rápida. Não funciona pra nada que precise ser auditado, explicado ou reproduzido.
E aí está o problema. IA em produção precisa de tudo isso. Quando alguém pergunta "de onde veio essa resposta?", a rastreabilidade não termina no chunk que o modelo recebeu. Ela vai até o dado de origem: qual documento, qual versão, quando foi ingerido, quem aprovou, se passou por validação de qualidade. Se você não consegue responder esse caminho inteiro, está operando num nível de risco que, em mercados regulados, pode virar problema sério. E mesmo fora de mercados regulados, é o tipo de coisa que transforma um incidente de IA numa crise de confiança.
Esse artigo é sobre como sair do "joga no S3" e chegar num data lake que suporta IA de verdade. Não é sobre ferramentas específicas. É sobre os conceitos de engenharia de dados que fazem a diferença entre um repositório de arquivos e uma infraestrutura de dados governável.
O que muda quando o consumidor dos dados é um modelo de IA
Um data lake tradicional serve analistas e dashboards. Os consumidores são humanos que olham pra um gráfico, interpretam, e aplicam julgamento. Se um dado está levemente errado, o analista provavelmente percebe. Se um campo tem formato inconsistente, o analista ajusta na query.
Quando o consumidor é um modelo de IA, essas salvaguardas humanas desaparecem. O modelo não questiona. Não percebe que um campo de data está no formato americano em metade dos registros e no formato brasileiro na outra metade. Não desconfia quando o mesmo cliente aparece duas vezes com nomes diferentes. Não sabe que aquele CSV de preços é de 2023 e os preços mudaram.
A coisa é que modelos amplificam problemas de dados. Um dado sujo num dashboard gera um número errado que um humano pode questionar. Um dado sujo no contexto de um LLM gera uma resposta errada que o usuário aceita como verdade, porque veio formatada com convicção e citando "fontes". Um dado sujo num dataset de fine-tuning se propaga pra milhares de respostas futuras.
Isso muda o nível de exigência. O data lake pra IA não precisa ser perfeito (nenhum data lake é), mas precisa ser governado: saber o que tem ali, de onde veio, quando foi atualizado, quem pode acessar, e qual o nível de confiança de cada dataset.
Data catalog: o inventário que ninguém quer manter (mas todo mundo precisa)
Um data catalog é, no fundo, um inventário dos seus dados. Parece burocracia. Não é. É a diferença entre "temos dados, mas ninguém sabe onde" e "sabemos exatamente o que temos, o que cada coisa significa, e quem é responsável".
Pra IA, o catálogo precisa responder quatro perguntas sobre cada dataset:
O que é isso? Nome, descrição, esquema, formato, volume. Parece óbvio, mas quantos arquivos no seu S3 ou Azure Blob Storage têm nomes auto-explicativos e documentação do esquema? A resposta honesta geralmente é "poucos".
De onde veio? Sistema de origem, processo de extração, frequência de atualização, data da última ingestão. Se é um export do CRM, do ERP, de um scraping, de um formulário, de uma API externa. Essa informação é o primeiro elo do lineage.
Quem é o dono? Qual time ou pessoa é responsável pela qualidade e atualidade desse dataset? Sem ownership claro, ninguém mantém, ninguém atualiza, e quando o dado fica obsoleto, ninguém percebe até que uma resposta de IA cause um problema visível.
Quem pode acessar? Controle de acesso por dataset, por coluna, por perfil. Nem todo dado do lake pode alimentar qualquer modelo. Dados de clientes de um tenant não podem vazar pro contexto de outro. Dados financeiros têm restrições de compliance. Dados de RH são sensíveis por natureza. O catálogo precisa registrar essas políticas de forma consultável.
Na prática, um catálogo pode ser tão simples quanto um repositório Git com arquivos YAML descrevendo cada dataset:
dataset:
  name: contratos_clientes
  description: "Contratos ativos e inativos de clientes PJ"
  format: parquet
  location: s3://datalake-prod/contracts/
  schema_ref: schemas/contratos_v3.json
  source_system: crm_salesforce
  extraction: incremental_daily
  last_ingestion: "2026-03-28T04:00:00Z"
  owner_team: data-engineering
  owner_contact: time-dados@empresa.com
  classification: confidential
  contains_pii: true
  pii_fields: [nome_representante, cpf_representante, email]
  retention_policy: 5_years
  quality_checks:
    - null_rate_below_5pct: [valor_contrato, data_inicio]
    - unique: [contrato_id]
    - freshness: max_24h
  consumers:
    - rag_pipeline_contratos
    - dashboard_comercial
  version: "3.1.0"
Não precisa ser um produto comercial de data catalog pra começar. Precisa existir. A evolução pra ferramentas como DataHub, Amundsen, OpenMetadata ou o catálogo nativo do Databricks pode vir depois, quando o volume justificar.
Data lineage: de onde veio, por onde passou, onde parou
Lineage é a rastreabilidade completa de um dado, da origem até o ponto de consumo. Se o data catalog é o inventário, o lineage é o mapa de como os dados se movem.
Pra IA, lineage responde uma pergunta que parece simples mas que derruba a maioria dos times: "esse dado que o modelo usou pra gerar essa resposta, de onde ele veio originalmente?"
O caminho típico de um dado num pipeline de IA é mais longo do que parece:
Cada seta ali é um ponto onde o dado pode ser transformado, filtrado, agregado ou corrompido. Lineage registra cada transformação: o que entrou, o que saiu, qual lógica foi aplicada, quando, e por qual processo.
Sem lineage, quando o modelo dá uma resposta errada e alguém pergunta "por quê?", o máximo que você consegue dizer é "o modelo recebeu esse contexto". Mas de onde veio esse contexto? Qual era o dado original? Ele foi transformado no caminho? A versão mais recente do documento já foi ingerida? O ETL rodou corretamente ontem? Tudo isso fica sem resposta.
Com lineage, você consegue fazer o caminho inverso: da resposta do modelo, pro chunk do RAG, pro dataset curado, pro dado raw, pro sistema de origem. É como ter um git blame dos seus dados.
Na prática, lineage pode ser implementado em diferentes níveis de sofisticação. O mínimo é registrar, em cada etapa do pipeline, o ID do dado de entrada e o ID do dado de saída com um timestamp. O intermediário é usar ferramentas como dbt (que registra lineage de transformações SQL automaticamente), Apache Atlas, ou Marquez. O avançado é ter lineage em tempo real integrado ao catálogo, com visualização gráfica do caminho de cada dado.
Comece pelo mínimo. Já faz diferença enorme.
Qualidade de dados: o garbage que o modelo não filtra
Qualidade de dados é uma disciplina inteira, mas pra IA, alguns aspectos importam mais que outros.
Completude é o mais básico. Campos nulos onde não deveria ter nulo. Se 15% dos contratos não têm data de vencimento, e o modelo recebe um desses contratos como contexto pra responder "quando vence o contrato X?", ele vai inventar uma data ou dizer que não sabe. Nenhum dos dois é bom.
Consistência é o mais traiçoeiro. Mesmo campo com formatos diferentes: "São Paulo", "SP", "Sao Paulo", "SAO PAULO", "são paulo". Pra um humano, é óbvio que é tudo a mesma coisa. Pra um embedding, são representações diferentes. Se o índice RAG tem "São Paulo" e o usuário digita "SP", a busca semântica pode não conectar os dois.
Atualidade é o mais perigoso pro contexto de IA. Dado desatualizado que o modelo apresenta como fato atual. Preço de um produto que mudou. Política interna que foi revisada. Informação de contato de um funcionário que saiu da empresa. O dado não está "errado" no sentido técnico; estava certo quando foi ingerido. Mas está obsoleto, e o modelo não sabe disso.
Duplicidade é o problema que infla custos e confunde retrieval. Mesmo documento indexado duas vezes com metadados levemente diferentes. Mesmo registro aparecendo em dois datasets com valores conflitantes. O modelo recebe informação duplicada ou contraditória e precisa escolher sem critério.
Como operacionalizar isso? Com checks automatizados no pipeline de ingestão. Antes de um dataset chegar na zona curada do lake, ele passa por validações:
O conceito de quarentena é importante. Dados que não passam nos checks não vão pra zona curada. Ficam numa zona de quarentena, com alerta pro time responsável. O pipeline de IA só consome da zona curada. Isso evita que dados problemáticos cheguem no contexto do modelo sem ninguém perceber.
Ferramentas como Great Expectations, Soda, dbt tests ou até scripts simples de validação dão conta disso. O mecanismo importa menos que a disciplina de ter o gate de qualidade antes do consumo.
PII e dados sensíveis: o que o modelo não deveria ver
Esse é o assunto que faz o jurídico perder o sono, e com razão.
Quando você alimenta um modelo com dados pra RAG ou fine-tuning, qualquer informação pessoal nos dados pode potencialmente aparecer numa resposta. CPF, nome completo, e-mail, telefone, endereço, dados de saúde, dados financeiros. Se o modelo recebe isso como contexto, ele pode devolver isso pro usuário. E dependendo de quem é o usuário, isso é vazamento de dados.
A abordagem tem duas camadas.
Camada 1: classificação e marcação. Cada campo de cada dataset precisa estar classificado quanto à presença de PII. Isso pode ser feito manualmente (no catálogo, como mostrei antes) ou com ferramentas automatizadas de detecção de PII (Presidio da Microsoft, Amazon Macie, Google DLP, ou regex patterns pra casos simples como CPF e e-mail). A classificação precisa existir antes de qualquer consumo por IA.
Camada 2: política de acesso e mascaramento. Com a classificação feita, você define regras. O pipeline de RAG pode acessar o dataset de contratos, mas campos de PII são mascarados antes de chegar no índice. O embedding é gerado sobre o texto mascarado. A resposta do modelo nunca expõe o CPF porque o CPF nunca chegou no contexto.
Mascaramento pode ser: substituição por placeholder ("CPF: ..*-"), remoção do campo, generalização ("cliente da região sudeste" em vez de "João da Silva de São Paulo"), ou tokenização reversível (pra casos onde o dado precisa ser recuperado depois por processo autorizado, mas o modelo não precisa ter acesso ao valor real).
A regra é simples: se o modelo não precisa daquele dado pra gerar uma resposta útil, o modelo não deveria receber aquele dado. Pergunte sempre: "pra responder a pergunta do usuário, o modelo precisa saber o CPF do cliente?" A resposta quase sempre é não.
Um detalhe que passa despercebido: embeddings podem vazar informação. Se você gera um embedding de um texto que contém PII, o embedding em si não é legível, mas pode ser usado pra reconstruir informação aproximada via ataques de inversão. Pra a maioria dos cenários, o risco é baixo. Pra cenários de alta sensibilidade (saúde, financeiro, jurídico), mascarar antes de gerar o embedding é a abordagem mais segura.
Controle de acesso: nem todo dado é pra todo modelo
Controle de acesso em data lake pra IA tem uma camada a mais que o controle de acesso tradicional. Não é só "quem pode ler". É "qual pipeline pode consumir qual dataset pra qual finalidade".
Em ambientes multi-tenant, isso é particularmente crítico. Os dados do Tenant A não podem aparecer no contexto de uma resposta pro Tenant B. Parece óbvio, mas se todos os dados de todos os tenants estão no mesmo índice vetorial sem segregação, a busca pode retornar chunks de qualquer tenant.
Existem duas abordagens pra resolver isso.
Segregação física: um índice por tenant. Cada tenant tem seu próprio índice vetorial, alimentado só com seus dados. A busca acontece no índice do tenant que está fazendo a query. É a abordagem mais simples e mais segura, mas escala mal quando você tem centenas ou milhares de tenants.
Segregação lógica: um índice compartilhado com filtro por tenant. Todos os chunks estão no mesmo índice, mas cada chunk tem um metadado tenant_id. Toda busca inclui obrigatoriamente um filtro por tenant_id. É mais eficiente em escala, mas depende de o filtro ser aplicado corretamente em 100% das queries. Um bug, um esquecimento, um path de código que não filtra, e você tem cross-tenant data leakage.
Na prática, a escolha depende do volume. Poucos tenants com muito dado cada? Segregação física. Muitos tenants com pouco dado cada? Segregação lógica com testes rigorosos pra garantir que o filtro está sempre presente.
O controle de acesso também precisa cobrir o pipeline de ingestão. Quem pode adicionar dados ao lake? Quem pode promover um dataset de raw pra curado? Quem pode criar um novo índice ou adicionar documentos a um índice existente? Se qualquer dev com acesso ao bucket pode jogar um arquivo e ele automaticamente entra no pipeline de IA, você perdeu o controle do que alimenta seus modelos.
Versionamento de datasets: a reprodutibilidade que ninguém tem
Pergunta: se o modelo deu uma resposta errada ontem, você consegue reproduzir exatamente o estado dos dados que existia ontem?
Na maioria das implementações, a resposta é não. O índice foi atualizado desde então. Novos documentos foram adicionados. Alguns foram removidos. O dataset que alimentou o fine-tuning foi substituído. Reproduzir o estado anterior é impossível porque ninguém versionou.
Versionamento de datasets significa tratar datasets como artefatos imutáveis e versionados, assim como a gente trata código. Cada versão de um dataset tem um identificador único, um timestamp de criação, e uma referência ao conteúdo exato.
Pra dados tabulares, isso pode ser feito com ferramentas como Delta Lake, Apache Iceberg ou Apache Hudi, que implementam time-travel sobre arquivos Parquet. Você consegue consultar "como estava essa tabela em 2026-03-15T10:00:00Z?" sem manter cópias separadas.
Pra documentos não-estruturados (os que alimentam RAG), o versionamento geralmente é por referência: cada documento tem um ID e uma versão, cada versão aponta pra um arquivo específico no storage, e o índice registra qual versão de qual documento gerou cada chunk.
Pra datasets de treinamento e avaliação, o versionamento pode ser feito com DVC (Data Version Control), que funciona como um Git pra arquivos grandes. Cada "commit" de dados registra exatamente quais arquivos compõem aquela versão do dataset.
O diagrama de como isso se conecta:
Se amanhã alguém questionar uma resposta do modelo, o lineage completo te leva do interaction_id até as versões exatas do índice, do dataset de treino, do documento fonte e do modelo. Isso é reprodutibilidade. E é o que reguladores pedem quando querem entender como uma decisão automatizada foi tomada.
A arquitetura do data lake orientado a IA
Juntando tudo, um data lake preparado pra IA tem zonas com propósitos claros e controles em cada transição:
As zonas funcionam assim:
Raw zone é onde os dados chegam, no formato original, sem transformação. É imutável: você nunca altera um dado na raw zone, só adiciona. Isso preserva a fonte da verdade e permite reprocessar se a lógica de transformação mudar.
Curated zone é onde os dados vivem depois de limpos, normalizados e validados. É o que os pipelines de IA consomem. A promoção de raw pra curated passa pelo gate de qualidade. Sem aprovação no gate, o dado não avança.
A separação entre raw e curated parece burocrática, mas salva em cenários reais. "O ETL de normalização tinha um bug que estava cortando os últimos dois dígitos do CEP." Se os dados raw estão preservados, você corrige o ETL e reprocessa. Se não tem raw zone e o dado já foi transformado in-place, boa sorte recuperando.
O impacto concreto em RAG, treinamento e auditoria
Tudo que discutimos até aqui converge nesses três cenários de consumo. Vamos ver como cada um é afetado.
Pra RAG, o data lake governado muda o jogo em freshness e rastreabilidade. O pipeline de indexação consome da zona curada, que tem SLA de atualização. Se o SLA é "dados atualizados em até 24h", o índice RAG reflete isso. Cada chunk no índice tem referência ao documento de origem, com versão e data. Quando o modelo cita uma fonte na resposta, essa fonte é verificável e rastreável até o sistema de origem. Se um documento é atualizado, o pipeline sabe qual versão anterior invalidar e qual nova versão indexar. Sem o data lake governado, o índice RAG é uma foto estática que envelhece silenciosamente.
Pra treinamento e fine-tuning, o impacto é em reprodutibilidade e compliance. Um dataset de treinamento versionado significa que, se o modelo fine-tuned apresentar comportamento indesejado, você consegue inspecionar exatamente quais dados foram usados. Campos de PII mascarados antes de chegar no dataset significam que o modelo nunca aprendeu informações pessoais. Lineage do dataset até os sistemas de origem significa que, se um dado fonte for corrigido, você sabe quais datasets derivados e quais modelos foram afetados.
Pra auditoria, tudo se conecta. O auditor (interno ou regulatório) pergunta: "essa decisão automatizada foi baseada em quais dados?" Com a infraestrutura certa, a resposta é: "A resposta foi gerada pelo modelo X versão Y, usando contexto do índice RAG snapshot Z, que contém chunks dos documentos A v3.1, B v2.0 e C v1.4, originados dos sistemas CRM e GED, ingeridos em tal data, que passaram por validação de qualidade com resultado OK." Sem a infraestrutura, a resposta é: "O modelo respondeu isso. Não sei exatamente de onde veio."
A segunda resposta pode funcionar num produto B2C de baixo risco. Num banco, numa seguradora, numa operação de trading, numa empresa de saúde? Não funciona.
Começando: o mínimo que faz diferença
Não precisa montar um Databricks Lakehouse no dia 1. Mas precisa ter disciplina desde o dia 1.
O mínimo viável é: separação entre raw e curated, nem que seja duas pastas diferentes no mesmo bucket com uma convenção de nomes clara. Um arquivo de catálogo (YAML, Markdown, planilha, o formato importa menos que a existência) documentando cada dataset com nome, origem, owner, classificação de sensibilidade e data da última atualização. Um check de qualidade, mesmo que seja um script Python no pipeline de ingestão que valida campos obrigatórios e formatos antes de promover pra zona curada. E marcação de PII nos campos que contêm dados pessoais, com política de mascaramento definida antes de qualquer consumo por IA.
Isso cabe numa sprint. Não resolve tudo, mas resolve o suficiente pra que, quando alguém perguntar "de onde veio esse dado?", a resposta não seja um encolher de ombros.
Conclusão
Data lake pra IA é governança de dados aplicada. Não é um conceito novo. É o conceito de sempre, com urgência renovada, porque agora o consumidor dos seus dados é um sistema que não questiona, não interpreta e não desconfia. Se o dado está errado, o modelo amplifica o erro. Se está desatualizado, o modelo apresenta informação obsoleta como fato. Se contém PII, o modelo pode expor.
A cadeia de rastreabilidade completa, do sistema de origem até a resposta do modelo, é o que permite operar IA com confiança. Sem isso, cada resposta gerada é um ponto cego. Com isso, cada resposta é explicável, auditável e corrigível.
E a pergunta que deveria guiar toda decisão de arquitetura de dados pra IA é essa: "daqui a 6 meses, quando alguém questionar uma resposta do modelo, eu consigo explicar de onde saiu?"
Insights & Takeaways
-
Modelos de IA amplificam problemas de dados porque não questionam, não interpretam e não desconfiam. O nível de exigência de qualidade de dados pra IA é maior do que pra dashboards e relatórios.
-
Um data catalog, mesmo que simples, é obrigatório. Cada dataset precisa ter origem, owner, classificação de sensibilidade e SLA de atualização documentados. Sem isso, ninguém sabe o que alimenta os modelos.
-
Lineage de ponta a ponta, do sistema fonte até a resposta do modelo, é o que permite auditoria real. Sem lineage, a rastreabilidade morre no "o modelo recebeu esse contexto" sem saber de onde o contexto veio.
-
PII precisa ser classificada e mascarada antes de chegar no pipeline de IA, não depois. Se o modelo recebeu o dado, o risco de exposição já existe. Mascarar na origem é a abordagem mais segura.
-
Comece com o mínimo: separação raw/curated, catálogo em arquivo, checks de qualidade no pipeline e marcação de PII. Cabe numa sprint e já permite responder "de onde veio esse dado?" sem encolher os ombros.