IA First · Episódio 18
Segurança e Compliance em Produtos com IA: Do LGPD ao "Não Deixa Esse Modelo Ver Esse Dado"
Como pôr segurança e LGPD no design de um produto com IA: mapa do fluxo de dados, mascaramento, logs, cláusulas com o provedor e revisão humana de decisões.
Neste artigo · 11 seções
- A conversa que ninguém quer ter mas que define o futuro do projeto
- O que muda quando IA entra no processamento de dados
- Mapeamento do fluxo de dados: o exercício obrigatório
- Classificação e segregação de dados
- Mascaramento e tokenização: detalhes que importam
- Logs: a parte que ninguém olha até dar problema
- Contratação de provedor: a parte legal que afeta o design
- Decisões automatizadas e direito de revisão
- Como conversar com jurídico, risco e segurança sem travar o time
- Conclusão
- Insights & Takeaways
A conversa que ninguém quer ter mas que define o futuro do projeto
Em algum momento, todo projeto de IA em empresa séria chega na conversa difícil. O time tem uma feature pronta pra entrar em produção. O jurídico pede pra revisar. A área de risco operacional quer entender o fluxo de dados. Segurança da informação pergunta como o provedor armazena os prompts. Compliance quer saber se houve avaliação de impacto sob LGPD.
E aí aparecem perguntas que ninguém pensou direito: o que acontece com os dados que mandamos pro modelo? O provedor pode usar isso pra treinar versões futuras? Esse cliente assinou autorização pra ter dados processados por IA? E se o modelo, num caso específico, vazar informação de outro cliente na resposta? Quem responde por isso?
Essas perguntas costumam pegar o time de surpresa. Não porque sejam injustas, mas porque o time pensou em arquitetura, em prompt engineering, em latência, em custo, mas não pensou em compliance como requisito de design. Aí o lançamento atrasa, ou, pior, lança e descobre as consequências depois.
Esse artigo é sobre como integrar segurança e compliance no design de produtos com IA desde o começo. Não é um manual jurídico; é um guia de engenharia pra desenhar sistemas que conseguem responder essas perguntas com confiança quando elas chegam.
O que muda quando IA entra no processamento de dados
Sistemas tradicionais já têm seus próprios desafios de compliance. LGPD se aplica há anos, princípios de minimização de dados, controle de acesso, finalidade específica, tudo isso já é conhecido. O que muda com IA?
Três coisas mudam, e mudam bastante.
Primeiro, o destino dos dados se expande. Antes, dados ficavam dentro do seu perímetro: bancos, caches, logs internos. Com IA, especialmente IA via API de provedor externo, dados saem do seu ambiente. Vão pra um terceiro processar e voltam. Esse trânsito precisa estar mapeado, contratado e auditado.
Segundo, a natureza do processamento muda. Sistemas tradicionais executam regras determinísticas. IA toma decisões probabilísticas. Sob LGPD, decisões automatizadas que afetam pessoas têm regras específicas: direito de revisão humana, transparência sobre critérios, direito de não ser submetido a decisão exclusivamente automatizada em alguns contextos. Não é só mais um processamento; é um tipo de processamento que tem regulação específica.
Terceiro, o risco de vazamento muda de natureza. Em sistema tradicional, vazamento é um bug ou um ataque. Em sistema com LLM, o vazamento pode ser comportamento "normal" do modelo: ele recebeu dados de um cliente no contexto, gerou uma resposta que misturou esses dados com a resposta de outro. Não houve invasão; a arquitetura permitiu.
Esses três fatores juntos exigem que segurança e compliance sejam pensadas como propriedades do design, não como camada adicionada depois.
Mapeamento do fluxo de dados: o exercício obrigatório
Antes de pensar em qualquer controle, é preciso saber o que está acontecendo com os dados. Mapeamento de fluxo de dados pra um sistema de IA tem algumas perguntas que o time precisa responder pra cada feature:
Que dados entram no sistema? De onde vêm (input do usuário, banco de dados, integração)? Têm classificação de sensibilidade?
Que dados são incluídos no contexto enviado ao modelo? System prompt, contexto RAG, histórico, tool results, mensagem do usuário. Cada um desses pode conter PII ou dado confidencial.
Pra onde os dados são enviados? Provedor de LLM externo? Modelo self-hosted? Múltiplos provedores em fallback?
O que é registrado em log? Prompts completos? Respostas? Apenas metadados? Logs ficam onde, por quanto tempo?
Que dados são retornados ao usuário? A resposta do modelo pode conter informações que o usuário não deveria ter? Pode misturar dados de fontes diferentes?
Visualizar isso num diagrama por feature é o primeiro entregável de uma boa avaliação:
Cada seta nesse diagrama é um ponto de decisão de compliance: que dado passa por aqui? Tem PII? Foi mascarado? Pode ir pro provedor externo? Foi consentido pra esse uso?
Sem esse mapa, qualquer conversa com jurídico vira teórica. Com o mapa, vira concreta: "nesse ponto, esses dados vão pro provedor X, que tem cláusula contratual Y de não treinamento e retenção zero."
Classificação e segregação de dados
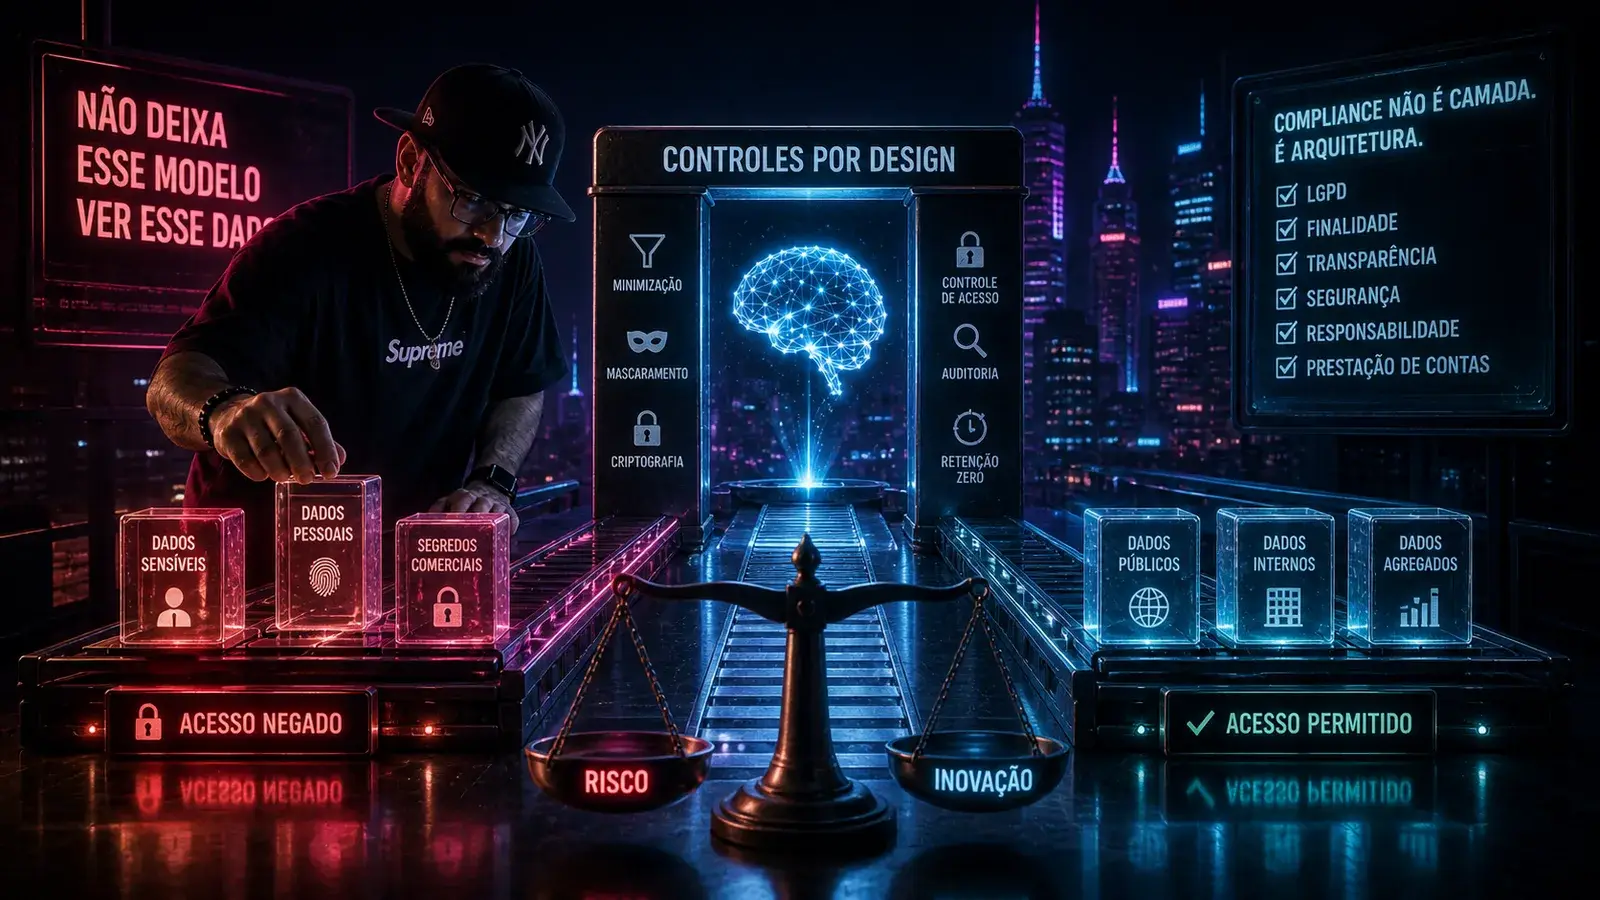
Nem todo dado tem o mesmo nível de sensibilidade, e nem todo modelo deveria ter acesso a tudo. Classificar dados é o passo que permite tomar decisões de segregação com base em critério claro.
A classificação pode usar três níveis simples (várias empresas usam mais, mas três cobre a maioria dos casos):
Pública. Dados que podem ser expostos sem restrição. Catálogo de produtos, FAQ, documentação pública.
Interna. Dados não-públicos mas sem informação pessoal sensível. Processos internos, organogramas, dados agregados de operação.
Sensível. Dados pessoais (sob LGPD), dados financeiros, dados de saúde, segredos comerciais. Tem regras específicas de tratamento.
Com a classificação no lugar, regras de segregação ficam discutíveis. Dados sensíveis podem ir pro modelo? Quais modelos? Em que circunstâncias? Pra quais finalidades?
Algumas decisões que costumam funcionar:
Dados sensíveis nunca vão pro modelo sem necessidade explícita. A pergunta é: pra responder a pergunta do usuário, o modelo precisa saber esse dado específico? Se não precisa, não vai. Princípio de minimização aplicado.
Quando precisa ir, o dado é mascarado ou tokenizado antes da chamada. CPF vira ***.***.***-**. Nome de cliente pode virar [CLIENTE_A]. Valor exato vira faixa. O modelo trabalha com a versão mascarada e o sistema reverte na resposta se necessário.
Dados sensíveis e dados de tenants diferentes nunca compartilham contexto. Em sistemas multi-tenant, segregação rigorosa entre contextos. O modelo não pode receber, na mesma chamada, dados do tenant A e do tenant B, mesmo que a infraestrutura seja compartilhada.
A segregação é tanto lógica (controles em código) quanto contratual (acordos com provedores que estabelecem como dados são tratados do lado deles).
Mascaramento e tokenização: detalhes que importam
Mascaramento é substituir dado sensível por placeholder antes de enviar ao modelo. Tokenização é substituir o dado por um identificador reversível, mantendo o original num cofre.
A diferença prática é importante. Com mascaramento simples, a informação se perde: o modelo nunca vê "João Silva", vê "[NOME]". Se a resposta precisa retornar o nome real ao usuário, o sistema precisa fazer essa correlação fora do modelo. Com tokenização, o modelo vê "TKN_84721", e o sistema sabe que TKN_84721 corresponde a João Silva, podendo reverter na resposta antes de retornar ao usuário.
Quando usar cada um?
Mascaramento simples é melhor quando o dado real não precisa aparecer na resposta. Análise de sentimento de avaliação, classificação de e-mail, resumo de documento.
Tokenização é melhor quando o dado precisa estar na resposta final mas não pode ser visto pelo modelo. Por exemplo: "envie um e-mail confirmando o pedido para o cliente". O modelo gera o texto com placeholder, o sistema substitui pelo dado real depois.
Em ambos os casos, é fundamental que o componente que faz mascaramento/tokenização seja consistente. Não adianta um caminho de código mascarar CPF e outro caminho enviar CPF cru. Esse tipo de inconsistência é a fonte mais comum de incidente. Centralizar essa lógica em um único componente (Context Assembler, como discutimos no artigo de arquitetura de backend) e garantir que todo dado que vai pro modelo passa por ele é o que evita bug de vazamento.
Logs: a parte que ninguém olha até dar problema
Logs de interação com IA são uma faca de dois gumes. Sem eles, você não consegue debugar, auditar ou rastrear comportamento. Com eles, você criou um repositório de prompts e respostas que pode conter dados sensíveis, e que precisa ser tratado com o mesmo rigor que qualquer base de dados sensível.
Algumas decisões importantes:
O que entra no log? O ideal é registrar metadados completos (modelo, tokens, latência, custo, IDs) e referências aos artefatos grandes (prompt, contexto, resposta) que ficam num storage separado com controle de acesso mais restrito. Logar tudo inline é receita pra vazamento via análise de log.
Por quanto tempo? Política de retenção precisa estar definida e justificada. 30 dias pra debugging operacional? 1 ano pra auditoria? 5 anos pra compliance regulatório? A definição depende do setor, mas precisa existir.
Quem acessa? Logs com prompts completos são uma fonte de informação sensível. Acesso deveria ser restrito por papel, com auditoria de quem consultou o quê.
PII nos logs? Se o prompt continha PII, o log também contém. Algumas empresas optam por aplicar mesmo mascaramento nos logs que aplicam no prompt. Outras mantêm logs originais com controle de acesso forte. A decisão depende de como você balanceia capacidade de debug com risco de exposição.
Direito de eliminação. LGPD dá ao titular o direito de pedir eliminação dos dados. Se logs de IA contêm dados de um titular que pediu eliminação, esses logs precisam ser eliminados também. Sem mecanismo pra fazer isso (busca por titular nos logs e remoção), o pedido vira problema operacional.
Contratação de provedor: a parte legal que afeta o design
A escolha do provedor de LLM é tanto técnica quanto contratual. Algumas cláusulas que importam pra compliance:
Não treinamento com dados do cliente. Provedor confirma por contrato que dados enviados via API não são usados pra treinar versões futuras do modelo. Sem essa cláusula, qualquer dado que você manda pode acabar incorporado em treinamento, e isso é problema sério.
Retenção zero ou definida. Provedor confirma quanto tempo retém os dados após o processamento. Algumas opções de provedores oferecem retenção zero (dados deletados imediatamente após resposta), o que é o ideal pra dados sensíveis.
Localização de processamento. Em alguns setores, dados precisam ser processados em jurisdições específicas. Provedor confirma onde os data centers estão e se honra restrições geográficas.
Subprocessadores. Provedor lista quem mais processa os dados (cloud providers, parceiros). Cada subprocessador é mais um ponto de exposição.
Notificação de incidente. Provedor compromete-se a notificar em prazo razoável caso haja incidente que afete seus dados.
Capacidade de auditoria. Você pode pedir relatórios de segurança (SOC 2, ISO 27001), evidência de controles, ou auditoria sob demanda?
Na prática, isso significa que o time de IA precisa trabalhar com jurídico desde a escolha do provedor, não depois. E precisa também estar preparado pra justificar tecnicamente por que escolheu esse e não outro: se o provedor mais barato não tem cláusula de não-treinamento, e a alternativa mais cara tem, a diferença de preço se compensa em mitigação de risco.
Decisões automatizadas e direito de revisão
LGPD tem um artigo (artigo 20) que merece atenção especial em IA: o titular tem direito a solicitar revisão de decisões tomadas exclusivamente com base em tratamento automatizado que afetem seus interesses, incluindo decisões destinadas a definir perfil pessoal, profissional, de consumo, etc.
Isso significa, na prática, que features de IA que tomam decisões com impacto significativo precisam ter mecanismo de revisão humana acessível ao titular. "Esse cliente foi recusado pelo modelo" não é justificativa suficiente; precisa ter caminho pra reanalisar com humano.
Algumas implicações de design:
Decisões automatizadas precisam ser explicáveis em algum nível. Não exige explicação técnica do modelo, mas exige saber quais critérios foram usados, em linguagem compreensível.
Logs precisam permitir reconstruir a decisão. Se um cliente questiona uma negativa, você precisa conseguir mostrar que dados foram considerados, qual prompt foi usado, qual resposta o modelo deu, e por que isso resultou na decisão.
Caminho de revisão precisa existir e ser acessível. Tipicamente um processo onde a decisão é reanalisada por humano, com dados disponíveis pra esse humano avaliar.
Comunicação ao titular sobre o uso de IA. Em alguns contextos, é necessário informar que decisões estão sendo tomadas com apoio de IA. Transparência é parte do compliance, não opcional.
Como conversar com jurídico, risco e segurança sem travar o time
Essa parte é prática mais que técnica. Times de IA muitas vezes vêem as áreas de governança como obstáculo. As áreas de governança muitas vezes vêem times de IA como descuidados. Os dois estão errados.
Algumas práticas que reduzem fricção:
Trazer compliance pra dentro do design, não pra revisão final. Quando o time desenha a arquitetura, alguém de compliance ou jurídico participa de uma sessão. Não pra aprovar; pra entender e antecipar questões. Isso encurta o ciclo lá na frente.
Documentar decisões em vez de só implementá-las. "Decidimos usar o provedor X com cláusula Y, mascarando campos Z, retendo logs por W dias. As alternativas consideradas foram A, B, C." Esse tipo de registro vira insumo pra qualquer revisão de compliance.
Falar a língua do interlocutor. Pra jurídico, o vocabulário é "tratamento de dados", "finalidade", "base legal", "subprocessador". Pra segurança da informação, é "ameaça", "controle", "vetor de ataque". Pra risco operacional, é "probabilidade", "impacto", "mitigação". O time técnico que aprende esses vocabulários se faz entender melhor.
Apresentar trade-offs explícitos. "A opção mais segura custa 3x mais e tem latência 30% maior. A opção atual tem essa exposição de risco. A área de risco quer aceitar essa exposição ou aprovar o custo adicional?" Decisões viram explícitas em vez de empurradas pra um lado ou outro.
E uma observação: governança que diz não a tudo é tão problemática quanto time que ignora governança. O objetivo é encontrar o caminho que viabiliza o produto dentro de limites aceitáveis, não bloquear ou ignorar.
Conclusão
Segurança e compliance em IA não são uma camada adicional; são propriedades do design. Mapear fluxo de dados, classificar sensibilidade, segregar contextos, mascarar quando possível, escolher provedor com cláusulas adequadas, manter logs com controle, garantir caminho de revisão humana. Tudo isso é decisão de arquitetura, não documentação a ser preenchida no fim.
A diferença entre um produto de IA que entra em produção e cresce, versus um que entra e descobre problema regulatório seis meses depois, está nesse trabalho feito antes. Não é espetacular. Não vira post de LinkedIn celebrando deploy. Mas é o que sustenta o produto quando ele cresce e atrai atenção.
E a pergunta honesta que vale fazer: "se o regulador, o jurídico, ou o cliente sensível chegar amanhã pedindo evidência de como esse sistema trata dados, eu consigo apresentar com confiança?" Se a resposta tem hesitação, tem trabalho a fazer agora, não depois.
Insights & Takeaways
-
IA muda três coisas em compliance: dados saem do seu perímetro pra processadores externos, decisões probabilísticas têm regulação específica, e vazamento pode ser comportamento normal do modelo, não bug. Cada uma exige design intencional.
-
Mapear fluxo de dados por feature é o exercício obrigatório antes de qualquer conversa de compliance. Sem o mapa, discussão fica teórica. Com o mapa, vira concreta e acionável.
-
Mascaramento ou tokenização antes da chamada ao modelo, centralizado num componente único, é o que evita bug de vazamento. Inconsistência entre caminhos de código é a fonte mais comum de incidente.
-
Logs de IA são repositório de dados sensíveis. Política de retenção, controle de acesso, mascaramento e capacidade de eliminação por titular precisam existir desde o dia 1.
-
Compliance não é revisão no fim; é insumo no design. Trazer jurídico, risco e segurança pra dentro do desenho, com vocabulário comum e trade-offs explícitos, é o que reduz fricção e acelera o ciclo.