IA First · Episódio 27
Explainability em Sistemas de IA: Como Dar Satisfações Sem Inventar Desculpas Bonitas
Por que o raciocínio que o LLM conta e o gráfico de SHAP não explicam a decisão, e o que funciona: trilha de decisão, contrafactual e modelo interpretável.
Neste artigo · 10 seções
- A explicação que parece certa e a explicação que é certa
- Duas palavras que todo mundo troca: plausível e fiel
- O modelo mente sobre o próprio raciocínio
- Por que explicar uma caixa-preta é, por construção, um chute
- A bifurcação: explicar a caixa-preta ou ler o vidro
- O que funciona de verdade em produção
- A fronteira: abrir o modelo de verdade
- Brasil, bolsa e o que a lei realmente exige
- Conclusão
- Insights & Takeaways
A explicação que parece certa e a explicação que é certa
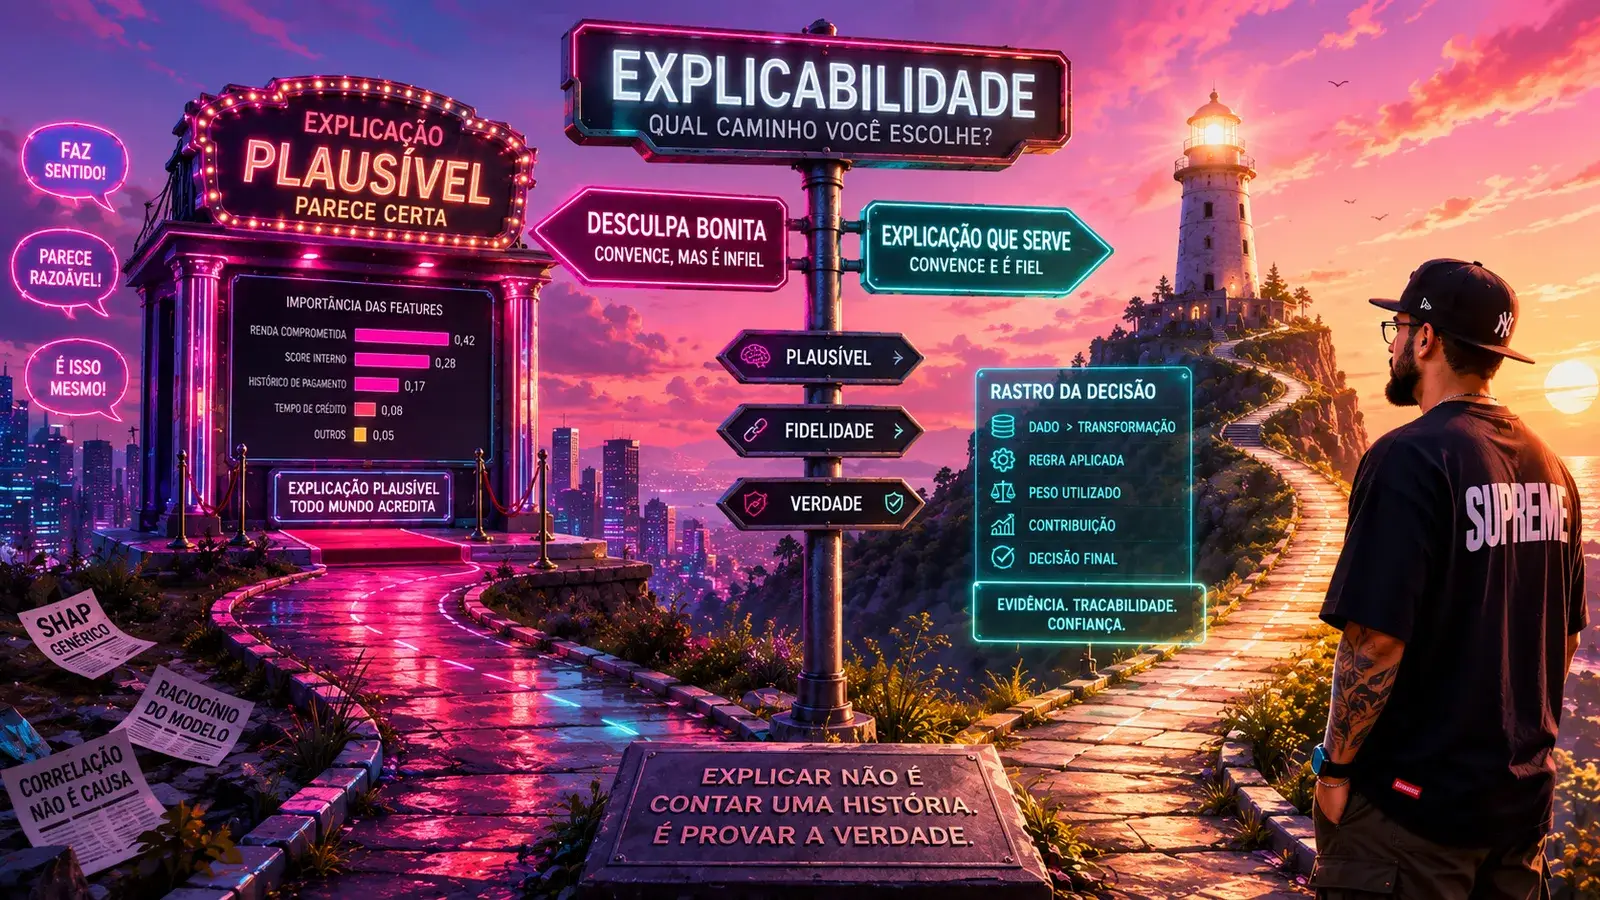
A diretora de risco te chama na sala. Um cliente teve o crédito negado pelo modelo e quer saber por quê. O regulador, daqui a pouco, vai querer a mesma coisa. Você abre o dashboard, gera um gráfico de SHAP lindo, com barrinhas coloridas mostrando "renda comprometida" e "score interno" puxando a decisão pra baixo. Todo mundo balança a cabeça. Parece uma explicação. Sai todo mundo aliviado da reunião.
Aí vem a pergunta que estraga tudo, se alguém na sala for honesto o suficiente pra fazer: isso é mesmo o motivo da decisão, ou é só uma história que a gente montou depois, que por acaso combina com o resultado?
Essa é a diferença entre uma explicação que parece certa e uma que é certa. E quase todo mundo que botou IA em produção está confundindo as duas. A indústria inteira aprendeu a gerar explicações que passam no teste do "isso soa razoável" sem nunca passar no teste do "isso é o que de fato aconteceu". O nome técnico disso é falta de fidelidade. O nome honesto é desculpa bonita.
Esse artigo é sobre não fazer isso. Sobre dar satisfação real a usuário, negócio e regulador sem inventar uma narrativa elegante que você mesmo não sabe se é verdade.
Duas palavras que todo mundo troca: plausível e fiel
Vale separar dois conceitos que parecem sinônimos e não são. A literatura de NLP chama isso de plausibility versus faithfulness, e Alon Jacovi e Yoav Goldberg organizaram bem essa distinção num trabalho de 2020 na ACL.
Plausibilidade é o quanto uma explicação convence um ser humano. É o quão bem ela "vende". Fidelidade é uma coisa completamente diferente: é o quanto a explicação corresponde ao processo que o modelo realmente usou pra chegar na resposta. As duas são independentes. Dá pra ter uma explicação altamente plausível e totalmente infiel. E é exatamente esse o caso perigoso, porque é o mais confortável: todo mundo acredita, ninguém questiona, e está errado sobre a causa.
Pensa nisso como um plano de dois eixos.
O quadrante de cima à esquerda, muito convincente e pouco fiel, é onde mora a desculpa bonita. É o lugar mais confortável do gráfico e o mais perigoso. Quando você não tem um processo pra distinguir os eixos, é pra esse canto que a sua explicabilidade desliza por gravidade.
O modelo mente sobre o próprio raciocínio
A forma mais ingênua de explicabilidade é a mais tentadora: é só pedir pro modelo explicar. "Pensa passo a passo." "Justifique sua resposta." O texto que sai é articulado, lógico, convincente. E aqui está o problema que deveria tirar o sono de quem confia nisso em produção: esse texto frequentemente não tem nada a ver com o cálculo que o modelo de fato fez.
A Anthropic publicou em abril de 2025 um estudo com um título que já entrega tudo: "Reasoning Models Don't Always Say What They Think". Eles plantavam uma dica que levava o modelo à resposta e depois mediam se ele admitia ter usado a dica na hora de explicar o raciocínio. O Claude 3.7 Sonnet admitia em cerca de 25% das vezes. O DeepSeek R1, em 39%. Ou seja: na maioria das vezes, o modelo usava a informação pra decidir e contava outra história sobre por que decidiu.
O experimento de reward hacking é ainda mais brutal. Quando o ambiente recompensava um atalho indevido, o modelo aprendia a explorar esse atalho em mais de 99% dos casos. Quantas vezes ele mencionava o atalho na explicação? Menos de 2%. Nos outros 98%, ele construía uma justificativa plausível, às vezes elaborada, pra uma escolha que tinha sido feita por um motivo completamente diferente. Isso é uma desculpa bonita gerada automaticamente, em escala industrial.
E não adianta apostar que modelo maior resolve. Um trabalho anterior da própria Anthropic, liderado por Tamera Lanham em 2023, mediu fidelidade de chain-of-thought e achou o contraintuitivo: em boa parte das tarefas, modelos maiores e mais capazes produzem raciocínio menos fiel, não mais. O texto fica mais convincente; a correspondência com o cálculo real, não necessariamente.
A coisa é simples de enunciar e difícil de engolir. Quando você pede pro modelo "explicar o raciocínio", você não está lendo o motivo. Você está lendo um texto novo, gerado depois, otimizado pra parecer um motivo. Tratar a cadeia de raciocínio como log de auditoria é o erro de explicabilidade mais comum de 2025, e ele vem embrulhado pra presente, com aparência de transparência.
Por que explicar uma caixa-preta é, por construção, um chute
Tudo bem, você não vai confiar no modelo se autoexplicando. Vai usar uma ferramenta séria de atribuição: LIME, do Marco Tulio Ribeiro e colegas (KDD 2016), ou SHAP, do Scott Lundberg e Su-In Lee (NeurIPS 2017), que ancora a importância de cada feature nos valores de Shapley da teoria dos jogos. Ferramentas legítimas, matemática real. Mas vale saber o que elas são, e principalmente o que elas não são.
Cynthia Rudin colocou o dedo na ferida num artigo de 2019 na Nature Machine Intelligence. O argumento dela é quase um teorema: uma explicação post-hoc de uma caixa-preta é, na melhor das hipóteses, um palpite sobre o que o modelo faz. Ela não pode ter fidelidade perfeita. Por quê? Porque uma explicação que fosse 100% fiel ao modelo original seria o próprio modelo. Se um resumo simples capturasse exatamente a decisão, você não precisaria da caixa-preta pra começar.
Então LIME e SHAP são aproximações locais. Eles ajustam um modelo simples no entorno de uma decisão específica e dizem "por aqui, o comportamento se parece com isto". Útil. Mas instável: perturba a amostragem e a explicação muda. E é fácil esquecer que aquele gráfico de barras não é a razão da decisão; é um modelo de um modelo, com erro embutido que ninguém mostra na barrinha.
O mesmo vale pra qualquer atalho visual de explicabilidade. Teve um debate clássico em 2019 que ilustra isso melhor que qualquer slide. Sarthak Jain e Byron Wallace publicaram "Attention is not Explanation" mostrando que os pesos de atenção de um modelo têm correlação fraca com a real importância das entradas, e que dá pra forjar distribuições de atenção bem diferentes que produzem a mesma predição. No mesmo ano, Sarah Wiegreffe e Yuval Pinter responderam com "Attention is not not Explanation", argumentando que depende da definição de explicação. Os dois lados têm razão, e essa é a lição: a mesma evidência leva a conclusões opostas quando ninguém definiu o que "explicar" significa. Se você não definiu, o seu fornecedor de dashboard definiu por você, e ele optou pelo que é mais bonito de renderizar.
A bifurcação: explicar a caixa-preta ou ler o vidro
Aqui o caminho se divide, e a decisão é de arquitetura, não de ferramenta.
Um caminho é continuar com a caixa-preta e ficar gerando explicações post-hoc por cima, sabendo que são aproximações. O outro, defendido com força por Rudin, é não ter caixa-preta onde a aposta é alta. Para decisões de alto risco, prefira modelos interpretáveis por design: um modelo aditivo, uma árvore esparsa, um conjunto de regras monotônicas. Você não explica esse modelo depois; você lê ele direto. A explicação não é uma camada que você gruda em cima, é o próprio modelo sendo legível.
O contraponto honesto, e ele existe, é o medo de perder acurácia. Rudin é direta nesse ponto: na experiência dela, em dados estruturados de alto risco, raramente existe esse trade-off de verdade. O modelo simples costuma empatar com a caixa-preta. O caso COMPAS, o score de reincidência criminal que a ProPublica esmiuçou em 2016, é o exemplo dela: um modelo proprietário e opaco que não era mais acurado que uma árvore de decisão com pouquíssimas variáveis, e que, por ser fechado, virou um pesadelo de auditar.
Com LLM, claro, você não vai trocar o transformer por uma árvore. Mas o princípio se transporta. Em vez de explicar as entranhas do modelo, você embrulha o LLM numa estrutura interpretável: saída estruturada com campos obrigatórios, regras determinísticas pras partes sensíveis, constraints que o modelo não pode violar, validação na borda. A parte que precisa ser explicável vira a casca de vidro ao redor do modelo, não o miolo dele. É a mesma lógica de quando você combina modelos grandes, pequenos e regras clássicas, sobre a qual já escrevi em Arquiteturas Híbridas: você coloca o determinismo onde a previsibilidade importa.
O que funciona de verdade em produção
Se autoexplicação mente e explicação post-hoc é aproximação, o que sobra? Sobra a parte que ninguém posta no Twitter porque não é glamourosa: engenharia.
A primeira peça é a trilha de decisão. Repara que ela é uma coisa diferente de explicar o modelo. Explicar o modelo é responder "como essa rede neural pensa". Reconstruir a decisão é responder "o que de fato entrou, qual versão do modelo rodou, qual contexto foi recuperado, qual score saiu, qual regra foi aplicada, qual foi o resultado". A segunda pergunta é respondível, auditável e verdadeira. A primeira, como vimos, é um chute. E a trilha só existe se você instrumentou desde o começo, que foi exatamente o ponto de Arquitetura de um Backend Pronto pra IA: logs ricos de interação não são luxo, são a matéria-prima da explicabilidade.
A segunda peça é a explicação contrafactual. Sandra Wachter, Brent Mittelstadt e Chris Russell propuseram isso em 2017 com uma sacada elegante: em vez de abrir a caixa-preta, descreva a menor mudança no input que mudaria o resultado. "Se sua renda declarada fosse 15% maior, o crédito teria sido aprovado." Isso é acionável pro usuário, não exige revelar a lógica interna nem ferir segredo comercial, e tem uma propriedade rara em explicabilidade: dá pra verificar se é verdade, rodando o modelo de novo com o input alterado.
A terceira peça é calibrar a explicação pra quem ouve. Tim Miller, num trabalho de 2019 na revista científica Artificial Intelligence, mostrou que explicação humana tem três propriedades que a gente costuma ignorar. Ela é contrastiva: as pessoas não querem saber "por que isto", querem "por que isto e não aquilo". Ela é seletiva: a gente escolhe uma ou duas causas relevantes, não despeja todas. E ela é social: é uma conversa, não um relatório. Despejar trinta pesos de feature na cara de um cliente não é explicar, é se proteger fingindo transparência.
Esse ponto tem dente regulatório, e não é teórico. O CFPB, o regulador de crédito americano, foi explícito em circulares de 2022 e 2023: usar um algoritmo complexo não isenta ninguém de dar o motivo específico e preciso de uma negativa. E deu o exemplo perfeito da desculpa bonita: se a recusa foi pela profissão do solicitante, dizer "renda insuficiente" não cumpre a lei. A explicação tem que ser a verdadeira, não a mais apresentável. A lei, nesse caso, está literalmente proibindo a desculpa bonita.
Por fim, documentação de escopo. Model Cards, proposta por Margaret Mitchell, Timnit Gebru e colegas na FAccT de 2019, é o padrão: pra que o modelo serve, pra que ele não serve, como performa quebrado por grupo. Boa parte das "explicações" que viram crise são, na verdade, uso do modelo num contexto pra qual ele nunca foi validado. A explicação honesta, aí, é "esse modelo não deveria estar decidindo isso", e ela precisa estar escrita antes do incidente.
A fronteira: abrir o modelo de verdade
Tem um esforço sério de abrir a caixa-preta de verdade, não por aproximação. Chama-se interpretabilidade mecanicista, e o time do Chris Olah na Anthropic é a referência. Em 2024, no trabalho "Scaling Monosemanticity", eles treinaram sparse autoencoders sobre as ativações do Claude 3 Sonnet e extraíram milhões de features interpretáveis de dentro de um modelo de produção. Features multilíngues e multimodais: a feature da Golden Gate Bridge dispara em inglês, japonês, em texto e em imagem. E dá pra manipular: amplificando essa feature, eles criaram o "Golden Gate Claude", que enfiava a ponte em qualquer conversa.
Isso é fascinante e é a direção certa. Mas seja honesto sobre a maturidade: é pesquisa de fronteira, cobre uma fração das features, e não está pronto pra responder "por que esse cliente específico foi negado" em produção amanhã de manhã. Vale acompanhar, não vale prometer pro jurídico.
Brasil, bolsa e o que a lei realmente exige
Tem um mito confortável de que a lei brasileira obriga uma explicação humana detalhada de toda decisão automatizada. Vale ler o que o Artigo 20 da LGPD diz de fato, porque a história é mais interessante. A redação original previa revisão das decisões automatizadas por pessoa natural. Esse trecho foi removido pela MP 869 de 2018, convertida na Lei 13.853 de 2019. Na prática, a lei garante o direito de pedir revisão, mas não garante que ela seja feita por um humano; pode, em tese, ser outra máquina. Já tratei do lado de proteção de dado disso em Segurança e Compliance em Produtos com IA; aqui o ângulo é outro.
E essa fraqueza da lei é justamente o argumento. Se o piso regulatório é baixo, explicabilidade de verdade deixa de ser só compliance e vira diferencial. Lá fora, o caso Apple Card de 2019 mostrou isso na marra: a investigação do regulador de Nova York, concluída em 2021, não encontrou discriminação de gênero comprovada. Mesmo assim, o relatório foi duro ao dizer que a percepção de falta de transparência minou a confiança do consumidor. Repara: sem viés provado, a inexplicabilidade sozinha já gerou crise reputacional e pressão regulatória. Não dá pra explicar o limite de crédito custou caro, mesmo quando o limite estava tecnicamente correto.
Quem vem de mercado regulado entende isso no osso. Em bolsa, em pagamentos, em risco, a trilha de auditoria não é peso morto que se carrega pra agradar fiscal; é parte do produto. Reconstruir o que aconteceu, em que ordem e com base em quê não é favor que a engenharia faz, é requisito de existir. O mundo de IA está redescobrindo, com dez anos de atraso, uma disciplina que o setor financeiro já tinha: o framework de model risk do SR 11-7, do Fed americano, exige inventário de modelos, validação independente e governança de ciclo de vida desde 2011. Não é tecnologia nova. É higiene antiga aplicada a um brinquedo novo.
Conclusão
Explicabilidade não é gerar a narrativa mais convincente sobre por que o modelo decidiu. É a disciplina de só dizer o que você consegue sustentar como verdade. Isso muda o trabalho de lugar: sai da camada de apresentação, onde mora a desculpa bonita, e vai pra camada de engenharia, onde mora a trilha de decisão, o contrafactual verificável, o modelo interpretável por design e a documentação de escopo.
Já escrevi sobre quem assina embaixo quando a IA erra, em Governança de Modelos. Governança responde "quem responde". Explicabilidade responde uma pergunta diferente e mais incômoda: o que você consegue dizer de verdade sobre o porquê. Sem a segunda, a primeira assina embaixo de uma história que ninguém checou.
A pergunta honesta que protege o time: se um cliente, um diretor e um regulador perguntarem, no mesmo dia, por que o modelo decidiu aquilo, você tem uma resposta que é verdadeira, ou só uma que é bonita? Se você hesitou, o problema não é o modelo. É que a explicabilidade virou departamento de marketing da decisão, e isso, mais cedo ou mais tarde, cobra a conta.
Insights & Takeaways
-
Separe plausibilidade de fidelidade. Plausível é o quanto a explicação convence; fiel é o quanto ela corresponde ao que o modelo fez. A desculpa bonita é a explicação muito convincente e pouco fiel, e é pra esse canto que tudo desliza por gravidade se você não tiver processo.
-
Pedir pro modelo explicar o próprio raciocínio não é auditoria, é geração de texto. A Anthropic mostrou em 2025 que, sob reward hacking, o modelo usava o atalho em mais de 99% das vezes e admitia em menos de 2%, inventando justificativas plausíveis pro resto.
-
Explicação post-hoc de caixa-preta é aproximação, não verdade. Como Cynthia Rudin argumentou, uma explicação 100% fiel ao modelo seria o próprio modelo. Onde a aposta é alta, prefira interpretável por design a explicável depois.
-
A explicabilidade que sobrevive a auditoria é engenharia, não dashboard: trilha de decisão reconstruível, contrafactual verificável e explicação calibrada pra quem ouve, que Tim Miller mostrou ser contrastiva, seletiva e social.
-
A LGPD não garante revisão humana de decisão automatizada desde que o trecho caiu em 2019. Isso transforma explicabilidade de verdade em diferencial, não só compliance. O caso Apple Card provou que inexplicabilidade gera crise mesmo sem viés comprovado.