IA First · Episódio 9
RAG Sem Romance: Como Fazer Busca + Contexto Que Não Vira Máquina de Alucinação
RAG em produção sem misticismo: quando não usar, extração, chunking, busca híbrida com threshold, montagem de contexto, invalidação do índice e métricas.
Neste artigo · 14 seções
- O problema com RAG na vida real
- O que RAG realmente é, sem misticismo
- Antes de montar RAG: você realmente precisa disso?
- Indexação: onde tudo começa (e onde tudo pode dar errado)
- Chunking: a decisão mais importante que ninguém discute o suficiente
- Busca: embedding não é a única ferramenta
- Montagem de contexto: a ponte entre busca e geração
- Quando RAG alucina (e como reduzir isso)
- Versionamento e invalidação: o que ninguém planejou
- Observabilidade: como saber se RAG está funcionando
- O pipeline completo: do documento à resposta
- O que erra mais em produção: uma lista honesta
- Conclusão
- Insights & Takeaways
O problema com RAG na vida real
RAG virou a resposta padrão pra qualquer pergunta sobre IA em produto. "Como faço o modelo responder com dados da empresa?" RAG. "Como evito alucinação?" RAG. "Como deixo o chatbot mais inteligente?" RAG. A palavra aparece em toda reunião de produto como se fosse um encantamento que resolve qualquer coisa.
Aí o time implementa. Joga uns PDFs num índice vetorial, conecta no LLM, e na demo funciona. A pergunta certa com o documento certo retorna a resposta certa. Todo mundo bate palma. Vai pra produção e o cenário muda: a busca retorna trechos irrelevantes, o modelo mistura informação de documentos diferentes, a resposta cita um dado que não existe em lugar nenhum, e o usuário perde a confiança em duas tentativas.
O problema não é RAG como conceito. O conceito é sólido: em vez de depender só do conhecimento que o modelo absorveu no treinamento, você busca informação relevante numa base de dados e injeta no contexto antes de gerar a resposta. Simples. O problema é que entre o conceito e uma implementação que funciona em produção existe um abismo de decisões de engenharia que quase ninguém discute.
Esse artigo é sobre essas decisões. Não é uma introdução a RAG. É um guia de engenharia pra quem vai construir (ou já construiu e está sofrendo) um pipeline de busca + contexto que precisa ser confiável, observável e operável.
O que RAG realmente é, sem misticismo
Vamos ser didáticos. RAG é um padrão de arquitetura com três etapas:
Só isso. Busca, monta contexto, gera. Não é mágica, não é um produto, não é um framework. É um padrão. E como todo padrão, o diabo está nos detalhes de cada etapa.
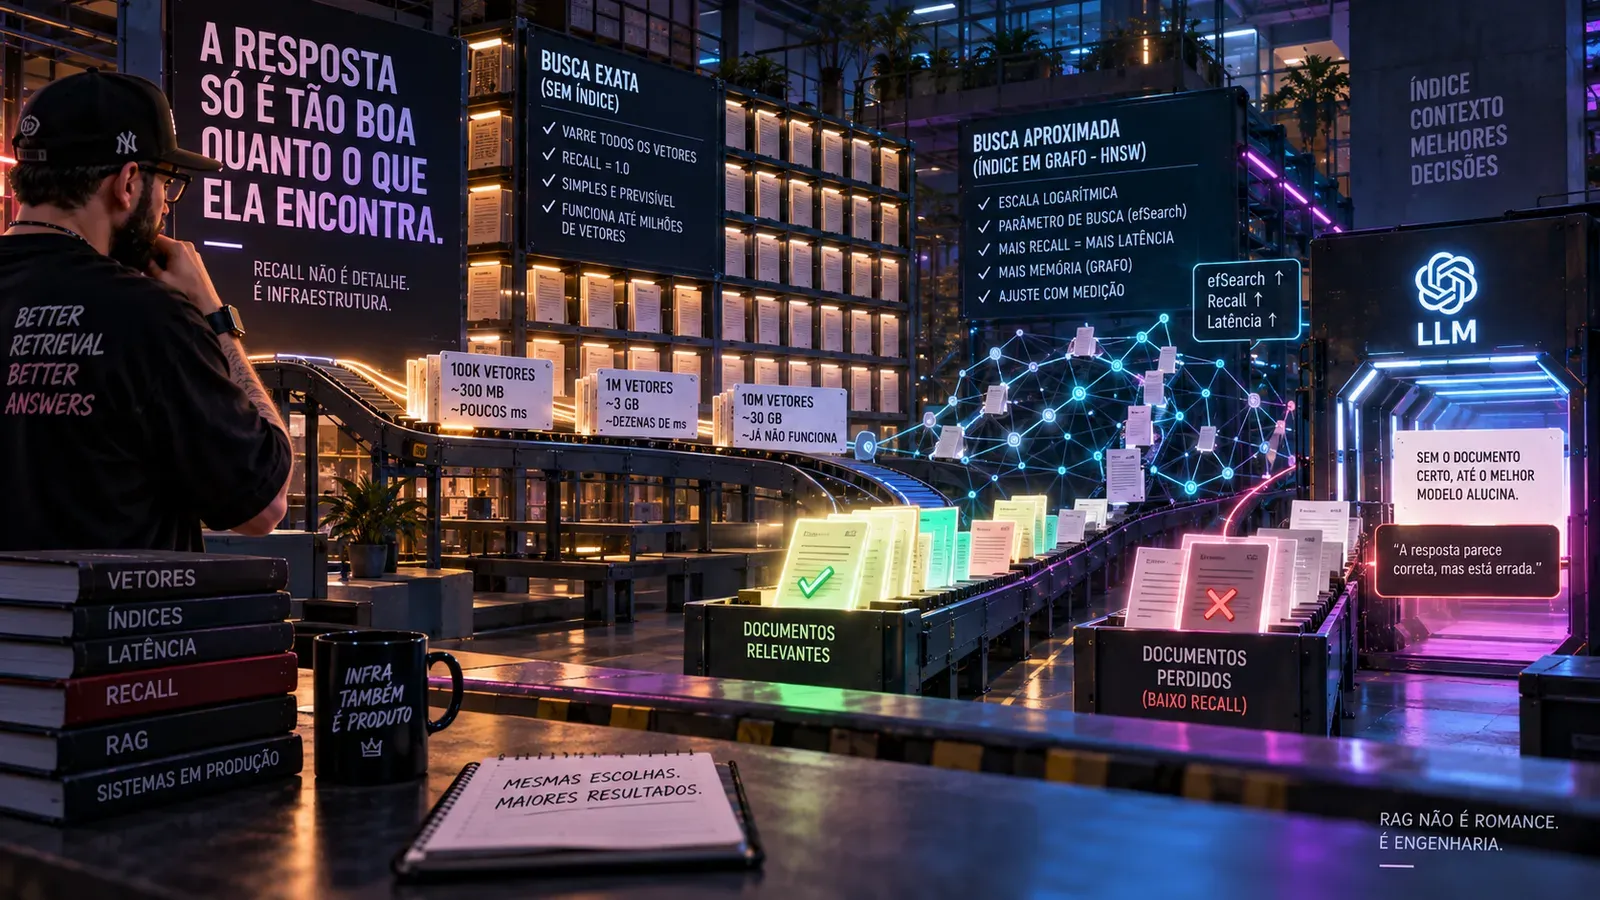
A etapa de Retrieval é onde a maioria dos problemas começa. Se a busca retorna lixo, o modelo vai gerar uma resposta eloquente baseada em lixo. "Garbage in, garbage out" continua valendo, só que agora o garbage vem embrulhado num texto bonito e convincente. Isso é pior do que um erro óbvio, porque o usuário não percebe.
A etapa de Augmentation é onde a maioria dos problemas se esconde. Como você monta o contexto? Quantos trechos inclui? Em que ordem? O que faz quando os trechos se contradizem? O que faz quando nenhum trecho é relevante o suficiente? Essas decisões definem a qualidade da resposta tanto quanto o modelo escolhido.
A etapa de Generation é onde a maioria dos times gasta 90% do tempo. Ajustando prompt, testando modelos, comparando temperaturas. Sendo que o impacto real está nas duas etapas anteriores.
Antes de montar RAG: você realmente precisa disso?
Pergunta honesta que pouca gente faz antes de começar. Nem todo problema que parece RAG é RAG.
Se a informação que o usuário precisa está estruturada num banco relacional, com campos bem definidos e queries previsíveis, um bom SELECT com um template de resposta resolve. Sério. "Qual o status do meu pedido?" não precisa de embedding search + LLM. Precisa de SELECT status FROM orders WHERE id = ? e uma frase formatada.
Se a informação é semi-estruturada mas o domínio de perguntas é pequeno e previsível, um sistema de regras com busca full-text (Elasticsearch, por exemplo) pode funcionar melhor, mais rápido e mais barato do que um pipeline de RAG.
RAG faz sentido quando: a base de conhecimento é grande e não-estruturada (documentos, manuais, contratos, artigos); as perguntas dos usuários são variadas e não-previsíveis; a resposta precisa sintetizar informação de múltiplas fontes; e o formato da resposta precisa ser flexível, em linguagem natural.
Se o seu caso não atende a maioria desses critérios, pense duas vezes antes de montar a infraestrutura toda. Um endpoint REST com busca textual e formatação de resposta pode ser 95% tão bom por 10% do custo e da complexidade.
Indexação: onde tudo começa (e onde tudo pode dar errado)
Indexar é o processo de transformar seus documentos em algo buscável. Em RAG, isso geralmente significa gerar embeddings (representações vetoriais) dos trechos de texto e armazená-los num banco vetorial.
O pipeline de indexação completo se parece com isso:
Cada etapa tem armadilhas.
Extração de texto parece trivial até você encontrar um PDF com tabelas, um documento escaneado com OCR ruim, um HTML cheio de boilerplate, ou um DOCX com headers e footers repetidos em toda página. Se a extração é ruim, o embedding vai representar lixo. E o modelo vai receber lixo como contexto. Investir tempo na qualidade da extração é provavelmente o melhor ROI do pipeline inteiro.
Limpeza e normalização é tirar o que não agrega: cabeçalhos repetidos, numeração de página, disclaimers legais que aparecem em todo documento, espaços duplos, caracteres especiais quebrados. Parece trivial, mas um chunk que começa com "Página 47 de 132 - Confidencial - Uso Interno" vai poluir o embedding e confundir a busca.
Metadados são tão importantes quanto o texto. De qual documento veio esse chunk? Qual a data de publicação? Qual a versão? Qual o departamento? Qual o tipo de documento? Esses metadados permitem filtrar a busca antes de comparar embeddings, o que melhora muito a precisão e reduz custo. Se o usuário pergunta sobre a "política de férias de 2025", você pode filtrar por tipo=política e ano=2025 antes de fazer a busca semântica. Sem metadados, a busca semântica sozinha pode trazer a política de 2023 porque o texto é parecido.
Chunking: a decisão mais importante que ninguém discute o suficiente
Chunking é como você divide um documento em pedaços menores pra indexar. Parece uma decisão técnica menor. Não é. A estratégia de chunking define a granularidade da sua busca e, por consequência, a qualidade do contexto que o modelo recebe.
Chunks grandes (2.000+ tokens) capturam mais contexto por trecho, mas a busca fica menos precisa. Se o usuário pergunta algo específico, o chunk retornado pode ter a resposta enterrada no meio de um monte de texto irrelevante. Isso gasta tokens do context window com informação que não ajuda.
Chunks pequenos (100-200 tokens) são mais precisos na busca, mas perdem contexto. Um parágrafo sozinho pode não fazer sentido sem o anterior. O modelo recebe trechos desconectados e tenta montar uma resposta coerente a partir de fragmentos.
Não existe tamanho mágico. Mas existe uma heurística que funciona na maioria dos casos: chunks de 500 a 800 tokens com overlap de 10-15% entre chunks consecutivos. O overlap garante que informação que está na fronteira entre dois chunks não se perde.
Mas mais importante que o tamanho é a estratégia de divisão. Dividir por número fixo de caracteres é a abordagem mais simples e a pior. Você vai cortar frases no meio, separar uma pergunta da sua resposta, dividir uma tabela em pedaços sem sentido.
Dividir por estrutura do documento é melhor. Respeitar parágrafos, seções, headers. Se o documento tem seções claras (e a maioria tem), cada seção vira um ou mais chunks. Se uma seção é muito grande, subdivide por parágrafos mantendo o header da seção como prefixo de cada chunk. Isso preserva contexto.
Dividir por semântica é o mais sofisticado. Você usa o próprio modelo de embedding pra detectar mudanças de assunto e dividir nos pontos de transição. Funciona bem, mas adiciona complexidade e custo no pipeline de indexação.
Uma técnica que faz diferença e que muita gente ignora: adicionar contexto hierárquico ao chunk. Cada chunk não guarda só o texto do trecho; guarda também o título do documento, o título da seção e, se possível, um resumo do documento. Assim, quando o chunk é recuperado, o modelo tem contexto suficiente pra entender de onde aquele trecho veio.
Na prática:
Chunk ruim:
"O prazo é de 30 dias corridos a partir da data de aprovação."

Chunk bom:
"[Documento: Política de Reembolso v3.2 | Seção: Prazos e Condições]
O prazo é de 30 dias corridos a partir da data de aprovação.
O colaborador deve submeter os comprovantes pelo sistema até 5 dias
antes do vencimento do prazo."
O segundo chunk é buscável, contextualizável e rastreável. O primeiro é uma frase solta que pode significar qualquer coisa.
Busca: embedding não é a única ferramenta
Tem uma tendência de tratar busca vetorial como a única forma de retrieval em RAG. Embedding search é poderosa, mas não é perfeita, e em vários cenários não é nem a melhor opção.
Busca por embedding funciona bem quando a pergunta do usuário é semanticamente próxima do texto que contém a resposta, mesmo que as palavras sejam diferentes. "Como peço reembolso?" vai encontrar um chunk sobre "procedimento de restituição de despesas" porque o embedding captura o significado, não as palavras exatas.
Busca por embedding funciona mal quando a pergunta envolve termos técnicos específicos, códigos, números, nomes próprios ou identificadores. "Qual o limite do plano XPT-400?" vai ter dificuldade porque "XPT-400" é um token raro que o modelo de embedding provavelmente não representa bem. Aqui, uma busca keyword (BM25, full-text) que procura a string exata funciona melhor.
A solução que mais entrega resultado na prática é busca híbrida: combina embedding search com keyword search e faz um merge dos resultados. Isso é chamado de hybrid retrieval ou hybrid search, e a maioria dos bancos vetoriais modernos (Weaviate, Qdrant, Pinecone, Elasticsearch com knn) já suporta nativamente.
O Reciprocal Rank Fusion (RRF) é uma técnica simples pra combinar rankings de fontes diferentes: pega a posição de cada resultado em cada lista, aplica uma fórmula de fusão, e reordena. Funciona surpreendentemente bem sem precisar de tuning pesado.
E tem um detalhe que muita gente pula: o threshold de relevância. Nem toda busca retorna resultados bons. Se o melhor chunk tem um score de similaridade de 0.3 (numa escala de 0 a 1), provavelmente não é relevante. Definir um threshold mínimo e retornar "não encontrei informação suficiente pra responder" é infinitamente melhor do que mandar contexto ruim pro modelo e deixar ele inventar.
Montagem de contexto: a ponte entre busca e geração
Você buscou, rankeou, filtrou, e agora tem, digamos, 5 chunks relevantes. Como monta o contexto pro modelo?
A forma ingênua é concatenar tudo e mandar. Funciona em demos. Em produção, causa problemas.
Primeiro, ordem importa. Modelos de linguagem tendem a dar mais peso pra informação que aparece no início e no final do contexto (isso é estudado e se chama "lost in the middle" effect). Se o chunk mais relevante está no meio de 5 outros, o modelo pode ignorá-lo parcialmente. Colocar os chunks mais relevantes primeiro (e possivelmente repetir o mais relevante no final) melhora a qualidade da resposta.
Segundo, contradições precisam ser tratadas. Se dois chunks dizem coisas diferentes (por exemplo, versões diferentes do mesmo documento), o modelo vai escolher um ou, pior, misturar os dois numa resposta inconsistente. O Context Assembler (que falamos no artigo anterior sobre arquitetura de backend) deveria detectar isso e, no mínimo, sinalizar pro modelo que existem informações conflitantes. Melhor ainda: filtrar pela versão mais recente antes de montar o contexto.
Terceiro, budget de tokens. Cada chunk consome tokens. Se você manda contexto demais, gasta dinheiro e pode estourar a context window. Se manda de menos, a resposta fica incompleta. A heurística é reservar entre 60-70% da context window pro contexto e o restante pra instrução do sistema, histórico da conversa e espaço de geração. Mas isso varia por caso de uso.
Um padrão que funciona bem em produção é montar o contexto como um documento estruturado com marcadores de fonte:
[Fonte: Política de Reembolso v3.2 | Seção: Prazos | Relevância: 0.91]
O prazo é de 30 dias corridos a partir da data de aprovação.

[Fonte: FAQ RH - Atualizado em 2025-11 | Relevância: 0.87]
Reembolsos acima de R$500 requerem aprovação do gestor direto.

[Fonte: Regulamento Interno v2.1 | Seção: Despesas | Relevância: 0.72]
Despesas com transporte podem ser reembolsadas mediante apresentação de nota fiscal.
Quando o modelo recebe isso, ele sabe de onde veio cada informação, pode citar a fonte na resposta, e o time de engenharia pode rastrear qual chunk influenciou qual parte da resposta. Sem esses marcadores, a rastreabilidade morre.
Quando RAG alucina (e como reduzir isso)
Vamos ser diretos. RAG reduz alucinação comparado com geração pura. Não elimina. E em alguns cenários, pode até criar novos tipos de alucinação.
Alucinação por contexto irrelevante é a mais comum. A busca retorna chunks que são vagamente relacionados mas não contêm a resposta. O modelo, como foi treinado pra ser útil, tenta responder mesmo assim, e inventa. A mitigação é ter threshold de relevância e instruir o modelo explicitamente no prompt: "Se os documentos fornecidos não contêm informação suficiente para responder, diga que não encontrou a informação. Não invente."
Alucinação por síntese incorreta acontece quando o modelo combina informações de chunks diferentes de uma forma que nenhum chunk individual afirma. Chunk A diz "o prazo é 30 dias". Chunk B diz "pedidos acima de R$500 requerem aprovação". O modelo responde "pedidos acima de R$500 têm prazo de 30 dias após aprovação". Parece coerente, mas nenhum documento diz isso, essa relação foi inventada pelo modelo. A mitigação é instruir o modelo a responder com base em cada fonte separadamente e não sintetizar entre fontes quando a relação não é explícita.
Alucinação por confiança excessiva é quando o modelo responde com total convicção baseado em um único chunk de relevância mediana. Ele não sinaliza incerteza. A mitigação é incluir o score de relevância no prompt e instruir o modelo a modular a confiança da resposta: "Se a relevância dos documentos é abaixo de 0.8, indique que a resposta pode estar incompleta."
Nenhuma dessas mitigações é perfeita. A abordagem mais robusta combina todas elas com um passo de validação pós-geração: verificar se as afirmações da resposta são rastreáveis a chunks específicos. Isso pode ser feito com uma segunda chamada ao modelo ("verifique se cada afirmação da resposta está suportada pelos documentos fornecidos") ou com regras mais simples (checar se nomes, números e datas da resposta existem nos chunks). Custa mais tokens, mas em domínios sensíveis, o custo da alucinação é maior.
Versionamento e invalidação: o que ninguém planejou
Todo mundo planeja a indexação. Quase ninguém planeja a atualização.
Documentos mudam. Políticas são revisadas. Manuais ganham novas versões. Produtos são descontinuados. Se o seu índice tem a versão antiga e o usuário pergunta sobre a política atual, RAG vai retornar com convicção a informação desatualizada. Isso é pior do que não responder, porque o usuário confia que a resposta é baseada em documentos reais.
O pipeline de indexação precisa ter um caminho de atualização tão bem definido quanto o de criação. Concretamente, isso significa:
Cada documento no índice precisa de um ID estável e uma versão. Quando um documento é atualizado, os chunks da versão anterior são invalidados (marcados como inativos ou deletados) e os novos chunks são indexados. Não é append-only; é replace.
Invalidação por expiração. Alguns documentos têm validade. Uma promoção que termina em março, uma política temporária, um comunicado com data de vigência. O índice precisa saber que esses chunks expiram e parar de retorná-los após a data.
Re-indexação sob demanda. Quando o modelo de embedding muda (e ele vai mudar, porque versões melhores saem o tempo todo), todos os chunks precisam ser re-embedados. Se você tem 100 mil chunks, isso leva tempo e custa dinheiro. Planejar isso antes é melhor do que descobrir na hora.
Lineage é o que amarra tudo. Cada chunk precisa saber de onde veio: documento original, versão, data de indexação, modelo de embedding usado. Sem lineage, você não tem como responder "essa resposta foi gerada com base em informação atualizada?" E essa é uma pergunta que vai aparecer.
Observabilidade: como saber se RAG está funcionando
RAG sem observabilidade é um sistema que você opera no escuro. E o escuro aqui é particularmente perigoso porque o sistema pode estar retornando respostas erradas com total convicção, sem nenhum erro técnico nos logs.
As métricas que importam pra RAG se dividem em retrieval e generation.
Pra retrieval: quantos chunks foram retornados por query, em média? Qual o score médio de relevância dos chunks retornados? Qual a taxa de queries com zero chunks acima do threshold (ou seja, a busca não encontrou nada relevante)? Qual a taxa de queries onde o chunk correto estava na base mas não foi retornado (retrieval miss)? Essa última é difícil de medir automaticamente mas pode ser amostrada com revisão humana periódica.
Pra generation: taxa de respostas "não encontrei informação suficiente" (se está alta demais, a base está incompleta ou o threshold está restritivo demais; se está baixa demais, o modelo provavelmente está inventando). Taxa de citação correta (a resposta cita a fonte, e a afirmação realmente está na fonte?). Feedback do usuário (aceitou, rejeitou, corrigiu).
Um dashboard mínimo viável pra RAG mostraria: volume de queries por dia, distribuição de scores de relevância, taxa de "não sei" vs. respostas geradas, latência do pipeline completo (busca + montagem + geração, separadamente), custo por query (tokens de contexto + tokens de geração), e top queries sem resultado relevante.
Essa última métrica, as queries que não retornam nada bom, é ouro. Ela te diz exatamente quais documentos estão faltando na base, quais perguntas os usuários fazem que você não previu, e onde o gap de conteúdo está. É o melhor feedback pra priorizar o que indexar a seguir.
O pipeline completo: do documento à resposta
Juntando tudo, o pipeline de RAG em produção se parece com isso:
Tem muita coisa ali. Mas repara que a complexidade não está no modelo. Está na infraestrutura ao redor: extração, chunking, busca, montagem, validação, observabilidade. O modelo é uma chamada HTTP. Todo o resto é engenharia.
O que erra mais em produção: uma lista honesta
Depois de ver implementações de RAG funcionando (e não funcionando) em produção, os problemas mais frequentes seguem um padrão:
Extração de texto ruim é o problema número um. Parece o menos glamoroso, mas é o que mais impacta. PDFs mal parseados, tabelas que viram texto corrido sem sentido, OCR que troca números. Se a extração está ruim, nenhuma otimização de embedding ou prompt vai salvar.
Chunks sem contexto é o segundo. Trechos soltos que fazem sentido pra quem leu o documento inteiro, mas são ambíguos isoladamente. "O valor é de R$1.500" sem saber de qual produto, de qual plano, de qual ano.
Ausência de threshold é o terceiro. O sistema sempre retorna algo, mesmo que o melhor resultado tenha similaridade de 0.3. O modelo recebe contexto ruim e inventa uma resposta plausível. O usuário não sabe que a resposta foi fabricada a partir de nada relevante.
Índice desatualizado é o quarto. Documentos novos que nunca foram indexados, versões antigas que nunca foram invalidadas. O sistema responde com confiança baseado em informação que não é mais válida.
Sem observabilidade é o quinto. Ninguém sabe qual a taxa de acerto, quais queries estão falhando, quanto está custando. O time assume que está funcionando porque ninguém reclamou. Até que alguém reclama.
Conclusão
RAG é um padrão de engenharia, não uma feature que você liga e esquece. A busca precisa ser boa. O chunking precisa preservar contexto. O índice precisa estar atualizado. O threshold precisa existir. O contexto precisa ser montado com marcadores de fonte. A resposta precisa ser validada. E tudo isso precisa ser observável.
A parte mais contraintuitiva de RAG é que a qualidade da resposta depende muito mais da qualidade da busca do que do modelo de geração. Se a busca retorna os chunks certos, um modelo mediano gera uma resposta boa. Se a busca retorna lixo, o melhor modelo do mundo gera uma resposta eloquente e errada.
Gaste 70% do esforço no pipeline de retrieval. Os outros 30% no prompt e na geração. E não esqueça: às vezes um bom SELECT resolve e RAG é overkill. Saber quando não usar é tão valioso quanto saber usar bem.
Insights & Takeaways
-
Antes de montar RAG, valide se o problema realmente precisa disso. Se as queries são previsíveis e os dados são estruturados, busca textual com template de resposta pode resolver por uma fração do custo e da complexidade.
-
Chunking é a decisão mais subestimada do pipeline. Chunks sem contexto hierárquico (título do documento, seção, versão) geram respostas ambíguas. Cada chunk deveria fazer sentido lido isoladamente.
-
Busca híbrida (vetorial + keyword) com threshold de relevância é o setup que mais entrega resultado. Busca vetorial sozinha falha com termos técnicos, códigos e identificadores. Sem threshold, o modelo recebe contexto ruim e alucina com confiança.
-
Versionamento e invalidação de índice são tão importantes quanto a indexação inicial. Documento desatualizado no índice gera resposta errada com total convicção, que é o pior cenário possível.
-
Gaste 70% do esforço no retrieval, 30% na geração. A qualidade da busca determina a qualidade da resposta mais do que a escolha do modelo.