IA de Alta Performance · Episódio 18
Todo Mundo Mede o LLM e Ninguem Mede o Embedding
O embedding é latência na consulta e throughput na ingestão. Padding, cache por hash, dimensão do vetor e lote por tokens para cortar custo e p99 no RAG.
Neste artigo · 8 seções
Pegue o painel de latência do seu RAG e procure a linha do embedding. Provavelmente não existe.
Tem tempo de resposta do LLM, tem contagem de tokens, tem custo por requisição, às vezes tem tempo de busca no índice. O passo que transforma a pergunta do usuário em vetor, e que acontece antes de tudo isso, costuma estar dentro de um bloco genérico chamado "recuperação" ou, pior, embutido no total sem nome próprio.
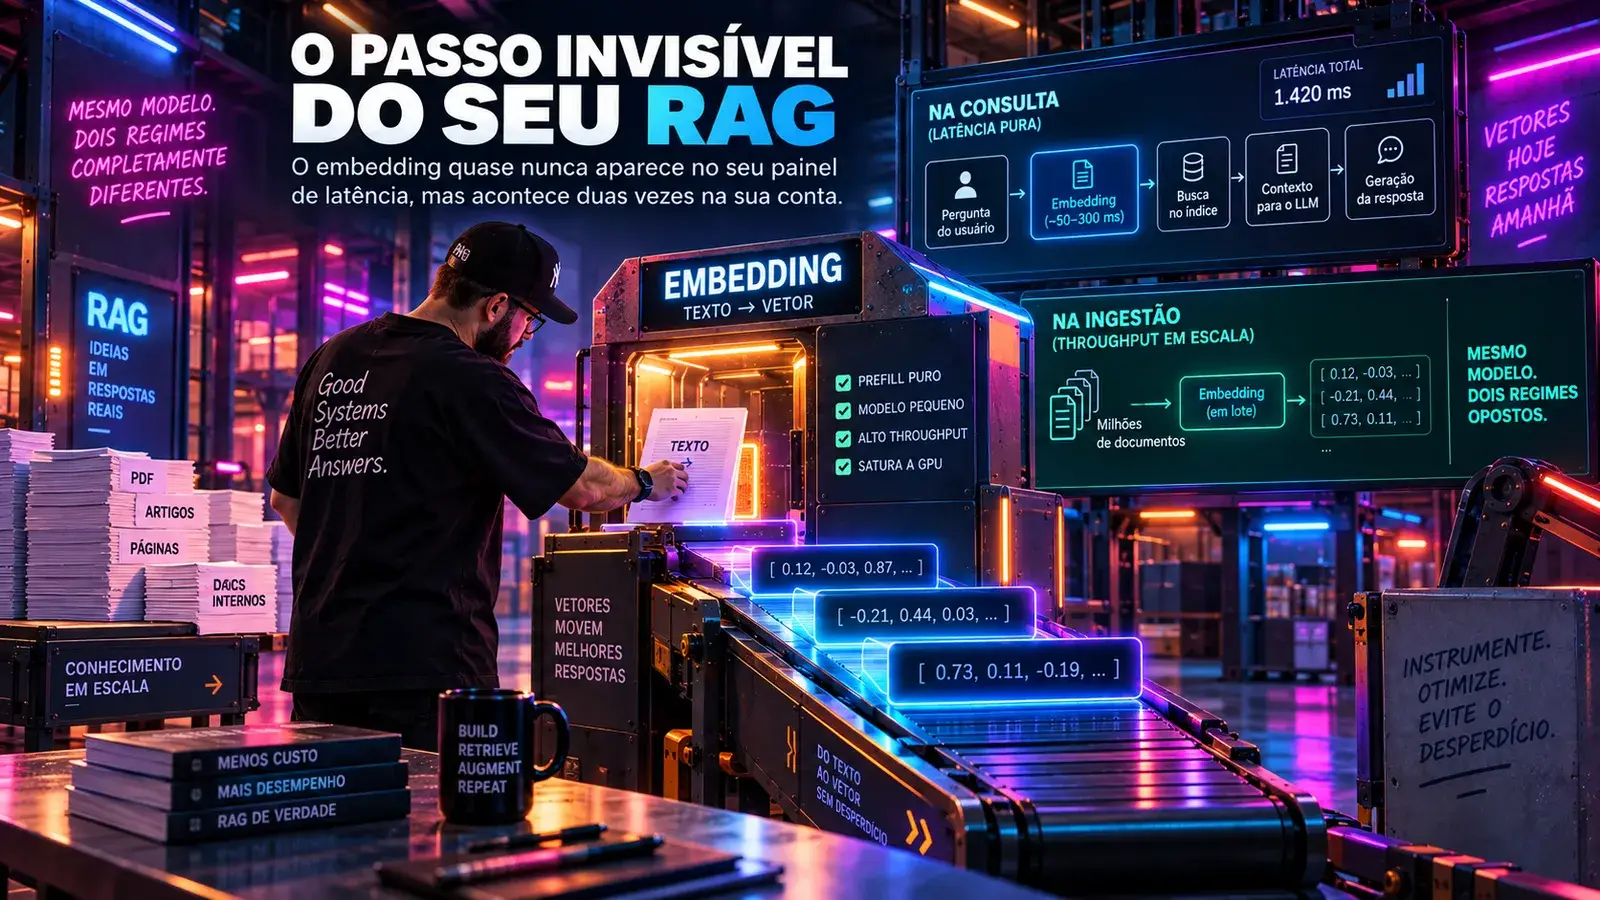
É um passo pequeno, e é justamente por isso que ele escapa. Só que ele aparece duas vezes na sua conta, em regimes completamente diferentes: uma vez por consulta, no caminho crítico, e uma vez por documento, na ingestão, multiplicado por milhões. O artigo anterior tratou da busca; este trata do que precisa acontecer antes de qualquer busca existir.
dois problemas com o mesmo nome
Vale separar as duas metades logo no começo, porque otimizar uma com a régua da outra é o erro mais comum aqui.
Na consulta, você tem um texto curto, uma pessoa esperando, e o embedding está no caminho crítico. Nada acontece antes dele: não dá para buscar sem vetor, não dá para montar contexto sem busca, não dá para gerar sem contexto. É um problema de latência pura, com lote de tamanho um.
Na ingestão, você tem milhões de trechos, ninguém esperando, e o objetivo é atravessar o acervo gastando o mínimo. É um problema de throughput, com o lote sendo a variável mais importante do sistema.
Um mesmo modelo, dois regimes opostos. Quem esta série vem acompanhando reconhece o padrão: é a mesma divisão entre a leitura do prompt e a geração da resposta que apareceu lá no terceiro artigo, com os mesmos gargalos e as mesmas saídas.
o embedding é prefill puro, e isso é uma boa notícia
Um encoder de embedding processa o texto inteiro numa passagem e devolve um vetor. Não tem geração token a token, não tem KV cache crescendo, não tem decode.
Ou seja: é prefill do começo ao fim, e prefill é trabalho denso de cálculo. Enquanto a geração de texto deixa a GPU com uma fração ridícula do poder computacional em uso, o embedding em lote é uma das poucas cargas de IA que realmente satura o silício.
Duas consequências práticas saem disso.
A primeira é que lote grande funciona de verdade aqui, sem o drama de memória do KV cache. Dobrar o lote quase dobra o throughput até o ponto em que a placa satura, e a saturação chega bem mais cedo que na geração.
A segunda é que o modelo é pequeno. Um encoder de embedding típico tem algumas centenas de milhões de parâmetros, ordens de grandeza abaixo do modelo de linguagem que vai gerar a resposta. Ele cabe na memória de placas modestas, roda em CPU sem constrangimento, e aceita quantização com folga.
Junte as duas e você chega numa conclusão que contraria a arquitetura padrão de muito projeto: embedding é o candidato mais óbvio a rodar dentro da sua infraestrutura, e não como chamada para uma API externa. A consulta é curta, o modelo é pequeno, e a conta em si custa menos que a viagem de rede até o fornecedor.
o desperdício invisível: padding
Este é o detalhe que decide o custo da ingestão e que quase ninguém instrumenta.
Uma GPU processa o lote como um retângulo. Se você juntar 32 textos de comprimentos variados numa mesma passagem, todos são preenchidos até o comprimento do maior, com tokens de enchimento que não significam nada. O trabalho é feito sobre o retângulo inteiro, incluindo o vazio.
Monte o lote com um texto de 500 tokens e 31 textos de 30 tokens e faça a conta: você paga por 32 vezes 500 e aproveita menos de um décimo disso. O restante é a placa calculando o nada com toda a eficiência do mundo.
A correção é banal e o ganho é enorme: ordenar os textos por comprimento antes de formar os lotes, de modo que cada lote junte tamanhos parecidos. O desperdício de um lote é a diferença entre o comprimento médio e o comprimento máximo dele, então lotes homogêneos aproximam esse desperdício de zero.
Vale ainda dimensionar o lote por tokens, não por documentos. Trinta e dois documentos podem ser 1.000 tokens ou 16.000, e é o número de tokens que determina se a passagem cabe na memória e quanto tempo leva. Servidores de inferência maduros trabalham assim há tempos; pipelines de ingestão feitos em casa quase sempre contam documentos.
reprocessar o que não mudou
O segundo desperdício é conceitual, e ele custa mais caro que o padding.
Um trecho de documento é imutável. O modelo de embedding, numa versão fixa, é uma função determinística. Logo, o vetor daquele trecho é imutável também, e recalculá-lo é queimar dinheiro com o mesmo resultado, exatamente o argumento de cache que abriu esta temporada, aplicado ao outro lado do pipeline.
Na prática, a chave de cache é o resumo criptográfico do texto normalizado somado ao identificador e à versão do modelo. Com ela, uma reindexação depois de uma mudança na regra de fatiamento só paga pelos trechos que realmente mudaram, e um documento reenviado sem alteração custa uma consulta de tabela em vez de uma passagem de GPU.
Sem essa chave, o roteiro é o que se vê em campo: alguém ajusta o tamanho do fatiamento, dispara a reindexação, e o acervo inteiro passa pela GPU de novo para produzir, na maior parte, vetores idênticos aos que já existiam.
Existe um caso em que reprocessar tudo é inevitável, e é bom saber disso na hora de desenhar. Trocar o modelo de embedding invalida o índice inteiro, porque vetores de modelos diferentes não são comparáveis. Não é uma migração incremental, é uma reconstrução, e ela precisa de índice versionado, escrita dupla durante a transição e uma janela de retorno. Quem não planejou isso descobre no dia em que quer atualizar o modelo e percebe que a atualização é um projeto.
dimensão é custo em três lugares
O tamanho do vetor parece detalhe de configuração e é uma decisão de arquitetura, porque a dimensão aparece na memória do índice, na conta de cada comparação e na banda consumida durante a busca.
Cair de 1536 para 768 dimensões corta pela metade os três. Numa base de dez milhões de vetores, isso é a diferença entre caber ou não caber na máquina que você provisionou.
A pergunta óbvia é quanto de qualidade isso custa, e a resposta depende de como o modelo foi treinado. Modelos treinados com representação aninhada permitem truncar o vetor e continuar usável, porque as primeiras dimensões concentram a informação mais grossa e as últimas refinam. Truncar um modelo que não foi treinado assim degrada de forma imprevisível.
Vale medir com a mesma régua do artigo anterior: pegue o conjunto de consultas de referência, calcule o recall com a dimensão cheia e com a truncada, e decida com o número na mão. É barato de fazer e costuma render corte de memória sem perda perceptível.
Um detalhe pequeno que fecha essa parte: se você normalizar todos os vetores no momento da indexação, a similaridade de cosseno vira um produto escalar simples, sem divisões nem cálculo de norma em tempo de consulta. É trabalho feito uma vez na ingestão e economizado em toda busca, para sempre.
o lote que respeita o formato do trabalho
O contraste está em como o lote é formado. O laço ingênuo agrupa por contagem e paga o retângulo cheio; o outro agrupa por semelhança de tamanho e mede o desperdício.
// ❌ lote por contagem: 32 documentos, comprimento do maior manda em todo mundo
foreach (var pedaco in trechos.Chunk(32))
    await encoder.EmbedAsync(pedaco);   // 31 textos de 30 tokens pagando por 500
// ✅ ordenar por comprimento, fechar lote por orçamento de tokens, e medir o vazio
var ordenados = trechos.OrderBy(t => t.Tokens); // lotes homogêneos
var lote = new List<Trecho>();
int maior = 0;
foreach (var t in ordenados)
{
var novoMaior = Math.Max(maior, t.Tokens);
if ((lote.Count + 1) * novoMaior > OrcamentoDeTokens && lote.Count > 0)
{
await ProcessarAsync(lote, maior);
lote.Clear(); maior = 0;
novoMaior = t.Tokens;
}
lote.Add(t); maior = novoMaior;
}
if (lote.Count > 0) await ProcessarAsync(lote, maior);
async Task ProcessarAsync(List<Trecho> lote, int maior)
{
// o cache resolve antes da GPU: trecho imutável, modelo versionado, vetor imutável
var faltando = lote.Where(t => !_cache.TryGet(t.Hash, ModeloVersao, out _)).ToList();
if (faltando.Count == 0) return;
var vetores = await encoder.EmbedAsync(faltando);
_metricas.RegistrarPadding(faltando.Sum(t => maior - t.Tokens)); // o desperdício, medido
_cache.Gravar(faltando, vetores, ModeloVersao);
}A métrica de padding é a que ninguém tem e a que paga o exercício. Ela responde em uma linha quanto da sua fatura de ingestão foi gasta processando enchimento, e costuma sair de dois dígitos percentuais para perto de zero com uma ordenação.
o que fazer com a metade online
Do lado da consulta, três decisões resolvem quase tudo.
A primeira é aproximar o modelo do serviço. Um encoder pequeno rodando junto do seu backend, através do runtime que o sexto artigo desta série apresentou, tira do caminho crítico uma viagem de rede, uma fila de fornecedor e uma dependência de disponibilidade. Para consultas curtas, a passagem pelo encoder é trabalho de poucos milissegundos, e a chamada remota costuma custar múltiplos disso só em transporte.
A segunda é reconhecer que consultas se repetem. Em produto real, uma fatia relevante das perguntas é idêntica ou quase idêntica a perguntas anteriores, e o vetor da consulta é cacheável pelas mesmas regras do trecho: texto normalizado, versão do modelo, pronto.
A terceira é não deixar o embedding invisível no painel. Ele merece uma métrica própria, com percentis, do mesmo jeito que o tempo até o primeiro token tem. Sem isso, quando o p99 do RAG piorar, a investigação vai começar pelo modelo de linguagem, que é o suspeito caro e famoso, enquanto o culpado pode ser um passo de dez linhas que ninguém instrumentou.
Insights & Takeaways
- Embedding é dois problemas com o mesmo nome: latência pura na consulta, com lote de tamanho um no caminho crítico, e throughput na ingestão, com milhões de trechos e ninguém esperando. Otimizar um com a régua do outro é o erro mais comum.
- O encoder é prefill puro e pequeno, então ele satura a GPU de verdade em lote e roda bem em CPU. Isso faz do embedding o candidato mais óbvio a rodar dentro da sua infraestrutura, e não como chamada externa no caminho crítico.
- Padding é o desperdício invisível da ingestão: o lote é um retângulo e todo texto paga o comprimento do maior. Ordenar por comprimento e fechar o lote por orçamento de tokens leva esse desperdício de dois dígitos percentuais para perto de zero.
- Trecho imutável mais modelo versionado dão vetor imutável. Sem cache por hash do texto e versão do modelo, toda mudança de regra de fatiamento reprocessa o acervo inteiro para produzir os mesmos vetores.
- Dimensão é custo em três lugares ao mesmo tempo: memória do índice, conta por comparação e banda na busca. Cortar pela metade vale ser medido com o conjunto de consultas de referência, e normalizar na ingestão transforma cosseno em produto escalar de graça.
Uma pergunta honesta pra fechar: quanto do p99 do seu RAG é embedding? Se a resposta for que a métrica não existe separada, a próxima investigação de lentidão vai começar pelo modelo de linguagem, que é o suspeito caro e visível, enquanto o passo pequeno segue fora do radar por mais alguns meses.
No próximo artigo, a série entra no arco que é a casa do .NET: o código que cerca o modelo. Tokenização, montagem de prompt, serialização do fluxo de saída. Nenhuma dessas coisas usa GPU, todas elas rodam a cada requisição, e o custo delas cresce com o tamanho das respostas que o seu produto entrega.