IA de Alta Performance · Episódio 17
A Metade Esquecida do RAG
Busca vetorial aproximada erra por configuração. Recall do índice, HNSW, quantização de vetores e filtro por metadado: o que medir na busca do seu RAG.
Neste artigo · 8 seções
Pergunte ao time que mantém o RAG da sua empresa qual é o recall do índice vetorial em produção. Não a acurácia da resposta, não a nota da avaliação: o recall da busca, a fração dos documentos realmente mais parecidos com a pergunta que o índice devolveu.
Na maioria das vezes a resposta é um silêncio educado, seguido de "acho que a gente usa o padrão da biblioteca". E esse é o assunto deste artigo, que abre um arco novo da série: a busca vetorial é aproximada por definição, o grau de aproximação é uma configuração, e essa configuração está tomando decisões de qualidade e de latência no seu produto sem que ninguém tenha escolhido.
A geração é a parte glamourosa do RAG e leva a culpa por tudo. A busca é a metade esquecida, e ela responde por uma fatia teimosa tanto da latência quanto dos erros que o time debita ao modelo.
o botão que ninguém sabe que existe
Busca vetorial exata é simples de entender: compare a pergunta com todos os vetores e devolva os mais próximos. Correta, previsível e cara.
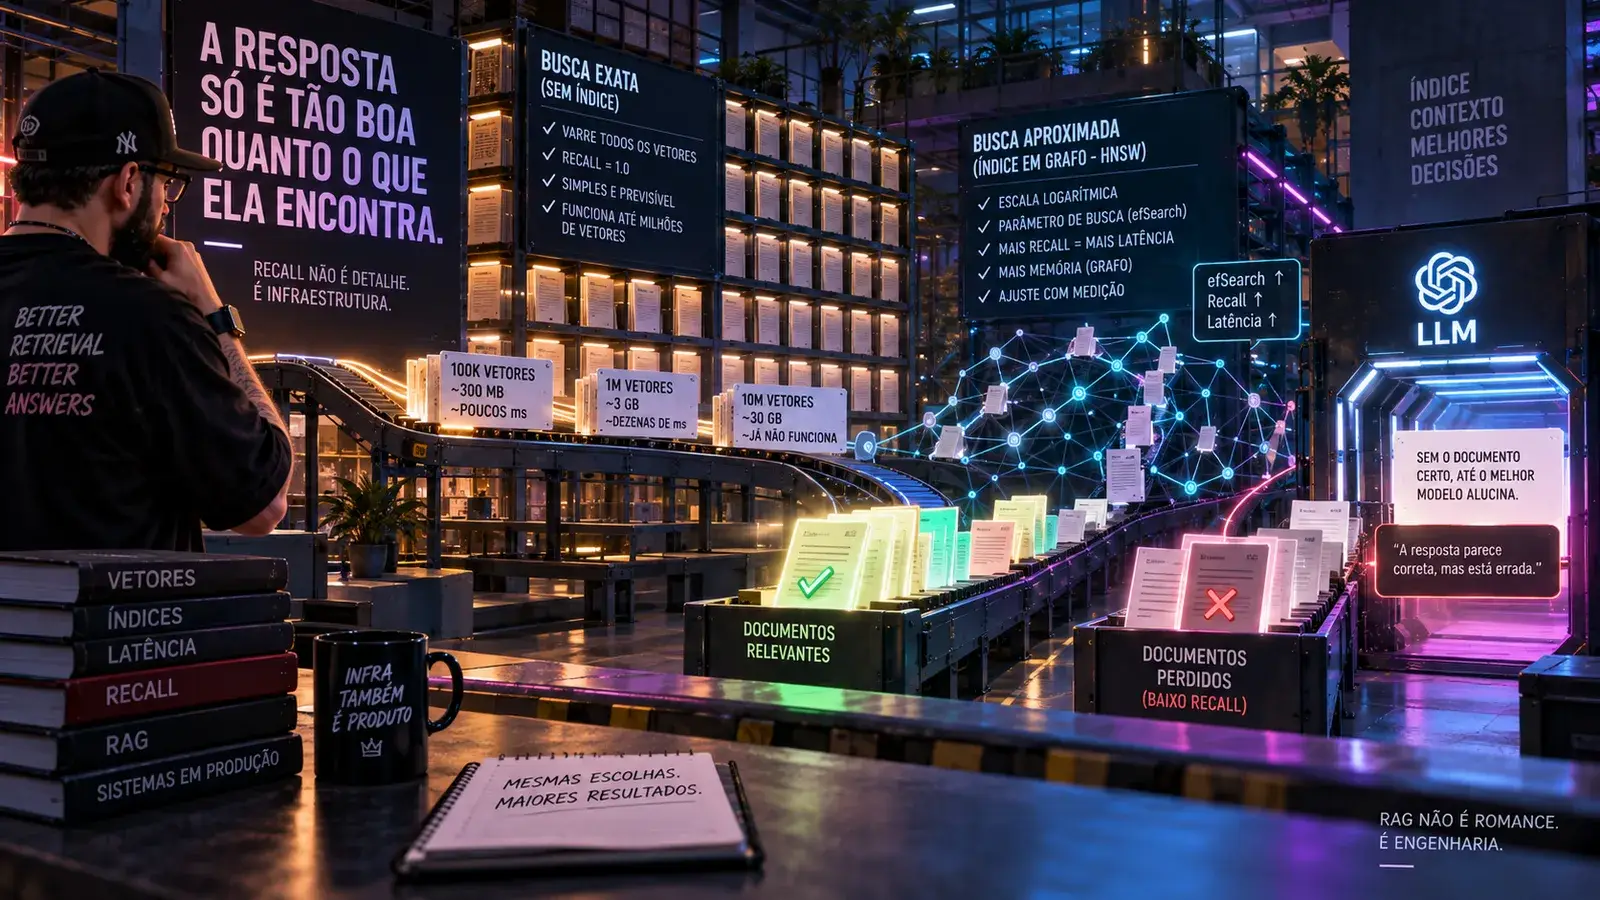
Índices aproximados existem para fugir do custo dessa varredura, e o preço é que eles às vezes erram. Recall, aqui, mede quantos dos verdadeiros vizinhos mais próximos apareceram na resposta. Recall de 0,8 significa que, em média, um a cada cinco documentos que deveriam ter entrado no contexto ficou de fora.
Agora acompanhe o efeito no produto. O documento que respondia à pergunta não entra no prompt. O modelo, que só sabe o que está no contexto, responde com o que sobrou, com toda a fluência do mundo. O time registra como alucinação, abre uma discussão sobre trocar de modelo, escreve instruções mais rígidas no prompt.
A causa estava três camadas antes, num parâmetro padrão de biblioteca. Já escrevi que RAG não é romance, e essa é a versão de infraestrutura do mesmo argumento: se a evidência não chega ao contexto, nenhuma engenharia de prompt salva a resposta.
Recall não é uma propriedade do sistema, é um ponto escolhido numa curva. E como toda escolha nesta série, ela tem o outro lado: subir o recall custa latência, memória, ou os dois.
quando você nem precisa de índice
Antes de discutir estrutura sofisticada, vale fazer a conta que a primeira temporada ensinou a fazer, porque ela vale igual aqui.
Uma busca exata lê todos os vetores da memória e faz uma conta barata com cada um. É o mesmo perfil do decode: limitada por banda, não por cálculo. Então o tempo é o tamanho do conjunto dividido pela banda de memória disponível.
Cem mil vetores de 768 dimensões em ponto flutuante de 32 bits somam uns 300 MB. Numa máquina que sustenta algumas dezenas de gigabytes por segundo, isso é uma varredura de poucos milissegundos, e o .NET moderno faz esse tipo de conta com instruções vetoriais sem que você escreva uma linha de código especial. Um milhão de vetores já são 3 GB e dezenas de milissegundos. Dez milhões são 30 GB, e aí acabou a brincadeira.
Ou seja, existe uma faixa larga de aplicações reais, especialmente base de conhecimento interna, documentação de produto e busca por cliente em sistema multiempresa, onde a busca exata é rápida o suficiente, tem recall de 1,0 por construção, não precisa de tuning, não tem índice para reconstruir e não tem parâmetro para alguém errar.
A decisão de adotar um índice aproximado deveria vir de uma conta como essa, não de reflexo. Estrutura de dados é resposta a um problema de escala; adotar antes da escala é comprar complexidade sem comprar nada.
como o grafo faz a busca virar logarítmica
Passada a faixa em que a varredura serve, a estrutura que dominou a área é um grafo, e vale entender o mecanismo porque ele explica os parâmetros que você vai ter que ajustar.
A ideia é construir uma rede de vizinhança em camadas, com uma propriedade de mundo pequeno: a maioria das ligações é local, entre vetores parecidos, e algumas ligações são longas, atalhos que atravessam o espaço. A camada de cima tem poucos nós e ligações longuíssimas; as de baixo vão ficando densas e locais, até a camada zero, que contém todo mundo.
A busca entra pelo topo, caminha em direção ao vizinho mais próximo da consulta até não conseguir melhorar, desce uma camada e repete. É a mesma lógica de uma lista com saltos: começar com passos enormes e ir encurtando. Malkov e Yashunin mostraram que essa hierarquia leva a busca a escalar de forma logarítmica com o tamanho do conjunto, o que é a diferença entre um índice que aguenta dez milhões de vetores e um que não aguenta.
Três parâmetros importam. Dois deles são decididos na construção: quantas ligações cada nó mantém, que define a robustez do grafo e o custo de memória, e o esforço gasto para escolher boas ligações, que define a qualidade do índice e o tempo de construção. O terceiro é decidido na busca: a largura da fronteira explorada, ou seja, quantos candidatos a busca mantém vivos enquanto caminha.
Esse terceiro é o botão do título. Aumentar a largura da busca melhora o recall e custa tempo, de forma contínua e previsível, sem reconstruir nada. É o parâmetro que deveria estar exposto na sua configuração, com um valor escolhido a partir de medição, e que na prática está no padrão da biblioteca.
Uma observação de custo que pega muita gente de surpresa: o grafo não é de graça em memória. Guardar dezenas de ligações por nó, com todo o índice residente em RAM para a busca fazer sentido, adiciona centenas de bytes por vetor além do vetor em si. Num conjunto de dez milhões, isso é a diferença entre caber e não caber na máquina que você provisionou.
comprimir os vetores, com a mesma lógica de sempre
Se memória é o teto, existe uma saída que esta série já percorreu do outro lado da casa. Quantização de pesos reduziu o custo de servir modelos trocando precisão por bytes; quantização de vetores faz o mesmo com o índice.
Cair de ponto flutuante de 32 bits para inteiro de 8 bits corta a memória por quatro e mantém a ordenação dos vizinhos praticamente intacta, porque a busca não precisa da distância exata, precisa da ordem relativa. Descer até um bit por dimensão corta por trinta e dois, e aí a distorção é grande demais para confiar direto no resultado.
O que salva a versão agressiva é uma ideia velha de sistemas de busca: procurar barato e conferir caro. A travessia acontece na representação comprimida, rápida e cabendo em cache, e os melhores candidatos, um pouco mais do que os k pedidos, são reordenados com os vetores originais. O grosso do trabalho roda na versão pequena, e a precisão da resposta final vem da versão grande, aplicada a um punhado de itens.
O padrão é o mesmo de qualquer sistema de alta performance: filtrar rápido com uma aproximação barata, refinar devagar com a fonte da verdade, e desenhar o sistema para que a fase cara toque poucos elementos.
o filtro que quebra o grafo
Tem um problema que quase nunca aparece no tutorial e que aparece em toda implantação corporativa no segundo mês: filtrar por metadado.
Na demonstração, você busca em tudo. Na sua empresa, você busca nos documentos daquele cliente, daquele departamento, dentro do período, respeitando a permissão de quem perguntou. E filtro e grafo de vizinhança se dão mal.
Filtrar depois da busca é a saída ingênua: peça os dez mais parecidos, descarte os que não passam no filtro, e às vezes sobram dois. Se o filtro for seletivo, pode sobrar zero, e o sistema devolve uma resposta vazia sobre uma base que tinha a informação.
Filtrar durante a travessia parece melhor e traz o problema estrutural: o caminho até a região certa do espaço passa por nós que não pertencem ao filtro. Ao ignorá-los, você corta a conectividade do grafo, a busca fica presa em regiões locais e o recall despenca justamente nos filtros mais restritivos, que são os mais comuns em ambiente corporativo.
As saídas reais não são elegantes, e é bom saber disso antes de desenhar. Particionar fisicamente por chave de alta cardinalidade, um índice por cliente, resolve o caso multiempresa com um custo de gestão que é honesto. Filtros de baixa seletividade, que mantêm boa parte da base, funcionam bem com filtro durante a travessia e uma largura de busca maior. E quando o subconjunto filtrado é pequeno, a melhor resposta costuma ser a menos sofisticada: varredura exata dentro do subconjunto, que volta a ser barata justamente porque o filtro reduziu a base.
Esse é o tipo de detalhe que decide se o RAG corporativo funciona ou se ele vira uma coleção de casos estranhos em que "às vezes ele não acha o documento".
escolher a estrutura pela escala e pelo filtro
recall é medição, não crença
A diferença entre um índice que você opera e um que opera você cabe em vinte linhas de teste. O truque é ter uma referência: uma amostra de consultas reais com os vizinhos verdadeiros calculados na marra, uma vez, e guardados.
// ❌ o índice como caixa-preta: parâmetro padrão, resultado aceito por fé
var vizinhos = indice.Buscar(consulta, k: 10);
// qual recall isso entrega no SEU dado? ninguém sabe. e o p99 da busca?
// ✅ referência exata calculada uma vez, recall medido a cada mudança
static int[] TopKExato(float[] consulta, float[][] baseVetores, int k)
{
var pontuacoes = new float[baseVetores.Length];
for (int i = 0; i < baseVetores.Length; i++) // varredura vetorizada
pontuacoes[i] = TensorPrimitives.CosineSimilarity(consulta, baseVetores[i]);
return Enumerable.Range(0, pontuacoes.Length)
.OrderByDescending(i => pontuacoes[i]).Take(k).ToArray();
}
// a curva que decide a configuração: largura da busca contra recall e latência
foreach (var largura in new[] { 32, 64, 128, 256, 512 })
{
var (recall, p99) = Avaliar(consultasDeReferencia, largura);
_log.Configuracao(largura, recall, p99); // escolha o menor que cumpre a meta de recall
}Duas coisas saem desse exercício, e as duas mudam conversa de arquitetura. A primeira é o número que faltava: com esta configuração, este índice entrega tanto de recall no meu dado, não no dado do artigo de marketing. A segunda é a curva, que transforma uma discussão de opinião numa escolha explícita, do mesmo tipo que a série vem fazendo desde o começo: escolha o menor esforço de busca que ainda cumpre a meta de qualidade, e ganhe o resto em latência.
Vale repetir a construção da referência sempre que o modelo de embedding mudar. Trocar de modelo de embedding invalida o índice inteiro, e é surpreendentemente comum alguém atualizar o modelo e manter os vetores antigos convivendo com os novos, o que produz um recall ruim que nenhum ajuste de parâmetro conserta.
Insights & Takeaways
- Busca vetorial aproximada erra por construção, e o quanto ela erra é configuração, não destino. Recall de 0,8 significa um em cada cinco documentos relevantes fora do contexto, e o sintoma disso chega ao time como alucinação do modelo.
- Antes de adotar índice, faça a conta de banda: centenas de milhares de vetores cabem numa varredura exata de poucos milissegundos, com recall perfeito e zero parâmetros. Complexidade de índice é resposta a escala, não a ambição.
- No grafo em camadas, dois parâmetros são decididos na construção e um na busca. A largura da busca é o botão contínuo de recall contra latência, e é ele que costuma estar no padrão da biblioteca sem ninguém ter escolhido.
- Quantizar vetores repete a lógica da quantização de pesos: cortar bytes por quatro ou por trinta e dois, percorrer o índice na versão comprimida e reordenar só os finalistas com os vetores originais. Barato para filtrar, caro para confirmar, e o caro toca poucos itens.
- Filtro por metadado é o problema real de RAG corporativo: filtrar depois esvazia o resultado, filtrar durante corta a conectividade do grafo e derruba o recall. As saídas honestas são particionar por chave, aceitar filtros pouco seletivos ou varrer exatamente o subconjunto quando ele for pequeno.
Uma pergunta honesta pra fechar: qual é o recall do seu índice vetorial hoje, medido no seu dado, com as suas consultas? Se esse número não existe, existe um parâmetro padrão decidindo quanta evidência chega ao modelo, e o time está debatendo qualidade de resposta sem saber o que foi entregue ao contexto.
No próximo artigo, a série continua nesse arco pelo outro lado da mesma moeda: o pipeline de embedding, que transforma texto em vetor antes da busca acontecer, e que costuma esconder mais latência e mais custo do que a busca e a geração somadas.