IA First · Episódio 17
Fine-tuning vs Prompting vs RAG: A Tríade Que Vai Comer Seu Orçamento se Você Não Entender
Quando usar prompting, RAG ou fine-tuning, quanto cada um custa em tokens, manutenção e governança, e como combinar os três sem queimar o orçamento.
Neste artigo · 10 seções
- A confusão que custa caro
- O que cada uma faz, sem mistificação
- Qual problema cada técnica resolve
- Os trade-offs que ninguém detalha bem
- A combinação que funciona melhor que escolher uma só
- "Overkill" que aparece toda hora
- Como decidir na prática
- O que tipicamente está errado quando o custo explode na decisão errada
- Conclusão
- Insights & Takeaways
A confusão que custa caro
Tem uma cena que se repete em todo time tomando decisão sobre IA pela primeira vez. Alguém da liderança lê um post sobre fine-tuning e pergunta: "a gente não deveria estar treinando nosso próprio modelo?" Outra pessoa argumenta que RAG é melhor. Um terceiro defende que o ChatGPT já resolve tudo com prompt bem feito. A discussão vira religiosa, cada um defendendo a abordagem da moda, e a decisão é tomada com base em quem fala mais alto, não em qual técnica resolve o problema.
O preço dessa confusão aparece depois. Time investiu meses em fine-tuning quando prompting resolveria. Time montou pipeline complexo de RAG quando fine-tuning de um modelo pequeno seria mais barato e rápido. Time foi direto pro modelo mais caro com prompt grande quando uma combinação RAG + modelo menor entregaria o mesmo com 1/10 do custo.
Essa confusão é evitável. As três técnicas resolvem problemas diferentes, têm trade-offs claros, e quase sempre são complementares, não substitutas. Esse artigo é sobre entender quando cada uma faz sentido, em que combinações, e quais perguntas guiar a decisão.
O que cada uma faz, sem mistificação
Vamos definir cada uma do jeito mais direto possível.
Prompting é instruir o modelo, em tempo de execução, sobre o que fazer. Você manda system prompt, exemplos few-shot, contexto da tarefa, e a mensagem do usuário. O modelo usa o conhecimento que já tem (do treinamento) e o que você passou no prompt pra responder. Você não treina nada; só configura.
RAG (Retrieval-Augmented Generation) adiciona uma etapa antes de chamar o modelo: busca dados relevantes numa base externa e injeta esses dados no contexto. O modelo continua sendo o mesmo; o que muda é que agora ele responde com base em informação específica que você buscou, não só com o que sabe do treinamento.
Fine-tuning é treinar o modelo (a partir de um modelo base) com dados específicos do seu domínio. O modelo aprende padrões, vocabulário, estilo, comportamento. Você não passa esses dados em tempo de execução; eles ficam "embutidos" nos pesos do modelo treinado.
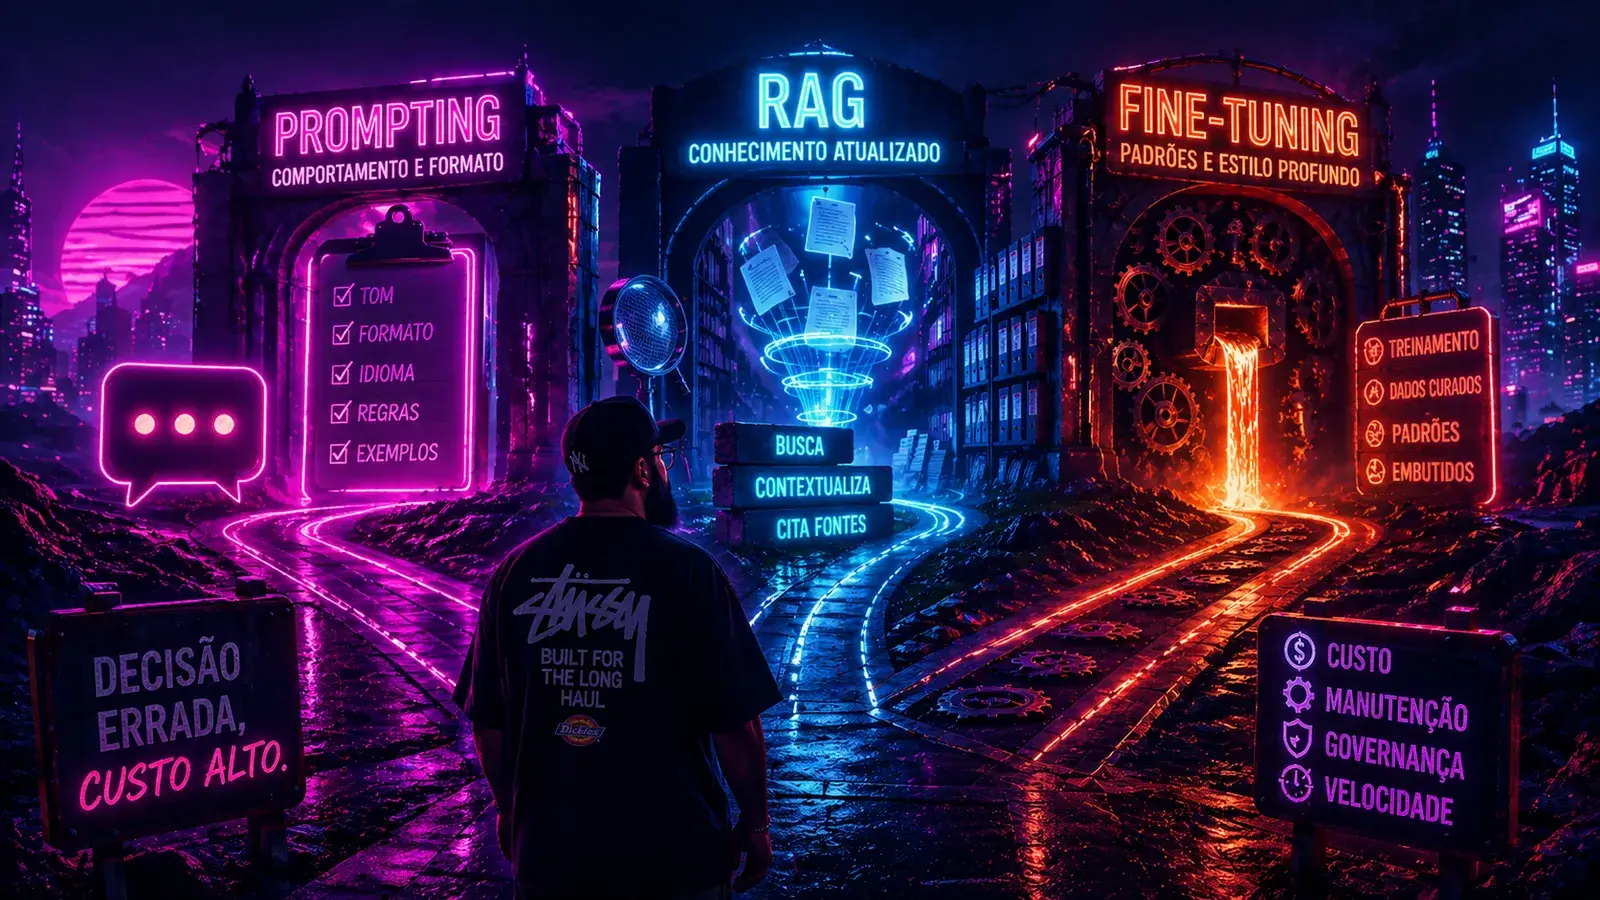
Visualmente, a diferença fica clara:
Cada uma resolve um problema diferente. Confundir qual problema você tem é o que faz o orçamento explodir.
Qual problema cada técnica resolve
Aqui está a parte que economiza dinheiro: cada técnica é forte num eixo específico de adaptação.
Prompting é forte em comportamento e formato. Quer que o modelo responda em formato JSON específico, com tom formal, no idioma X, evitando certos tópicos? Prompt resolve. Você está dizendo "como" responder, não "o que" saber.
RAG é forte em conhecimento factual atualizado. Quer que o modelo responda com base em documentos da empresa, na política mais recente, no histórico do cliente, em catálogo de produtos? RAG resolve. Você está fornecendo "o que" saber, em tempo de execução.
Fine-tuning é forte em padrões implícitos e estilo profundo. Quer que o modelo aprenda um vocabulário muito específico do domínio, um estilo de escrita particular, uma forma de raciocinar sobre um tipo de problema, ou que tenha um comportamento robusto que prompt sozinho não consegue ensinar? Aí entra fine-tuning.
A pergunta que orienta a decisão é: "o que está faltando no comportamento atual do modelo?"
Falta saber como responder? Prompting.
Falta saber o quê responder, e a informação muda com frequência? RAG.
Falta um padrão de comportamento que não cabe em prompt e os dados são estáveis? Fine-tuning.
Os trade-offs que ninguém detalha bem
Cada técnica tem custos diferentes, e não é só de tokens. Vou destrinchar quatro dimensões: custo, manutenção, governança e ciclo de desenvolvimento.
Prompting
Custo. Pago a cada chamada, proporcional ao tamanho do prompt + resposta. Prompts grandes ficam caros em volume. Cache de prompt do provedor reduz isso significativamente quando partes do prompt são fixas.
Manutenção. Baixa. Mudar comportamento é editar texto. Versionar prompts e testar mudanças é o suficiente.
Governança. Boa. Você tem controle total sobre o que vai pro modelo a cada chamada. Logging do prompt completo é trivial. Auditoria é direta.
Ciclo de dev. Rapidíssimo. Mudou prompt, testou, deu deploy. Minutos a horas.
RAG
Custo. Tokens de entrada altos (contexto recuperado entra no prompt) + custo de embeddings na indexação + custo de busca em tempo de execução + infraestrutura do índice vetorial. Em volume, o contexto domina a fatura. Cache ajuda menos porque o contexto muda por query.
Manutenção. Média a alta. Pipeline de indexação precisa funcionar (extração, chunking, embedding, atualização, invalidação). Qualidade do retrieval precisa ser monitorada. Documentos novos precisam ser indexados.
Governança. Excelente. Cada resposta pode citar fontes. Lineage do dado é rastreável. Atualização da base é controlável.
Ciclo de dev. Médio. Implementar RAG do zero leva semanas. Adicionar novos documentos depois é processo automatizado.
Fine-tuning
Custo. Custo alto de treinamento (uma vez por versão do modelo, mas se repete a cada atualização). Custo por chamada pode ser menor (modelo menor pode ter desempenho equivalente em tarefa estreita). Mas exige infraestrutura de treinamento ou consumo de serviço gerenciado, mais infraestrutura de hospedagem se for self-hosted.
Manutenção. Alta. Dataset de treinamento precisa ser curado, versionado, atualizado. Cada atualização do modelo é um novo treinamento, com pipeline de avaliação completo. Modelo treinado fica defasado em relação ao base; quando o base evolui, precisa retreinar.
Governança. Complicada. O modelo "sabe" coisas que estão embutidas nos pesos. Não é trivial saber exatamente o que ele aprendeu. Auditoria é mais difícil. Compliance fica mais sensível, especialmente com PII no dataset.
Ciclo de dev. Lento. Treinamento + avaliação + iteração leva dias a semanas. Errar um detalhe no dataset pode exigir começar de novo.
A tabela mental fica assim:
A combinação que funciona melhor que escolher uma só
Aqui vai o ponto que muita gente perde: prompting, RAG e fine-tuning não são alternativas excludentes. Sistemas maduros combinam as três.
Combinação típica em produto sério:
Fine-tuning de um modelo base pra dominar o estilo de comunicação da empresa, vocabulário do domínio, formato de saída padrão, comportamento de recusa de pedidos fora de escopo. Isso fica embutido nos pesos.
RAG sobre esse modelo treinado pra fornecer conhecimento factual atualizado: documentos atuais, dados do cliente, políticas vigentes. Isso entra no contexto de cada chamada.
Prompting bem desenhado em cima disso pra orquestrar a interação específica: tom da resposta, instruções de tarefa, restrições da chamada atual. Isso ajusta a chamada caso a caso.
Cada camada resolve o que é forte em resolver. Você não usa fine-tuning pra ensinar dados que mudam toda semana (RAG faz melhor). Não usa RAG pra ensinar estilo que é o mesmo sempre (fine-tuning ou prompt fazem). Não usa só prompt quando o contexto fica grande demais (RAG ou fine-tuning ajudam a reduzir).
Mas isso é cenário de maturidade. Pra começar, quase sempre a recomendação é prompting puro, depois adicionar RAG se faltar conhecimento factual, e considerar fine-tuning só quando os dois primeiros não dão conta de algo específico.
"Overkill" que aparece toda hora
Tem algumas formas de overkill que aparecem com frequência e queimam orçamento sem necessidade.
Fine-tuning pra ensinar fatos. "Vamos treinar um modelo com nossos manuais de produto." Errado. Fatos mudam, manuais são atualizados, fine-tuning não é o lugar pra isso. RAG resolve melhor, mais barato e mais auditável.
RAG pra responder perguntas que não dependem de conhecimento específico. "Como redigir um e-mail formal?" não precisa de RAG. O modelo base já sabe. Adicionar busca aqui é processamento desnecessário e contexto inflado.
Prompts gigantes com 50 exemplos few-shot quando fine-tuning seria barato. Se você está mandando 30 exemplos a cada chamada pra ensinar um padrão específico, em volume alto, fine-tuning paga ele mesmo em poucas semanas.
Fine-tuning de modelo grande quando modelo pequeno bastaria. Se a tarefa é estreita (classificação, extração, formato específico), fine-tunar um modelo pequeno costuma entregar resultado comparável ou superior, com latência menor e custo dramaticamente menor.
RAG sobre uma base que cabe em system prompt. Se sua "base de conhecimento" tem 20 entradas que cabem em 2000 tokens, RAG é overengineering. Coloca tudo no system prompt e ativa cache.
A regra geral: comece com a abordagem mais simples que pode funcionar. Prompting sozinho. Se não dá conta, identifica o que falta. Se falta conhecimento, RAG. Se falta padrão profundo que prompt não ensina, fine-tuning. Subir camadas é fácil; descer camadas é dolorido.
Como decidir na prática
Um framework simples de decisão que tende a funcionar:
Pergunta 1: o que o modelo precisa fazer já está descrito em prompt razoável (system prompt + few-shot examples)?
Se sim, faça prompting. Itere até atingir qualidade. Não vá além disso até justificar.
Pergunta 2: o sistema precisa responder com base em informação específica da empresa, do cliente, do contexto, e essa informação muda?
Se sim, adicione RAG. Mantém prompting; adiciona retrieval na frente.
Pergunta 3: depois de prompting otimizado e RAG funcionando, ainda há lacunas de comportamento que não cabem em prompt (estilo profundo, vocabulário muito específico, padrões de raciocínio)?
Se sim, considere fine-tuning. Mas com uma checagem extra: você tem dataset de pelo menos algumas centenas de exemplos de qualidade, com gabarito? Se não tem, fine-tuning vai falhar antes de começar.
Pergunta 4: o volume justifica o investimento?
Fine-tuning compensa em volume. Em features de baixo volume, o custo de manter dataset, pipeline de treinamento e versionamento ultrapassa qualquer economia em inferência.
O que tipicamente está errado quando o custo explode na decisão errada
Alguns padrões aparecem com frequência:
Time foi direto pra fine-tuning porque "queriam um modelo próprio". Resultado: meses de esforço, dataset insuficiente, modelo final pior que o base + RAG, conta de infraestrutura crescente, ninguém quer admitir que foi caminho errado.
Time montou RAG complexo pra problema que era de comportamento, não de conhecimento. Buscar não trouxe a resposta porque a resposta não estava nos documentos; o problema era o modelo respondendo no formato errado. Prompt teria resolvido em uma tarde.
Time mantém prompt de 8000 tokens com dezenas de exemplos pra ensinar um padrão estável. Em volume, paga toda chamada. Fine-tuning de modelo pequeno teria reduzido custo dramaticamente, mas ninguém calculou.
Time treinou modelo com dados de seis meses atrás e nunca mais retreinou. Modelo está respondendo sobre situações que não existem mais. RAG sobre dados atuais teria evitado isso; ou pelo menos um pipeline de retrain regular.
Em todos esses casos, a raiz é a mesma: a decisão foi tomada por preferência de tecnologia ou hype, não por análise do problema real.
Conclusão
Prompting, RAG e fine-tuning não são técnicas concorrentes; são camadas diferentes de adaptação de um modelo. Prompting ensina como responder. RAG fornece o que saber em tempo de execução. Fine-tuning embute padrões profundos nos pesos. Sistemas maduros combinam as três; sistemas iniciantes deveriam começar pela mais simples.
A decisão certa quase nunca é "qual técnica vence". É "qual combinação resolve o problema com o menor custo de operação contínua". E pra responder isso, você precisa entender o que está faltando no comportamento atual, não escolher pela técnica que está em alta.
Uma forma honesta de checar se a decisão está bem fundamentada: se você não consegue explicar, em uma frase, por que prompting não basta, você ainda não tem justificativa pra escalar pra RAG ou fine-tuning. Comece simples. Suba camadas só quando tiver evidência de que precisa.
Insights & Takeaways
-
As três técnicas resolvem problemas diferentes: prompting ensina como responder, RAG fornece o que saber em tempo de execução, fine-tuning embute padrões profundos. Confundir qual problema você tem é o que faz o orçamento explodir.
-
Comece sempre por prompting. Adicione RAG quando o conhecimento necessário não está no modelo e muda. Considere fine-tuning quando prompt e RAG juntos não resolvem um padrão específico de comportamento.
-
Fine-tuning pra ensinar fatos é o erro mais caro. Fatos mudam, modelos treinados envelhecem, e RAG resolve isso melhor, mais barato e mais auditável.
-
Sistemas maduros combinam as três técnicas. Não escolha uma; escolha a combinação certa pra cada camada do problema.
-
Se você não consegue explicar em uma frase por que prompting sozinho não basta, ainda não tem justificativa pra escalar pra RAG ou fine-tuning. Subir camadas é fácil; descer é dolorido.