IA First · Episódio 15
Custo de IA em Produção: Como Parar de Levar Surpresa na Fatura no Final do Mês
Como estimar o custo de uma feature de IA antes de lançar, criar alertas de anomalia e cortar tokens com contexto enxuto, cache e roteamento de modelos.
Neste artigo · 8 seções
A cena que se repete em todo time que bota IA em produção
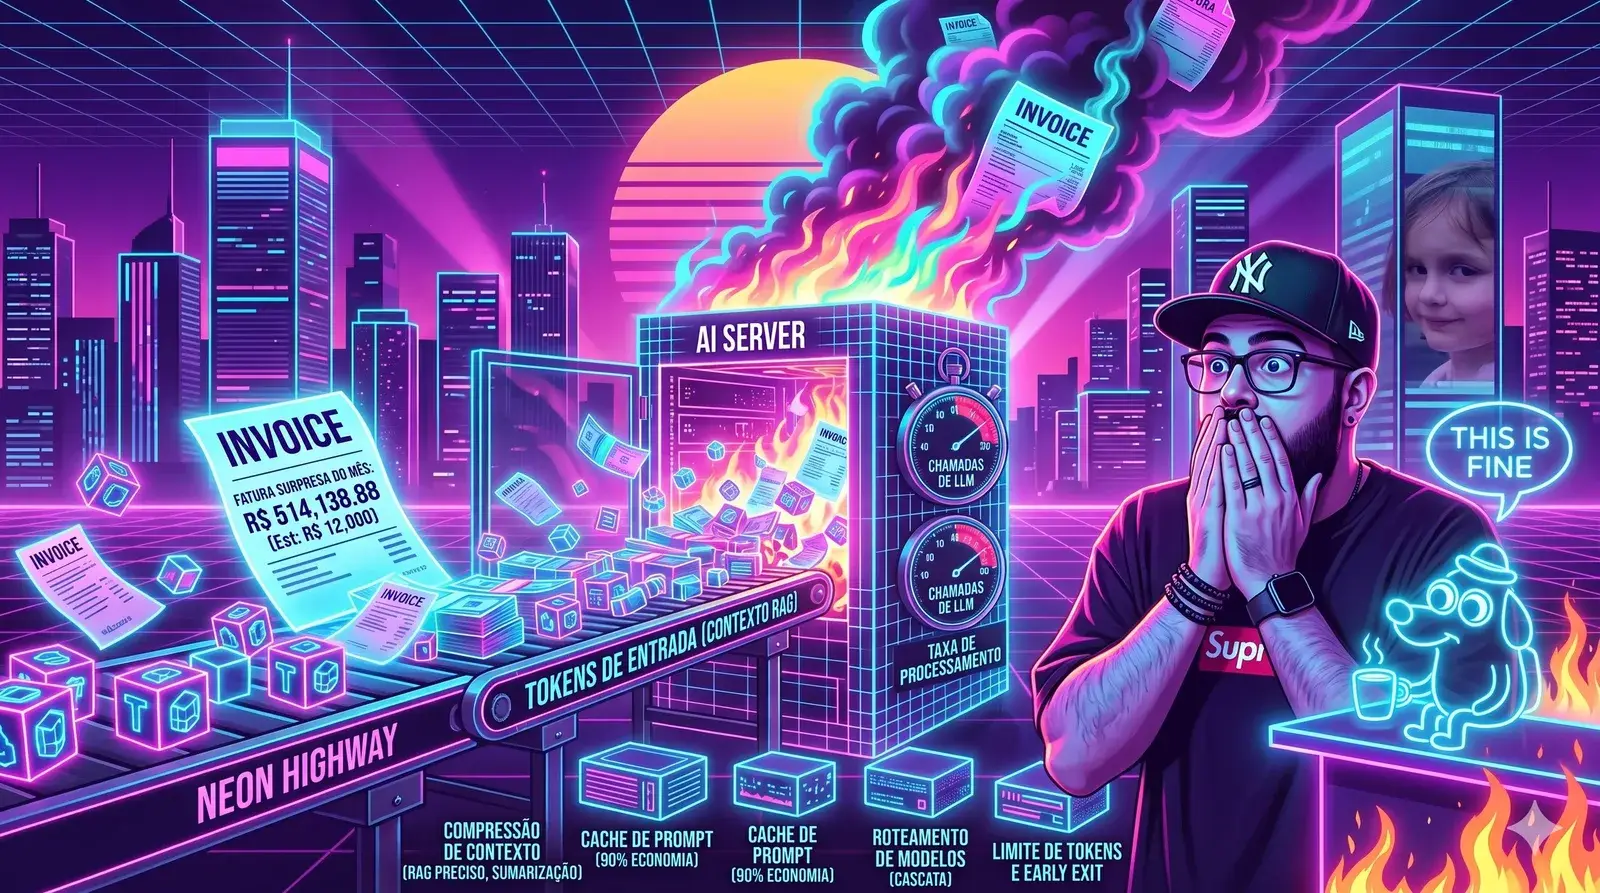
Dia 28 do mês. Alguém do financeiro manda uma mensagem no Slack com um print da fatura do provedor de LLM. "Isso aqui está certo?" O número é três vezes maior que o esperado. Ninguém sabe explicar. O time de engenharia começa a investigar. Duas horas depois, descobre que uma feature nova, que entrou em produção duas semanas atrás, está fazendo 8 chamadas ao modelo por interação em vez das 2 que estavam no design. Ou pior: um bug de retry ficou chamando o modelo em loop pra um conjunto específico de inputs, e ninguém percebeu porque a feature "parecia estar funcionando".
Isso acontece em empresa de todo tamanho. Não é falta de competência técnica; é falta de modelagem e observabilidade específicas de custo. Num sistema tradicional, custo de infraestrutura é relativamente previsível (servidores, storage, largura de banda). Com IA, o custo é variável por chamada, dependente de input do usuário, e pode explodir de formas que não aparecem em alertas de CPU ou latência.
Esse artigo é sobre como tomar controle. Como modelar custo antes de lançar, como rastrear depois, e quais técnicas de engenharia reduzem consumo sem degradar qualidade.
Entendendo o que você está pagando
Antes de otimizar qualquer coisa, é preciso entender o que forma a conta. Com LLMs, o modelo mental mais útil é: você paga por token processado.
Cada chamada a um provedor de LLM tem dois componentes de custo.
Tokens de entrada são o que o modelo lê. Inclui a system prompt, o histórico da conversa se houver, os documentos de contexto (em RAG), os resultados de tool calls anteriores, e a mensagem atual do usuário. Cada provedor cobra um preço por milhão de tokens de entrada.
Tokens de saída são o que o modelo gera. A resposta em si, incluindo eventuais tool calls que o modelo decide fazer. O preço por milhão de tokens de saída é tipicamente 3 a 5 vezes maior que o de entrada.
Isso é crítico. Muita gente otimiza geração e ignora contexto, quando na maioria dos casos de RAG e tool use, são os tokens de entrada que dominam a conta. Você pode estar gastando 5.000 tokens de contexto pra gerar 200 tokens de resposta. Se o preço de saída é mais alto, ainda assim os 5.000 de entrada, em volume, pesam mais.
Outros componentes que podem aparecer na fatura: embeddings (pra RAG, cada documento indexado gera custo; cada busca também), cache de prompts (alguns provedores cobram menos por tokens de entrada que se repetem), e inferência batch (mais barata, mas com latência maior).
Modelagem de custo antes do lançamento
Feature de IA nova sem modelagem de custo é aposta. Não precisa ser preciso ao centavo; precisa ser razoável em ordem de grandeza.
A pergunta simples: "quanto vai custar essa feature por usuário ativo por mês?"
Pra responder, você estima três coisas:
Quantas chamadas ao modelo uma interação típica gera? Isso depende do design da feature. Uma classificação simples é 1 chamada. Um fluxo com RAG é 1 chamada de embedding na busca + 1 chamada ao modelo. Um agente com tools pode ser 3-10 chamadas. Um workflow com múltiplas etapas pode ser 5-15.
Quantos tokens cada chamada consome, em média? Tokens de entrada somam system prompt (normalmente entre 200-1000 tokens), histórico se houver, contexto RAG se houver (tipicamente 1000-5000 tokens se você recupera 3-5 chunks), e mensagem do usuário. Tokens de saída dependem da natureza da resposta: uma classificação retorna 10-50 tokens, uma resposta conversacional 100-500, um documento gerado pode chegar em milhares.
Quantas interações por usuário por mês? Essa é a mais incerta e precisa ser estimada com base em benchmarks de features similares ou em pilotos controlados.
Um exemplo de conta realista pra uma feature de atendimento conversacional com RAG:
Chamadas por interação: 2 (1 embedding de busca + 1 chamada ao modelo)
Tokens de entrada por chamada do modelo: 3500 (system + contexto RAG + histórico + pergunta)
Tokens de saída por chamada do modelo: 300
Interações por usuário por mês: 20

Por usuário por mês:
- Entrada: 2 chamadas × 3500 tokens × 20 = 140.000 tokens de entrada (mas só 1 chamada de modelo usa contexto grande, ajustando)
- Aproximação simplificada: 20 × 3500 = 70.000 tokens de entrada
- Saída: 20 × 300 = 6.000 tokens de saída

Usando preços hipotéticos de $3/M entrada e $15/M saída:
- Custo de entrada: 70.000 / 1.000.000 × $3 = $0,21
- Custo de saída: 6.000 / 1.000.000 × $15 = $0,09
- Total: $0,30 por usuário/mês
Com 10.000 usuários ativos, isso é $3.000 por mês. Com 100.000, $30.000. Agora você tem uma ordem de grandeza pra discutir com o financeiro antes do launch, não depois.
Se essa conta está muito longe do que o negócio aguenta, é o momento de revisar o design, não depois que a fatura chegou.
Observabilidade de custo em tempo real
Modelagem antes ajuda a evitar surpresas grandes. Observabilidade depois detecta desvios cedo.
O mínimo viável é ter métricas agregadas de custo que você consegue visualizar no mesmo dashboard onde olha latência e erros. Três métricas importam mais que as outras:
Custo total por feature por dia. Se a feature X estava custando R$ 150/dia e de repente pulou pra R$ 400/dia sem mudança de volume, tem algo errado. Provavelmente mudança de prompt aumentou tokens de entrada, ou um retry está fazendo chamadas extras, ou um bug específico disparou loops.
Custo médio por interação por feature. Essa é a métrica mais sensível pra detectar regressão. Se a feature custava R$ 0,02 por interação e passou pra R$ 0,05 sem motivo aparente, algo mudou no design ou no comportamento do modelo.
Custo por tenant ou por cliente. Em produtos multi-tenant, uns clientes podem estar consumindo muito mais que outros. Sem essa visibilidade, você cobra tarifa plana e alguns tenants ficam no prejuízo. Com ela, você pode ajustar pricing, aplicar limites por plano, ou identificar uso abusivo.
Pra implementar isso, o log de interação com o modelo (que discutimos no artigo de arquitetura de backend) precisa incluir tokens de entrada, tokens de saída, modelo usado, e tenant. Com isso, qualquer ferramenta de métricas (Grafana em cima de um time-series database, Datadog, ou até queries SQL num data warehouse) consegue agregar.
Alertas que funcionam bem:
Esses três alertas simples capturam a maioria dos cenários de surpresa. Anomalia detecta loops e bugs. Budget detecta volume inesperado. Regressão detecta mudança de prompt ou modelo que ninguém avisou.
Técnicas de redução: o que funciona de verdade
Com modelagem e observabilidade no lugar, dá pra discutir otimização sem voar cego. As técnicas se dividem em quatro categorias.
Compressão de contexto
A maior parte do custo em features com RAG ou histórico longo vem de tokens de entrada repetitivos. Reduzir contexto, mantendo qualidade, é o maior vetor de economia.
Chunks mais precisos na busca. Em vez de recuperar 10 chunks grandes, recupere 3 chunks específicos. Isso exige melhorar o retrieval (ver artigo anterior sobre RAG). Ganho típico: 40-60% de redução em tokens de entrada.
Summarização de histórico. Em conversas longas, em vez de mandar todo o histórico a cada turno, mantenha um resumo rolling dos turnos antigos e os últimos N turnos literais. Ganho típico: 30-50% em conversas longas.
Prompt engineering enxuto. System prompts verbosos com exemplos desnecessários são comuns. Revisar e cortar costuma dar 20-30% de redução sem perda de qualidade. Mais que isso geralmente degrada comportamento.
Cache
Se a mesma entrada gera chamadas idênticas, cachear economiza.
Cache de resposta exata. Se usuários fazem perguntas comuns ("qual meu saldo?", "como cancelo?"), você pode cachear a resposta por chave determinística. Funciona bem pra FAQ e consultas frequentes, mal pra fluxos personalizados.
Cache de prompt do provedor. Provedores como Anthropic e OpenAI oferecem caching de partes fixas do prompt (system prompt + contexto estável) com desconto significativo. Se o seu system prompt tem 2000 tokens e é o mesmo pra todos os usuários, ativar cache reduz o custo dessa parcela em até 90%.
Cache de embeddings. Documentos indexados não precisam ser re-embedados toda hora. Mas queries de usuários também podem ser cacheadas: se dois usuários fazem buscas idênticas, o embedding é o mesmo.
Roteamento de modelos
Nem toda chamada precisa do modelo mais caro. Roteamento inteligente economiza muito.
Modelos menores pra tarefas simples. Classificação binária, extração de campos simples, reformulação de texto curta. Um modelo pequeno (Haiku, Gemini Flash, GPT-4o-mini) pode custar 10-20 vezes menos que o modelo grande, com qualidade comparável pra tarefas estreitas.
Cascata. Tenta primeiro o modelo pequeno. Se a confiança é alta ou a tarefa simples, aceita. Se não, escalona pro modelo grande. Combina economia com qualidade, mas adiciona complexidade.
Modelos locais pra casos específicos. Pra tarefas de alto volume e baixa complexidade (classificação, embeddings), rodar modelo local em GPU pode ser mais barato que API em escala. O ponto de equilíbrio depende do volume; com menos de 100k chamadas/dia, API normalmente vence.
Early exit e limites
Evitar trabalho desnecessário é a otimização mais honesta.
Validação antes da chamada. Se o input obviamente não requer IA (string vazia, dados já estruturados, query com match exato numa base existente), retorne sem chamar o modelo.
Limites de tokens de saída. Configure max_tokens sempre. Se a resposta esperada é de 200 tokens, não deixe o modelo gerar 2000 por acaso.
Limite por sessão. Em agentes com tool use, defina máximo de chamadas por interação. Sem isso, um bug pode gerar dezenas de chamadas sequenciais.
O que tipicamente está errado quando o custo explode
Depois de investigar algumas explosões de custo em sistemas alheios, alguns padrões se repetem.
Retry silencioso em loop. O código tem retry, mas não tem limite claro. Quando o provedor está instável, cada chamada vira 5-10 tentativas. Em volume, a fatura dobra. A correção é retry com limite máximo e backoff exponencial.
Contexto inflado sem necessidade. O time adicionou novos campos ao prompt, aumentou número de chunks no RAG, passou a incluir mais histórico. Cada mudança foi pequena; o efeito composto dobrou o custo por chamada. A correção é revisar o contexto periodicamente e medir qualidade com menos.
Modelo superdimensionado. A feature usa o modelo top pra tarefa que um modelo menor resolveria. Ninguém nunca reavaliou. A correção é testar rebaixar modelo com eval apropriado e trocar se qualidade aguentar.
Falta de cache onde deveria ter. Prompts fixos de 3000 tokens batem toda chamada, sem cache de provider ativo. A correção é ativar caching onde disponível e ver 50-80% de economia na parte cacheada.
Feature sem budget. Ninguém pensou em limite. Quando um cliente abusa ou um bot faz web scraping via sua feature, não há freio. A correção é rate limiting por tenant com alertas.
Conclusão
Custo de IA em produção é uma competência de engenharia que ainda não está madura na maioria dos times. A diferença entre uma feature que custa R$ 0,30 por usuário e uma que custa R$ 3,00 não é o provedor ou o modelo; é o design. Quanto contexto passa, quantas chamadas são feitas, o que é cacheado, o que é validado antes.
A boa notícia é que as técnicas não são complexas. Modelar antes de lançar, observar durante a operação, e aplicar redução onde faz sentido. Nada disso exige PhD em ML. Exige disciplina de tratar custo como requisito de primeira classe, do mesmo jeito que a gente trata latência e taxa de erro.
A pergunta que deveria guiar qualquer decisão de feature de IA é: "se essa feature escalar 10x, o custo escala junto ou explode?" Se a resposta é "explode", o design tem um problema que vai aparecer. Melhor resolver antes, quando ainda dá tempo.
Insights & Takeaways
-
Tokens de entrada costumam dominar a conta em features com RAG e tool use, não tokens de saída. Otimizar só geração e ignorar contexto é atacar o lado errado do problema.
-
Modele custo por usuário por mês antes de lançar. A conta não precisa ser exata; precisa dar ordem de grandeza que permita conversar com o negócio antes da fatura chegar.
-
Três métricas cobrem a maioria dos cenários de surpresa: custo total por feature por dia, custo médio por interação, custo por tenant. Com elas em dashboard e alertas simples, você detecta anomalia cedo.
-
As técnicas de redução que mais entregam retorno são compressão de contexto (chunks mais precisos, histórico resumido, prompt enxuto) e cache de provider. Roteamento de modelos vem em terceiro.
-
Quando o custo explode, na maioria das vezes é retry sem limite, contexto que foi inflando aos poucos sem revisão, ou modelo superdimensionado pra tarefa. Quase nunca é volume orgânico de uso.