IA First · Episódio 16
Avaliação Contínua: Não Basta Subir o Modelo, Tem Que Medir, Quebrar e Ajustar
Como medir a qualidade de uma feature de IA depois do deploy: eval set vivo, LLM-as-judge calibrado, eval no CI, detecção de drift e feedback do usuário.
Neste artigo · 11 seções
- A diferença entre "deu deploy" e "está funcionando"
- O que significa "qualidade" pra um sistema de IA
- Eval set: o gabarito que você nunca tem mas precisa ter
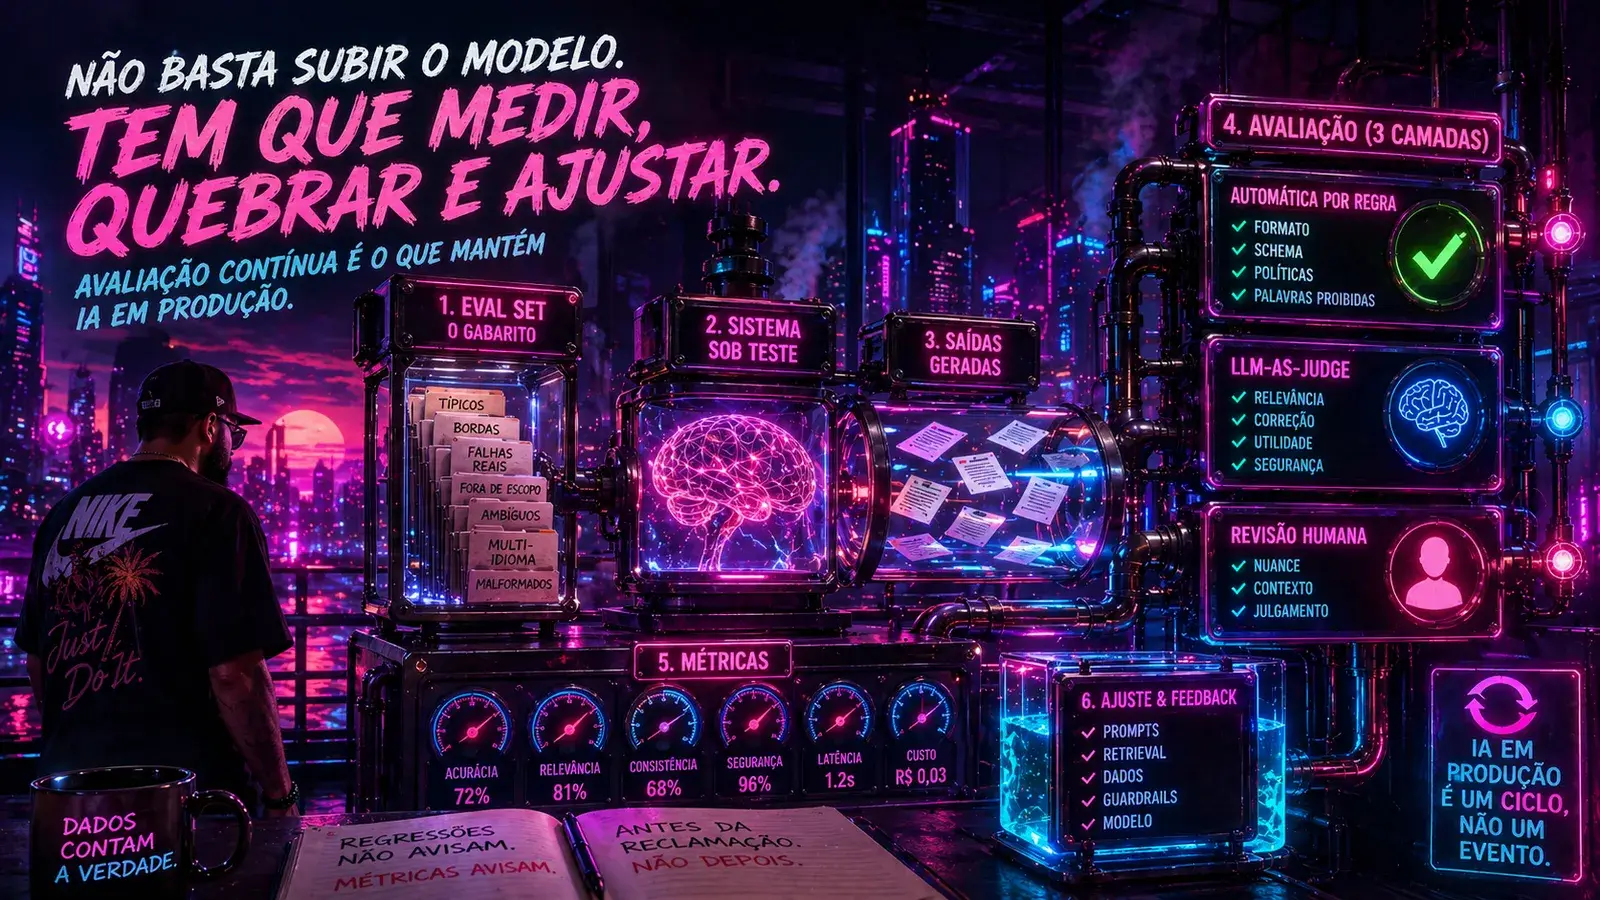
- Métodos de avaliação: três abordagens que se complementam
- Avaliação em CI: rodando antes do deploy
- Drift: o problema que aparece sem ninguém mexer
- Feedback do usuário: a fonte que muita gente subutiliza
- O ciclo completo de avaliação contínua
- O que erra mais nessa disciplina
- Conclusão
- Insights & Takeaways
A diferença entre "deu deploy" e "está funcionando"
Tem uma cultura ruim que se espalhou em projetos de IA: tratar o lançamento de uma feature como se fosse o fim do trabalho. O time integra o modelo, ajusta o prompt até a demo ficar boa, faz alguns testes manuais com casos típicos, e dá deploy. A partir daí, a feature "está em produção". A próxima vez que alguém olha pra ela com atenção é quando algum usuário reclama, ou quando alguém percebe que o número da feature caiu sem motivo claro.
Esse modelo funcionava razoavelmente bem em sistemas determinísticos. Se o código não mudou e o input não mudou, o output não muda. Quebra é exceção, não regra. Com IA, a premissa cai por terra. O comportamento do sistema pode mudar sem ninguém ter feito nada: o provedor atualizou o modelo silenciosamente, a distribuição dos inputs dos usuários evoluiu, um documento novo foi adicionado ao índice e degradou o retrieval. Tudo isso é invisível pro monitoramento tradicional.
Esse artigo é sobre como tratar IA em produção como o que ela é: um sistema vivo que precisa de avaliação contínua, não de deploy-e-esquece. Como medir qualidade depois que está rodando, como detectar regressões antes do usuário, e como criar um ciclo de ajuste que não dependa de reclamação.
O que significa "qualidade" pra um sistema de IA
Antes de medir, é preciso definir o que se mede. Qualidade num sistema de IA tem várias dimensões, e elas não se resumem em "o modelo acerta?".
Acurácia funcional é o mais óbvio. A classificação está certa? A extração capturou os campos corretos? A resposta corresponde aos documentos de contexto? Isso pode ser medido contra um gabarito, quando você tem.
Relevância é mais sutil. A resposta foi útil pro que o usuário queria? Pode estar tecnicamente correta e mesmo assim não responder a pergunta de fato. "Qual o prazo de devolução?" recebendo "Os prazos estão definidos na política da empresa" é correto e inútil.
Consistência é o que mantém confiança. A mesma pergunta, em momentos diferentes, deveria gerar respostas equivalentes. Se na segunda-feira o sistema diz "30 dias" e na quarta diz "45 dias" pra mesma situação, o usuário perde a fé no sistema.
Segurança e conformidade. A resposta vazou dado sensível? Cumpriu políticas de tom? Recusou pedido que deveria recusar?
Custo e latência também são qualidade, embora a gente costume tratar separado. Uma resposta correta que demora 12 segundos e custa R$ 0,50 pode ser pior, na prática, que uma resposta levemente menos precisa em 1 segundo e R$ 0,02.
A escolha de quais dimensões priorizar depende do caso de uso. Pra um chatbot de suporte, relevância e custo dominam. Pra extração de dados em contrato, acurácia funcional é tudo. Pra geração de conteúdo, consistência e segurança importam mais.
Eval set: o gabarito que você nunca tem mas precisa ter
A base de qualquer avaliação séria é um conjunto de exemplos com gabarito. Em ML clássico, isso é trivial: dataset de teste com label. Com LLM, fica mais complexo porque saídas são texto livre, mas o conceito é o mesmo.
Um eval set é uma coleção de inputs com saídas esperadas (ou critérios de aceitação) que representa os casos que importam. Não precisa ser gigante; precisa ser representativo. Cinquenta exemplos bem escolhidos batem cinco mil exemplos aleatórios.
Na construção, alguns princípios funcionam:
Inclua casos típicos e casos de borda. Casos típicos validam que o sistema funciona pro fluxo principal. Casos de borda quebram o sistema de formas interessantes. Inputs ambíguos, perguntas fora de escopo, dados malformados, idiomas misturados, conteúdo tentando manipular o modelo.
Inclua casos que já falharam em produção. Cada vez que você descobre uma falha real (via reclamação, log, revisão), adicione esse caso ao eval set. O eval cresce com a operação.
Mantenha versão. O eval set é um artefato. Tem versão. Tem owner. Tem changelog. Mudanças no eval set afetam medição; precisa ser rastreável.
Separe por dimensão. Um sub-conjunto pra acurácia, outro pra segurança, outro pra cobertura de domínio. Isso permite medir cada dimensão isoladamente e detectar regressões específicas.
Pra muitas tarefas, os critérios de aceitação são mais úteis que respostas exatas. Em vez de "a resposta deve ser literalmente X", o critério vira "a resposta deve mencionar o prazo de 30 dias", "a resposta não deve recomendar produto fora do catálogo", "a resposta deve estar em português".
Métodos de avaliação: três abordagens que se complementam
Existem três formas principais de medir qualidade de saída de IA, e a escolha depende do volume, do orçamento e da natureza da tarefa.
Avaliação humana é o padrão ouro. Pessoas qualificadas avaliam saídas contra critérios. É preciso, capta nuance, mas é caro e lento. Funciona bem como revisão amostral periódica e pra calibrar os outros métodos.
Avaliação automática por regra é o oposto: rápida, barata, limitada. Verifica formato, presença de campos, conformidade com schema, ausência de palavras proibidas. É boa pra checks objetivos e ruim pra qualidade subjetiva. Sempre vale ter, mas raramente é suficiente sozinho.
LLM-as-judge é o intermediário. Você usa um LLM (geralmente um modelo forte) pra avaliar a saída de outro. Define critérios em prompt ("essa resposta é relevante pra essa pergunta? Justifique."), passa pro modelo, captura o veredito. Escala bem, custa moderado, capta nuance razoavelmente bem. O cuidado é que o juiz também é falível, e calibrar contra avaliação humana periódica é necessário.
Na prática, um pipeline maduro combina os três:
A revisão humana amostral existe pra calibrar e validar que o LLM-judge está alinhado. Sem isso, você corre o risco de o juiz aprovar saídas que humanos rejeitariam, ou vice-versa, e nunca perceber.
Avaliação em CI: rodando antes do deploy
Toda mudança que afeta o comportamento do sistema (mudança de prompt, troca de modelo, atualização de configuração de RAG, novo conjunto de tools) deveria passar pelo eval set antes de ir pra produção. Não porque o eval garante que tudo está bom, mas porque ele garante que regressões óbvias não passam.
A integração é parecida com testes unitários. O pipeline de CI roda o eval set contra a versão proposta, gera métricas, compara com o baseline, e bloqueia o deploy se a regressão for significativa.
O threshold importa. Se você bloqueia qualquer queda, o time vai aprender a ignorar o sinal porque pequenas variações são naturais. Um threshold razoável é algo como "não pode cair mais de 3% nas métricas-chave" ou "não pode quebrar nenhum caso crítico".
Casos críticos são exemplos do eval set marcados como "se esses falharem, é incidente". Tipicamente cobrem regulatório, segurança, e cenários de alto impacto pro usuário. Esses não admitem regressão zero, não 3%.
Drift: o problema que aparece sem ninguém mexer
Drift é a mudança de comportamento ao longo do tempo, sem alteração explícita no sistema. É o tipo de problema que mata projetos de IA porque não dispara alertas tradicionais. O CPU está normal. A latência está normal. A taxa de erro 5xx está zero. Mas a qualidade das respostas caiu.
Existem três tipos principais de drift que afetam sistemas com LLM.
Drift de modelo. O provedor atualiza o modelo subjacente. As vezes silenciosamente. "claude-3-5-sonnet" pode comportar levemente diferente em uma janela de tempo sem mudança de versão visível. Provedores costumam avisar mudanças grandes, mas otimizações menores acontecem o tempo todo.
Drift de dados de entrada. A distribuição do que os usuários mandam evolui. Você desenhou o sistema pra responder dúvidas sobre cinco produtos; agora o catálogo tem dez e o sistema continua otimizado pros cinco originais. Não há erro técnico, há descompasso entre o sistema e o uso real.
Drift de base de conhecimento. Em RAG, documentos novos são adicionados, antigos são removidos, versões são atualizadas. O comportamento do retrieval muda. Chunks que antes eram retornados agora competem com chunks novos parecidos. Respostas antes consistentes começam a oscilar.
Detectar drift exige rodar o eval set periodicamente, não só no CI. Uma vez por dia, ou uma vez por semana, dependendo do quão crítico é. As métricas são comparadas com baseline histórico, e desvios significativos disparam investigação.
Outra abordagem é monitorar características das interações em produção: distribuição de tipos de pergunta, comprimento médio das respostas, taxa de "não sei" do sistema, taxa de tool calls. Se alguma dessas distribuições muda significativamente, é sinal de que algo no comportamento mudou.
Feedback do usuário: a fonte que muita gente subutiliza
O usuário é o avaliador final. Capturar o feedback dele de forma estruturada é uma das melhores fontes de sinal sobre qualidade real.
Feedback explícito é o que o usuário oferece deliberadamente. Thumbs up/down nas respostas, rating, formulário, campo de comentário. É preciso mas tem volume baixo, porque a maioria dos usuários não dá feedback voluntário.
Feedback implícito é mais abundante. O usuário aceitou a sugestão? Editou antes de usar? Refez a pergunta de outra forma? Abandonou a interação? Cada um desses é sinal. Aceitar é sinal positivo. Editar é sinal de correção parcial (a base estava certa, faltou algo). Refazer a pergunta é sinal de que a primeira resposta não satisfez. Abandonar é sinal de frustração.
Capturar esses sinais exige instrumentação no produto. Cada interação tem um ID. Cada ação subsequente do usuário (aceita, edita, descarta, refaz) é registrada com referência a esse ID. Em volume, esses dados viram a melhor base pra entender qualidade real, muito melhor que eval set artificial.
Um detalhe importante: feedback negativo é mais valioso que positivo. Quando o usuário marca thumbs down, ele está apontando exatamente onde o sistema falha. Esses casos deveriam virar exemplos no eval set automaticamente, depois de revisão. Assim, o sistema aprende com falhas reais, não só com casos que alguém imaginou.
O ciclo completo de avaliação contínua
Juntando tudo, a avaliação contínua se parece com um ciclo:
Esse ciclo é o que separa um sistema de IA mantido de um sistema de IA esquecido. Não é pesado se está embutido nos processos do time. É pesado quando você tenta fazer só quando aparece problema.
O que erra mais nessa disciplina
Alguns padrões aparecem com frequência em times que estão começando a estruturar avaliação contínua.
Eval set criado uma vez e abandonado. Foi montado no início, com 30 exemplos, e nunca mais cresceu. Em poucos meses, o eval não representa mais o que acontece em produção. Eval set vivo cresce com o sistema.
Confiar 100% em LLM-as-judge sem calibração humana. O juiz vira oráculo, e ninguém percebe quando ele aprova coisas que não deveria. Revisão humana amostral é manutenção, não overhead.
Métricas só de acurácia, sem custo e latência. Sistema "melhorou" 5% em qualidade, mas o custo dobrou e a latência subiu 80%. Essa "melhoria" pode ser regressão na prática, dependendo do caso.
Sem versionamento do eval set. Mudanças no eval afetam comparações históricas. Sem versão, você não sabe se a queda na métrica é regressão real ou eval ficou mais difícil.
Feedback do usuário capturado mas nunca incorporado. Cada thumbs down é uma oportunidade que vira lixo se não vira melhoria. Sem processo claro pra revisar feedback negativo e atualizar sistema/eval, o sinal se perde.
Conclusão
Avaliação contínua não é luxo. É o equivalente, pra IA, do que monitoramento e SRE são pra microserviços. Você não roda sistema distribuído em produção sem dashboard, alertas e processo de incidente. Pelo mesmo motivo, não deveria rodar feature de IA sem eval set, métricas de qualidade rodando periodicamente, e ciclo de ajuste baseado em sinal.
A boa notícia é que muito do que precisa estar no lugar é processo, não tecnologia exótica. Eval set num arquivo versionado, pipeline que roda no CI, dashboard que junta métricas, processo que incorpora feedback. Não é trivial, mas é fazível com as ferramentas que o time já usa.
A pergunta que vale ter sempre na cabeça: "se o comportamento desse sistema degradar amanhã, eu vou descobrir antes do usuário?" Se a resposta é não, a infraestrutura de avaliação tem uma lacuna que vai virar problema em algum momento. Melhor preencher antes de descobrir do jeito difícil.
Insights & Takeaways
-
Sistemas com LLM degradam sem ninguém mexer. Drift de modelo, drift de inputs, drift de base de conhecimento. Sem avaliação periódica, a queda só aparece via reclamação de usuário, e aí é tarde.
-
Eval set é artefato vivo, com versão, owner e crescimento contínuo. Cada falha real em produção deveria virar caso no eval depois de revisão. Sem isso, o eval envelhece e perde representatividade.
-
Combine os três métodos de avaliação: automática por regra (objetivos), LLM-as-judge (escala), humana amostral (calibração). Confiar só em um deixa pontos cegos.
-
Feedback implícito do usuário (aceitou, editou, refez, abandonou) é mais abundante e mais útil que feedback explícito. Mas só serve se o produto está instrumentado pra capturar.
-
Avaliação contínua é processo, não ferramenta. Eval rodando no CI, métricas em dashboard, revisão periódica de feedback negativo, ciclo claro pra incorporar mudanças. Sem o processo, ferramentas viram dashboards mortos.