IA First · Episódio 25
Linhas de Produção de IA: Do Git ao Experimento em Produção em Poucos Passos Confiáveis
CI/CD para IA: como versionar código, prompts, modelo e eval set juntos, testar no pipeline, fazer shadow e canary e ter um rollback que funciona.
Neste artigo · 11 seções
- O que esse artigo não vai repetir
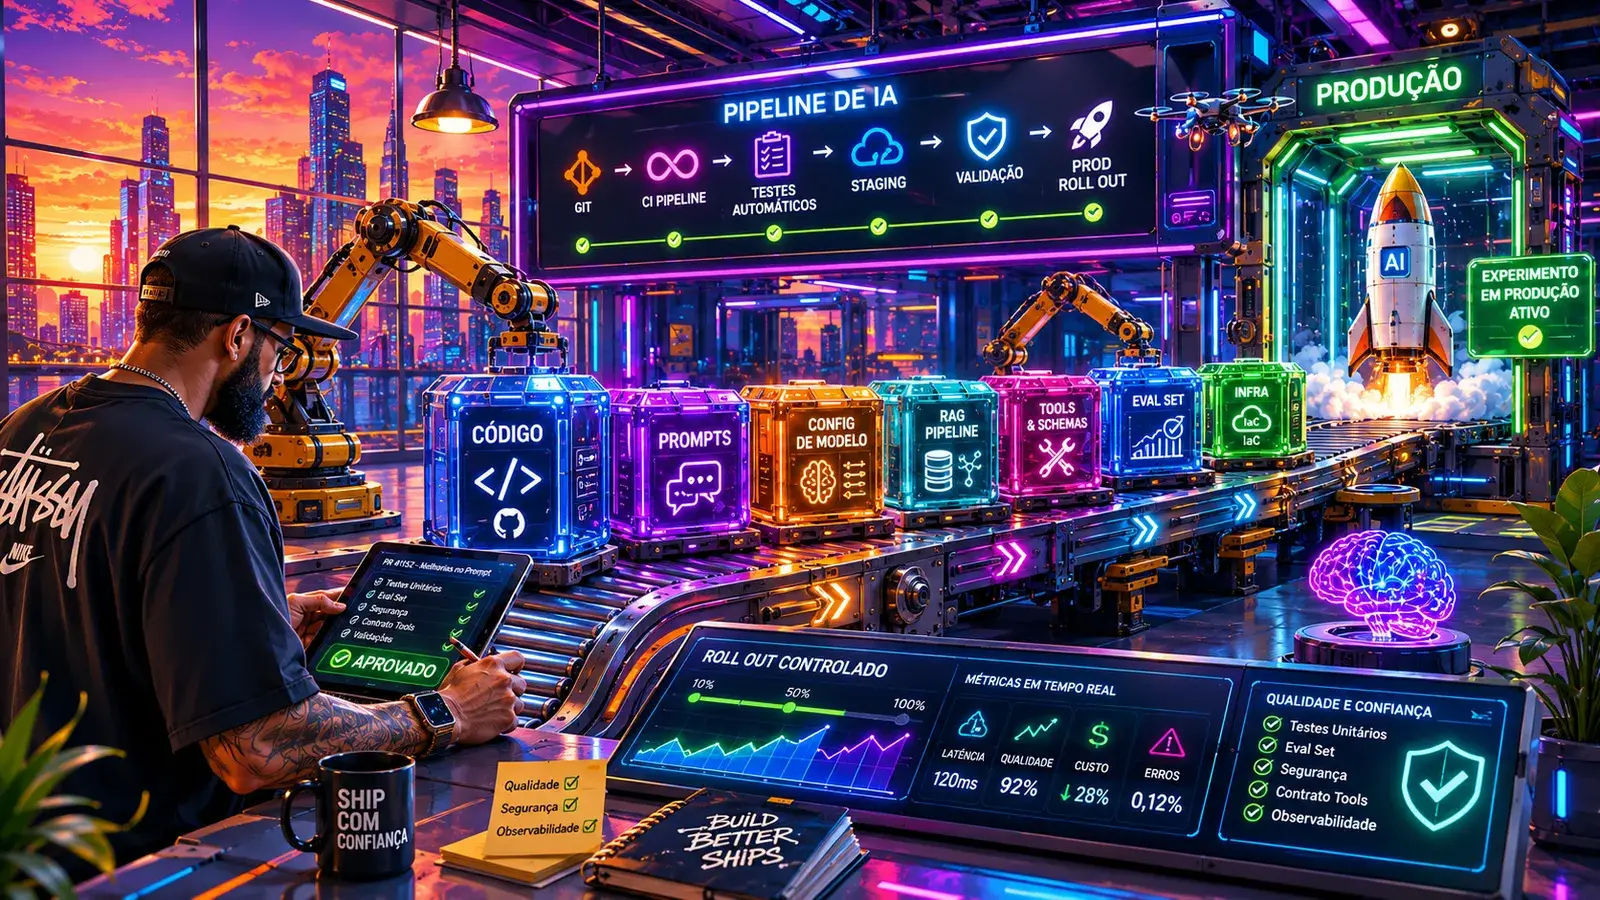
- Os artefatos que precisam fluir juntos
- O que muda nos testes automatizados
- Ambientes: dev, staging, produção, com particularidades
- Rollout controlado: as estratégias específicas
- Rollback: o problema mais complicado que em sistema tradicional
- Reprodutibilidade: a propriedade que viabiliza tudo
- Auditoria do próprio pipeline
- A relação com governança e o resto do sistema
- Conclusão
- Insights & Takeaways
O que esse artigo não vai repetir
Os artigos anteriores dessa série cobriram peças importantes: arquitetura de backend, governança, avaliação contínua, custo, observabilidade, segurança. Cada um falou de um componente. Esse artigo é sobre o que costura todos eles: a linha de produção que leva uma mudança da branch local até produção, com confiança e rastreabilidade.
A diferença é importante. Você pode ter eval set, governança definida, AI Gateway implementado, e mesmo assim sofrer com deploys que demoram dias, mudanças que entram sem rastreio, rollbacks que não funcionam, e times paralisados por medo de mexer no que está funcionando. O problema aí não é nenhum componente; é a pipeline que conecta tudo.
A boa notícia é que pipeline de IA não é tecnologia exótica. É CI/CD aplicado a um conjunto de artefatos novos, com algumas particularidades. Quem já fez CI/CD funcionar pra serviços tradicionais tem 80% do trabalho conceitual feito. O que muda são os 20% específicos: o que precisa ser versionado junto, como reproduzir um estado, como fazer rollout e rollback de algo que não é só código.
Os artefatos que precisam fluir juntos
Em serviço tradicional, o que flui da branch pra produção é código + configuração. Em sistema com IA, são vários artefatos diferentes que precisam estar sincronizados.
Código da aplicação. O serviço que consome o modelo, monta contexto, processa resposta. Versionado normalmente em Git.
Prompts. Templates de prompt, system prompts, instruções de tools. Como discutido no artigo de arquitetura de backend, idealmente em arquivos separados versionados. Cada prompt tem ID e versão.
Configuração de modelo. Qual modelo é usado, parâmetros (temperatura, max_tokens, top_p), provedor, fallback. Configuração é tão sensível quanto código.
Configuração de pipeline RAG. Estratégia de chunking, modelo de embedding, thresholds de retrieval, fontes de dados ativas.
Tools e seus contratos. Lista de tools disponíveis, schemas, descrições. Mudança aqui afeta comportamento.
Eval set. Casos de teste contra os quais a versão é avaliada. Sem ter o eval junto, não dá pra reproduzir uma medição de qualidade.
Infraestrutura. Definição da infra que sustenta tudo (em IaC). Mudanças em infra podem afetar comportamento (memória, timeout, GPU).
A questão central: quando você diz "versão 2.3.1 da feature X", isso deveria significar uma combinação reproduzível de todos esses artefatos. Não "o código está em 2.3.1, mas o prompt foi atualizado no painel ontem". Sincronia entre artefatos é o que viabiliza tudo o que vem depois.
Cada um desses passos é mais complexo que parece, mas o desenho geral funciona como qualquer pipeline moderna de software.
O que muda nos testes automatizados
Testes em pipeline de IA têm camadas que não existem em serviços tradicionais.
Testes unitários continuam existindo. Validação de schemas, parsing de respostas, conversão de formatos. São rápidos, determinísticos, executam em milissegundos. Cobrem o código ao redor do modelo, não o comportamento do modelo.
Testes de contrato pra tools. Cada tool tem schema de entrada e saída. Mudanças que quebram o contrato precisam ser detectadas antes do merge. Esses testes verificam que mudança no schema é compatível ou que clientes foram atualizados juntos.
Testes de prompt. Sintaxe do prompt (template renderiza sem erro), tokens dentro do limite, variáveis obrigatórias presentes. Validações básicas que evitam que um prompt quebrado vá pra produção.
Eval set. A camada que vimos no artigo de avaliação contínua. Roda a versão proposta contra casos representativos, compara com baseline, bloqueia merge se há regressão significativa. Não vou repetir os detalhes daqui; só registro que essa é a camada mais cara em tempo e custo de execução, e precisa ser desenhada pra não inviabilizar o ciclo de dev.
Testes de segurança específicos. Tentativas de prompt injection que deveriam ser bloqueadas, queries que tentam vazar contexto entre tenants, prompts que tentam fazer o modelo executar ações fora de escopo. Esses testes garantem que regressão de segurança não escorrega.
A combinação executada no CI varia por mudança. Mudança só em código de backend: unitários + contrato. Mudança em prompt: unitários + eval set + segurança. Mudança em tool: unitários + contrato + eval set. Saber qual conjunto rodar pra cada tipo de mudança é o que mantém o pipeline rápido sem perder cobertura.
Ambientes: dev, staging, produção, com particularidades
Pipeline tradicional tem dev, staging, produção. Em IA, isso continua, mas com particularidades em cada um.
Ambiente de dev. O desenvolvedor faz experimentação local. Usa modelo via API com chave de dev, com rate limit baixo e dados sintéticos ou anonimizados. Eval set pode rodar localmente em subset pra feedback rápido. O eval set completo roda no CI, não localmente.
Ambiente de staging. Espelha produção em estrutura, mas com volume reduzido e dados não-reais. Aqui é onde mudanças são validadas com volume suficiente pra detectar problemas que testes unitários e eval set não pegam: latência sob carga, comportamento com dados reais (anonimizados), interação com sistemas adjacentes.
Uma questão sensível em staging de IA: que dados usar? Dados de produção têm PII; dados sintéticos não representam casos reais. As opções viáveis: anonimização robusta de subset de produção (com revisão de segurança); geração de dados sintéticos representativos (com cuidado pra não criar viés); ou um ambiente "pre-prod" com volume controlado de tráfego real espelhado, com proteções rigorosas.
Ambiente de produção. O modelo de fato em uso. Aqui entram técnicas de rollout controlado que vão além do simples deploy.
A promoção entre ambientes precisa preservar a sincronia de artefatos. Se a versão 2.3.1 foi aprovada em staging, é a mesma combinação exata de código, prompts, configurações, eval set, e infraestrutura que vai pra produção. Não dá pra promover só o código e ficar com prompt de staging em prod, ou vice-versa.
Rollout controlado: as estratégias específicas
Deploy direto pra 100% da produção é receita pra problema em IA. O comportamento de um modelo só fica visível em escala, com dados reais, em interações reais. Rollout controlado é como você descobre problema com exposição limitada.
Existem três estratégias principais, com graus diferentes de proteção.
Shadow mode. A versão nova roda em paralelo com a antiga, mas só a antiga responde ao usuário. Os resultados da nova são logados pra comparação. Latência percebida pelo usuário não muda; o usuário nem sabe que existe uma versão nova rodando. É a estratégia mais segura porque erro do shadow não afeta ninguém. Custa o dobro de tokens durante a janela de shadow, mas dá dados reais antes de qualquer exposição.
Canary release. A versão nova recebe uma fração pequena do tráfego real (1%, 5%, 10%). Métricas de qualidade e latência são monitoradas. Se tudo correr bem, a fração cresce gradualmente. Se algo destoa, rollback automático ou manual. É menos seguro que shadow (usuários do canary recebem a versão nova), mas dá feedback real de qualidade percebida.
Blue-green com switch. Duas versões coexistem; o roteamento decide quem responde a cada request. A versão nova começa sem tráfego, recebe gradualmente, e em caso de problema, o switch volta tudo pra versão antiga em segundos. Útil quando rollback rápido é crítico.
A combinação que costuma funcionar pra mudanças significativas: shadow durante alguns dias pra coletar comparação; canary com fração crescente por mais alguns dias; rollout completo com monitoramento reforçado. Cada etapa tem critérios de promoção explícitos: "se métrica X não destoa em mais de Y%, promover; se destoa, investigar".
Rollback: o problema mais complicado que em sistema tradicional
Rollback em sistema tradicional é razoavelmente simples: volta pra commit anterior, redeploy, fim. Em sistema com IA, rollback é mais sutil porque envolve mais artefatos.
Considere o cenário. A versão 2.3.1 foi pra produção. Métricas caem. Você quer voltar pra 2.3.0. Mas:
A 2.3.1 inclui um prompt novo. Voltar o código sem voltar o prompt mantém o problema.
A 2.3.1 ativou uma nova tool. Voltar requer desativar a tool.
A 2.3.1 adicionou documentos no índice RAG. Voltar requer reverter o índice ou marcar esses documentos como inativos.
A 2.3.1 trocou o modelo subjacente. Voltar requer voltar a configuração de modelo.
Rollback funcional exige que toda essa combinação volte junto. Por isso a sincronia de artefatos é tão crítica: se a versão 2.3.0 é uma combinação reproduzível identificável, rollback é executar essa combinação. Se a versão 2.3.0 é "ah, o código de duas semanas atrás com talvez aquele prompt antigo", rollback é uma investigação no escuro.
Algumas práticas que ajudam:
Rollback testado como parte do processo. Antes de promover pra produção, valide que rollback funciona. Reverter para a versão anterior em staging, confirmar que tudo opera, e só então promover. Rollback não testado é rollback que falha quando você precisa.
Janela de capacidade pra rollback. Não deletar imediatamente versões antigas. Mantenha as últimas N versões disponíveis pra rollback rápido por algum tempo após cada deploy.
Rollback parcial. Em alguns casos, dá pra reverter parte do sistema (só o prompt, por exemplo) sem reverter o restante. Isso exige que cada artefato tenha versão independente e que o roteador possa compor versões diferentes.
Plano de rollback documentado por feature. Pra cada feature, está documentado o procedimento exato de rollback? Quem aciona, quais comandos, em qual ordem? Sem isso, rollback no meio de incidente vira improviso.
Reprodutibilidade: a propriedade que viabiliza tudo
Reprodutibilidade é a capacidade de, dado um identificador de versão, reconstruir exatamente o estado do sistema que existia. Não "mais ou menos parecido"; exatamente.
Em produção tradicional, isso significa: dado um commit, eu reconstruo o binário e a configuração. Em IA, exige mais: dado um identificador de versão, eu reconstruo o código, os prompts, as configurações, o índice RAG (versão exata dos documentos), o modelo subjacente (versão exata, mesmo de provedor), o eval set usado pra validação, e a infraestrutura.
Por que isso importa? Pelo menos três razões.
Auditoria. Quando alguém pergunta "como o sistema se comportou no dia X?", você precisa conseguir voltar a esse estado. Pra justificar uma decisão automatizada com base em informações que existiam naquele momento, reprodução é essencial.
Investigação de incidente. Incidente aconteceu numa versão específica. Pra entender por que, reproduzir o cenário é o caminho mais direto. Sem reprodutibilidade, investigação fica em hipóteses.
Comparação de versões. Pra entender se versão B é melhor que versão A, você precisa rodar ambas no mesmo eval set, na mesma infraestrutura, com os mesmos dados. Sem reprodutibilidade, comparações são suspeitas.
Atingir reprodutibilidade total nem sempre é viável (modelos de provedor podem mudar silenciosamente, por exemplo). Mas reprodutibilidade prática, suficiente pra os usos acima, é fazível com disciplina de versionamento.
Auditoria do próprio pipeline
A pipeline em si gera dados que importam pra governança. Quem aprovou cada promoção, quais testes rodaram, quais resultados deram, quem mergeou o código, quem rodou o deploy. Tudo isso é registro auditável.
Algumas perguntas que o registro do pipeline deveria responder:
Quem propôs essa mudança? Quem fez code review? Quem aprovou o merge?
Qual o resultado de cada teste no momento do merge? Em qual versão do eval set?
Quem promoveu pra staging? Quem promoveu pra produção?
Quando começou o rollout? Em que fração? Quem aprovou cada incremento?
Houve rollback? Quando? Por que? Quem decidiu?
Em sistemas maduros, esses dados ficam disponíveis na ferramenta de CI/CD (GitHub Actions, GitLab CI, Jenkins) com retenção apropriada, e podem ser correlacionados com logs de produção pra investigação. Cruzando "quando entrou a versão Y" com "incidente registrado na semana Z", você responde rapidamente "esse incidente está relacionado a essa mudança?".
A relação com governança e o resto do sistema
A pipeline conecta tudo o que os outros artigos discutiram. Eval set roda nela. Aprovação de governança (do artigo anterior) é gate dentro dela. Métricas de custo (de outro artigo) começam a ser coletadas nela. AI Interaction Log (da arquitetura de backend) é populado por código que veio através dela.
Isso significa que pipeline robusta é multiplicador: ela faz tudo o que já discutimos funcionar de forma sustentável. Pipeline fraca é o oposto: faz cada componente bem desenhado sofrer porque a integração entre eles é frágil.
A imagem mental útil: pipeline é o sistema circulatório. Os outros componentes são órgãos. Cada órgão pode ser perfeito, mas se o sistema circulatório falha, nada funciona como deveria.
Conclusão
Linhas de produção de IA não são reinvenção do CI/CD. São aplicação do CI/CD aos artefatos novos que IA traz: prompts, modelos, configurações, eval sets, índices. As práticas que tornaram DevOps maduro (versionamento, ambientes, testes automatizados, rollout controlado, rollback testado, auditoria) se aplicam, com ajustes específicos.
A diferença entre time que opera IA com confiança e time que sofre a cada mudança está nessa pipeline. Time que tem pipeline robusta consegue evoluir rápido sem medo, porque sabe que se algo der errado, vai detectar cedo e reverter rápido. Time que tem pipeline frágil evolui devagar, com medo, porque cada mudança é risco e cada rollback é improviso.
A pergunta que orienta bem: "do commit local até produção, quantos passos confiáveis existem, e em quanto tempo um problema é detectável e reversível?" Quanto menor o número de passos manuais, mais confiável é cada um, e mais curto o ciclo de detecção e reversão, mais madura é a operação.
Insights & Takeaways
-
Pipeline de IA precisa fazer fluir junto vários artefatos sincronizados: código, prompts, configurações, eval set, infraestrutura. Versão da feature é a combinação exata desses artefatos, não só do código.
-
Testes em pipeline de IA têm camadas além das unitárias: contrato de tools, validação de prompt, eval set, testes de segurança específicos. A combinação executada deveria variar por tipo de mudança pra manter velocidade sem perder cobertura.
-
Rollout controlado (shadow, canary, blue-green) é como você descobre problema com exposição limitada. Deploy direto pra 100% em IA é receita pra incidente porque o comportamento só fica visível em escala real.
-
Rollback em IA é mais complicado que em sistema tradicional porque envolve reverter combinação de artefatos. Rollback não testado é rollback que falha; testar reversão antes de promover é parte do processo, não opcional.
-
Reprodutibilidade prática é o que viabiliza auditoria, investigação de incidente e comparação de versões. Dado um identificador de versão, conseguir reconstruir o estado exato (com limites realistas) é capacidade que separa operação madura de operação no escuro.