IA First · Episódio 26
Orquestração Multi-Modelo e Multi-Provedor: Não Coloque Todos os Tokens na Mesma Cesta
Por que depender de um só provedor de LLM é risco de negócio e como reduzi-lo com camada de abstração, roteamento por tenant e feature e benchmark contínuo.
Neste artigo · 10 seções
- O que esse artigo acrescenta
- Os riscos concretos de provedor único
- A camada de abstração: o que torna tudo possível
- Roteamento dinâmico: além da complexidade da tarefa
- Regras por tenant e por feature: a granularidade que importa
- Benchmarking constante: a disciplina que mantém o roteamento bom
- O efeito colateral comercial: poder de negociação
- O custo da estratégia: quando não vale
- Conclusão
- Insights & Takeaways
O que esse artigo acrescenta
Já falamos de arquiteturas híbridas (misturar modelos grandes, pequenos e regras pela complexidade da tarefa) e de fallback em baixa latência (o que fazer quando o provedor falha no momento da chamada). Esse artigo é sobre uma camada diferente: a estratégia de não depender de um único provedor, e a arquitetura e operação que tornam isso real.
A diferença de ângulo importa. Arquitetura híbrida é sobre escolher a ferramenta certa pra cada problema dentro do seu sistema. Multi-provedor é sobre não ser refém de uma empresa externa que você não controla. São motivações diferentes que levam a decisões diferentes.
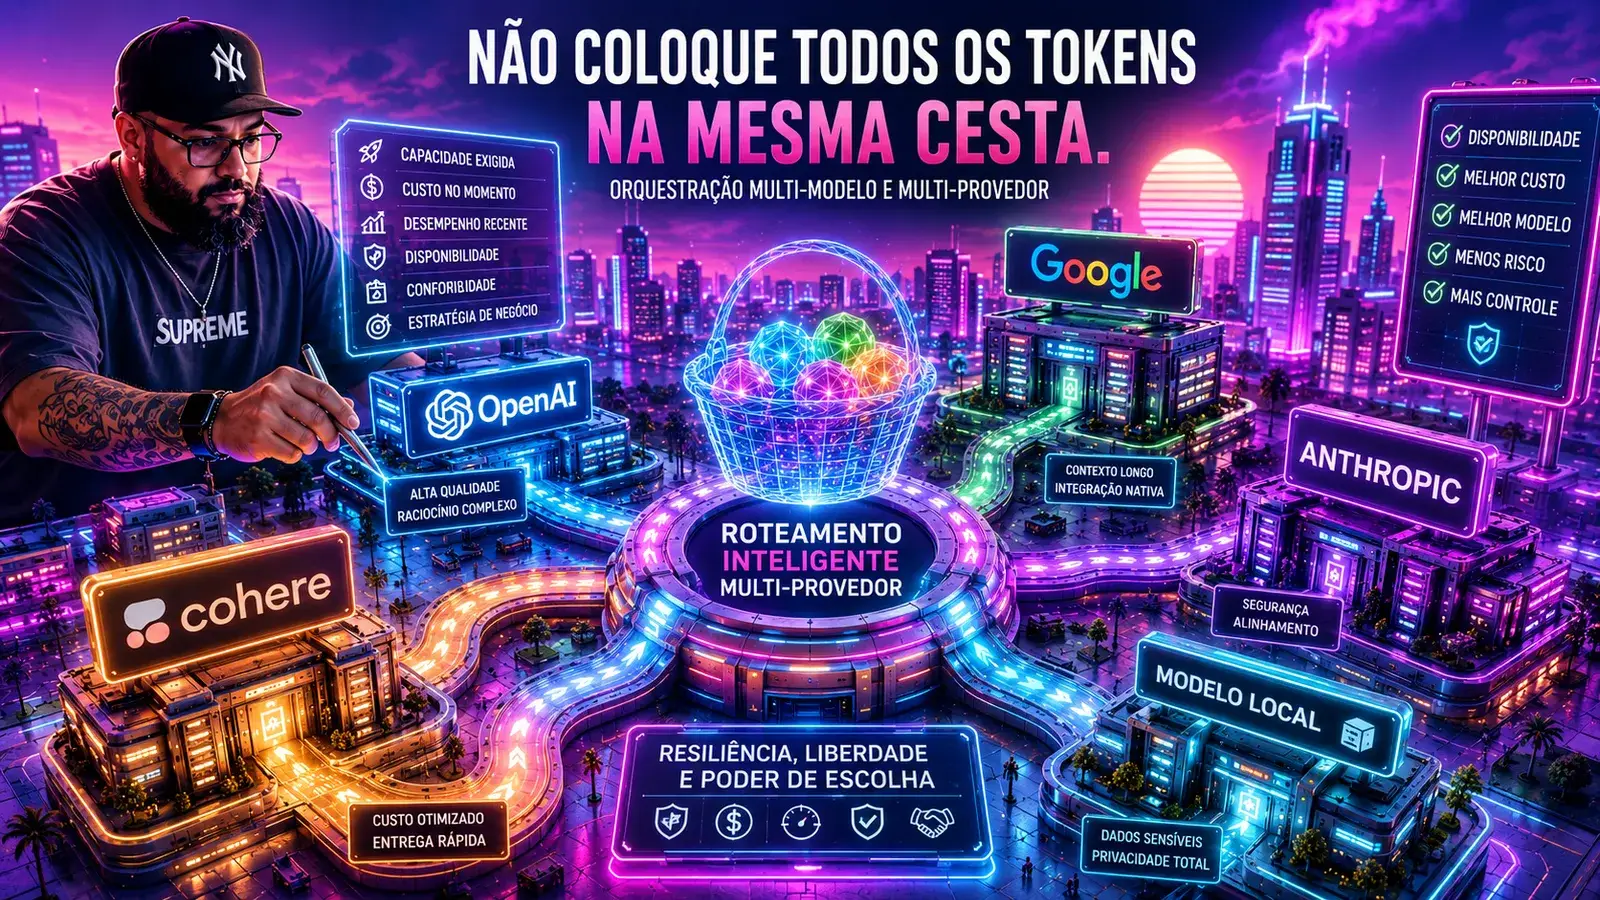
O ponto central é de risco. Quando toda a sua operação de IA depende de um único provedor, você está exposto a coisas fora do seu controle: o provedor muda preço, muda termos, degrada o modelo, tem instabilidade, descontinua a versão que você usa, ou simplesmente fica indisponível numa janela crítica. Cada uma dessas é um risco de negócio real, e a forma de mitigar é não colocar todos os tokens na mesma cesta.
Os riscos concretos de provedor único
Antes de discutir solução, vale ser específico sobre o que se está mitigando. Dependência de provedor único expõe a empresa a vários riscos reais.
Risco de disponibilidade. Provedores de IA têm incidentes. Quando o provedor fica fora, e você só tem ele, a sua feature fica fora junto. Em features críticas, isso é inaceitável. Mesmo features não-críticas ficam mal quando a IA "para de funcionar" do ponto de vista do usuário.
Risco de preço. O provedor pode mudar a tabela de preços. Você dimensionou o negócio com base num custo, e ele sobe. Sem alternativa pronta, você não tem poder de negociação nem caminho de migração rápido.
Risco de mudança de comportamento. Provedores atualizam modelos. Como vimos no artigo de avaliação contínua, isso causa drift. Se você depende de um modelo e ele muda, seu sistema muda junto, sem você ter pedido. Com alternativa pronta, você pode trocar pro modelo que se comporta como você precisa.
Risco de descontinuação. Modelos são aposentados. O provedor avisa que a versão X será descontinuada em alguns meses. Se você só tem ela e não tem caminho de migração, vira corrida contra o relógio.
Risco de termos e compliance. O provedor pode mudar termos de uso, política de retenção, ou condições que afetam seu compliance. Se isso vira incompatível com suas necessidades, você precisa de saída.
Risco de poder de negociação. Esse é o mais sutil. Se o provedor sabe que você não tem alternativa, você não tem poder na mesa de negociação. Ter arquitetura multi-provedor pronta muda a conversa comercial completamente.
Nenhum desses riscos é hipotético. Todos já aconteceram, com vários provedores, em vários momentos. A pergunta não é "será que vai acontecer?", é "quando acontecer, eu tenho alternativa?".
A camada de abstração: o que torna tudo possível
A base de qualquer estratégia multi-provedor é uma camada de abstração que desacopla seu código do provedor específico. Sem isso, trocar de provedor é refactor em todo o codebase. Com isso, é mudar uma configuração.
Essa camada é uma evolução do AI Gateway que discutimos no artigo de arquitetura de backend. Lá, o foco era centralizar chamadas, adicionar retry, logging, rate limiting. Aqui, o foco adicional é abstrair as diferenças entre provedores pra que eles sejam intercambiáveis.
O conceito é uma interface interna única que o seu código usa, independente de qual provedor está por trás:
Cada adaptador traduz a interface interna pra API específica do provedor. O seu código sempre chama a interface interna; nunca sabe qual provedor está respondendo. Trocar de provedor é trocar qual adaptador é usado, não mexer no código de aplicação.
O desafio dessa camada é que provedores não são idênticos. Eles diferem em:
Formato de API. Estrutura de request e response, nomes de campos, formato de tool calls. O adaptador normaliza isso.
Capacidades. Tamanho de contexto, suporte a tool use, suporte a structured output, modos de streaming. Nem todo provedor suporta tudo. A abstração precisa lidar com isso, seja oferecendo o denominador comum, seja sinalizando capacidades por provedor.
Tokenização. Cada modelo conta tokens de forma diferente. O mesmo texto tem contagem diferente em modelos diferentes. Isso afeta custo e limite de contexto.
Comportamento. Mesmo prompt gera respostas diferentes em modelos diferentes. Isso significa que trocar de provedor não é totalmente transparente; o prompt pode precisar de ajuste. Vamos voltar nisso.
Construir essa camada de abstração tem custo de engenharia, e por isso não vale pra todo mundo. Mas pra quem opera IA em escala ou em contexto crítico, é o investimento que viabiliza tudo o resto.
Roteamento dinâmico: além da complexidade da tarefa
No artigo de arquiteturas híbridas, falamos de roteamento por dificuldade da tarefa. Aqui o roteamento ganha dimensões novas, porque agora você roteia entre provedores, não só entre tamanhos de modelo.
As dimensões de decisão de roteamento se expandem:
Por capacidade exigida. A tarefa precisa de contexto muito longo? Roteia pro provedor que oferece isso. Precisa de tool use sofisticado? Roteia pro que faz melhor. Precisa de structured output garantido? Pro que suporta nativamente.
Por custo no momento. Provedores têm preços diferentes pra capacidades equivalentes. Se dois provedores resolvem a tarefa com qualidade similar, roteia pro mais barato. Isso pode ser dinâmico, ajustando conforme tabelas mudam.
Por latência observada. Se um provedor está com latência degradada agora (medida em tempo real), roteia o tráfego pra outro. Isso conecta com o circuit breaker por latência que discutimos no artigo de baixa latência, mas agora com destino alternativo em vez de só fallback determinístico.
Por disponibilidade. Provedor primário fora? Roteia pro secundário automaticamente.
Por tenant ou cliente. Alguns clientes podem ter requisitos específicos. Cliente em setor regulado que exige processamento em jurisdição específica vai pro provedor que atende. Cliente enterprise com SLA premium vai pro provedor mais confiável. Cliente em plano básico vai pro mais barato.
Por feature. Features diferentes podem ter provedores preferenciais. A feature de geração criativa usa um modelo; a de extração estruturada usa outro; a de classificação usa um terceiro, possivelmente local.
O roteador não precisa ser complexo desde o início. Pode começar com regras simples ("feature X usa provedor A, com fallback pra B") e evoluir pra roteamento dinâmico conforme a necessidade aparece.
Regras por tenant e por feature: a granularidade que importa
Em produtos multi-tenant, a capacidade de aplicar regras de roteamento por tenant é particularmente valiosa.
Considere um produto SaaS com clientes variados. Um cliente é um banco que exige que os dados sejam processados por um provedor específico com cláusulas de compliance rigorosas. Outro é uma startup que prioriza custo baixo. Outro tem um SLA premium e quer a melhor qualidade independente de custo.
Com regras por tenant, o mesmo produto atende os três de formas diferentes:
Tenant banco-xyz:
  provider: provedor-com-compliance-bancario
  fallback: nenhum (compliance não permite)
  data_residency: brasil

Tenant startup-abc:
  provider: provedor-mais-barato
  fallback: segundo-mais-barato
  optimize_for: custo

Tenant enterprise-premium:
  provider: provedor-melhor-qualidade
  fallback: segundo-melhor
  optimize_for: qualidade
Isso permite atender requisitos contratuais e comerciais distintos sem ter produtos separados. A mesma base de código, com configuração de roteamento por tenant, serve necessidades diferentes.
Regras por feature seguem lógica similar. Cada feature declara seus requisitos (capacidades necessárias, prioridade de custo vs. qualidade, tolerância a latência), e o roteamento respeita isso. A feature de geração de relatório complexo pode aceitar latência maior por melhor qualidade; a de autocomplete precisa de latência mínima.
Benchmarking constante: a disciplina que mantém o roteamento bom
Decisões de roteamento se baseiam em premissas: esse provedor é melhor pra essa tarefa, esse é mais barato, esse tem menor latência. Mas premissas envelhecem. Provedores melhoram, lançam modelos novos, mudam preços. O roteamento que era ótimo há seis meses pode estar subótimo hoje.
Benchmarking constante é a prática de medir continuamente o desempenho de cada provedor nas suas tarefas reais, pra manter as decisões de roteamento atualizadas.
Como funciona na prática:
Eval set por tarefa (do artigo de avaliação contínua) roda periodicamente contra cada provedor disponível. Você descobre qual provedor entrega melhor qualidade em cada tipo de tarefa, com dados atuais, não com impressão de meses atrás.
Métricas de produção por provedor. Latência, custo, taxa de erro, taxa de aceitação do usuário, segmentadas por provedor. Isso mostra o desempenho real, não o prometido.
Comparação contínua. Quando um provedor lança um modelo novo, você roda seu benchmark e descobre se vale trocar. A decisão é baseada em dados seus, na sua tarefa, não em benchmark genérico de marketing.
Shadow testing de provedores. Você pode rodar um provedor candidato em shadow mode (do artigo de linhas de produção), processando tráfego real sem afetar usuários, pra avaliar antes de rotear de fato.
O benchmarking constante transforma a decisão de roteamento de "escolha feita uma vez" em "decisão revisada com dados". Isso é o que mantém o sistema otimizado conforme o mercado de provedores evolui, que evolui rápido.
O efeito colateral comercial: poder de negociação
Tem um benefício de arquitetura multi-provedor que é puramente comercial, mas que costuma pagar todo o investimento técnico: poder de negociação.
Quando você depende de um provedor único, a conversa comercial é desigual. O provedor sabe que migrar custa caro e demora, então a margem de negociação é pequena.
Quando você tem arquitetura multi-provedor pronta, a conversa muda. Você pode genuinamente mover volume de um provedor pra outro com esforço baixo. Isso significa que:
Você pode negociar preço com credibilidade. "Estamos avaliando mover 40% do volume pro provedor concorrente" é uma frase com peso quando a arquitetura torna isso real.
Você pode aproveitar promoções e créditos. Provedores oferecem créditos e condições pra ganhar volume. Com arquitetura flexível, você aproveita sem se prender.
Você reduz dependência de qualquer relacionamento comercial específico. Mudança de política de um provedor não te coloca em crise.
O custo de construir a arquitetura multi-provedor frequentemente é menor que a economia obtida em negociação ao longo do tempo, especialmente em volumes altos. É um caso onde investimento técnico tem retorno comercial direto.
O custo da estratégia: quando não vale
Multi-provedor não é grátis. A camada de abstração é trabalho de engenharia. Manter adaptadores para múltiplos provedores significa acompanhar mudanças de API de vários lugares. O roteamento adiciona complexidade. Benchmarking constante é processo contínuo. Prompts podem precisar de variações por provedor.
Por isso, não vale pra todo mundo.
Não vale em estágio inicial. Quando você está validando se a feature de IA tem valor, multi-provedor é otimização prematura. Use um provedor, valide, e considere multi-provedor quando escalar.
Não vale em baixo volume. Se sua conta de IA é modesta, a economia de negociação não justifica a complexidade, e o risco de disponibilidade pode ser aceitável com fallback simples.
Não vale se a abstração custa qualidade. Forçar o denominador comum entre provedores pode te impedir de usar capacidades específicas de um provedor que agregam muito valor. Em alguns casos, é melhor usar um provedor profundamente do que vários superficialmente.
A regra é a mesma de sempre: introduza a complexidade quando o problema justifica. Multi-provedor justifica quando o volume é alto, quando a disponibilidade é crítica, quando há requisitos diferentes por tenant, ou quando o poder de negociação tem valor material.
Conclusão
Orquestração multi-provedor é uma decisão de gestão de risco e posicionamento estratégico, com implementação técnica que a viabiliza. O risco de depender de um único provedor é real: disponibilidade, preço, mudança de comportamento, descontinuação, compliance, poder de negociação. A mitigação é uma camada de abstração que torna provedores intercambiáveis, roteamento que distribui tráfego com inteligência, regras por tenant e feature, e benchmarking que mantém as decisões atualizadas.
Como toda decisão de arquitetura, tem custo, e o custo só se justifica quando o problema é real. Em escala e em contexto crítico, multi-provedor deixa de ser luxo e vira proteção necessária. Em estágio inicial ou baixo volume, é complexidade que não se paga.
A pergunta que orienta bem: "se o meu provedor principal mudar preço, degradar, ou ficar fora amanhã, qual o impacto, e quanto tempo eu levo pra reagir?" Se o impacto é alto e o tempo de reação é longo, você tem concentração de risco que vale endereçar. Se é baixo, talvez um provedor com bom fallback baste por enquanto.
Insights & Takeaways
-
Dependência de provedor único expõe a riscos reais e já observados: disponibilidade, mudança de preço, drift de comportamento, descontinuação de modelo, mudança de termos, e perda de poder de negociação. A pergunta não é se acontece, é se você tem alternativa quando acontecer.
-
A base de qualquer estratégia multi-provedor é uma camada de abstração que desacopla seu código do provedor específico. É evolução do AI Gateway, com adaptadores que normalizam as diferenças de API, capacidades e tokenização entre provedores.
-
Regras de roteamento por tenant e por feature permitem atender requisitos contratuais, de compliance e comerciais distintos com a mesma base de código. Banco com compliance rigoroso, startup que prioriza custo, e enterprise premium podem coexistir.
-
Benchmarking constante mantém as decisões de roteamento atualizadas. Provedores evoluem rápido; o roteamento ótimo de seis meses atrás pode estar subótimo hoje. Eval set por tarefa rodando contra cada provedor é o que mantém a escolha baseada em dados atuais.
-
O benefício comercial (poder de negociação) frequentemente paga o investimento técnico. Ter a arquitetura pronta pra mover volume entre provedores muda a mesa de negociação, e em volumes altos, a economia supera o custo de manter a flexibilidade.