IA First · Episódio 19
Design de Feedback Loop: Como Ensinar a IA Usando o Próprio Uso do Produto
Como capturar feedback explícito e implícito numa feature de IA, ligar cada ação do usuário à interação e usar o sinal para ajustar prompt, config e dataset.
Neste artigo · 11 seções
- A oportunidade que a maioria dos times deixa passar
- Os dois tipos de feedback e por que ambos importam
- Mapeando sinais por tipo de feature
- Capturando feedback sem prejudicar a UX
- A instrumentação que conecta interação a ação
- De sinal pra ação: o que fazer com o feedback capturado
- O ciclo completo
- Cuidados com viés e amostragem
- O que erra mais nessa disciplina
- Conclusão
- Insights & Takeaways
A oportunidade que a maioria dos times deixa passar
Cada interação que um usuário tem com uma feature de IA gera sinal. O usuário aceitou a sugestão, editou, descartou, refez a pergunta, abandonou a sessão. Isso tudo é informação valiosa sobre o que está funcionando e o que não está. Em volume, é a melhor fonte que existe pra entender qualidade real do sistema, melhor que qualquer eval set artificial.
E mesmo assim, a maioria dos produtos de IA ignora esse sinal. O usuário interage, o sistema responde, e tudo acaba ali. O log da chamada vai pra algum lugar, mas a ação subsequente do usuário não é capturada de forma estruturada. Quando o time quer entender se a feature está boa, depende de pesquisa qualitativa, de NPS trimestral ou de reclamações no SAC. Tudo isso chega tarde e em pouca quantidade.
O problema não é técnico; é de design. Feedback loop não acontece sozinho. Ele precisa ser desenhado, instrumentado e usado. Esse artigo é sobre como fazer isso: que sinais capturar, como diferenciar feedback explícito de implícito, como transformar dados de uso em insumo pra melhorar prompts, regras, configuração ou até dataset de treinamento.
Os dois tipos de feedback e por que ambos importam
Feedback do usuário sobre IA se divide em dois tipos, e a confusão entre eles é a primeira fonte de problema.
Feedback explícito é o que o usuário oferece deliberadamente. Thumbs up ou down em uma resposta. Rating de 1 a 5. Botão de "isso não foi útil". Campo aberto pra comentário. É o que a maioria dos produtos implementa quando alguém fala "vamos coletar feedback dos usuários".
Tem uma virtude e um problema. A virtude é que é direto: o usuário está dizendo, em palavras, o que pensa. O problema é o volume. A taxa de feedback explícito tipicamente não passa de 5-10% das interações, e mesmo essa fração tem viés (gente muito satisfeita ou muito insatisfeita; o meio termo nunca aperta o botão).
Feedback implícito é o que o usuário faz sem perceber que está dando feedback. Aceitou a sugestão e seguiu em frente? Sinal positivo. Editou antes de usar? A base estava certa, faltou ajuste. Descartou e refez a pergunta? Resposta não satisfez. Fechou a janela sem agir? Frustração ou irrelevância.
A virtude do implícito é cobertura: 100% das interações geram sinal. O problema é interpretação: cada ação pode significar coisas diferentes, e correlacionar ação com qualidade exige cuidado.
A combinação dos dois é o que dá visão real. Explícito pra capturar opiniões fortes; implícito pra capturar comportamento da maioria silenciosa.
Mapeando sinais por tipo de feature
Os sinais que importam dependem do que a feature faz. Vamos olhar três tipos comuns de feature de IA e que sinais valem a pena capturar pra cada um.
Feature de sugestão (autocomplete, recomendação, completion de código). O sistema oferece, o usuário aceita ou não.
A diferença entre "aceita literalmente" e "aceita após editar" é informação rica. Se 80% dos usuários editam a sugestão antes de usar, a sugestão está perto mas não acerta. O delta entre o que foi oferecido e o que foi usado é insumo direto pra melhorar.
Feature conversacional (chatbot, assistente). O usuário pergunta, o sistema responde, conversa segue ou termina.
Sinais relevantes: reformulação imediata da pergunta (a primeira resposta não satisfez), abandono após a resposta (a resposta resolveu ou frustrou demais a ponto de desistir), continuação produtiva (próxima mensagem é uma nova questão, sinal de que a anterior foi resolvida), pedido de escalar pra humano (resposta da IA não bastou).
Feature de classificação ou extração com revisão humana. O sistema processa, o humano revisa antes de validar.
Sinais relevantes: aceito sem alteração, alterado em campos específicos (quais campos?), rejeitado completamente, marcado como erro grave. A granularidade do sinal aqui é alta: você sabe exatamente onde o modelo errou.
Cada tipo de feature pede instrumentação diferente. Não dá pra ter um único pattern de feedback que serve a tudo.
Capturando feedback sem prejudicar a UX
Tem uma armadilha comum: encher o produto de mecanismos de feedback achando que isso vai dar mais sinal. Pelo contrário. Cada vez que você pergunta ao usuário "isso foi útil?", você está adicionando fricção.
Feedback explícito funciona melhor quando é discreto e estratégico. Algumas práticas:
Botão simples e visível, mas não invasivo. Thumbs up/down ao lado da resposta, sem modal, sem "obrigado pelo seu feedback" interrompendo o fluxo.
Pergunta opcional só pra negativos. Se o usuário marcou negativo, aí sim aparece um campo opcional "o que estava errado?". Não pra positivos. Feedback negativo é mais valioso e merece o esforço de captura mais detalhada.
Sem solicitação proativa em momentos ruins. Não peça feedback quando o usuário está claramente frustrado ou no meio de uma tarefa urgente. O timing afeta a qualidade do sinal.
Frequência limitada. Não peça feedback em toda interação. Amostragem inteligente é melhor: peça em uma a cada N interações, ou em momentos onde a resposta foi gerada com baixa confiança.
Feedback implícito não tem custo de UX porque é instrumentação invisível. Mas tem custo técnico: cada ação relevante do usuário precisa ser logada com referência à interação que originou. Isso exige correlation IDs e pipeline de eventos bem desenhado.
A instrumentação que conecta interação a ação
Pra capturar feedback implícito, cada interação com IA precisa ter um identificador único, e cada ação subsequente do usuário precisa carregar esse identificador. Sem isso, você não consegue correlacionar.
Na prática, o esquema fica assim:
Interação 1:
  interaction_id: int_abc123
  feature: code_completion
  prompt_completo: "..."
  resposta_modelo: "..."

Eventos relacionados:
  event_type: suggestion_shown
  interaction_id: int_abc123
  timestamp: t0

  event_type: suggestion_accepted
  interaction_id: int_abc123
  timestamp: t0 + 2.3s
  edited_before_accept: true
  diff: "..."
Esse modelo permite responder perguntas como: "qual a taxa de aceitação por tipo de sugestão?", "quanto tempo o usuário leva pra decidir?", "quanto da sugestão original sobrevive depois da edição?", "que tipos de sugestão são abandonados sem ação?".
O pipeline de eventos pode ser o mesmo que você já usa pra analytics de produto: Mixpanel, Amplitude, Segment, Snowplow, ou pipeline próprio. O importante é que eventos de IA estejam no mesmo grafo de eventos que tudo mais. Isso permite cruzar com sinais já existentes (usuário recente, plano, segmento, etc.).
De sinal pra ação: o que fazer com o feedback capturado
Capturar é só metade. A outra metade é transformar sinal em melhoria do sistema. Existem quatro caminhos principais.
Ajuste de prompts. O caso mais simples e mais rápido. Se você identificou que o sistema está respondendo no formato errado, ou cobrindo casos errados, ajusta o prompt e mede. O eval set deveria incluir os casos negativos identificados pelo feedback, pra evitar regressão.
Ajuste de regras e configuração. Threshold de confiança, escolha de modelo, limite de tokens, parâmetros de retrieval. Muitas vezes o feedback aponta pra ajuste de configuração, não de prompt. "Quando a confiança é baixa, melhor não sugerir nada" é uma decisão de configuração que sai direto do sinal de "sugestões com confiança X são rejeitadas em Y% dos casos".
Curadoria de dataset. Em features que usam fine-tuning ou que poderiam usar, casos de feedback negativo (especialmente os que foram corrigidos pelo usuário) são gold standard pra treinamento. O par "input que o sistema viu" + "saída que o usuário acabou usando" é exatamente o que um dataset de fine-tuning quer.
Reprojetar a feature. Às vezes o feedback aponta pra problema mais profundo. A feature está mal posicionada no fluxo. O usuário não confia no formato. A latência derrota o valor. Esses casos não se resolvem com prompt; exigem voltar pra prancheta.
A maioria dos times se contenta com a primeira camada (ajuste de prompts) e nunca chega nas outras três. Isso limita o quanto o feedback pode realmente melhorar o sistema.
O ciclo completo
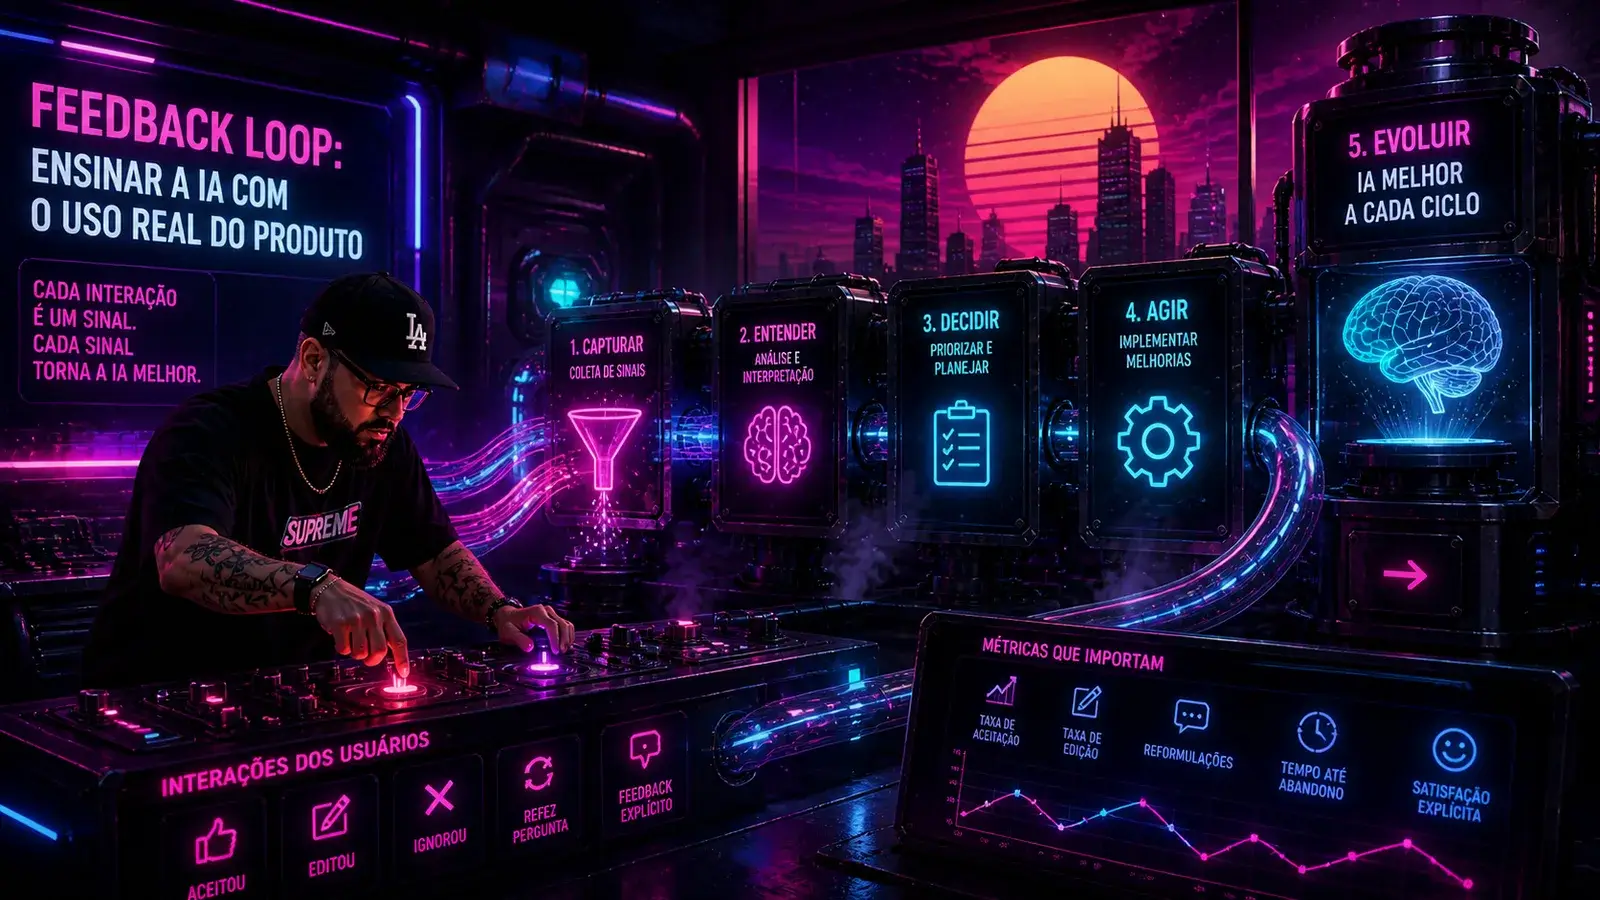
Visualizando o ciclo inteiro:
O ponto chave é que esse ciclo precisa estar instrumentado e operacional, não ser exercício esporádico. Quando você espera o produto reclamar pra investigar, o sinal já passou faz tempo. Quando o ciclo está rodando, melhorias acontecem incrementalmente, baseadas em dado real.
Cuidados com viés e amostragem
Feedback do usuário tem vieses que podem distorcer a leitura se não forem considerados.
Viés de auto-seleção. Quem dá feedback explícito não é amostra representativa. Tipicamente são os usuários mais engajados ou mais frustrados. Decisões baseadas só em explícito podem otimizar pros extremos e ignorar a maioria silenciosa.
Viés de novidade. Usuários novos avaliam features de forma diferente de usuários experientes. Misturar os dois sem segmentar pode esconder problemas que aparecem com uso prolongado, ou problemas de onboarding.
Viés de contexto. A mesma feature pode ter taxa de aceitação muito diferente em contextos diferentes. Sugestão de código aceita em arquivo de testes pode ser rejeitada em arquivo de produção. Agregar tudo num único número esconde isso.
Viés de capacidade. Usuários com habilidade alta (programadores experientes, especialistas no domínio) tendem a editar mais antes de aceitar, porque sabem refinar. Usuários iniciantes podem aceitar sugestões ruins porque não têm critério. Volume bruto de aceitação pode levar a leitura errada.
Cuidado com cada um desses passa por segmentar análise. Não olhar só "taxa de aceitação geral", mas "taxa de aceitação por segmento de usuário, por tipo de tarefa, por momento da jornada". Isso revela padrões que o agregado esconde.
O que erra mais nessa disciplina
Alguns padrões aparecem com frequência em times implementando feedback loop pela primeira vez.
Coleta sem destino. Métricas de aceitação são capturadas e exibidas em dashboard, mas ninguém olha periodicamente pra extrair ação. Vira métrica decorativa.
Confiar só em explícito. O time fica obcecado por NPS, thumbs up/down, e ignora os sinais comportamentais que estão acontecendo em volume infinitamente maior.
Tratar todo feedback negativo igual. Um thumbs down num caso de borda raro vale o mesmo que feedback negativo de uma falha sistemática? Não. Sem classificação, todos têm o mesmo peso, e o time gasta esforço em casos errados.
Não fechar o ciclo com o usuário. Em alguns casos, vale mostrar ao usuário que o feedback foi incorporado: "obrigado, ajustamos a sugestão". Isso aumenta engajamento futuro com o mecanismo de feedback. Quando feedback some num buraco, usuário para de dar.
Não revisar feedback automaticamente capturado. Casos negativos identificados via implícito não viram melhoria automaticamente. Alguém precisa olhar, classificar, decidir se vira ajuste, regra nova, ou caso de eval. Sem essa revisão, o sinal acumula sem efeito.
Conclusão
Feedback loop não é "ah, vamos colocar um thumbs up nas respostas". É um sistema completo: instrumentação que captura sinais explícitos e implícitos, pipeline que correlaciona ações com interações, processo que transforma sinal em melhoria. Sem qualquer uma dessas peças, o ciclo não funciona.
A boa notícia é que cada peça é fazível com tecnologias que o time já tem. Eventos de produto, dashboard de métricas, ritmo de revisão de casos negativos. Não precisa de plataforma exótica.
A pergunta que vale ter sempre na cabeça: "se eu olhar pros dados de uso da semana passada, eu consigo apontar três coisas concretas pra melhorar no sistema?" Se a resposta é sim, o ciclo está vivo. Se é não, ele provavelmente não existe de fato, mesmo que tenha botão de thumbs up no produto.
Insights & Takeaways
-
Feedback explícito tem virtude (palavras claras) e problema (volume baixo, viés). Feedback implícito tem virtude (cobertura total) e problema (interpretação). Os dois juntos dão visão real; um sozinho deixa pontos cegos.
-
Sinais variam por tipo de feature. Sugestão pede aceitação/edição/rejeição. Conversação pede reformulação/abandono/continuação. Classificação com revisão humana pede granularidade por campo alterado. Não dá um único pattern pra tudo.
-
Capturar feedback implícito exige correlation ID em cada interação e pipeline de eventos que correlaciona ações subsequentes. Sem isso, você só tem o explícito, que é ponta do iceberg.
-
Sinal vira ação por quatro caminhos: ajuste de prompt, ajuste de configuração, curadoria de dataset, redesign da feature. A maioria dos times para no primeiro e perde os outros três.
-
Feedback tem vieses (auto-seleção, novidade, contexto, capacidade). Análise sem segmentar esconde padrões. Olhe por segmento, não só por agregado.