IA de Alta Performance · Episódio 11
Responder a Mesma Pergunta Duas Vezes é Rasgar Dinheiro
Cache exato, de prefixo e semântico têm riscos opostos. Qual ligar primeiro num LLM, como evitar acerto falso e vazamento de dado, e a métrica que falta.
Neste artigo · 9 seções
- nível 1: o cache exato, e por que ele decepciona
- nível 2: o cache de prefixo, e esse você deveria estar usando ontem
- nível 3: o cache semântico, e aqui a coisa fica interessante
- o modo de falha que ninguém instrumenta
- a métrica que falta
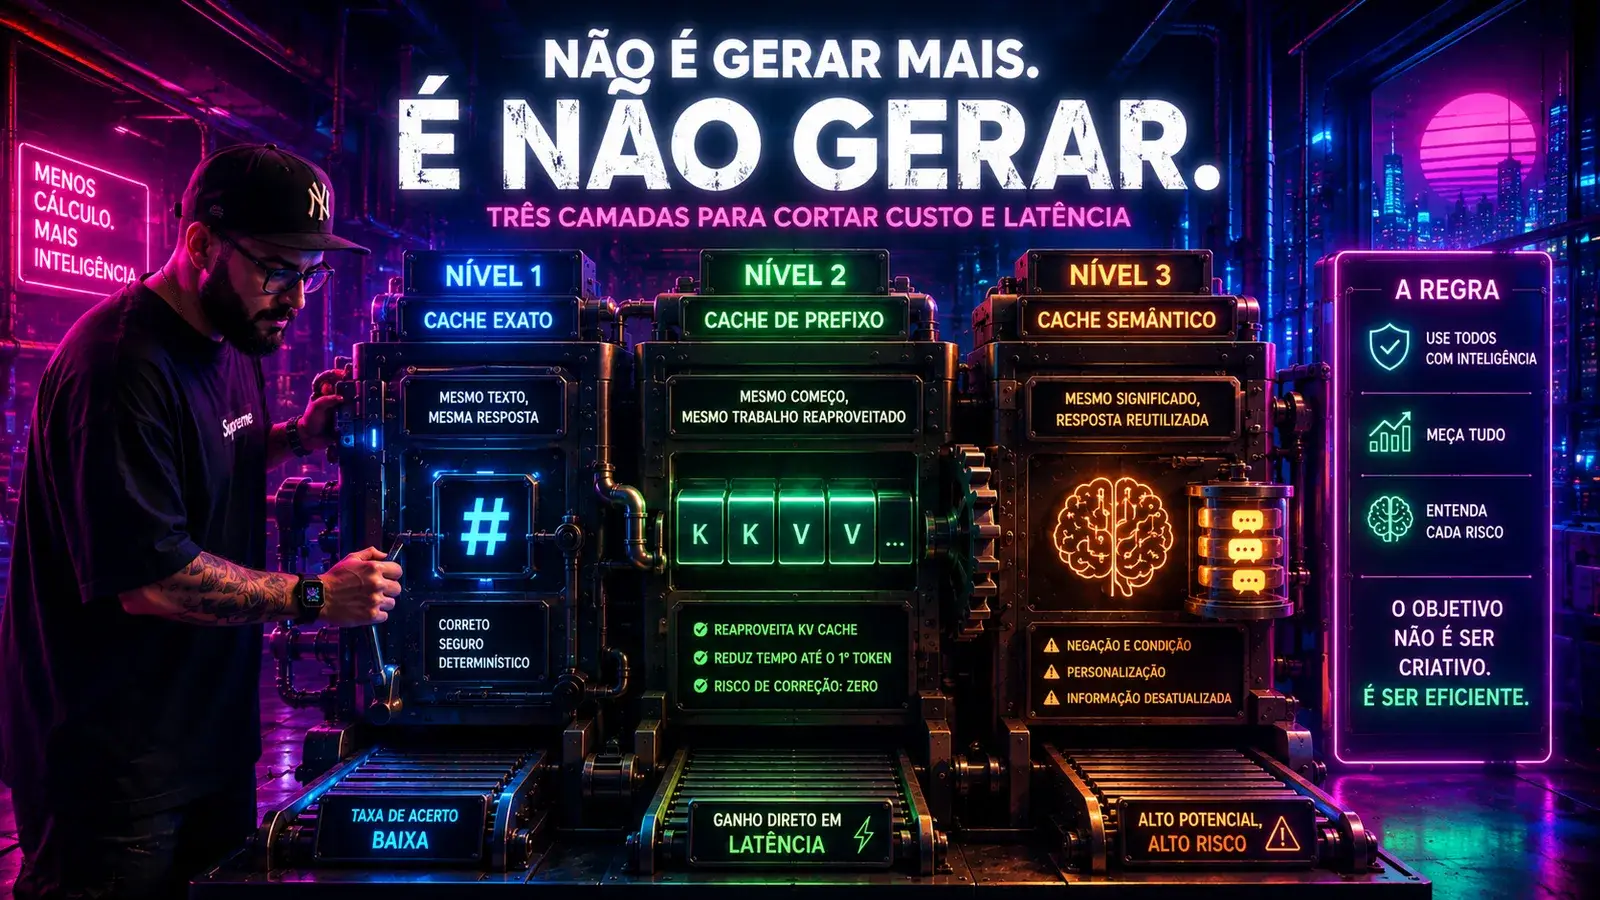
- o diagrama: três camadas, três riscos
- a implementação ingênua, e a que sobrevive
- onde ele é seguro, e onde nem tente
- Insights & Takeaways
A temporada passada desta série foi sobre entender a física: por que um token custa o que custa, onde a latência mora, o que decide quanta gente cabe numa placa. Esta temporada é sobre a sala de máquinas, ou seja, o que um servidor de inferência decente faz para transformar aquela física em capacidade de atender gente.
E a primeira coisa que ele faz não é gerar mais rápido. É não gerar.
Toda otimização que discuti até aqui trabalha para reduzir o custo de produzir um token. Existe uma categoria inteira de otimização que trabalha antes disso, perguntando se aquele token precisa ser produzido. Ela é a de melhor retorno por esforço que existe no serving, e é a mais mal implementada que eu vejo, porque as pessoas tratam três mecanismos bem diferentes como se fossem o mesmo assunto.
Vamos separar os três, porque eles têm perfis de risco que não se parecem em nada.
nível 1: o cache exato, e por que ele decepciona
O primeiro é o que qualquer pessoa implementa em vinte minutos: pega o texto do prompt, calcula um hash, guarda a resposta. Chegou o mesmo prompt, devolve o que estava guardado.
É correto, é seguro, é determinístico. E, em produto de linguagem natural, a taxa de acerto costuma ser deprimente.
O motivo é óbvio quando você olha tráfego real. As pessoas não repetem texto. Elas perguntam a mesma coisa de vinte jeitos, com erro de digitação, com uma vírgula a mais, com o nome do produto escrito diferente. Um espaço em branco a mais no fim da frase já é outro hash. Some a isso que a maioria dos sistemas injeta timestamp, identificador de sessão ou histórico no prompt, e o cache exato passa a nunca acertar nada.
Ele não é inútil: em chamadas internas, programáticas, com prompt montado por template e parâmetros de um conjunto pequeno, ele acerta muito. Mas para a pergunta digitada por um humano, esqueça.
nível 2: o cache de prefixo, e esse você deveria estar usando ontem
Este é o mecanismo que quase ninguém mede e que dá o maior ganho com risco nenhum.
Volte ao artigo sobre o KV cache. Para gerar texto, o modelo guarda as chaves e os valores de cada token já processado, de forma a não reprocessar a sequência inteira a cada passo. Aquele artigo tratava disso como um custo de memória, que é o ângulo da densidade.
Agora olhe pelo outro lado. Se o K e o V de um token dependem só daquele token e dos anteriores, então dois prompts que começam igual produzem exatamente os mesmos K e V naquele pedaço inicial. Bit a bit. Sempre.
E os seus prompts começam iguais. Todos eles. O system prompt com as instruções, as regras de tom, os exemplos, o esquema de saída, a política de recusa: são os mesmos dois, três, às vezes cinco mil tokens na frente de cada requisição que o seu sistema faz.
Sem cache de prefixo, você processa esses milhares de tokens do zero, toda vez, para todo usuário. É trabalho de prefill puro, que é a fase cara em cálculo, jogado fora e refeito indefinidamente.
Com cache de prefixo, o servidor guarda o K e o V daquele trecho comum e reaproveita. O ganho aparece direto no tempo até o primeiro token, que é a métrica que o usuário sente, e ele é proporcional ao tamanho do prompt fixo em relação ao variável. Em sistema com system prompt gordo, e a maioria tem, isso é a diferença entre uma resposta que começa a aparecer rápido e uma que demora.
Repare no ponto que importa: isto não é "responder do cache". É não recalcular o que não mudou. O resultado é idêntico ao que sairia sem cache, com a mesma resposta e a mesma qualidade. Risco de correção: zero.
Por isso a recomendação é sem ressalva. Se o seu servidor de inferência suporta cache de prefixo e você não ligou, ou não organizou os prompts para que a parte fixa venha primeiro, tem dinheiro e latência parados ali. E é uma mudança de arrumação de string, não de arquitetura.
nível 3: o cache semântico, e aqui a coisa fica interessante
A ideia: em vez de comparar texto, compare significado. Você transforma a pergunta num vetor de embedding, procura no seu banco de perguntas já respondidas a mais próxima, e se a similaridade passar de um limite, devolve a resposta guardada sem chamar o modelo.
Agora "qual o prazo de entrega?" e "em quantos dias chega?" acertam o mesmo cache. A taxa de acerto sai do chão e vai para algo que muda a fatura de verdade, porque tráfego de suporte e de FAQ é absurdamente repetitivo.
Quem leu o que escrevi em RAG sem romance reconhece a maquinaria: é busca vetorial, com os mesmos embeddings e a mesma noção de proximidade. A diferença é o que está sendo recuperado. No RAG você recupera contexto para o modelo trabalhar em cima, e se vier um documento meio errado o modelo ainda tem chance de contornar. No cache semântico você recupera a resposta final e entrega direto ao usuário, sem ninguém no meio para perceber que ela não combina com a pergunta.
Essa diferença é tudo.
o modo de falha que ninguém instrumenta
Similaridade de embedding mede proximidade de assunto, não equivalência de resposta. E existem três famílias de caso onde as duas coisas divergem feio.
A primeira é negação e condição. "Posso cancelar depois de 7 dias?" e "Posso cancelar antes de 7 dias?" são quase idênticas em vetor, porque as duas falam de cancelamento e prazo, e têm respostas opostas. O mesmo vale para qualquer par que difere por um "não", por um "sem", por um limite numérico. Embeddings são notoriamente ruins em negação, e é exatamente aí que a resposta muda.
A segunda é personalização. "Qual é o meu saldo" é uma pergunta só, com um vetor só, e uma resposta diferente para cada pessoa que a faz. Se a chave do seu cache não inclui quem perguntou, você acabou de construir uma máquina de vazar dado de um usuário para outro. Isso não é hipótese remota: é a consequência direta e previsível de cachear por significado sem particionar por identidade.
A terceira é validade no tempo. "Quanto está a taxa?" tem resposta certa hoje e errada semana que vem, e o vetor não envelhece.
O que une as três é o formato da falha. Não tem exceção, não tem log de erro, não tem alerta. O usuário recebe uma resposta bem escrita, coerente e errada, e o sistema registra aquilo como um acerto de cache, ou seja, como economia. O seu painel vai mostrar a métrica melhorando enquanto a qualidade piora.
a métrica que falta
Todo mundo que implementa cache semântico mede taxa de acerto, porque é a métrica que justifica o projeto. Quase ninguém mede a segunda, que é a que importa: a taxa de acerto falso, ou seja, a fração das entregas do cache em que a resposta guardada não servia para a pergunta feita.
Sem esse segundo número, o primeiro não quer dizer nada. Um cache com 40% de acerto e 5% de acerto falso pode ser um péssimo negócio, porque você trocou uma economia modesta por um erro silencioso em uma a cada vinte respostas, num sistema onde ninguém vai reclamar formalmente e todo mundo vai confiar um pouco menos.
Medir isso não é complicado, é só trabalhoso: amostre as entregas do cache, mande a pergunta original e a resposta entregue para avaliação, humana ou por um modelo forte agindo como juiz, e pergunte se aquela resposta responde aquela pergunta. É o mesmo tipo de avaliação contínua que qualquer sistema de IA sério já deveria ter.
o diagrama: três camadas, três riscos
a implementação ingênua, e a que sobrevive
O jeito que costuma aparecer primeiro:
// ❌ um limiar global, sem dono e sem prazo
var vetor = await _embeddings.GerarAsync(pergunta);
var achado = await _indice.MaisProximoAsync(vetor);

if (achado.Similaridade > 0.92)          // número escolhido no olho
    return achado.Resposta;               // entregue direto ao usuário

// não sabe de quem era a pergunta original.
// não sabe de quando é a resposta.
// não mede quantas vezes entregou coisa errada.
O que muda na versão que aguenta produção não é o algoritmo, é o que entra na chave e o que sai na medição:
// ✅ escopo na chave, validade explícita, e a segunda métrica sendo coletada
var vetor  = await _embeddings.GerarAsync(pergunta);
var achado = await _indice.MaisProximoAsync(vetor, escopo: new EscopoCache(
    Inquilino: ctx.TenantId,
    Usuario:   politica.DependeDeUsuario ? ctx.UserId : null,   // particiona o pessoal
    Idioma:    ctx.Idioma));

var elegivel = achado is not null
    && achado.Similaridade > politica.Limiar          // limiar por tipo de pergunta
    && achado.Idade < politica.ValidadeMaxima         // resposta velha não serve
    && !DetectorDeNegacao.Divergem(pergunta, achado.Pergunta);

if (elegivel)
{
    _metricas.AcertoDeCache();
    _auditoria.AmostrarParaAvaliacao(pergunta, achado);  // alimenta a taxa de acerto falso
    return achado.Resposta;
}

var resposta = await _modelo.GerarAsync(pergunta);
await _indice.GuardarAsync(vetor, pergunta, resposta, politica.ValidadeMaxima, escopo);
return resposta;
Três detalhes carregam esse código. O escopo na chave, que impede resposta de um usuário chegar a outro. A validade, que faz a resposta expirar sozinha em vez de envelhecer para sempre. E a amostragem para avaliação, que é a única forma de a taxa de acerto falso existir.
O limiar vir da política, e não ser uma constante global, também importa mais do que parece: pergunta sobre documentação estável aguenta um limiar frouxo; pergunta que envolve valor, prazo ou condição contratual exige limiar apertado ou nem deveria ser elegível.
onde ele é seguro, e onde nem tente
Cache semântico é seguro quando a resposta é a mesma independentemente de quem pergunta e de quando pergunta. Documentação de produto, dúvida conceitual, explicação de funcionalidade, política pública da empresa, conteúdo de ajuda. Nesses casos a repetição é altíssima e o risco é baixo, que é a combinação ideal.
Ele é perigoso quando a resposta depende de contexto que o vetor não enxerga: qualquer coisa com dado da conta, com valor, com prazo em movimento, com decisão condicional. Aí ou você particiona a chave até o cache perder utilidade, ou aceita que não é o lugar dele.
E vale a comparação com o nível 2, que é o argumento que eu levaria para uma reunião. O cache de prefixo dá ganho garantido com risco zero, e a maioria dos times não ligou. O cache semântico dá ganho maior com risco real, e é o que todo mundo quer implementar primeiro porque é o mais interessante de construir. A ordem certa é a inversa: arrume o prefixo, meça, e só depois vá para o semântico, com a segunda métrica montada antes de ligar.
Insights & Takeaways
- São três mecanismos diferentes, não três nomes para a mesma coisa. Cache exato tem risco zero e acerto baixo em linguagem natural; cache de prefixo tem risco zero e ganho garantido; cache semântico tem o maior ganho e o único risco de correção.
- O cache de prefixo é o mais subestimado: como o K e o V de um trecho dependem só dele e do que veio antes, o system prompt de milhares de tokens que abre toda requisição pode ser calculado uma vez e reusado. Não é responder do cache, é não recalcular o que não mudou.
- Similaridade de embedding mede assunto, não equivalência de resposta. Negação e limites numéricos quase não movem o vetor e invertem a resposta; personalização dá uma pergunta só com muitas respostas certas; validade no tempo não é capturada em vetor nenhum.
- O acerto falso é silencioso: nenhuma exceção, nenhum log, e o painel registra como economia. Taxa de acerto sem taxa de acerto falso é uma métrica que só sabe elogiar a si mesma.
- Escopo na chave (inquilino, usuário quando a resposta é pessoal, idioma), validade explícita e limiar por tipo de pergunta são o que separa um cache que economiza de um que vaza dado e mente com confiança.
Uma pergunta honesta pra fechar: qual é a taxa de acerto do cache de prefixo no seu serving hoje? Se a resposta for que não existe cache de prefixo, você está reprocessando o mesmo system prompt milhares de vezes por dia, pagando prefill por trabalho idêntico, e essa é a economia mais barata que existe no seu sistema. E se existir cache semântico sem taxa de acerto falso, o número bonito do painel não está medindo economia. Está medindo quantas vezes você deixou de verificar.
No próximo artigo a sala de máquinas abre de verdade: como o servidor decide quem entra no lote e quando, e por que admitir requisição nova no meio da geração, em vez de esperar o lote fechar, é o truque que faz uma GPU atender muito mais gente.