IA de Alta Performance · Episódio 6
Você Não Precisa de Python Pra Servir IA
Como servir modelos de IA em .NET com ONNX Runtime, LLamaSharp e Microsoft.Extensions.AI, e quando o sidecar de Python custa mais do que entrega.
Neste artigo · 7 seções
O time tem dez anos de .NET. Esteira madura, observabilidade afiada, deploy sem drama há tempos. Aí chega a primeira feature de IA e alguém decreta, com a naturalidade de quem repete uma lei da física: "vamos precisar de um serviço em Python".
Três meses depois o time mantém dois mundos. Um Dockerfile diferente, outra esteira, outro jeito de fazer log, um requirements.txt que quebra sozinho e um serviço que ninguém sabe direito quem cuida. Tudo isso pra rodar um modelo que responde em milissegundos atrás de vinte linhas de FastAPI.
Ninguém decidiu essa arquitetura. Ela foi herdada do tutorial.
No artigo anterior desta série eu fechei prometendo esta conversa: dá pra servir modelo em .NET, sem sidecar de Python, sem pedir desculpa. Dá. E entender por que dá exige separar duas coisas que o mercado mistura o tempo todo: a linguagem em que a IA é pesquisada e a infraestrutura em que ela é servida.
o Python não executa a matemática
O fato que desmonta o mito: quando um modelo roda "em Python", o Python não está fazendo a conta.
A multiplicação de matrizes que domina uma inferência (a série inteira vem martelando isso desde a física do token) acontece em kernels nativos: CUDA e cuBLAS na GPU, oneDNN e AVX na CPU. Código C++ compilado, ajustado a mão por gente da NVIDIA e da Intel. O interpretador Python é o maestro que aponta pra orquestra; quem toca é o metal. PyTorch, na prática, é uma casca amigável em volta de uma biblioteca nativa chamada libtorch.
Isso muda a pergunta. Se a matemática mora em bibliotecas nativas, a pergunta deixa de ser "qual linguagem sabe IA" e vira "qual linguagem consegue chamar essas bibliotecas com eficiência". E interop nativo é justamente um dos pontos fortes do C#: P/Invoke, ponteiros quando precisa, Span<T> pra passar memória sem cópia.
Vamos dimensionar o medo de sempre, o custo do interop, porque número é a marca desta série. Uma chamada P/Invoke custa nanossegundos, na casa de dezenas deles. Uma inferência de embedding custa milissegundos; uma geração de token, dezenas de milissegundos. A ponte entre o C# e o kernel nativo representa algo na ordem de 0,001% do tempo total. O overhead que importa não está na fronteira da linguagem. Está, como sempre nesta série, na banda de memória da GPU.
o mapa do stack
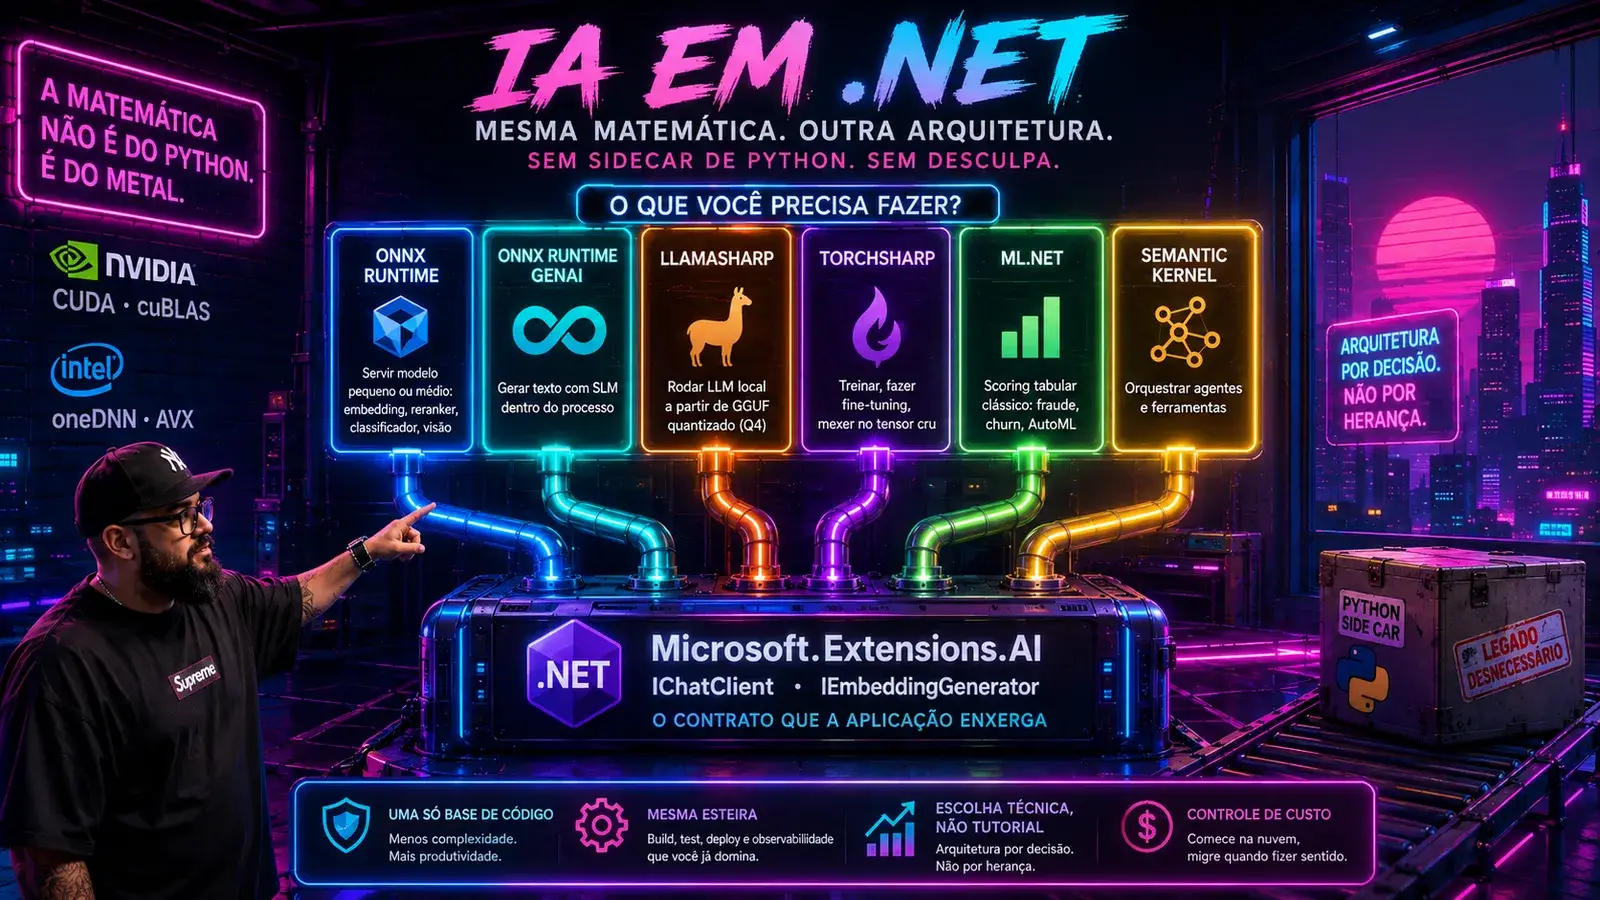
O ecossistema .NET de IA sofre de um problema de marketing, não de maturidade. As peças existem, são mantidas pela Microsoft ou pela comunidade séria, e quase ninguém sabe o nome delas. Vale percorrer uma a uma, porque escolher entre elas é a decisão de arquitetura de verdade.
O ONNX Runtime é o mesmo runtime que a Microsoft usa pra rodar modelo dentro do Windows e do Office, o que diz algo sobre maturidade. O fluxo: você exporta o modelo pra ONNX (ou baixa já exportado do Hugging Face), abre uma InferenceSession, e ela escolhe o execution provider disponível: CUDA ou TensorRT com GPU NVIDIA, DirectML no Windows, OpenVINO em Intel, CPU puro em qualquer lugar. O mesmo binário do seu serviço serve o modelo onde ele cair.
O ONNX Runtime GenAI fecha a lacuna que faltava: o loop de geração. Servir LLM não é uma inferência, é o loop de decode que esta série destrinchou nos primeiros artigos, com KV cache pra gerenciar e sampling pra fazer. A extensão GenAI entrega esse loop pronto em C#, e um Phi-4-mini quantizado roda dentro do seu processo ASP.NET consumindo uns poucos gigabytes.
O LLamaSharp embrulha o llama.cpp, o motor que move o ecossistema inteiro de LLM local, e te dá acesso ao formato GGUF: um Llama de 8B quantizado em Q4 vira um arquivo de uns 5 GB que roda em CPU ou GPU modesta. Guarde essa informação do "quantizado em Q4", porque o próximo artigo da série é inteiro sobre o que esse Q4 significa e o que ele custa.
Outras três peças completam o quadro sem entrar na discussão do sidecar. O TorchSharp, mantido sob a .NET Foundation, traz o libtorch inteiro pro C# com a API do PyTorch quase idêntica, e é o caminho de quem precisa do tensor cru para treino ou fine-tuning. O Semantic Kernel mora uma camada acima e orquestra agentes e ferramentas, então não compete com nenhum dos anteriores: ele chama quem serve. E o ML.NET segue resolvendo aprendizado de máquina clássico e tabular, aquele scoring de fraude ou churn que não precisa de LLM nenhum, e consome modelo ONNX quando faz sentido.
E o Microsoft.Extensions.AI merece menção por um motivo de arquitetura, não de performance: ele define o contrato (IChatClient, IEmbeddingGenerator) que separa a aplicação do provedor. A aplicação pede um chat; se quem responde é a OpenAI, um vLLM interno ou um Phi rodando in-process via ONNX, vira detalhe de configuração. É a interface que deixa você começar com API paga e migrar pra modelo próprio sem reescrever nada, uma decisão que já discuti pelo ângulo do custo em Custo de IA em Produção.
Junte tudo e o mapa fica assim, pela pergunta que interessa na hora de decidir, que é o que você precisa fazer:
Repare no nó de baixo. As três peças que servem modelo desembocam no mesmo contrato, e é isso que torna a escolha reversível: trocar quem responde não deveria custar reescrita de aplicação.
o sidecar cobra em outra moeda
Agora a parte que a discussão de linguagem esconde. O custo real do serviço Python satélite não é o interpretador ser lento. É o que existir como processo separado cobra de você.
Todo request seu atravessa a rede até ele. Serialização JSON na ida, na volta, um hop de rede no meio. Pra um LLM que pensa por segundos, esse pedágio é irrelevante. Pra um embedding ou um classificador que resolve em poucos milissegundos, o pedágio custa a mesma ordem de grandeza da inferência: você dobra a latência do recurso pra ganhar o quê, exatamente?
E a conta operacional é pior que a de latência. Dois deploys que precisam andar sincronizados. Dois APMs. Dois modelos de threading pra raciocinar em incidente. Healthcheck, retry, circuit breaker, versionamento de contrato entre os dois lados. Cada peça dessas é trabalho de gente, e nenhuma existe se o modelo roda dentro do processo.
Quem construiu sistema de bolsa conhece essa disciplina de outro lugar: no caminho crítico, cada processo a mais é um salto de rede, uma serialização e um ponto de falha a mais, e a primeira pergunta diante de qualquer caixa nova no diagrama é se ela precisa mesmo existir. A resposta padrão do mercado financeiro é não. Acho saudável importar essa desconfiança.
O código conta a história melhor. O caminho que virou reflexo:
// ❌ um microsserviço inteiro pra 15 linhas de inferência
var resp = await _http.PostAsJsonAsync("http://embedder:8000/embed",
    new { text = pergunta });
var vetor = await resp.Content.ReadFromJsonAsync<float[]>();

// o que não aparece nessas 3 linhas:
// - o Dockerfile, a esteira e o APM do serviço Python
// - o hop de rede + JSON em TODA requisição do seu p99
// - dois deploys pra sincronizar a cada mudança de modelo
E o caminho que quase ninguém testa antes de decidir:
// ✅ o modelo dentro do processo: uma dependência, zero hops
using Microsoft.ML.OnnxRuntime;
using Microsoft.ML.OnnxRuntime.Tensors;

// singleton no DI; a sessão é thread-safe pra inferências concorrentes
var session = new InferenceSession("all-minilm-l6-v2-int8.onnx");

float[] Embed(ReadOnlySpan<int> tokens)
{
    var ids  = new DenseTensor<long>(tokens.Length);
    var mask = new DenseTensor<long>(tokens.Length);
    for (int i = 0; i < tokens.Length; i++) { ids[i] = tokens[i]; mask[i] = 1; }

    using var saida = session.Run(new[] {
        NamedOnnxValue.CreateFromTensor("input_ids", ids.Reshape([1, tokens.Length])),
        NamedOnnxValue.CreateFromTensor("attention_mask", mask.Reshape([1, tokens.Length])),
    });
    return MeanPooling(saida[0].AsTensor<float>());   // [1, seq, 384] → [384]
}
Um MiniLM quantizado pesa uns 23 megabytes e responde em poucos milissegundos numa CPU comum. É menos memória que muita lib de log e menos latência que o hop de rede que ele substitui.
Não aceite meu adjetivo: meça, que é o que esta série prega desde o primeiro artigo. O harness cabe num benchmark de dez linhas:
[MemoryDiagnoser]
public class EmbeddingBench
{
    [Benchmark(Baseline = true)]
    public float[] InProcess() => _onnx.Embed(_tokens);      // ONNX in-process

    [Benchmark]
    public Task<float[]> Sidecar() => _http.EmbedAsync(_texto); // FastAPI na rede
}
Rode com o seu modelo, na sua infra, com o seu payload. No resultado típico, a linguagem nem aparece na história: o hop de rede e a serialização custam mais que a inferência inteira do modelo pequeno. A física de novo, só que agora a banda escassa é a da rede.
onde o Python continua ganhando (e não é pouco)
Honestidade de trade-off, senão isso aqui vira torcida.
Pra treinar e fazer fine-tuning, o ecossistema Python é imbatível e vai continuar sendo: as ferramentas nascem lá, os papers publicam código lá, e brigar contra isso é perder tempo. O TorchSharp existe e é sério, mas é a exceção que confirma a regra.
Pra servir LLM grande em escala, com continuous batching, paged attention e tensor parallelism, um vLLM ou TGI dedicado ganha do seu processo .NET, e vai ganhar por muito tempo. Esses servidores são o assunto da próxima temporada desta série, e a decisão certa neles é consumi-los como infraestrutura, do jeito que você consome o Postgres: um serviço especializado, atrás do contrato do IChatClient, sem nenhuma linha de Python escrita pelo seu time.
A linha de corte que uso é essa. Modelo pequeno ou médio no hot path de um sistema .NET (embedding, reranker, classificador, um SLM de extração): dentro do processo, via ONNX Runtime ou LLamaSharp. LLM grande, multi-GPU, compartilhado por vários sistemas: serviço de inferência dedicado, tratado como banco de dados, não como código seu. O que essa linha elimina é o meio-termo que virou padrão por inércia: o serviço Python artesanal de vinte linhas de FastAPI embrulhando uma chamada de biblioteca, cobrando um hop de rede e uma esteira inteira pra fazer o que uma InferenceSession faz dentro do seu deploy.
E o glue code em volta da inferência (tokenização, batching, fila, pós-processamento) roda em um runtime que compila pra código nativo de verdade e melhora a cada release, como mostrei no artigo sobre as melhorias do JIT no .NET 10. Streaming de token pro cliente vira um IAsyncEnumerable idiomático, o mesmo modelo assíncrono que destrinchei em Async/Await no .NET. Nada disso é exótico; é o stack que seu time já opera bem, fazendo o trabalho que sempre fez.
o diagrama: dois caminhos pro mesmo metal
Repare no que o desenho diz. Os dois caminhos terminam no mesmo lugar, nos mesmos kernels, no mesmo silício. A diferença entre eles não é capacidade de fazer IA; é quantas fronteiras de rede e de operação você atravessa pra chegar lá. Essa é a decisão de arquitetura real, e "qual linguagem sabe IA" nunca foi a pergunta.
conclusão: a pergunta era de operação, não de linguagem
O sidecar Python virou padrão pelo mesmo mecanismo que muita dívida técnica nasce: uma escolha de tutorial repetida até parecer arquitetura. A matemática da inferência roda em kernel nativo pra todo mundo; o que cada stack escolhe é o que colocar em volta dela. E em volta dela mora exatamente o que um time .NET maduro já faz bem: processo, threading, observabilidade, deploy.
Servir um embedding atrás de um hop de rede porque "IA é em Python" é pagar latência, esteira e incidente por um mito. E consumir um vLLM como infraestrutura, atrás de uma interface, é maturidade, não derrota. Entre os dois extremos, a régua é a de sempre: conte os saltos no caminho crítico e justifique cada um.
Insights & Takeaways
- A matemática da inferência roda em kernels nativos (CUDA, cuBLAS, oneDNN) pra qualquer linguagem. Python é orquestração em volta do metal, e orquestração o C# faz com interop de nanossegundos num trabalho de milissegundos.
- O stack .NET de IA está completo e maduro: ONNX Runtime pra produção, ONNX Runtime GenAI pro loop de geração de SLMs, LLamaSharp pra GGUF local, TorchSharp pra tensor cru, Microsoft.Extensions.AI como contrato da aplicação.
- O custo real do sidecar não é linguagem, é operação: um hop de rede e uma serialização em todo request, mais dois deploys, dois APMs e um contrato pra versionar. Pra modelo pequeno, o hop custa a ordem de grandeza da própria inferência.
- Linha de corte prática: modelo pequeno/médio no hot path .NET roda in-process; LLM grande multi-GPU fica num serving dedicado consumido como infraestrutura, atrás de um IChatClient. O que morre é o meio-termo artesanal de FastAPI.
- Não decida por adjetivo: um BenchmarkDotNet de dez linhas comparando in-process contra sidecar, com o seu modelo e o seu payload, encerra a discussão com número.
Uma pergunta honesta pra fechar, e essa divide qualquer time: você colocaria inferência dentro do seu processo .NET de produção, ou prefere pagar o hop e manter o modelo isolado num serviço, mesmo pequeno? Tenho lado, mas quero ouvir o argumento de quem está do outro.
No próximo artigo, a promessa que fiz lá no primeiro texto da série: aquele Q4 do arquivo GGUF. Um modelo 4x menor não é 4x pior, e entender por que (e onde essa mágica quebra) é a diferença entre economizar quatro vezes a memória e quebrar a qualidade do produto sem perceber.