IA de Alta Performance · Episódio 2
Um Enter Não é Um Request - A Viagem de Um Token do Teclado à GPU
A viagem de um token do Enter à GPU em seis etapas, do tokenizer ao sampling, e por que o custo de uma resposta cresce com os tokens gerados.
Neste artigo · 13 seções
- o reflexo que trai o engenheiro
- etapa 1: seu texto não entra como texto
- etapa 2: o token vira geometria
- etapa 3: as camadas, onde o dinheiro queima
- etapa 4: o modelo não escolhe uma palavra, ele gera uma aposta
- etapa 5: alguém precisa escolher
- etapa 6: de volta pra texto, e de volta pro começo
- vamos medir, no estilo conta de padaria
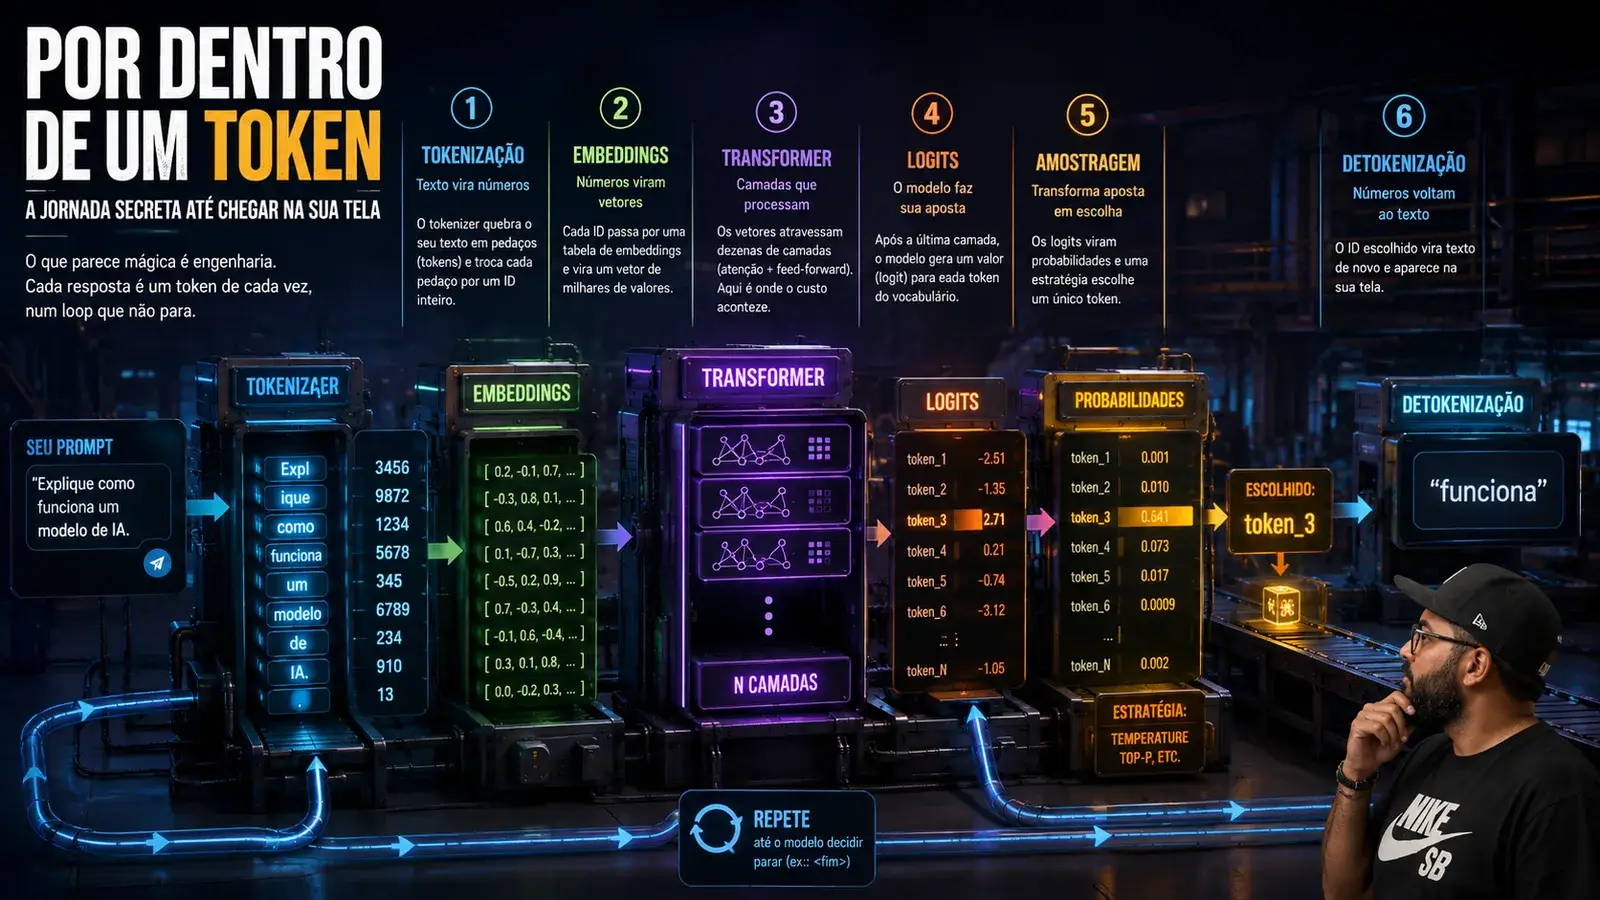
- o diagrama: a viagem inteira em uma figura
- request contra loop, no código
- por que quem decide deveria ler isto
- conclusão: o mapa que sustenta a série
- Insights & Takeaways
Você já viu o texto de um chat de IA aparecer palavra por palavra na tela. Todo mundo já viu. E quase todo mundo acha que aquilo é enfeite, uma animaçãozinha de digitação pra dar a impressão de que o modelo está pensando.
Não é animação. É a coisa real vazando pra tela.
O modelo não tem a resposta pronta esperando pra ser entregue. Naquele instante ele tem exatamente um token pra te dar. Depois mais um. Depois mais um. O cursor piscando mostra a verdade nua do que acontece por baixo: gerar texto é um processo que roda uma vez por palavra, e ninguém pula na frente.
Você aperta Enter e não faz um request. Você dispara um loop.
o reflexo que trai o engenheiro
Quem vem de backend carrega um reflexo, e ele engana. Você olha pro endpoint de chat, vê que é um POST que devolve um JSON, e trata igual a qualquer chamada REST. Manda o corpo, espera a resposta chegar inteira, coloca um timeout de dois segundos como colocaria num SELECT de banco.
Aí a resposta mais longa estoura o timeout. E a latência varia de um jeito que nenhuma API de CRUD varia: às vezes 300 milissegundos, às vezes oito segundos, e a única diferença é o tamanho do texto gerado. Nesse ponto você começa a desconfiar que a analogia com request e response está furada. Está.
No artigo anterior desta série eu falei da física: por que gerar um token é caro, por que o gargalo é a banda de memória e não o poder de cálculo. Aquilo respondeu quanto custa. Este artigo responde por onde passa. A gente vai seguir um token desde o momento em que você aperta Enter até ele voltar como texto na sua tela, etapa por etapa. É o mapa que todos os próximos artigos da série vão preencher.
Guarde o mapa. Ele vale mais que qualquer truque de otimização, porque otimização sem mapa é chute.
etapa 1: seu texto não entra como texto
A primeira coisa que acontece com o seu prompt é a mais ignorada de todas. O modelo não lê letras nem palavras. Ele lê números.
Antes de qualquer conta, um componente chamado tokenizer quebra o seu texto em pedaços chamados tokens e troca cada pedaço por um id inteiro. E esses pedaços não são o que a intuição sugere. Um token não é uma letra nem uma palavra: é uma unidade estatística, geralmente um pedaço de palavra. A palavra "inconstitucional" pode virar quatro ou cinco tokens. A palavra "de" é um token só. Um espaço em branco costuma andar grudado no token seguinte.
O algoritmo mais comum pra isso, o BPE (byte pair encoding), funciona por um princípio que quem leu meu artigo sobre o algoritmo de Huffman vai reconhecer na hora: dar representação curta pro que aparece muito. Huffman dá códigos curtos aos caracteres frequentes; o BPE funde os pares de bytes mais frequentes em tokens únicos até formar um vocabulário fixo. É codificação por frequência, prima direta da compressão. O mesmo tipo de ideia, aplicada pra transformar linguagem em algo que a GPU sabe processar.
Duas consequências práticas caem daqui, e as duas mexem na sua conta. A primeira: o vocabulário tem tamanho fixo, tipicamente dezenas de milhares de tokens, às vezes mais de cem mil. Guarde esse número, ele volta na etapa 4. A segunda: português rende menos que inglês. Os tokenizers foram treinados majoritariamente em inglês, então o mesmo texto traduzido pro português quase sempre vira mais tokens. Mais tokens é mais custo e mais latência, pelo simples fato de escrever na língua errada pro tokenizer. É o tipo de detalhe que não aparece em nenhum diagrama de arquitetura e mesmo assim aparece na fatura.
etapa 2: o token vira geometria
Cada id de token agora passa por uma tabela de embeddings e vira um vetor. Não um número, um vetor: uma lista de centenas ou milhares de valores em ponto flutuante. Um modelo de 7 bilhões de parâmetros costuma trabalhar com vetores de uns 4 mil valores por token.
O que aconteceu aqui é sutil e importante. O texto virou geometria. Cada token agora é um ponto num espaço de milhares de dimensões, e a distância entre esses pontos carrega significado. Palavras que aparecem em contextos parecidos moram perto. É essa representação numérica, e não a string original, que vai passar por todo o resto do caminho.
Ninguém "programou" onde cada palavra fica nesse espaço. As posições saíram do treinamento. Isso já adianta um tema que a série vai perseguir mais à frente: quando você serve um modelo, está movimentando esses vetores pela memória o tempo todo, e o tamanho deles é parte do motivo de a inferência ser pesada.
etapa 3: as camadas, onde o dinheiro queima
Agora os vetores entram na parte cara. A pilha de camadas do transformer.
Cada camada faz duas coisas: um mecanismo de atenção, que deixa cada token olhar pros outros e decidir de quais depende, e uma rede feed-forward, que processa o resultado. Depois passa pra próxima camada, que repete, e a próxima, dezenas de vezes. Um modelo grande tem muitas dezenas dessas camadas empilhadas.
Não vou abrir a atenção por dentro aqui, ela merece artigo próprio e vai ter. O que importa pro mapa é onde o custo mora. Lembra do artigo anterior, o teto de banda de memória, os 14 gigabytes de pesos que sobem da VRAM pra gerar cada token? É aqui que eles sobem. Cada camada tem seus pesos, e processar um token significa passar por todos eles. É neste bloco que a conta de GPU é queimada, camada após camada, multiplicação após multiplicação.
Segura essa imagem, porque a etapa 6 vai dar o nó que explica a conta inteira.
etapa 4: o modelo não escolhe uma palavra, ele gera uma aposta
Depois da última camada, o modelo produz um número pra cada token possível do vocabulário. Lembra das dezenas de milhares de tokens da etapa 1? Pois é: a saída bruta do modelo é um vetor com um valor pra cada um deles. Esses valores se chamam logits.
Passe esse vetor por uma normalização e ele vira uma distribuição de probabilidade. O modelo não apontou uma palavra. Ele te entregou uma aposta sobre todas as palavras ao mesmo tempo: 12% de chance de ser "casa", 4% de ser "carro", uma fração minúscula pra cada um dos milhares restantes. O modelo, no fundo, faz uma coisa só, e faz bilhões de vezes: prever a probabilidade do próximo token.
Isso reorganiza a cabeça de quem acha que o modelo "sabe" a resposta. Ele não sabe. Ele estima. Cada palavra que sai é uma amostra tirada de uma distribuição, não um fato recuperado de algum lugar.
etapa 5: alguém precisa escolher
Ter uma distribuição não é ter um token. Alguém precisa escolher um. Essa etapa se chama sampling, e ela é mais decisiva do que parece.
A escolha mais óbvia seria pegar sempre o de maior probabilidade. Funciona, mas produz texto repetitivo e sem graça. Então entram os controles que você provavelmente já configurou sem pensar muito: temperatura, que achata ou aguça a distribuição, e top-p, que corta a cauda dos improváveis antes de sortear. Mexer nesses botões é mexer em quanto o modelo ousa.
E aqui mora uma armadilha que a série vai encarar de frente lá na frente: a mesma pergunta, com sampling, pode dar respostas diferentes a cada chamada. Pra quem veio de sistemas onde a mesma entrada tem que dar a mesma saída sempre, e eu venho desse mundo, isso é um susto. Guardo o assunto do determinismo pra um artigo dedicado, mas quero que você já saiba que a variação nasce aqui, nesta etapa, por decisão de projeto e não por acaso.
etapa 6: de volta pra texto, e de volta pro começo
O token escolhido é um id inteiro. O detokenizer faz o caminho de volta da etapa 1 e o transforma em texto: um pedaço de palavra que aparece na sua tela. Aquele caractere que vazou no cursor piscando.
E agora o nó que explica tudo. Esse token recém-gerado é anexado ao final da sua sequência, e a sequência inteira volta pra etapa 3 pra gerar o próximo token. E o próximo. E o próximo. Cada palavra da resposta é uma volta completa por todas as camadas do modelo.
É isso que a palavra autoregressivo quer dizer, sem o jargão: o modelo se alimenta da própria saída pra dar o próximo passo. Um Enter não gerou uma resposta. Ele disparou um loop que roda uma vez por token, e cada volta paga o pedágio inteiro de memória da etapa 3.
Repare que existe uma assimetria que o artigo anterior já tinha antecipado. A primeira passada, quando o modelo lê o seu prompt inteiro de uma vez, acontece em paralelo: todos os tokens de entrada percorrem as camadas juntos. Isso tem nome, prefill. O loop que vem depois, gerando um token por vez, é o decode. Ler o prompt é uma passada; gerar a resposta são centenas de passadas. Mesmo caminho no mapa, custo completamente diferente.
vamos medir, no estilo conta de padaria
Chega de adjetivo. Número, que é a marca desta série.
Imagine uma resposta de 500 tokens, coisa de um parágrafo mais generoso. Quantas vezes o loop da etapa 6 roda? 500 vezes. E cada volta, como o artigo anterior mostrou, relê todos os pesos do modelo da memória. Num modelo de 7 bilhões de parâmetros em FP16, são 14 gigabytes por volta.
memória movida  =  voltas do loop  x  pesos por volta
memória movida  =  500 tokens  x  14 GB
memória movida  =  7 terabytes
Sete terabytes de tráfego de memória pra cuspir um parágrafo. Não porque o texto é grande, o texto tem alguns kilobytes. Mas porque a estrutura da geração obriga a reler o modelo inteiro a cada palavra. Esse é o custo que não aparece quando você pensa em "é só uma chamada de API".
E a conta te entrega, de graça, a intuição que separa quem dimensiona certo de quem leva susto: o custo de uma resposta cresce com o número de tokens gerados, não com o tamanho do prompt. Dobrar a saída dobra o número de voltas. Dobrar a entrada só encarece a primeira passada, que é barata. É por isso que resumir um texto gigante é rápido e gerar um texto gigante é lento, mesmo sendo "o mesmo modelo".
o diagrama: a viagem inteira em uma figura
O desenho abaixo é o mapa completo. O prompt entra, é tokenizado, vira vetores, atravessa as camadas uma vez em paralelo (prefill), e então o loop de geração assume: gera um token, detokeniza, anexa, volta pras camadas, de novo e de novo, até a resposta terminar (decode).
Um detalhe do mapa que vale um artigo inteiro mais à frente: repare que a cada volta o loop reprocessa a sequência que só cresce. Sem um truque pra guardar o trabalho já feito, o custo explodiria. Esse truque tem nome, KV cache, e é o próximo capítulo da série.
request contra loop, no código
A diferença entre os dois modelos mentais aparece no jeito que você chama o modelo. O reflexo de tratar como request trava a experiência:
// ❌ trata IA como request/response: espera a resposta inteira ficar pronta
var resposta = await chat.CompleteAsync(prompt);
Console.WriteLine(resposta.Text);
// o usuário encara a tela parada por 8 segundos
// e o timeout de 2s que você herdou do banco simplesmente estoura
Consumir o loop do jeito que ele existe muda o jogo:
// ✅ consome o fluxo token a token, do jeito que o modelo produz
await foreach (var update in chat.CompleteStreamingAsync(prompt))
    Console.Write(update.Text);
// o primeiro token chega rápido, a resposta se forma na frente do usuário
// você mede time-to-first-token, não só o tempo total
Se isso te lembrou um produtor e um consumidor de fluxo, você está certo, e não é coincidência. Streaming de tokens é a mesma disciplina de async e canais no .NET que a gente já discutiu neste espaço. Um modelo que gera texto é uma fonte assíncrona de eventos, e tratar como tal é o que separa uma interface que responde de uma que congela. Vou puxar esse fio num artigo próprio sobre backpressure, quando o cliente é mais lento que o modelo.
por que quem decide deveria ler isto
Você pode estar pensando: interessante, mas eu chamo uma API, o provedor que cuide do loop. Justo. Até o dia em que a conta ou a latência forçam uma explicação.
O mapa responde as três perguntas que sempre aparecem. Por que a feature de gerar respostas longas custa mais que a de classificar texto? Porque classificar é quase só prefill, uma passada, enquanto gerar são centenas de voltas no loop. Por que a latência é tão imprevisível? Porque ela depende do número de tokens gerados, que muda a cada resposta. Por que meu timeout padrão não serve? Porque ele foi pensado pra uma operação, não pra um loop de duração variável.
Quem enxerga o mapa para de tratar sintoma e passa a projetar pra causa. O timeout vira uma conta por token, não mais aquele número fixo que você herdou do banco. O orçamento passa a olhar tokens de saída. E a interface já nasce pensada pra streaming, porque o loop é a natureza da coisa e não um detalhe de implementação. Já falei sobre medir latência de IA em produção quando escrevi sobre ir de batch pra tempo real; a diferença é que lá a gente mediu o tempo por fora, e aqui a gente abriu a caixa e viu de onde ele nasce.
conclusão: o mapa que sustenta a série
Um Enter não é um request. É um loop autoregressivo que passa o seu texto por seis etapas, tokenizar, transformar em vetor, atravessar as camadas, virar uma distribuição de probabilidade, amostrar um token e devolver texto, e então repete a parte cara uma vez por palavra até terminar.
Esse mapa não é curiosidade. É a base pra tudo que vem: o KV cache existe pra baratear as voltas do loop, o batching pra dividir o pedágio de memória entre muita gente de uma vez, a quantização pra encolher os pesos que sobem a cada volta. Todos os próximos temas são otimizações de alguma etapa que você acabou de ver. Sem o mapa, cada um parece um truque solto. Com o mapa, todos são a mesma briga: fazer o loop rodar mais barato.
A galera de sistemas de baixa latência aprendeu faz tempo que você não otimiza o que não entende, e não mede o que não sabe nomear. Agora você sabe nomear cada etapa da viagem. Dá pra começar a medir.
Insights & Takeaways
- Uma chamada de LLM não é request e response, é um loop autoregressivo: cada token gerado obriga uma volta completa pelas camadas do modelo, uma vez por palavra da resposta.
- Seu texto nunca entra como texto. O tokenizer o transforma em ids por frequência, prima da compressão de Huffman, e português rende mais tokens que inglês, o que encarece a mesma frase só pela língua.
- O custo de uma resposta cresce com os tokens de saída, não com o tamanho do prompt. Uma resposta de 500 tokens num modelo 7B move na ordem de 7 terabytes de memória, porque relê o modelo inteiro a cada palavra.
- Ler o prompt (prefill) é uma passada paralela e barata; gerar a resposta (decode) são centenas de passadas sequenciais e caras. Mesmo caminho no mapa, custo oposto.
- Timeout, custo e interface de um produto de IA têm que ser projetados pro loop, não pro request: timeout por token, orçamento por tokens de saída, streaming desde o dia um.
Uma pergunta honesta pra fechar, no espírito de proteger o time antes do incidente: o seu produto de IA trata a resposta do modelo como um request que ou chega inteiro ou falha, ou como um fluxo que você consome e mede token a token? Se for a primeira, o seu primeiro timeout mal calibrado vai te ensinar a diferença do jeito caro.
No próximo artigo a gente entra na primeira grande otimização do mapa: o KV cache, a memória de curto prazo que faz o loop não recomeçar do zero a cada volta, e que domina a conta de memória da inferência.