IA de Alta Performance · Episódio 7
Um Modelo 4x Menor Não é 4x Pior
Quantização de LLM: por que INT8 e Q4 perdem tão pouco, onde fica o degrau abaixo do Q4 e como medir a perda na sua tarefa antes de trocar o modelo.
Neste artigo · 8 seções
- primeiro, o que ela paga: a física de novo
- por que cortar 4x não estraga 4x
- o cardápio, sem sopa de letrinhas
- o diagrama: a rampa e o precipício
- onde ela te trai (a parte que o benchmark do Reddit não mostra)
- vamos medir, porque "roda" não é critério
- conclusão: compressão com conhecimento de causa
- Insights & Takeaways
Todo engenheiro carrega uma intuição de compressão: aperta demais, estraga. Comprimiu um JPEG além da conta, aparece artefato. Reduziu o bitrate do áudio, o prato da bateria vira chiado. A régua mental é linear: cortou 4x o tamanho, espere um estrago proporcional.
Aí você pega um Llama de 8 bilhões de parâmetros, que em FP16 ocupa 16 gigabytes, baixa a versão Q4 de 5, roda as suas perguntas e ele responde... praticamente igual. Não 4x pior. Nem 2x pior. Quase igual, numa fração da memória, mais rápido.
A intuição linear falha aqui, e falha por um motivo que vale a pena entender de verdade, porque no meio do caminho entre "quase igual" e "igual" mora uma armadilha que já quebrou produto em produção. No primeiro artigo desta série eu prometi um texto inteiro sobre quando a quantização compensa e quando ela te trai. É este.
primeiro, o que ela paga: a física de novo
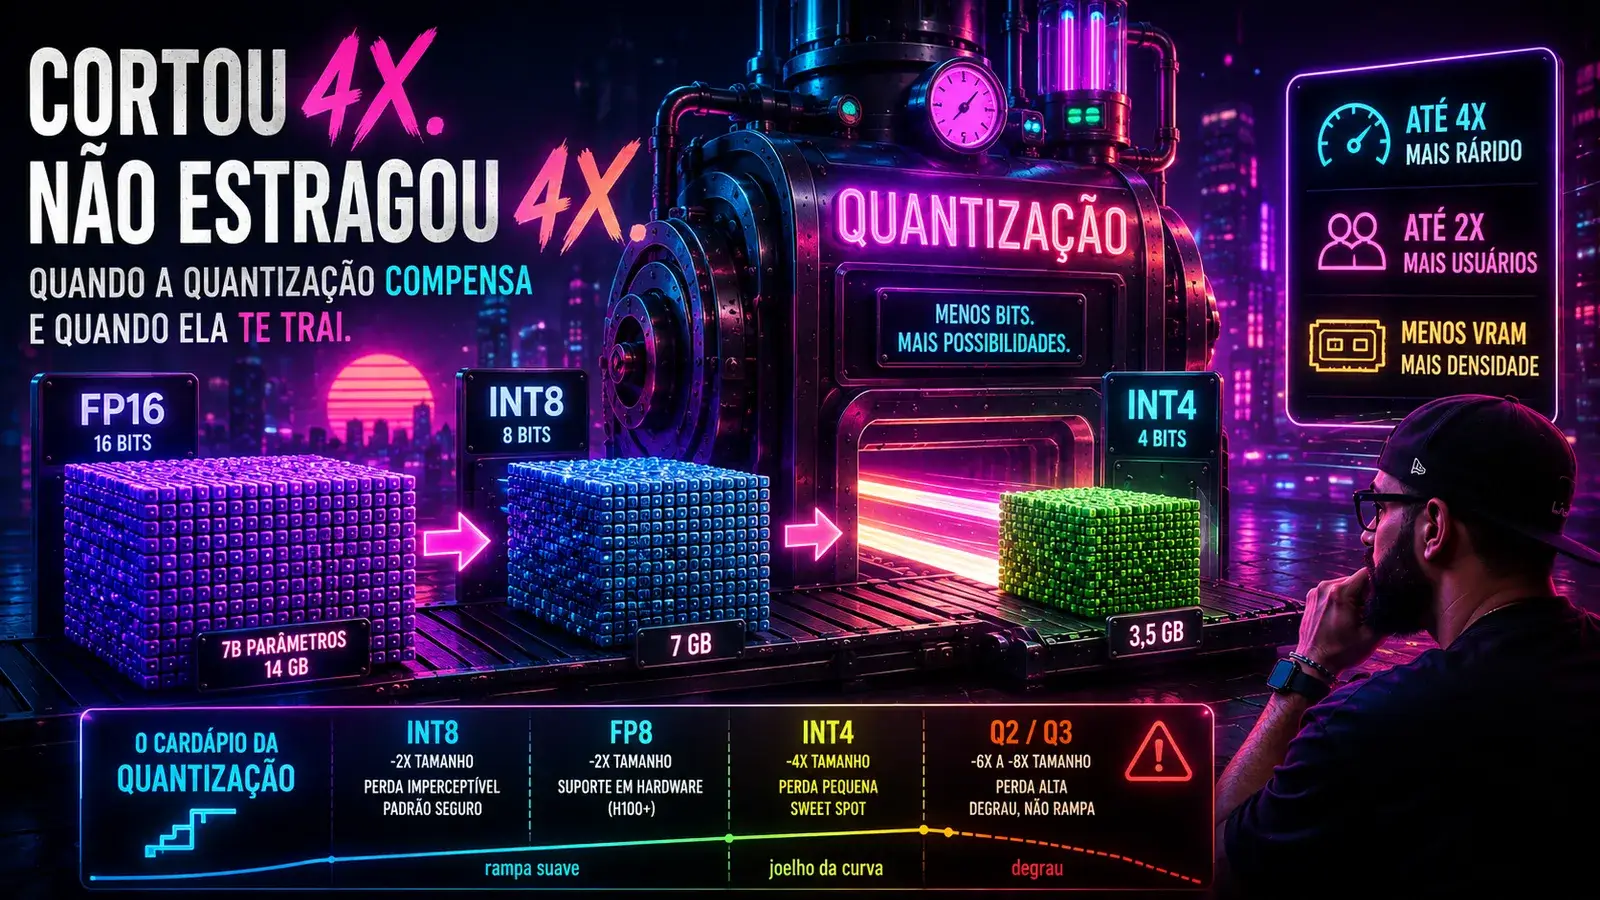
Quantizar é guardar cada peso do modelo com menos bits. FP16 usa 16 bits por parâmetro; INT8 usa 8; INT4, 4. Um 7B sai de 14 GB pra 7, e depois pra 3,5.
Se você acompanhou a série até aqui, já sabe por que isso não é só economia de VRAM. A geração de token é memory-bound: o teto de velocidade é a banda de memória dividida pelos bytes que precisam ser lidos por token, e esses bytes são majoritariamente os pesos. A conta do primeiro artigo, atualizada:
teto de tokens/seg  =  banda de memória / bytes dos pesos

7B em FP16  →  3.000 GB/s / 14 GB   ≈   214 tok/s de teto
7B em INT8  →  3.000 GB/s /  7 GB   ≈   428 tok/s de teto
7B em INT4  →  3.000 GB/s / 3,5 GB  ≈   857 tok/s de teto
Quantizar pra INT4 quadruplica o teto físico de geração sem trocar de hardware. E tem o segundo dividendo, que o artigo do KV cache deixou armado: dá pra quantizar também o próprio cache, os K e V guardados por token, e cortar pela metade a memória que define quantos usuários simultâneos cabem na placa. Quantização mexe nas duas contas que esta série ensinou a fazer: o teto de velocidade e a densidade por GPU.
O preço de tudo isso deveria ser qualidade. A surpresa é quanto.
por que cortar 4x não estraga 4x
Três fatos sobre redes neurais explicam a mágica, e nenhum deles é mágico.
Primeiro: modelos grandes são absurdamente sobre-parametrizados. Há muito mais pesos do que o estritamente necessário pra função que a rede aprendeu, e boa parte da precisão individual de cada peso codifica ruído do treinamento, não conhecimento. Arredondar esse ruído custa pouco.
Segundo: os pesos não estão espalhados uniformemente. A distribuição é concentrada perto de zero, num sino apertado. Uma representação de 4 bits com escala bem escolhida por bloco de pesos cobre esse sino com erro pequeno; os 16 bits originais gastavam a maior parte da própria faixa representando valores que nunca aparecem.
Terceiro, e é aqui que a pesquisa ganhou o jogo: o erro que importa não vem da massa de pesos comuns, vem de uma minoria desproporcional. Tim Dettmers mostrou no paper do LLM.int8() que, a partir de certa escala, os transformers desenvolvem outlier features: umas poucas dimensões com valores enormes, que quebram a quantização ingênua e explicam por que os primeiros experimentos de INT8 destruíam os modelos grandes. A solução dele: tratar essas dimensões à parte, em precisão cheia, e quantizar o resto. Resultado, degradação perto de zero até 175 bilhões de parâmetros.
O AWQ, do grupo do Song Han no MIT, levou a ideia pro INT4 com uma observação fina: os pesos que importam não são os maiores pesos, são os que multiplicam as maiores ativações. Protegendo cerca de 1% dos canais, identificados olhando os dados que passam pela rede e não os pesos em si, o INT4 ficou viável sem retreinar nada. É por isso que o Q4 do seu arquivo GGUF funciona: décadas de intuição de compressão aplicadas ao lugar certo, o erro concentrado onde ninguém sente.
Quem veio da bolsa reconhece o espírito da coisa. Sistema de negociação não representa preço como float solto; representa como inteiro escalado, em ticks, porque a gente aprendeu que representação numérica é decisão de engenharia com consequência auditável, não detalhe de implementação. Quantização é essa mesma disciplina aplicada a 7 bilhões de números de uma vez.
o cardápio, sem sopa de letrinhas
Os nomes assustam mais do que deviam, e o cardápio inteiro cabe em quatro degraus.
INT8 corta pela metade e é o padrão seguro de produção. A perda é imperceptível na prática, e é pra onde você vai quando a VRAM aperta e ninguém quer abrir discussão sobre qualidade. É o território do LLM.int8() e do SmoothQuant.
FP8 também corta pela metade, com a vantagem de ter suporte em hardware nas GPUs recentes, da geração H100 em diante. Serve para os pesos, para as ativações e, o que mais pesa na densidade, para o KV cache.
INT4 é o joelho da curva: quatro vezes menor, com perda pequena mas mensurável, na casa de décimos de ponto de perplexidade. É onde vivem o AWQ, o GPTQ e a família Q4_K_M dos arquivos GGUF, e é a escolha natural quando densidade e custo valem mais que o último fio de qualidade.
Abaixo disso, nos Q2 e Q3, o corte chega a seis ou oito vezes e a perda deixa de acompanhar. Aqui o degrau vira precipício. Quase nunca compensa, e nas raras vezes em que compensa você precisa de uma avaliação forte provando isso, não de uma impressão de que "respondeu bem no teste de mesa".
A regra que sai daí é a que vale guardar: de FP16 até Q4 você desce uma rampa suave; de Q4 para baixo tem um degrau.
Duas notas de rodapé que evitam confusão em reunião. GGUF não é um método de quantização, é o formato de arquivo do llama.cpp que empacota o modelo já quantizado em blocos com escalas (as famílias Q4_K_M, Q5, Q8 que você vê no Hugging Face). E quase tudo que roda hoje é PTQ, quantização pós-treinamento: pega o modelo pronto, calibra com uma amostra de dados, converte. Barato e bom o suficiente na imensa maioria dos casos.
o diagrama: a rampa e o precipício
onde ela te trai (a parte que o benchmark do Reddit não mostra)
A degradação média é pequena. Só que ninguém opera na média, e a perda não se distribui uniforme entre tarefas. Ela se concentra, e se concentra num padrão previsível.
Raciocínio em cadeia sofre primeiro. Matemática de múltiplos passos, código com dependências longas, extração estruturada que não tolera um campo errado. O mecanismo é o de sempre em sistema serial: erro pequeno por token, composto ao longo de uma cadeia longa de decisões, vira erro grande no resultado. Chat casual perdoa um token levemente pior; uma cadeia de raciocínio de trinta passos, não. Os benchmarks de perplexidade, que medem fluência média, seguem bonitos enquanto isso acontece.
Idioma fora do inglês sofre calado. PTQ calibra com uma amostra de dados, e a amostra padrão dos métodos publicados é inglês. Um modelo quantizado com calibração genérica pode degradar mais em português do que qualquer tabela pública sugere, e você só descobre testando na sua língua, com o seu domínio.
E o KV cache quantizado tem a própria pegadinha: em contexto longo, o erro acumulado nos K e V antigos degrada exatamente a habilidade que a janela grande prometia, a de recuperar com precisão algo dito 50 mil tokens atrás.
A regra que destilo dessas três: quanto mais a sua tarefa depende de cadeias longas de dependência (de raciocínio, de idioma raro na calibração, de contexto), mais cedo a quantização morde. E ela morde silenciosamente, porque o modelo não quebra: ele só fica pior, fluente e confiante como sempre.
vamos medir, porque "roda" não é critério
O erro clássico tem esta cara:
// ❌ critério de escolha: coube na placa
// baixou o Q2 porque "o Q4 não cabia junto com o resto"
var modelo = LLamaWeights.LoadFromFile(
    new ModelParams("llama-8b-Q2_K.gguf"));
// rodou, respondeu bonito no teste de mesa, foi pra produção.
// a fluência continua; a taxa de acerto da SUA tarefa foi embora
// e ninguém definiu sequer qual métrica vigiar.
O caminho honesto é um harness de avaliação que compara variantes na sua tarefa, não na impressão:
// ✅ mesma suíte, variantes lado a lado, número antes de decidir
string[] variantes = ["llama-8b-Q8_0.gguf", "llama-8b-Q4_K_M.gguf"];

foreach (var arquivo in variantes)
{
    using var pesos = LLamaWeights.LoadFromFile(new ModelParams(arquivo));
    using var ctx   = pesos.CreateContext(new ModelParams(arquivo));

    var resultado = await SuiteDaMinhaTarefa.RodarAsync(ctx);
    // a suíte: seus casos reais com resposta esperada,
    // acerto exato onde der, julgamento onde não der,
    // + tokens/seg e memória medidos no mesmo passe

    Log($"{arquivo}: acerto {resultado.Acerto:P1} · " +
        $"{resultado.TokensPorSegundo:F0} tok/s · {resultado.MemoriaGb:F1} GB");
}
// a decisão sai da comparação dos números, não do tamanho do arquivo
Repare no que esse harness usa: o LLamaSharp que apresentei no artigo anterior, rodando dentro do processo .NET. Cinquenta casos representativos da sua tarefa já separam um Q4 saudável de um Q2 quebrado, e o custo de montar isso é uma tarde. O custo de não montar é descobrir a degradação pelo usuário, semanas depois, sem saber sequer qual mudança causou.
A propósito: se você usa a API de um provedor grande, essa decisão já foi tomada por você, e o quantizado que você recebe foi avaliado por eles. A conversa deste artigo é pra quando o modelo roda no seu chão, que era a caixa-preta que ficou fechada quando escrevi sobre IA em baixa latência para casos críticos na série IA First. Lá, "modelo quantizado" era uma opção de prateleira. Agora você sabe o que tem dentro.
conclusão: compressão com conhecimento de causa
Um modelo 4x menor não é 4x pior porque a informação que importa não estava espalhada pelos 16 bits de cada peso; estava concentrada, e os métodos modernos aprenderam a proteger exatamente o que carrega sinal. INT8 é corte sem dor. Q4 é o joelho da curva, o ponto onde memória, teto de banda e qualidade se encontram, e é onde o ecossistema local inteiro se instalou por bons motivos.
Mas a curva tem um degrau depois do joelho, e a perda não avisa quando chega: ela se esconde nas tarefas de cadeia longa enquanto a perplexidade média sorri. Quantização é das poucas otimizações onde o ganho é físico e garantido (a banda não mente) e o custo é estatístico e silencioso. Tratar os dois lados com o mesmo rigor, medindo a sua tarefa antes de trocar o arquivo, é o que separa economia de acidente.
Insights & Takeaways
- Quantizar mexe nas duas contas da série: corta os bytes lidos por token (o teto de 214 tok/s de um 7B FP16 vira ~857 em INT4) e encolhe pesos e KV cache, aumentando quantos usuários cabem por placa.
- A perda não é proporcional ao corte porque o erro se concentra: LLM.int8() isola as dimensões outlier, AWQ protege o ~1% de pesos que multiplica as maiores ativações. O resto era precisão gasta em ruído.
- A curva tem forma: FP16 → INT8 é imperceptível, INT8 → Q4 perde décimos mensuráveis, Q4 → Q2 é precipício. O joelho fica no Q4, e é por isso que o mundo local mora lá.
- A degradação se esconde onde o benchmark médio não olha: raciocínio em cadeia, idioma fora da calibração (português incluso), recuperação em contexto longo com KV quantizado. Fluência não é acerto.
- Critério de escolha é eval da sua tarefa, não "coube na placa": cinquenta casos reais comparando Q8 e Q4 no mesmo harness custam uma tarde e compram a diferença entre economia e um incidente que ninguém viu chegar.
A pergunta honesta da vez: do modelo que está rodando aí no seu produto, você sabe dizer qual quantização ele usa e quanto ela custou na sua métrica de qualidade? Se a resposta é "veio assim do Hugging Face e funciona", você está operando com um número que nunca mediu.
No próximo artigo a série sobe um andar: com teto de banda, KV cache e quantização no bolso, dá pra encarar o trade-off que governa todo serving de IA. Throughput, latência e custo: você só escolhe dois, e fingir que escolhe três é como o mercado queima dinheiro em GPU hoje.