IA de Alta Performance · Episódio 12
O Lote Que Nunca Fecha - O Truque Que Faz Uma GPU Atender 10x Mais Gente
Como o continuous batching admite requisições entre um passo e outro do decode e faz a mesma GPU atender de 10 a 20 vezes mais gente, e o preço disso.
Neste artigo · 9 seções
- por que existe lote, em uma linha
- o jeito antigo: o lote como fornada
- a observação que mudou tudo
- o tamanho do ganho, e de onde ele vem
- o diagrama: fornada contra fluxo
- o código que denuncia o servidor antigo
- o preço: a fornada tinha uma virtude
- a consequência que ninguém anuncia: a memória virou o palco
- Insights & Takeaways
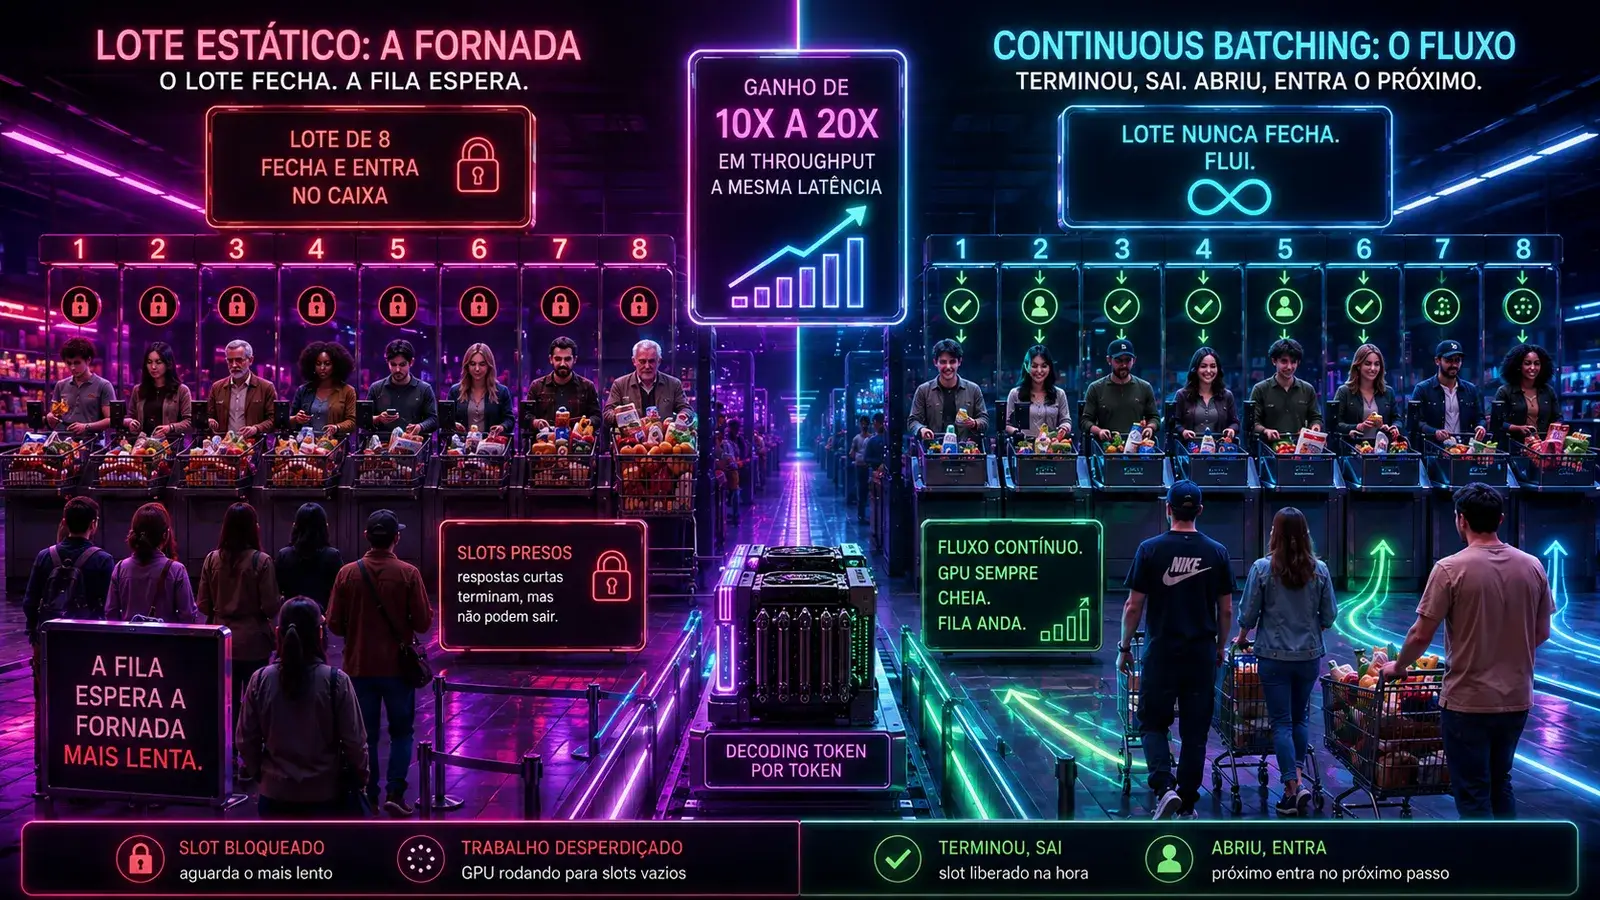
Imagine um caixa de supermercado com uma regra estranha: ele atende oito clientes de uma vez, mas só libera a fila quando os oito terminarem. O cliente que veio comprar um refrigerante paga em trinta segundos e fica parado, esperando o senhor da compra do mês passar duzentos itens. E a fila atrás não anda, porque a regra é o grupo fechar antes de o próximo entrar.
Ninguém desenharia um supermercado assim. Foi exatamente assim que os primeiros servidores de inferência de LLM funcionaram, e uma parte dos que estão em produção por aí funciona até hoje.
No artigo anterior a série abriu a sala de máquinas pelo jeito mais barato de servir uma resposta, que é não gerar de novo o que já foi gerado. Este aqui é sobre a segunda peça da sala de máquinas, e é a que mais move o ponteiro: como o servidor decide quem entra no lote e quando. A resposta certa mudou em 2022, o ganho foi de ordem de grandeza, e o mecanismo cabe numa ideia de fila que qualquer engenheiro de backend já conhece.
por que existe lote, em uma linha
Quem acompanhou a temporada passada já tem a física no bolso: gerar um token é ler todos os pesos do modelo da memória, e essa leitura custa o mesmo para uma requisição ou para trinta. Agrupar requisições multiplica os tokens produzidos pelo mesmo tráfego de memória. Numa carga limitada por banda, o lote é a diferença entre usar uma fração ridícula da placa e usar uma fração decente.
Então o lote precisa existir. A pergunta deste artigo é outra: quando ele abre e quando ele fecha.
o jeito antigo: o lote como fornada
O desenho ingênuo, que era o padrão dos servidores até pouco tempo atrás, trata o lote como fornada de pão. Junta requisições até encher (ou até estourar um tempo de espera), coloca todas no forno, e espera a fornada inteira assar antes de abrir a porta de novo.
O problema mora numa propriedade que pão não tem: as sequências terminam em momentos completamente diferentes. Uma pergunta rende uma resposta de 20 tokens. Outra, no mesmo lote, rende 900. E o texto que esta série martelou desde o começo explica por que isso é fatal: o decode é um loop, um token por passo, e o lote inteiro avança passo a passo junto.
Acompanhe o que acontece com a fornada. No passo 21, a resposta curta terminou. O slot dela no lote não pode ser liberado, porque a regra é a fornada fechar junta. Então a GPU segue rodando os próximos 880 passos com um lugar morto no lote, depois dois, depois cinco, conforme as outras respostas vão acabando. No fim, a fornada está rodando quase vazia, no custo de memória e leitura de uma fornada cheia, enquanto a fila de requisições novas espera do lado de fora.
O efeito composto é cruel. O throughput real despenca, porque a placa passa boa parte do tempo processando slots vazios. E a latência de quem chega piora, porque a requisição nova espera a fornada mais lenta do mundo terminar para conseguir entrar. É o cliente do refrigerante preso atrás da compra do mês, dos dois lados do caixa.
a observação que mudou tudo
Em 2022, o pessoal do Orca, um trabalho de Seoul National University, publicou a observação que parece óbvia depois de dita, como toda boa ideia de sistemas.
O modelo não processa "requisições". Ele processa passos. A cada iteração do loop, ele gera um token para cada sequência do lote, e o que cada sequência precisa para continuar não está no lote: está no KV cache dela, aquela memória de curto prazo que o quinto artigo da série destrinchou. As sequências de um lote não compartilham nada além do momento. São estados independentes que, por conveniência, atravessam os pesos juntos.
Se as sequências são independentes, a fornada é uma restrição inventada. Nada obriga o lote a fechar. Entre um passo e outro do loop, o servidor pode fazer duas coisas: tirar do lote a sequência que acabou de terminar, liberando o slot no mesmo instante, e admitir uma requisição da fila naquele slot, no passo seguinte.
O nome técnico é agendamento por iteração (no original, iteration-level scheduling). O nome que pegou no mercado é continuous batching. E a imagem certa é a do caixa decente: terminou, sai; abriu espaço, entra o próximo. O lote nunca fecha. Ele flui.
o tamanho do ganho, e de onde ele vem
O paper do Orca reportou ganhos de mais de uma ordem de grandeza em throughput contra os servidores da época, mantendo a mesma latência. Os números que circulam em benchmarks públicos desde então ficam tipicamente na casa de 10 a 20 vezes, e vale entender de onde sai um número desse tamanho, porque não é mágica de kernel.
O ganho vem inteiro de eliminar espera. Nenhum cálculo ficou mais rápido; nenhum byte a menos é lido por token. O que mudou é que a placa para de gastar passos com slots mortos e a fila para de esperar a fornada fechar. É por isso que o tamanho do ganho depende da variância dos comprimentos das suas respostas: se todas as respostas do seu sistema têm o mesmo tamanho, a fornada quase não desperdiça e o ganho é modesto. Com tráfego real, em que uma resposta tem 15 tokens e a vizinha tem 2 mil, o desperdício da fornada é gigantesco, e eliminar esse desperdício é o ganho.
Quem trabalha com backend já viu essa peça de teatro em outro palco. É a diferença entre processar mensagens em janelas fechadas e processar em fluxo com admissão contínua, a mesma conversa de produtor e consumidor que escrevi no artigo sobre System.Threading.Channels. O continuous batching é um producer-consumer clássico em que o consumidor tem capacidade de N slots e a admissão acontece por slot, não por janela. A novidade não é o padrão. É perceber que o decode de um LLM permite o padrão.
o diagrama: fornada contra fluxo
o código que denuncia o servidor antigo
A versão fornada, escrita como qualquer um de nós escreveria no primeiro dia:
// ❌ o lote como fornada: espera encher, roda até TODOS terminarem
var lote = new List<Requisicao>();
while (lote.Count < TamanhoDoLote && !prazoEstourou)
    lote.Add(await fila.ReceberAsync());

var geracoes = lote.Select(r => GerarRespostaCompletaAsync(r));
await Task.WhenAll(geracoes);          // a resposta de 20 tokens espera a de 900
// só agora a fila volta a andar
E a versão fluida, que é o que um servidor moderno faz por dentro:
// ✅ o lote que nunca fecha: admissão e saída entre um passo e outro
var ativas = new List<Sequencia>();

while (true)
{
    // saída: quem terminou libera o slot AGORA
    foreach (var s in ativas.Where(s => s.Terminou).ToList())
    {
        await EntregarAsync(s);
        ativas.Remove(s);
    }

    // admissão: slot vago + memória pra KV cache = próximo da fila entra
    while (ativas.Count < SlotsMaximos
           && MemoriaLivreParaKvCache()
           && fila.TryReceber(out var nova))
        ativas.Add(Sequencia.Iniciar(nova));

    if (ativas.Count == 0) { await fila.AguardarAsync(); continue; }

    await ExecutarUmPassoDeDecode(ativas);   // 1 token pra cada sequência ativa
}
Repare em duas coisas nesse loop, porque as duas viram assunto adiante. A primeira é a condição MemoriaLivreParaKvCache: a admissão não é limitada pelo cálculo, é limitada pela memória, porque cada sequência nova traz o próprio KV cache. A segunda é que Sequencia.Iniciar esconde um prefill inteiro, e prefill é a fase cara em cálculo.
o preço: a fornada tinha uma virtude
Continuous batching não é almoço grátis, e a honestidade de trade-off desta série exige mostrar onde ele cobra.
Quando uma requisição nova entra no lote, o prompt dela precisa ser processado. Esse prefill é um pico de trabalho pesado, e ele acontece no meio do fluxo de decode de todas as outras sequências, que estavam avançando num ritmo constante de um token por passo. O resultado, se o agendador for ingênuo, é que todo mundo que estava recebendo resposta sente um engasgo cada vez que alguém novo entra. No painel, isso aparece como um pico de latência entre tokens que ninguém consegue explicar, porque ele não tem correlação com a carga total, e sim com admissões.
A fornada, com todos os seus defeitos, não tinha esse problema: o prefill de todo mundo acontecia junto, no início, e o decode fluía limpo depois.
Esse é exatamente o problema que o agendamento com prefill fatiado ataca, aquele movimento de empurrar a fronteira que citei no artigo do trilema: quebrar o prefill da requisição que entra em pedaços e intercalar com o decode das que já estão dentro, pagando a admissão em prestações em vez de à vista. O detalhe fica para o artigo de saturação, mais adiante na temporada. Por ora, o que importa é saber que o lote fluido trouxe um inquilino novo para dentro do loop, e ele chuta a porta se o agendador deixar.
a consequência que ninguém anuncia: a memória virou o palco
Feche a conta do que o continuous batching realmente fez. Antes, o limite de quanta gente a placa atendia era o desenho do lote. Agora, o lote aceita qualquer um que caiba, e "caber" significa uma coisa só: ter memória livre para o KV cache da sequência nova.
Ou seja, o truque de agendamento transferiu o gargalo para a memória. A pergunta que define a capacidade do seu serving deixou de ser "qual o tamanho do lote" e virou "quantos KV caches cabem ao mesmo tempo", que é a conta que fechei no artigo do vilão da conta de GPU: numa placa de 80 gigabytes com um 7B, sobram uns 66 para os caches, e é esse número que decide quantas sequências o lote fluido consegue manter vivas.
E aqui aparece um problema que o leitor atento talvez já tenha farejado. Se a capacidade agora é memória, e a memória de cada sequência cresce token a token, sem que ninguém saiba de antemão quantos tokens a resposta vai ter, como é que o servidor aloca isso? Reservando o máximo possível para cada uma? Porque se for assim, a placa fica cheia de reserva não usada, e o lote fluido morre por asfixia de uma memória que está livre, só que presa.
Foi exatamente assim que os servidores faziam. E o desperdício medido era tão grande que resolvê-lo rendeu o servidor de inferência mais usado do mundo. É o próximo artigo, e a solução foi roubada de um lugar que você conhece bem: o seu sistema operacional.
Insights & Takeaways
- O lote estático funciona como fornada: junta requisições, roda até todas terminarem. Como as respostas têm comprimentos completamente diferentes, a fornada passa a maior parte do tempo com slots mortos, no custo de uma fornada cheia, com a fila parada do lado de fora.
- A observação do Orca (OSDI 2022): o modelo processa passos, não requisições. As sequências de um lote são estados independentes no KV cache, então nada obriga o lote a fechar. Entre um passo e outro, quem terminou sai e quem está na fila entra. É o continuous batching.
- O ganho é de ordem de grandeza (a casa citada é 10 a 20x) e vem inteiro de eliminar espera, não de acelerar cálculo. Por isso ele depende da variância dos comprimentos: tráfego real, com respostas de 15 e de 2 mil tokens misturadas, é onde a fornada mais desperdiça.
- O preço é a interferência de admissão: o prefill de quem entra engasga o decode de quem já estava dentro. É o pico de latência entre tokens que não se correlaciona com carga, e é o problema que o prefill fatiado ataca.
- O truque transferiu o gargalo do agendamento para a memória: a capacidade do serving virou "quantos KV caches cabem vivos ao mesmo tempo". Gerenciar essa memória sem desperdício é o assunto do próximo artigo.
Uma pergunta honesta pra fechar: você sabe se o serving que atende o seu produto hoje faz admissão por iteração ou ainda trabalha em fornada? Se você usa vLLM, TGI ou um provedor grande, a resposta é por iteração e você herdou o ganho sem saber. Se alguém no seu time embrulhou o modelo num loop caseiro de Task.WhenAll, aquele número de 10 a 20x está na mesa, esperando uma tarde de refatoração de fila.
No próximo artigo, a pergunta que este deixou armada: como alocar uma memória que cresce token a token, sem saber o tamanho final, sem desperdiçar a placa em reservas. A resposta veio de uma ideia dos anos 60, e o desperdício que ela eliminou era de até 80%.