IA de Alta Performance · Episódio 13
A Ideia de 60 Anos Que Domou a Memória da GPU
O PagedAttention do vLLM levou a paginação dos sistemas operacionais ao KV cache e cortou o desperdício de memória da GPU de até 80% para menos de 4%.
Neste artigo · 8 seções
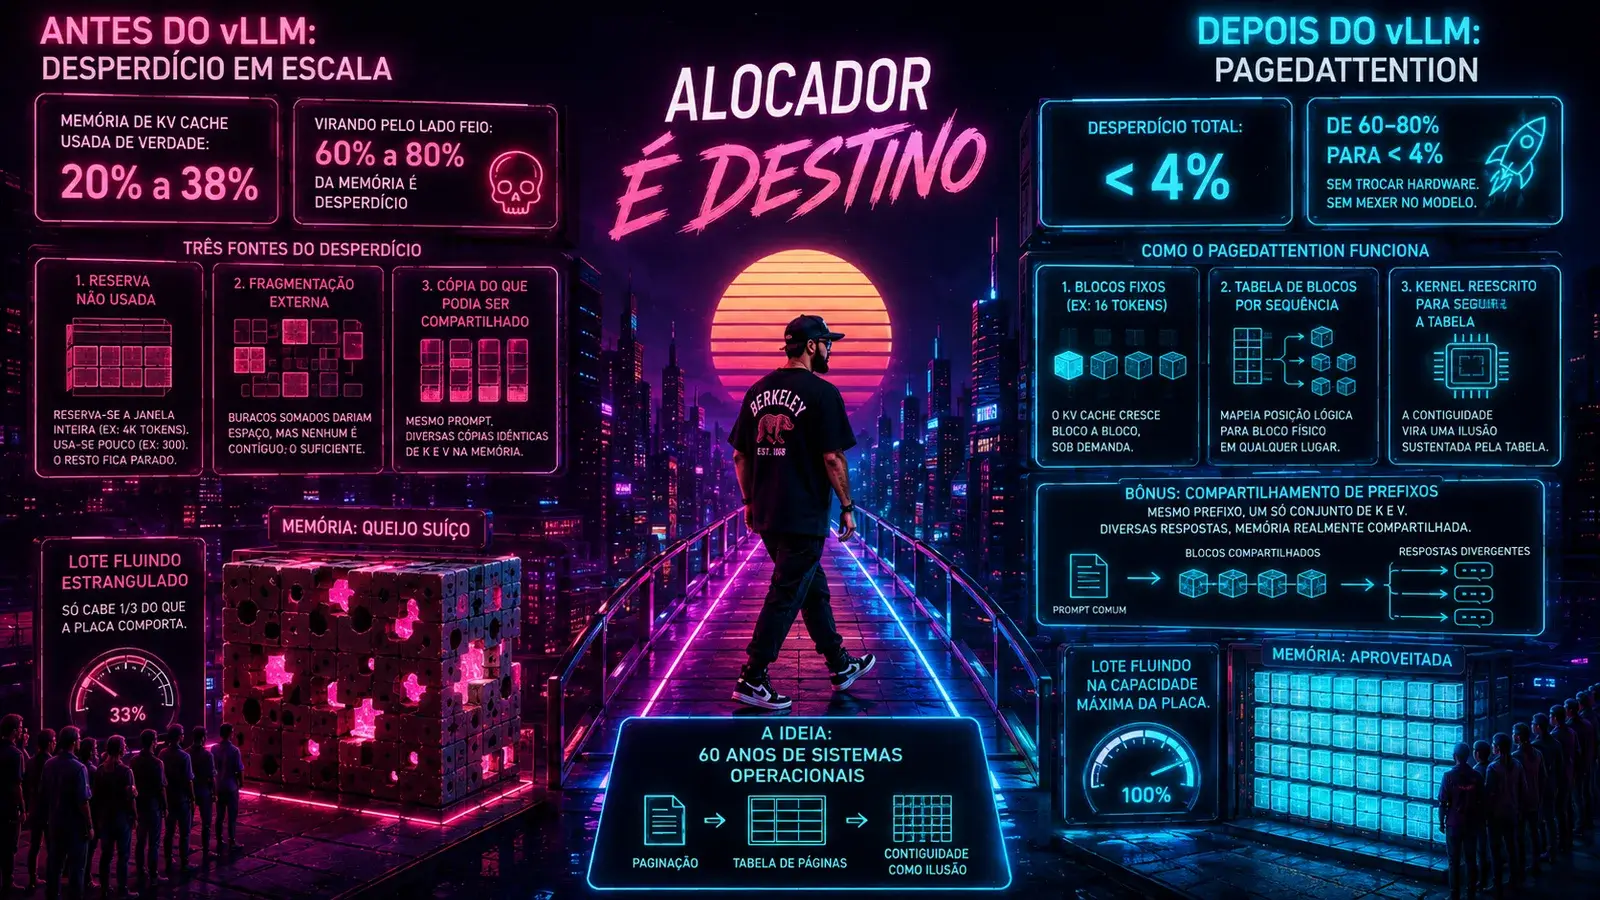
Em 2023, um grupo de Berkeley mediu quanto da memória reservada para KV cache nos servidores de inferência da época estava sendo usada de verdade. O resultado ficou entre 20% e 38%.
Agora vire o número pelo lado feio: de 60% a 80% da memória mais disputada do serving de IA era desperdício. Não memória fazendo trabalho ruim; memória presa em reservas que nunca seriam usadas, em buracos entre alocações, em cópias do mesmo conteúdo. Na placa mais cara do rack, no recurso que, como esta série vem mostrando, decide quanta gente cabe.
A solução que eles publicaram virou o vLLM, que virou o servidor de inferência mais usado do mundo. E o que me faz gostar dessa história o suficiente para dedicar um artigo a ela não é o resultado. É de onde a solução veio: de uma ideia que os sistemas operacionais usam desde os anos 60, e que qualquer pessoa que estudou computação viu em alguma aula e arquivou como teoria. O problema tinha 60 anos. A solução também. Só faltava alguém perceber que era o mesmo problema.
o problema que o artigo anterior deixou armado
No texto sobre o lote que nunca fecha, a série mostrou como o continuous batching transferiu o gargalo do serving para a memória: a capacidade virou "quantos KV caches cabem vivos ao mesmo tempo". O que ficou sem resposta foi como alocar essa memória, e o motivo de a pergunta ser difícil é que o KV cache tem um formato de crescimento hostil.
Ele cresce token a token, um bloco de bytes por passo do decode. Ninguém sabe de antemão o tamanho final, porque ninguém sabe quantos tokens a resposta vai ter. E o mecanismo de atenção, do jeito que os kernels foram escritos, exigia que esse tensor fosse contíguo na memória, um bloco só, sem furos.
Junte as três propriedades e você tem o pesadelo de qualquer alocador: um objeto de tamanho desconhecido, que cresce sozinho, e que precisa ser contíguo.
como os servidores resolviam, e o preço
A resposta dos servidores pré-vLLM foi a resposta clássica de quem precisa de contiguidade e não sabe o tamanho: reservar o pior caso. Chegou uma sequência, o servidor separava um bloco contíguo dimensionado para o máximo que ela poderia crescer, a janela de contexto inteira.
O desperdício vem em três parcelas, e vale nomear cada uma.
A primeira é a reserva não usada. A janela permite 4 mil tokens; a resposta média tem 300. Os outros 3.700 slots ficam reservados, intocados, até a sequência terminar. É memória que o painel mostra como ocupada e que nunca recebeu um byte. O quinto artigo desta série avisou que parte relevante da VRAM "em uso" estava apenas reservada, e prometeu voltar ao assunto. É aqui.
A segunda é a fragmentação externa. Sequências chegam e terminam o tempo todo, com reservas de tamanhos diferentes, e a memória vira um queijo suíço: os buracos somados dariam espaço para várias sequências novas, mas nenhum buraco individual é contíguo o suficiente para uma reserva inteira. Quem já brigou com heap conhece o filme, e eu já contei essa história no contexto do garbage collector do .NET, que compacta a heap exatamente para não morrer disso. Na GPU não tinha quem compactasse.
A terceira é a cópia do que podia ser compartilhado. Duzentas requisições com o mesmo system prompt de 2 mil tokens guardavam duzentas cópias idênticas dos mesmos K e V, porque cada reserva era um mundo isolado.
Some as três parcelas e chega-se aos 60 a 80% medidos. E repare no efeito sistêmico, que é o que importa: o continuous batching admite gente enquanto há memória livre. Com a memória afogada em reserva e fragmento, o lote fluido rodava com um terço da lotação que a placa comportava. O truque do artigo anterior estava sendo estrangulado por um alocador.
a ideia roubada
Agora recue sessenta anos. Os sistemas operacionais dos anos 60 enfrentavam literalmente o mesmo enunciado: programas que exigiam memória contígua, com tamanhos variados e imprevisíveis, entrando e saindo o tempo todo, fragmentando a memória física até o sistema não conseguir carregar mais nada.
A solução que a área encontrou, e que está rodando agora na máquina em que você lê isto, foi quebrar o vínculo entre o endereço que o programa enxerga e o endereço físico real. Memória virtual com paginação: o espaço de cada programa é dividido em páginas de tamanho fixo, uma tabela mapeia cada página lógica para um quadro físico qualquer, e a contiguidade vira uma ilusão que a tabela sustenta. O programa acredita ter um bloco contínuo; fisicamente, os pedaços estão espalhados onde houver espaço.
O PagedAttention é essa ideia, transplantada sem disfarce. O KV cache de cada sequência é dividido em blocos de tamanho fixo, na casa de 16 tokens por bloco. Uma tabela de blocos por sequência mapeia a posição lógica para o bloco físico, que pode estar em qualquer lugar da VRAM. O kernel de atenção foi reescrito para seguir a tabela em vez de exigir contiguidade. E a alocação passa a ser sob demanda: a sequência ganha um bloco novo quando enche o anterior, não uma reserva no nascimento.
Confira o que acontece com cada parcela do desperdício. A reserva de pior caso morre, porque ninguém reserva mais nada: aloca-se o que se usa, bloco a bloco. A fragmentação externa morre por definição, porque todos os blocos têm o mesmo tamanho e qualquer buraco serve para qualquer um. O que sobra é a fragmentação interna do último bloco de cada sequência, em média meio bloco de uns 8 tokens, e o paper mede o desperdício total em menos de 4%.
De 60 a 80% de desperdício para menos de 4%, sem trocar hardware, sem tocar no modelo. Alocador é destino.
o bônus que paga o ingresso: compartilhar
A tabela de indireção compra uma segunda coisa, e ela conecta direto com um artigo recente desta série.
Se duas sequências têm o mesmo prefixo, o system prompt idêntico que abre toda requisição do seu sistema, as tabelas das duas podem apontar para os mesmos blocos físicos. Uma cópia dos K e V do prefixo, referenciada por todo mundo, com um contador de referências por bloco. Quando uma sequência precisa divergir, o servidor copia só o bloco afetado antes de escrever, o copy-on-write que o seu sistema operacional faz com processos desde sempre.
O cache de prefixo que defendi no artigo de abertura desta temporada, aquele ganho garantido com risco zero, é viabilizado na prática por isso. Sem paginação, compartilhar prefixo exigiria contorcionismo com tensores contíguos; com a tabela, é um apontamento. O mesmo mecanismo serve quando o produto pede várias respostas alternativas do mesmo prompt: o prompt fica em blocos compartilhados e só as continuações divergem, cada uma pagando apenas os próprios blocos.
o diagrama: a reserva contra a tabela
o código: a diferença entre reservar e mapear
O contraste cabe em duas estruturas de dados, e a segunda é reconhecível para qualquer um que já implementou um pool.
// ❌ a reserva de pior caso: contígua, dimensionada pela janela
class SequenciaAntiga
{
    // nasce ocupando o máximo que PODERIA usar
    public KvSlot[] Cache = new KvSlot[JanelaMaxima];   // 4.000 slots
    public int TokensUsados;                            // ~300 na média
    // 92% disso nunca será tocado, e nenhum outro usuário pode usar
}
// ✅ a tabela de blocos: aloca o que usa, aponta pra onde couber
class Sequencia
{
public List<int> TabelaDeBlocos = new(); // posição lógica → id de bloco físico
public int TokensUsados;
}
class PoolDeBlocos
{
private readonly Stack<int> _livres; // qualquer bloco serve
private readonly int[] _referencias; // p/ compartilhar prefixo
public int Alugar() => _livres.Pop();
public void Referenciar(int b) => _referencias[b]++;
public void Devolver(int b) { if (--_referencias[b] == 0) _livres.Push(b); }
}
// a sequência pede um bloco novo só quando enche o atual.
// o prefixo comum entra como blocos já referenciados: custo de um apontamento.Quem vive de .NET reconhece o espírito do ArrayPool com contagem de referências. A diferença é o que está sendo poolado: aqui cada bloco carrega os K e V de 16 tokens, e o "aluguel" decide quantos usuários simultâneos a sua GPU atende.
o preço, porque sempre tem
A indireção não é gratuita, e o paper é honesto sobre isso: o kernel de atenção que segue tabela em vez de varrer memória contígua paga um overhead na casa de 20% dentro do kernel, porque os acessos deixam de ser perfeitamente sequenciais e a tabela precisa ser consultada.
Parece caro até colocar na balança o que se compra. O overhead incide sobre o kernel de atenção; o ganho incide sobre a capacidade da placa inteira. Com o desperdício de memória indo de 80% para 4%, cabem duas a quatro vezes mais sequências vivas, o lote do continuous batching engorda na mesma proporção, e o throughput do sistema sobe de 2 a 4 vezes na medição do paper. Trocar 20% de um componente por 2 a 4 vezes o sistema é o tipo de negócio que se aceita antes de o interlocutor terminar a frase.
A lição de arquitetura embutida vale mais que o número: contiguidade é uma exigência cara, e quase sempre ela é uma exigência do código, não do problema. O SO aprendeu isso nos anos 60. O serving de IA reaprendeu em 2023. E o seu sistema, seja ele qual for, provavelmente tem em algum lugar uma reserva de pior caso que existe porque alguém exigiu contiguidade que o problema não pedia.
Insights & Takeaways
- O KV cache é o pesadelo do alocador: cresce token a token, tamanho final desconhecido, e os kernels exigiam contiguidade. A resposta clássica, reservar o pior caso, deixava a memória mais cara do serving com 20 a 38% de uso real.
- O desperdício tinha três parcelas: reserva não usada (janela de 4 mil para resposta de 300), fragmentação externa (buracos que não servem a ninguém) e cópia do que podia ser compartilhado (o mesmo system prompt duplicado por requisição).
- O PagedAttention transplanta a memória virtual dos anos 60: blocos fixos de ~16 tokens, tabela por sequência mapeando lógico para físico, alocação sob demanda. Fragmentação externa morre por definição; o desperdício total cai para menos de 4%.
- A tabela compra o compartilhamento de graça: prefixo comum vira blocos referenciados com copy-on-write, que é o que torna o cache de prefixo do artigo de abertura da temporada barato de verdade.
- O preço é ~20% de overhead dentro do kernel de atenção, pago em troca de 2 a 4 vezes mais throughput do sistema, porque cabem mais sequências vivas e o lote contínuo engorda. Alocador é destino: a mesma GPU, o mesmo modelo, e a capacidade multiplicada por uma estrutura de dados.
Uma pergunta honesta pra fechar, e ela vale além de IA: onde, no seu sistema, existe uma reserva de pior caso que está presa porque alguém exigiu contiguidade, ou pré-alocação, que o problema não pedia? A resposta do serving de IA para essa pergunta valia 4 vezes a capacidade da placa. A do seu sistema pode não valer 4 vezes, mas quase nunca vale zero.
No próximo artigo, a sala de máquinas ataca a latência por um ângulo que parece piada até funcionar: usar um modelo pequeno e rápido para chutar os próximos tokens, e deixar o modelo grande apenas conferir. O nome é speculative decoding, o ganho é de 2 a 3 vezes na latência, e a resposta que sai é provadamente a mesma.