IA de Alta Performance · Episódio 5
O Vilão da Sua Conta de GPU Não é o Modelo
O KV cache, não o modelo, decide quantos usuários cabem na GPU: a conta de memória por token e as alavancas para atender mais gente na mesma placa.
Neste artigo · 9 seções
- o loop que se repete e o trabalho que se joga fora
- a conta que ninguém faz antes de dimensionar
- quando o cache fica maior que o modelo
- o diagrama: o que muda com o cache
- as alavancas, e o que cada uma cobra
- vamos medir, antes de comprar
- o que isso muda para quem decide
- conclusão: a memória que ninguém orçou
- Insights & Takeaways
Um modelo de 7 bilhões de parâmetros em FP16 ocupa 14 gigabytes. A placa tem 80. Sobra memória de sobra, o time comemora a folga, sobe o serviço, e umas semanas depois começa a receber erro de memória insuficiente com meia dúzia de conversas simultâneas abertas.
A primeira reação é sempre a mesma: alguém está com vazamento. Não está. A memória sumiu para uma estrutura que não aparece na ficha técnica de nenhum modelo, não entra na conta que a planilha fez, e cresce com uma coisa que o produto adora aumentar sem pedir licença. Ela se chama KV cache.
Nos artigos anteriores desta série a gente viu a física da inferência, o mapa da viagem de um token e o vocabulário para medir tudo isso. Chegou a hora de encarar quem manda de verdade na sua densidade de usuários por GPU. Não são os pesos. É a memória de curto prazo da conversa.
o loop que se repete e o trabalho que se joga fora
Volte ao mapa do segundo artigo, na parte que interessa. Para gerar cada token, a sequência inteira volta pelas camadas do modelo. Sequência inteira: o seu prompt mais tudo que já foi gerado até ali.
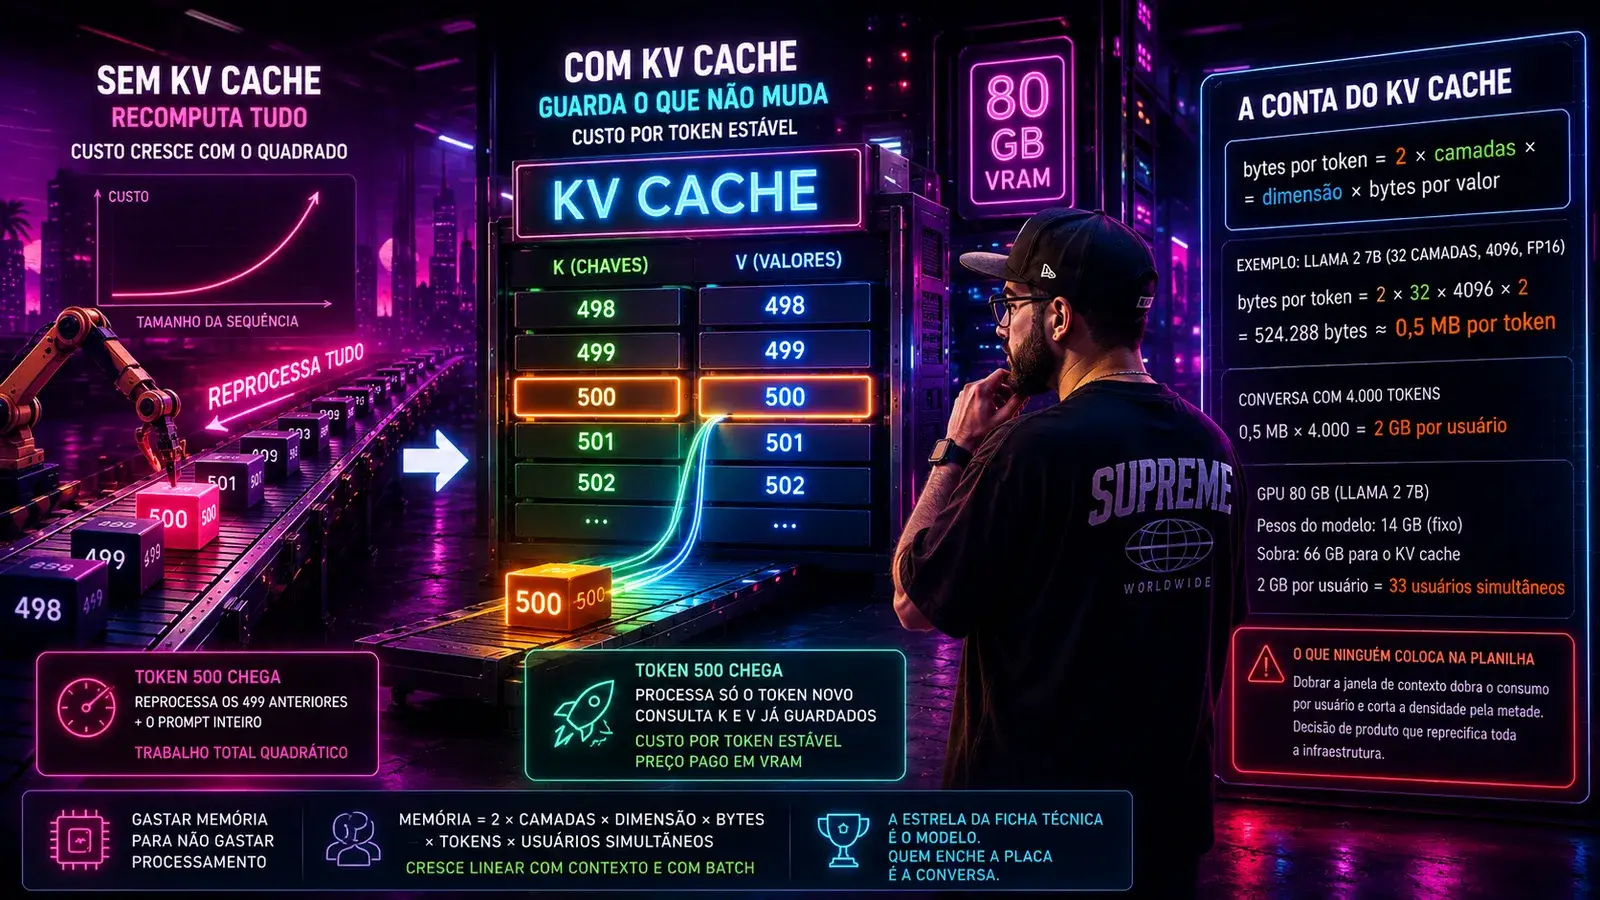
Pense no que isso significa sem nenhum truque. Para produzir o token número 500, o modelo precisaria reprocessar os 499 anteriores mais o prompt. Para o 501, tudo de novo mais um. O trabalho de uma resposta cresceria com o quadrado do tamanho dela, e gerar textos longos seria inviável em qualquer hardware que existe ou vai existir.
Só que ele não reprocessa. Dentro do mecanismo de atenção, cada token produz dois vetores, chamados chave e valor, o K e o V. E tem uma propriedade que salva o dia: o K e o V de um token que já passou não mudam quando um token novo chega. São os mesmos, para sempre, até o fim daquela sequência.
Então guarde. É isso que o KV cache é: a caixa onde ficam as chaves e os valores de todos os tokens já processados, camada por camada, para que o modelo nunca precise calculá-los de novo. Com o cache, cada volta do loop processa apenas o token novo e consulta o resto. O custo por token deixa de crescer com o tamanho da sequência.
É a troca mais clássica da computação, aquela que a gente faz desde sempre: gastar memória para não gastar processamento. Só que aqui a escala da memória gasta é que surpreende.
a conta que ninguém faz antes de dimensionar
Chega de adjetivo. Número, que é a marca desta série.
O tamanho do KV cache sai de uma multiplicação sem mistério. Para cada token guardado você tem dois vetores (K e V), em cada camada do modelo, com o tamanho do estado escondido, no formato numérico que você escolheu:
bytes por token = 2 (K e V) × camadas × dimensão do estado × bytes por valorPonha o Llama 2 de 7 bilhões nessa fórmula. São 32 camadas, dimensão 4096, FP16 com 2 bytes por valor:
bytes por token = 2 × 32 × 4096 × 2 = 524.288 bytes ≈ 0,5 MB por tokenMeio megabyte por token. Parece pouco até você lembrar que um token é um pedaço de palavra. Uma conversa com 4.000 tokens de contexto, coisa de um chat de suporte com histórico razoável, ocupa 2 gigabytes. Por usuário.
Agora feche a conta da placa de 80 gigabytes. Os pesos comem 14 e ficam parados ali, custo fixo. Sobram 66, e cada usuário simultâneo com o contexto cheio leva 2. Trinta e três usuários. Você comprou a GPU mais cara do catálogo para atender trinta e três conversas ao mesmo tempo, e o gargalo não foi poder de cálculo nem banda de memória. Foi espaço.
E olha o que ninguém coloca na planilha: esse número muda quando o produto muda. Dobrar a janela de contexto para acomodar mais histórico dobra o consumo por usuário e corta a densidade pela metade. É uma decisão de produto que reprecifica a infraestrutura inteira, tomada quase sempre numa thread do Slack sobre experiência do usuário.
quando o cache fica maior que o modelo
Puxe a corda até o extremo e o resultado fica constrangedor.
Pegue um modelo mais novo, o Llama 3 de 8 bilhões, com janela de 128 mil tokens. Ele usa uma otimização que já vou explicar e que derruba o custo por token para uns 128 kilobytes. Parece uma vitória, e é. Só que 128 mil tokens de contexto, aquele número que aparece no material de marketing como um recurso, dão algo em torno de 17 gigabytes de cache. Para uma sequência. Enquanto os pesos do modelo em FP16 ocupam 16.
Leia de novo. Um único usuário, com a janela de contexto cheia, consome mais memória do que o modelo inteiro. A estrela da ficha técnica é o modelo; quem enche a placa é a conversa.
É aqui que a conversa sobre "janela de um milhão de tokens" precisa descer do palco. Janela grande não é uma propriedade gratuita do modelo, é um cheque em branco assinado contra a sua VRAM, e quem paga é a quantidade de gente que cabe atendida ao mesmo tempo.
o diagrama: o que muda com o cache
O desenho compara as duas situações. Sem cache, cada volta reprocessa toda a sequência e o custo cresce com o quadrado. Com cache, cada volta processa só o token novo, e o preço vem na forma de memória que cresce a cada token guardado.
Quem leu meu artigo sobre cache lines e false sharing reconhece o padrão na hora. Cache existe para não repetir trabalho caro de memória, e nunca é de graça: você paga em espaço, em coerência e em complexidade de gerenciamento. A diferença é que na CPU a gente discute dezenas de bytes por linha, e aqui a mesma ideia consome gigabytes por usuário. As leis não mudaram. Mudou o tamanho da conta.
as alavancas, e o que cada uma cobra
Existem quatro formas sérias de atacar isso, e todas cobram alguma coisa.
A primeira é mexer na arquitetura da atenção. Em vez de cada cabeça de atenção ter o próprio par de K e V, várias cabeças compartilham o mesmo par. Noam Shazeer propôs a versão radical disso em 2019, com uma chave e um valor únicos para todas as cabeças, e o meio-termo que pegou no mercado ficou conhecido como grouped-query attention. É por isso que o Llama 3 de 8 bilhões guarda 128 kilobytes por token e o Llama 2 de 7 bilhões guarda 512: mesma família, quatro vezes menos cache, com perda de qualidade pequena o suficiente para o mercado inteiro ter adotado. Essa alavanca você não puxa em produção, ela vem decidida de fábrica, o que a torna um critério real na hora de escolher o modelo.
A segunda é quantizar o cache. Se guardar K e V em FP16 custa 2 bytes por valor, guardar em FP8 ou INT8 custa 1 e corta a memória pela metade. O preço é degradação de qualidade, que precisa ser medida no seu caso e não aceita fé. Quantização merece artigo próprio nesta série e vai ter, com números de antes e depois.
A terceira é a mais simples e a mais ignorada: limitar o contexto. Truncar histórico antigo, resumir conversas longas, deixar de despejar dez documentos de RAG quando três resolvem. Cada token que você não coloca no contexto é meio megabyte que não sai da placa, num modelo sem GQA. É a otimização que não exige nenhuma mudança de infraestrutura e que quase sempre esbarra em alguém dizendo que "mais contexto é melhor".
A quarta é reaproveitar prefixo. Se todas as suas requisições começam com o mesmo system prompt de dois mil tokens, o K e o V desses dois mil tokens são idênticos em todas elas. Um servidor de inferência decente guarda esse pedaço uma vez e compartilha, o que derruba tanto a memória quanto o TTFT de todo mundo. É o tipo de ganho que aparece sem você tocar no modelo, só arrumando como as requisições são montadas.
Falta um quinto ponto, que não é alavanca sua e sim do serving: o desperdício. Reservar memória contígua para o pior caso de cada sequência, quando na prática a maioria das respostas é curta, joga fora uma fatia enorme do que foi reservado. Quem já brigou com fragmentação de heap sabe o filme, e eu já escrevi sobre o assunto quando falei de garbage collection em .NET. O tratamento moderno disso na inferência trata a memória do cache como páginas de memória virtual, com blocos pequenos alocados sob demanda. Vou dedicar um artigo inteiro a esse mecanismo mais à frente, quando a série entrar na sala de máquinas do serving. Por ora, guarde a intuição: parte relevante da VRAM que você acha que está em uso está apenas reservada, e isso é escolha do stack de serving, não do modelo.
vamos medir, antes de comprar
O erro de dimensionamento acontece na planilha, semanas antes de o erro de memória aparecer no log. Ele parece com isto:
// ❌ dimensiona pela ficha técnica do modelo
var pesosGb = 14.0;                       // 7B em FP16
var vramGb  = 80.0;
var folgaGb = vramGb - pesosGb;           // "sobram 66 GB, tá tranquilo"
Log($"folga: {folgaGb} GB");
// nenhuma linha aqui sabe que existe contexto, usuário simultâneo ou KV cache
A conta honesta trata o cache como cidadão de primeira classe e responde a pergunta que o negócio realmente faz, que é quantos usuários cabem:
// ✅ dimensiona por pesos + KV cache do pior caso
static double KvBytesPorToken(int camadas, int dimensao, int bytesPorValor, int grupoGqa = 1)
    => 2.0 * camadas * dimensao / grupoGqa * bytesPorValor;   // 2 = K e V

var kvPorToken   = KvBytesPorToken(camadas: 32, dimensao: 4096, bytesPorValor: 2);
var kvPorUsuario = kvPorToken * contextoMaximoTokens;         // pior caso: janela cheia
var disponivel   = vramBytes * 0.90 - pesosBytes;             // 10% de folga pra ativações

var usuariosSimultaneos = (int)(disponivel / kvPorUsuario);

Log($"KV: {kvPorToken / 1024:F0} KB/token · {kvPorUsuario / 1e9:F2} GB por usuário · " +
    $"cabem {usuariosSimultaneos} sequências simultâneas com contexto cheio");
Rode esse cálculo com a janela de contexto que o produto quer, não com a que ele usa hoje. E rode de novo toda vez que alguém propuser aumentar o histórico da conversa, porque essa é a mudança que reprecifica a infraestrutura sem passar por nenhuma revisão de arquitetura.
o que isso muda para quem decide
Três consequências caem daqui, e nenhuma é técnica no fim da linha.
Contexto tem preço, e o preço é linear. Cada token que você mantém na janela é memória ocupada durante toda a conversa daquele usuário. Um produto que guarda o histórico inteiro está comprando VRAM por sessão. Quando escrevi sobre o custo de IA em produção, a discussão era sobre a fatura vista de cima, por feature. Aqui está o mecanismo que gera boa parte dela.
Densidade define o custo por usuário. Se cabem 33 sequências numa placa que custa alguns dólares por hora, o seu custo por usuário simultâneo é aquela divisão, e cortar o cache pela metade literalmente dobra a capacidade da mesma máquina. Nenhuma negociação com fornecedor entrega um ganho desse tamanho.
E escolher modelo é escolher perfil de memória, não só qualidade de resposta. Dois modelos com desempenho parecido em benchmark podem ter consumos de cache que diferem por quatro vezes por causa de uma decisão de arquitetura tomada no treinamento. Se ninguém no time olha esse número antes de fechar a escolha, a conta chega depois, disfarçada de necessidade de mais uma GPU.
conclusão: a memória que ninguém orçou
O modelo é o custo fixo. O KV cache é o custo variável, e é ele que decide quanta gente cabe na sua placa. Ele existe por um motivo excelente, evitar que o custo de gerar texto exploda com o quadrado do tamanho da resposta, e cobra por isso em gigabytes que crescem com o contexto e com o número de usuários simultâneos.
Quem dimensiona GPU pelo tamanho do modelo está lendo metade da conta. A outra metade depende de decisões que nem parecem de infraestrutura: quanto histórico a conversa guarda, quantos documentos o RAG injeta, que janela de contexto o produto promete no material de vendas. São essas escolhas que enchem a memória, e elas costumam ser tomadas longe de qualquer pessoa que saiba o que é um K e um V.
Na bolsa, a gente aprendeu que sistema não quebra pelo caso médio, quebra quando todo mundo aparece ao mesmo tempo e o recurso escasso acaba. O KV cache é exatamente esse recurso escasso na inferência. Ele fica invisível enquanto tem folga e vira o assunto da reunião de crise no dia em que acaba.
Insights & Takeaways
- O KV cache guarda as chaves e os valores de cada token já processado para que o loop de geração não recomece do zero a cada volta. Sem ele, o trabalho de uma resposta cresceria com o quadrado do seu tamanho.
- O preço vem em memória, e a fórmula é simples: 2 vezes camadas vezes dimensão vezes bytes por valor, por token. Num 7B em FP16 dá meio megabyte por token, ou 2 GB por usuário com 4.000 tokens de contexto.
- Numa placa de 80 GB com 14 GB de pesos, isso significa cerca de 33 conversas simultâneas com contexto cheio. O gargalo de densidade não é poder de cálculo, é espaço.
- Em janelas longas o cache passa o modelo: 128 mil tokens de contexto num 8B chegam a 17 GB para uma única sequência, mais do que os 16 GB dos pesos. Janela grande é cheque em branco contra a sua VRAM.
- As alavancas cobram: grouped-query attention vem decidida de fábrica e corta o cache em várias vezes, quantizar K e V troca memória por qualidade, limitar contexto é grátis e impopular, e reaproveitar prefixo de system prompt derruba memória e TTFT de uma vez.
Uma pergunta honesta pra fechar, no espírito de proteger o time antes do incidente: você sabe quantos usuários simultâneos cabem na sua GPU com a janela de contexto que o produto promete? Se a resposta vier em forma de "sobra memória", o seu primeiro pico de uso vai transformar essa sobra numa página de incidente.
No próximo artigo a série muda de terreno e vai para dentro da sua casa: dá para servir modelo em .NET, com ONNX Runtime e o que mais existe no ecossistema, sem manter um sidecar de Python só porque todo tutorial começa assim.