IA de Alta Performance · Episódio 9
Sua GPU Passa 70 Por Cento do Tempo Parada - A Conta Que Ninguém Faz
Custo por token é custo da hora dividido por tokens da hora: as duas ociosidades da GPU, o MFU e a métrica que mostra o desperdício que a fatura esconde.
Neste artigo · 8 seções
- a conta, em duas linhas
- existem dois tipos de ociosidade, e um deles é invisível
- o diagrama: para onde vai a hora que você paga
- por que a API do fornecedor parece tão barata
- a métrica que devia estar no painel
- o que fazer com o número depois de tê-lo
- conclusão: a fatura não mede desperdício
- Insights & Takeaways
A fatura de GPU tem uma propriedade cruel que quase nenhuma outra linha de infraestrutura tem: ela não olha para o que você produziu.
Você aluga a placa por hora. O relógio corre igual se ela estiver atendendo mil pessoas ou se estiver parada esperando alguém digitar. No fim do mês chega um número que depende só de quanto tempo a máquina ficou ligada, e não de quanto trabalho saiu dela.
Entre esses dois números mora a conta deste artigo. Ela é simples de fazer, quase ninguém faz, e a diferença entre fazer e não fazer costuma ser de vezes, não de porcentagem.
No artigo anterior a gente viu que throughput, latência e custo formam um trilema, e que o custo por token é o throughput visto de outro ângulo. Agora vamos abrir esse ângulo, porque é ele que chega na reunião de orçamento.
a conta, em duas linhas
Não tem mistério nenhum aqui, e é justamente por isso que incomoda.
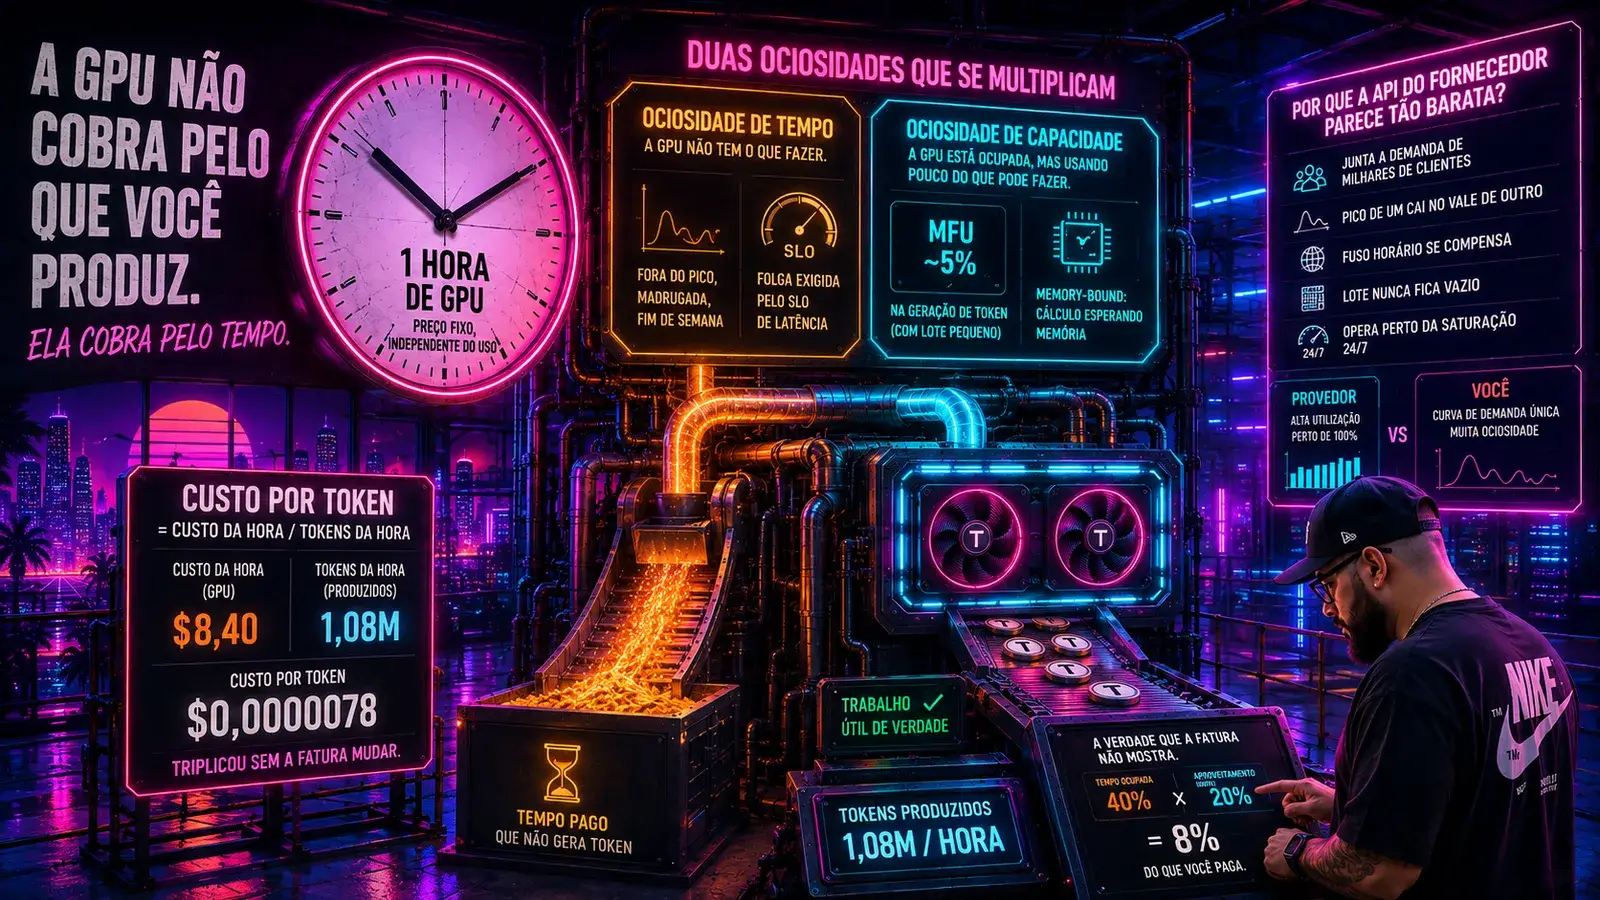
custo por token = custo por hora da GPU / tokens produzidos por horaO numerador é fixo e você conhece: está no contrato. O denominador é variável, você provavelmente não mede, e ele é quem manda no resultado.
Ponha número. Suponha uma placa que produza mil tokens por segundo quando está trabalhando de verdade. Em uma hora cheia, são 3,6 milhões de tokens. Agora suponha que ela só trabalhe de verdade em 30% do tempo, que é uma taxa perfeitamente normal em produção. A hora continua custando a mesma coisa, mas a produção caiu para 1,08 milhão.
O custo por token triplicou. A conta do fornecedor não mudou nem um centavo, o gráfico de gastos continua uma linha reta, e ninguém tem como perceber olhando a fatura. A ineficiência não aparece como despesa maior. Aparece como resultado menor pelo mesmo preço, que é o tipo de perda mais difícil de enxergar em qualquer negócio.
existem dois tipos de ociosidade, e um deles é invisível
Quando alguém diz que a GPU está parada, costuma estar pensando em um tipo só de parada. São dois, e eles se acumulam.
A primeira é a ociosidade de tempo, que é a intuitiva: a placa não tem o que fazer. Ela vem da curva de tráfego, e a curva de tráfego de produto corporativo é brutal. O uso se concentra no horário comercial, some à noite, some no fim de semana. Se você dimensionou para o pico das dez da manhã de terça, comprou uma capacidade que fica sem uso na maior parte das 168 horas da semana. Some a isso a folga que o SLO de latência exige, aquela que discuti no trilema: manter latência baixa no pico significa, por definição, ter capacidade sobrando fora dele.
A segunda é a ociosidade de capacidade, e essa quase ninguém contabiliza: a placa está ocupada, mas usando uma fração ridícula do que sabe fazer. É a física que esta série vem martelando desde o começo. Na geração de token, o trabalho é dominado por leitura de memória, então as unidades de cálculo passam a maior parte do tempo esperando bytes chegarem. A GPU aparece como ocupada em qualquer painel de monitoramento, e mesmo assim está entregando uma fatia pequena do que você pagou.
Existe uma métrica honesta para isso, e ela vem do pessoal que treinou o PaLM: MFU, o aproveitamento real dos FLOPs do modelo em relação ao que o hardware oferece. Para dar dimensão do quanto ela é dura, um treinamento grande bem executado costuma ser celebrado quando fica em torno de 50%. E, como destrinchei no artigo sobre prefill e decode, a geração de token com lote pequeno vive abaixo de 5%.
Junte as duas ociosidades. Uma placa que trabalha 40% do tempo, e que durante esse tempo aproveita 20% da própria capacidade, está entregando 8% do que você está pagando. O "70% parada" do título é generoso.
o diagrama: para onde vai a hora que você paga
por que a API do fornecedor parece tão barata
Essa é a consequência prática que vale a reunião inteira, e ela resolve uma discussão que todo time de plataforma tem mais cedo ou mais tarde.
Quando alguém compara o preço por milhão de tokens de um provedor com o custo de rodar o modelo em casa, a comparação quase sempre é injusta, e é injusta contra você. O preço do provedor já embute uma taxa de utilização que você não tem como alcançar sozinho, porque ele resolve exatamente o problema que te derruba: ele junta a demanda de milhares de clientes na mesma placa.
Pense no que isso significa. O pico de um cliente cai no vale de outro. O fuso horário de um compensa o do outro. O lote nunca fica vazio, porque sempre tem requisição de alguém para preencher. O provedor opera perto da saturação 24 horas por dia, o que é a única condição em que aquele custo por token faz sentido.
Você, rodando um modelo para o seu produto, tem uma curva de demanda só, com um pico só e uma madrugada só.
Isso não significa que rodar em casa nunca compensa. Significa que o ponto de equilíbrio não é sobre volume total, é sobre volume constante. A pergunta certa não é quantos tokens por mês você consome, é se você tem demanda suficiente para manter o lote cheio nas 24 horas. Quem tem carga assíncrona, que pode ser empurrada para a madrugada, muda o jogo, porque aí o vale vira oportunidade de encher a placa com trabalho que não tem pressa. Quando escrevi sobre treinar modelos proprietários e o que não aparece na conta, a discussão era sobre os custos escondidos da decisão. Este é o mais escondido de todos, porque ele não é um custo: é uma receita que você deixa de extrair do que já pagou.
a métrica que devia estar no painel
Quase todo painel de custo de IA que eu vi mostra a mesma coisa: gasto por mês, gasto por ambiente, gasto por time. Tudo isso é a fatura reorganizada, e a fatura, como vimos, é cega para eficiência.
A métrica que muda comportamento é uma só, e é a divisão do começo do artigo: custo efetivo por mil tokens. Ela sobe quando a utilização cai, mesmo com a fatura constante, e é a única que denuncia uma placa ociosa antes que alguém proponha comprar outra para resolver a fila.
Na prática o cálculo é este:
// ❌ o painel que mostra a fatura reorganizada
var custoMensal = HorasLigadas * CustoHora;
Log($"gasto com GPU: US$ {custoMensal:N0}");
// sobe se você ligar mais máquina, desce se desligar.
// não tem ideia nenhuma de quanto trabalho saiu disso.
// ✅ o painel que denuncia ociosidade
var tokensNoPeriodo = MetricasDeServing.TokensGerados(periodo); // já medido no ep. do SLA
var horasPagas = MetricasDeInfra.HorasDeGpu(periodo); // inclui a máquina ligada à toa
var custoEfetivoPor1k = (horasPagas * CustoHora) / tokensNoPeriodo * 1000;
var tokensPorHoraPaga = tokensNoPeriodo / horasPagas;
Log($"US$ {custoEfetivoPor1k:F3} por 1k tokens · {tokensPorHoraPaga:N0} tokens por hora paga");
// compare o segundo número com o que a placa entrega saturada.
// a razão entre os dois é a sua utilização real, e ela é a conta inteira.O detalhe que faz esse código valer é o denominador incluir hora paga, não hora ocupada. Máquina ligada esperando trabalho é hora paga. Se você tirar isso do denominador para o número ficar bonito, acabou de construir um painel que mente.
Quem vem de sistema de mercado tem essa disciplina por formação: em ambiente onde a infraestrutura é cara e o volume oscila com o pregão, custo por operação é métrica de primeira classe, e ninguém aceita olhar só o total gasto no mês. A IA trouxe o mesmo problema para times que nunca precisaram pensar assim, e trouxe com uma fatura maior.
o que fazer com o número depois de tê-lo
Ter a métrica não resolve nada sozinho. Ela serve para escolher entre alavancas que, sem ela, viram opinião.
Encher o lote é a primeira, e é o assunto do artigo anterior: o mesmo hardware, mais requisições por passagem, e o custo por token desaba. É a alavanca de maior efeito e a que mais gente deixa parada.
Quantizar é a segunda, e ela ataca os dois lados: menos bytes por token e mais espaço para lote maior.
Desligar é a terceira, e é a mais ignorada por motivo cultural. Escalar para zero fora do horário parece arriscado, e é chato por causa do tempo de carregar o modelo, mas é dinheiro literal jogado fora todas as noites. Uma placa desligada tem custo por token indefinido, o que é infinitamente melhor que ter custo por token altíssimo.
E a quarta é mover trabalho para o vale: se existe processamento que não tem usuário esperando, ele não deveria disputar espaço com o chat no horário de pico, deveria estar enchendo a placa às três da manhã.
conclusão: a fatura não mede desperdício
Tudo neste texto cabe numa inversão. A fatura de GPU responde "quanto gastamos", e essa é a pergunta errada. A pergunta certa é "quanto trabalho tiramos do que gastamos", e ela exige um denominador que quase nenhum time coleta.
Enquanto o denominador não existe, toda discussão sobre custo de IA vira negociação com fornecedor, corte de ambiente ou proibição de uso, que são respostas para um problema de preço. O problema não é de preço. É de aproveitamento. A diferença entre um décimo de centavo e um centavo por token não vem do contrato, vem de quanto tempo a placa ficou parada e de quanto da capacidade dela foi realmente usada enquanto estava ocupada.
Em escala, essa diferença é a distância entre uma linha de custo administrável e um projeto que o financeiro vai querer matar no próximo ciclo.
Insights & Takeaways
- A fatura de GPU depende de horas ligadas, não de trabalho produzido. Custo por token é custo da hora dividido por tokens da hora, e é o denominador, que quase ninguém coleta, que manda no resultado.
- São duas ociosidades e elas se multiplicam: a de tempo (fora do pico, madrugada, folga do SLO) e a de capacidade (decode memory-bound, com o cálculo esperando memória enquanto o painel mostra a placa ocupada). Uma placa a 40% do tempo com 20% de aproveitamento entrega 8% do que foi pago.
- MFU é a métrica honesta de aproveitamento. Treinamento grande bem feito celebra algo em torno de 50%; geração de token com lote pequeno vive abaixo de 5%.
- A API do fornecedor parece barata porque o preço dela embute utilização quase perfeita: ele junta milhares de clientes na mesma placa e nunca deixa o lote vazio. O ponto de equilíbrio para rodar em casa não é volume total, é volume constante.
- Coloque no painel o custo efetivo por mil tokens, com hora paga no denominador. Ele sobe quando a utilização cai, mesmo com a fatura constante, e é o único número que impede alguém de resolver fila comprando mais placa.
Uma pergunta honesta pra fechar: você sabe quantos tokens a sua GPU produziu por hora paga no mês passado? Não por hora ocupada, por hora paga. Se esse número não existe, a sua discussão de custo de IA está acontecendo sem o denominador, e discussão sem denominador termina sempre no mesmo lugar, que é cortar uso em vez de corrigir desperdício.
No próximo artigo a série fecha a temporada indo para o outro extremo da escala: o modelo pequeno rodando no seu notebook, com NPU, sem data center nenhum, e a conta de quando isso ganha do gigante na nuvem.