IA de Alta Performance · Episódio 8
Throughput, Latência e Custo - Escolha Dois
Throughput, latência e custo na inferência de LLM: como o tamanho do lote e a folga de hardware formam um trilema, e o que empurra a fronteira.
Neste artigo · 9 seções
- o mecanismo por trás do impasse
- por que o custo entra como terceiro eixo
- o diagrama: os dois botões e os três cantos
- quatro cargas, quatro pontos diferentes
- o teto que ninguém coloca na conta
- como se escapa do trilema (e não é escolhendo melhor)
- medir antes de escolher
- conclusão: o trilema é uma conversa de produto
- Insights & Takeaways
Toda reunião de arquitetura de IA em que o assunto é performance chega no mesmo impasse. Alguém pede resposta mais rápida. Outra pessoa lembra que a fatura de GPU dobrou. E um terceiro comenta que a fila cresce no horário de pico e que precisa aguentar mais gente.
Os três estão certos. Os três estão pedindo coisas que não cabem juntas.
Nos artigos anteriores desta série a gente montou as peças: a física que define o teto de velocidade, a assimetria entre ler o prompt e gerar a resposta, o vocabulário para medir, a memória que decide quanta gente cabe na placa, e o corte que a quantização entrega. Agora vem a parte que amarra tudo, e que é a decisão de arquitetura de verdade.
Você tem três coisas para otimizar: throughput, latência e custo. E só consegue duas.
o mecanismo por trás do impasse
Antes do trade-off, o motor que o produz. Ele tem um nome bem sem graça: batch.
Volte à física do primeiro artigo. Na geração de token, o gargalo é banda de memória: para produzir um único token, a GPU lê todos os pesos do modelo. Num 7B em FP16, são 14 gigabytes lidos por token. É um trabalho absurdo de movimentação de dados para uma quantidade ridícula de cálculo.
Agora repare no desperdício escondido nisso. Enquanto a GPU lê aqueles 14 gigabytes, ela poderia estar aplicando os mesmos pesos em vinte requisições diferentes, e o custo de leitura seria exatamente o mesmo. Os pesos não mudam entre usuários.
É isso que o batch faz. Você agrupa requisições, lê os pesos uma vez, e atende todas naquela passagem. O tráfego de memória fica quase igual, e o número de tokens produzidos multiplica. Numa carga que é memory-bound, agrupar não é uma otimização incremental. É a diferença entre usar 5% da placa e usar uma fração decente dela.
Só que o batch cobra em tempo. Para agrupar, alguém espera. A requisição que chegou primeiro aguarda companhia, e todas as requisições do grupo avançam no ritmo do grupo, não no ritmo individual. Quanto maior o lote, melhor o aproveitamento e pior a experiência de quem está esperando a resposta aparecer.
Aí está o primeiro eixo, e ele é uma gangorra honesta: throughput sobe, latência piora.
por que o custo entra como terceiro eixo
O custo por token não é uma terceira variável independente. Ele é consequência do throughput: você aluga GPU por hora, o preço da hora não muda, e o que muda é quantos tokens você extrai dela naquela hora. Mais throughput, menos custo por token. São o mesmo eixo, olhado de dois ângulos.
Se fosse só isso, não haveria trilema. Haveria uma gangorra simples entre latência e eficiência, e cada um escolheria seu ponto.
O que transforma a gangorra em trilema é o dinheiro entrar por outra porta: o provisionamento. Você pode comprar latência baixa sem sacrificar throughput, desde que alugue mais GPU e deixe cada uma delas trabalhando com lotes pequenos. Funciona, entrega os dois, e é caro exatamente na proporção em que funciona.
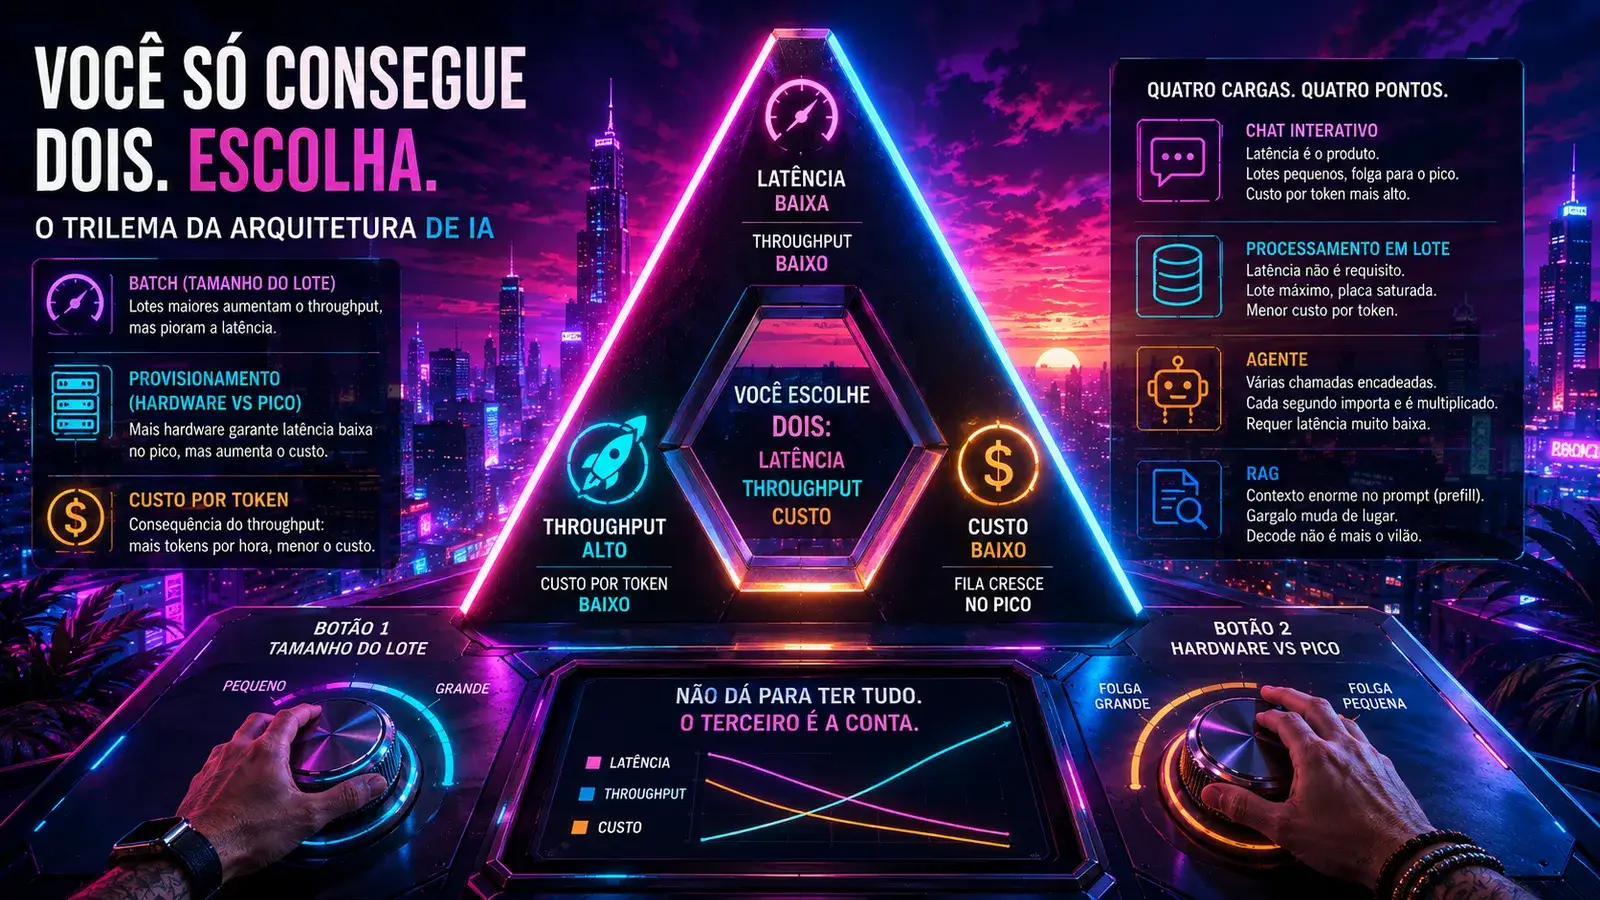
Então o desenho real é este. Existem dois botões: o tamanho do lote, que fica entre latência e throughput; e a quantidade de hardware que você mantém ligado em relação ao pico de demanda, que é o botão do custo. Mexer em qualquer um paga um e cobra outro.
Latência baixa com throughput alto: possível, e você paga em hardware ocioso na maior parte do tempo. Latência baixa com custo baixo: possível, e o sistema atende pouca gente. Throughput alto com custo baixo: possível, e quem espera vai esperar.
Escolha dois. O terceiro é a conta.
o diagrama: os dois botões e os três cantos
quatro cargas, quatro pontos diferentes
O erro que vejo com mais frequência não é escolher errado. É escolher uma vez e aplicar a mesma configuração em cargas que não têm nada a ver uma com a outra, dentro do mesmo produto.
No chat interativo, a latência é o produto. Ninguém elogia um assistente que responde certo em doze segundos. Aqui você trabalha com lotes pequenos, mantém folga de hardware para o pico, e aceita que o custo por token vai ser o mais alto do seu catálogo. É uma decisão de produto disfarçada de infraestrutura.
No processamento em lote, o oposto inteiro. Classificar dez milhões de documentos durante a madrugada não tem usuário esperando, então latência não é requisito, é vaidade. Lote máximo, placa saturada, e se der para usar capacidade ociosa mais barata, melhor ainda. É onde o custo por token cai para o piso, e é onde mais gente deixa dinheiro na mesa por rodar com a mesma configuração do chat.
O agente é o caso que quase todo mundo subestima. Parece chat, mas não é: um agente encadeia várias chamadas ao modelo antes de devolver qualquer coisa. Se cada passo leva dois segundos e o fluxo tem dez passos, o usuário espera vinte. A latência de cada chamada individual importa mais aqui do que no chat, porque ela é multiplicada, não somada à percepção. Agente rodando com configuração de throughput vira produto que ninguém usa duas vezes.
E o RAG muda o gargalo de lugar. O prompt carrega os documentos recuperados, então ele é enorme, e o peso da conta migra do decode para o prefill. É a assimetria que destrinchei em gerar texto é o pior trabalho que já deram pra uma GPU: as duas fases respondem a alavancas opostas. Otimizar decode num sistema dominado por prefill é gastar esforço no lugar errado.
o teto que ninguém coloca na conta
Tem um limite físico no botão do lote, e ele não é o que parece.
Você não aumenta o lote até a GPU ficar sem poder de cálculo. Você aumenta até a memória acabar. Cada sequência simultânea carrega o próprio KV cache, e aquela conta que fechei no artigo sobre o vilão da conta de GPU volta aqui com outro significado: se cada usuário com contexto cheio ocupa 2 gigabytes, e sobram 66 depois dos pesos, o seu lote máximo teórico é 33. Não porque a placa não dá conta do cálculo, mas porque não cabe mais ninguém.
Ou seja, o botão do throughput tem um curso limitado, e quem define o fim do curso é o tamanho do contexto que o produto prometeu. Aumentar a janela de contexto encurta o botão de throughput. Essas duas decisões parecem morar em universos separados, e são a mesma decisão.
como se escapa do trilema (e não é escolhendo melhor)
Tudo que descrevi até aqui é movimento ao longo de uma fronteira: você anda de um canto para o outro e paga a diferença. Escolher melhor não te tira da fronteira.
O que tira é empurrar a fronteira inteira para fora, e existem poucos movimentos assim.
Quantização é o mais direto, e por isso rendeu artigo próprio. Cortar os pesos pela metade melhora as três coisas ao mesmo tempo: menos bytes por token significa mais velocidade, menos memória de pesos significa mais espaço para lote maior, e mais lote significa custo por token menor. É raro uma alavanca dessas existir, e é por isso que ela merece medição séria antes de virar padrão.
O segundo é o agendamento do servidor de inferência. Existe uma patologia clássica em que uma requisição com prompt gigante entra em prefill e trava o decode de todo mundo que já estava sendo atendido, produzindo um pico de latência que não aparece na média e destrói o p99. Foi exatamente esse problema que o pessoal do Sarathi-Serve atacou, quebrando o prefill em pedaços e intercalando com o decode dos outros. O resultado é melhor latência sem perder throughput, o que é literalmente empurrar a fronteira.
O terceiro é reduzir trabalho em vez de acelerar trabalho: não gerar o token que não precisa existir, não reprocessar o prompt que já foi processado, não chamar o modelo grande onde o pequeno resolve. É o assunto que abre a próxima temporada desta série, e é o de melhor relação entre esforço e resultado.
medir antes de escolher
O sintoma de que alguém está no trilema sem saber é a configuração fixa. Aparece assim:
// ❌ o lote virou constante mágica, e ninguém sabe de onde veio
const int TamanhoDoLote = 32;      // "foi o que funcionou nos testes"
const int GpusLigadas   = 4;       // "sempre foi assim"

// não existe SLO em lugar nenhum deste arquivo.
// a mesma configuração atende o chat, o agente e o job noturno.
O caminho honesto é derivar a configuração do orçamento de latência que o produto assumiu, usando o vocabulário que montei no artigo do SLA:
// ✅ o SLO é a entrada; o lote e o provisionamento são consequência
record Slo(string Carga, int TtftMs, int ItlMs);

var slos = new[]
{
    new Slo("chat",   TtftMs:  800, ItlMs:  40),   // pessoa esperando
    new Slo("agente", TtftMs:  300, ItlMs:  25),   // multiplicado por N passos
    new Slo("lote",   TtftMs: 60_000, ItlMs: 500), // ninguém esperando
};

foreach (var slo in slos)
{
    var lote = MaiorLoteQueCumpre(slo);                  // medido, não chutado
    var custoPorMilTokens = CustoHora / TokensPorHora(lote) * 1000;

    Log($"{slo.Carga}: lote {lote} · US$ {custoPorMilTokens:F3}/1k tokens");
}
// cargas diferentes terminam em configurações diferentes.
// se as três derem o mesmo número, ou o SLO está errado ou ninguém mediu.
O detalhe que faz esse código valer alguma coisa não é a estrutura. É MaiorLoteQueCumpre ser uma medição real, com o seu modelo e o seu perfil de tráfego, e não um número herdado de um post de blog sobre outro hardware.
conclusão: o trilema é uma conversa de produto
A escolha entre throughput, latência e custo não é técnica. Ela é uma decisão de produto que tem consequência técnica, e ela chega na engenharia já tomada, quase sempre sem que ninguém perceba que tomou.
Quando o time decide que o assistente responde em streaming e a percepção precisa ser instantânea, ele acabou de escolher latência e comprometeu as outras duas. Quando alguém promete janela de contexto enorme no material de vendas, encurtou o botão do throughput. Quando o produto vira agente com dez passos encadeados, o orçamento de latência por chamada caiu para um décimo sem nenhuma reunião sobre isso.
O trabalho de quem cuida da arquitetura é tornar essa escolha explícita antes que ela vire fatura ou reclamação. Não para impedir, mas para que quem decide saiba o que está comprando e com que dinheiro.
Insights & Takeaways
- O motor do trilema é o batch. Numa carga memory-bound, ler os pesos uma vez e aplicar em várias requisições multiplica o throughput quase de graça, e o preço é o tempo que cada requisição passa esperando o grupo.
- Custo por token não é variável independente: é throughput visto de outro ângulo, porque a hora de GPU custa o mesmo cheia ou vazia. O que faz o custo virar terceiro eixo é o provisionamento, ou seja, quanto hardware você mantém ligado em relação ao pico.
- São dois botões, não três: tamanho do lote (latência contra throughput) e folga de hardware (custo contra os outros dois). Qualquer combinação de dois objetivos é atingível pagando no terceiro.
- Cargas diferentes exigem pontos diferentes na fronteira, dentro do mesmo produto. Agente é o caso mais subestimado, porque a latência de cada chamada é multiplicada pelo número de passos antes de chegar ao usuário.
- Escolher melhor não tira você da fronteira; só empurrar a fronteira tira. Os movimentos que fazem isso são quantização, agendamento decente no servidor de inferência (prefill fatiado para não travar o decode alheio) e, o mais barato de todos, não fazer o trabalho que não precisa ser feito.
Uma pergunta honesta pra fechar: no seu sistema, o tamanho do lote e a quantidade de GPU ligada saíram de um orçamento de latência escrito em algum lugar, ou de um número que alguém testou uma vez e ninguém mais mexeu? Se for a segunda, você não escolheu dois. Você recebeu os três de brinde, e provavelmente os três medianos.
No próximo artigo eu abro a fatura pelo lado que mais dói na liderança: a GPU que você aluga por hora passa a maior parte do tempo sem fazer nada, e existe uma conta simples que transforma essa ociosidade em dinheiro queimado por mês.