IA de Alta Performance · Episódio 1
Um Token Não e Grátis - A Fisica Que a IA First Não Te Contou
Por que gerar texto custa mais que ler o prompt: compute-bound, memory-bound e a conta de banda que define o teto de tokens por segundo da GPU.
Neste artigo · 8 seções
- o que a IA First te ensinou, e onde ela parou
- "é só uma multiplicação de matrizes", e por que isso não te ajuda
- ler é barato, gerar é caro: a assimetria que ninguém te conta
- vamos medir, estilo book de ofertas
- o diagrama: um token, todos os pesos, de novo e de novo
- por que um engenheiro de produto deveria se importar com isso
- conclusão: a conta tem uma física, e dá pra prever
- Insights & Takeaways
A primeira vez que olhei uma conta de GPU de inferência de perto, tive um déjà-vu desconfortável. Aquilo não parecia uma fatura de software. Parecia um book de ofertas.
Quem trabalhou com market data sabe do que estou falando. Você tem um recurso caro e finito (a banda do barramento, o tempo da matching engine, o ciclo do processador) e uma fila de gente querendo um pedaço dele agora. Cada microssegundo tem dono. Cada mensagem que entra empurra outra pra trás. E ninguém liga pra média: o que te machuca é a cauda, o p99, o pior caso que acontece exatamente quando o mercado abre e todo mundo manda ordem ao mesmo tempo.
Servir um modelo de linguagem é a mesma briga, com outro nome. Só que a maior parte do conteúdo de IA finge que não.
o que a IA First te ensinou, e onde ela parou
Na série IA First eu passei trinta artigos no andar de cima: produto, RAG, agentes, governança, a conta no fim do mês. Em From Batch to Real Time a gente aprendeu a pedir latência: definir um orçamento de milissegundos, escolher o modelo certo pro caso, decompor o tempo de resposta da aplicação, tratar "quantizado" como uma caixa-preta que custa menos. Isso é a visão de quem consome.
Esta série começa exatamente onde aquele artigo parou. Aqui a gente desce um andar e aprende a produzir latência. Não "como pedir um modelo mais rápido", mas "por que esse token demorou o que demorou, e quanto ele custou em joules, FLOPs e bytes lidos da memória". A tese é meio provocativa, e vou defender ela ao longo da série: a próxima geração de engenheiro de IA vai parecer um engenheiro de HFT. Tail latency, mechanical sympathy, obsessão por p99. A disciplina de quem constrói bolsa, aplicada a quem serve modelo.
Vamos começar pelo começo. Pela física.
"é só uma multiplicação de matrizes", e por que isso não te ajuda
Pergunte a qualquer pessoa o que um LLM faz por baixo e você ouve "multiplicação de matrizes". Tá certo. E é inútil como modelo mental, do mesmo jeito que "o carro anda porque o motor gira" não te ajuda a entender por que ele engasga na subida.
O modelo mental que funciona veio de um texto de 2022 do Horace He, do time do PyTorch, chamado Making Deep Learning Go Brrrr From First Principles. A ideia central é que todo código que roda numa GPU está preso por um de três limites, e quase nunca pelo que você imagina:
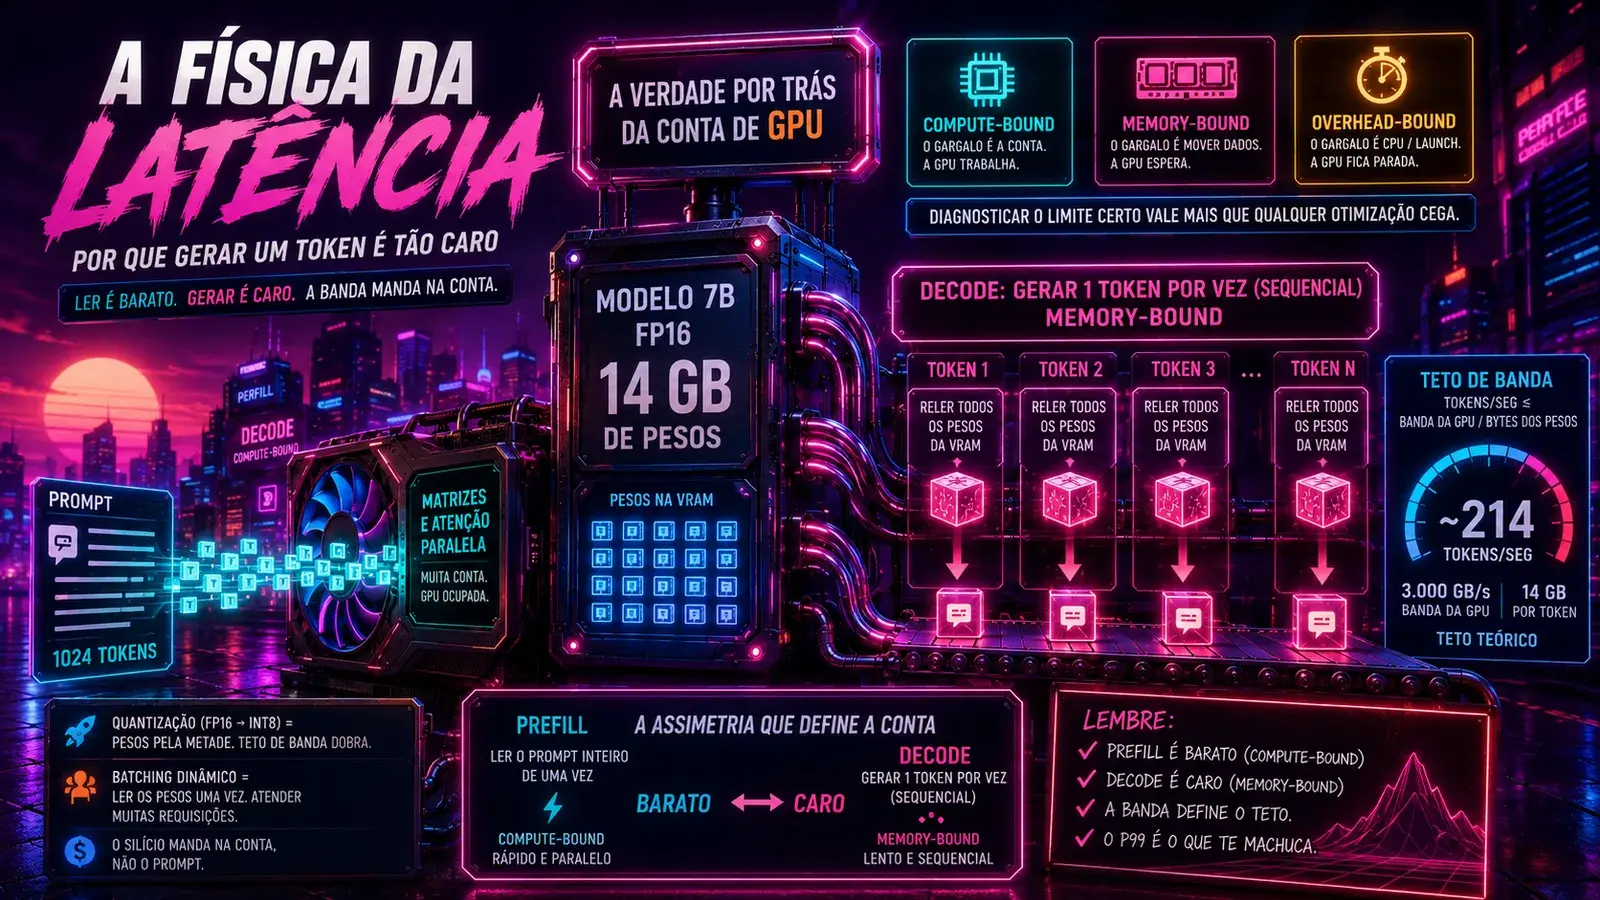
O primeiro é estar compute-bound: o gargalo é a conta em si, os FLOPs, as unidades de multiplicação trabalhando a todo vapor. Aqui a GPU está fazendo o que ela nasceu pra fazer. É o cenário bom.
O segundo é estar memory-bound: o gargalo é mover os dados. As unidades de cálculo estão ociosas, esperando os bytes chegarem da memória. Você comprou uma GPU de dezenas de teraflops e ela passa o tempo batendo o pé, esperando o caminhão de pesos descarregar.
O terceiro é estar overhead-bound: o gargalo nem é a GPU, é a CPU, o Python, o launch de kernel, a fila de comandos. A placa está parada esperando alguém mandar ela trabalhar. Comum em modelos pequenos e batch minúsculo, e o tipo de coisa que um profiler decente expõe na hora.
Por que isso importa tanto? Porque a otimização que resolve um desses casos não faz nada pelos outros. Trocar por uma GPU com o dobro de FLOPs num workload memory-bound é jogar dinheiro fora; você vai pagar mais por uma capacidade de cálculo que já estava ociosa. Quem mede antes de afirmar (e essa vai ser a marca registrada desta série) descobre cedo que diagnosticar o limite certo vale mais que qualquer micro-otimização cega.
Guarde os três nomes. Eles vão aparecer em quase todo artigo daqui pra frente.
ler é barato, gerar é caro: a assimetria que ninguém te conta
Aqui está o pulo do gato, e é o que separa quem entende a conta de quem só paga ela.
Uma inferência tem duas metades com perfis de custo opostos. Vou tratar cada uma a fundo num artigo próprio mais à frente, mas você precisa da intuição agora porque ela explica tudo.
A primeira metade é ler o seu prompt. O modelo recebe todos os tokens de entrada de uma vez e processa em paralelo. Mil tokens de contexto entram juntos no mesmo passo. Isso é trabalho denso, paralelizável, com aquela aritmética intensa que mantém as unidades de cálculo ocupadas. É compute-bound. A GPU adora.
A segunda metade é gerar a resposta. E aqui o jogo vira completamente. O modelo produz um token por vez, e cada token depende do anterior. Não dá pra paralelizar o futuro: você não sabe a quinta palavra antes de ter decidido a quarta. É inerentemente sequencial.
O detalhe brutal é o seguinte. Para gerar um único token, a GPU precisa reler todos os pesos do modelo da memória. Todos. Um modelo de 7 bilhões de parâmetros em FP16 ocupa por volta de 14 GB. Para cada token que sai, esses 14 GB sobem da VRAM até as unidades de cálculo. O próximo token? Releem os mesmos 14 GB. E assim por diante, palavra após palavra.
Repare na desproporção. Você move 14 GB de memória pra fazer uma quantidade ridícula de conta com eles. A razão entre operações e bytes movidos (o pessoal chama de intensidade aritmética) é baixíssima. Resultado: a geração de tokens é dominada por banda de memória, não por poder de cálculo. É memory-bound, do começo ao fim.
Esse é o ponto que reorganiza a sua cabeça. O silício manda na conta, não o prompt. Não é a inteligência do modelo nem a esperteza do seu texto que define o teto de velocidade. É quantos bytes de peso a sua GPU consegue ler por segundo.
vamos medir, estilo book de ofertas
Chega de adjetivo. Número.
Pegue uma GPU de data center com banda de memória na casa de 3 TB/s, que é a ordem de grandeza de uma H100. E o nosso modelo de 7B em FP16, 14 GB de pesos. Quantos tokens por segundo, no máximo teórico, uma única requisição consegue arrancar dela?
A conta é de padaria, do tipo que você faz antes de abrir a boca pra afirmar qualquer coisa sobre performance:
teto de tokens/seg  =  banda de memória  /  bytes lidos por token
teto de tokens/seg  =  3.000 GB/s  /  14 GB por token
teto de tokens/seg  ≈  214 tokens/seg
Esse é o teto. O céu. O número que você nunca vai superar com essa configuração porque ele é imposto pela física do barramento, não pela qualidade do seu código. Na prática você fica abaixo: tem o KV cache pra ler também, tem overhead, tem a eficiência real da memória que não é 100%. Mas o teto é esse, e ele não se move por vontade própria.
Agora o que essa conta te entrega de imediato, antes de qualquer benchmark:
Comprar uma GPU com o dobro de FLOPs e a mesma banda não muda quase nada na geração de um token só. Você está memory-bound; mais músculo de cálculo é capacidade que já estava sobrando.
Quantizar o modelo de FP16 pra INT8 corta os pesos pela metade, de 14 GB pra 7 GB. O teto de banda dobra, de ~214 pra ~428 tokens/seg, sem trocar de hardware. É por isso que quantização pesa tanto na latência da geração; a maioria pensa nela como economia de VRAM e para por aí, mas a alavanca de tempo é até mais direta. Vou dedicar um artigo inteiro a quando ela compensa e quando ela te trai, mas a raiz do ganho está nessa divisão aqui.
E o pulo de eficiência de verdade não vem de gerar um token mais rápido. Vem de gerar tokens pra muita gente ao mesmo tempo lendo os pesos uma vez só. Se a placa já vai pagar o pedágio de subir 14 GB da memória, que ela atenda dez, vinte, cinquenta requisições no mesmo trajeto. É exatamente o batching dinâmico, e é o motor econômico de qualquer stack de serving sério. Também tem artigo reservado pra ele.
Olha como a peça se encaixa. Se você não enxerga que o gargalo é banda, todas essas três decisões parecem desconexas. Quando você enxerga, elas viram a mesma decisão vista de três ângulos.
o diagrama: um token, todos os pesos, de novo e de novo
O desenho abaixo é a coisa toda em uma figura. O prompt entra inteiro de uma vez (a parte barata, compute-bound). Depois, cada token gerado obriga a releitura completa dos pesos da memória (a parte cara, memory-bound), e o teto de banda fica ali do lado, segurando a corda.
Quem leu meu artigo sobre Cache Lines e False Sharing vai reconhecer o padrão sem esforço. Lá, no mundo da CPU, o vilão silencioso era o mesmo: o custo de mover dados pela hierarquia de memória, não o custo de calcular. A diferença entre um acesso ao cache L1 e uma ida à RAM principal é de duas ordens de grandeza, e é ela que define a performance real do código, não o número de instruções. Na GPU a história se repete numa escala maior e mais cara. O hardware não virou outra coisa só porque a gente botou "IA" no nome. As leis são as mesmas. Mudou o tamanho da conta.
por que um engenheiro de produto deveria se importar com isso
Você pode estar pensando: legal, mas eu chamo uma API, o provedor que se vire com a física. Justo. Até o dia em que alguém pergunta por que a feature de geração de texto ficou três vezes mais lenta que a de classificação, sendo que "é o mesmo modelo". A resposta está inteira neste artigo. Classificar é prefill: lê o texto, cospe um rótulo, compute-bound, rápido. Gerar uma resposta longa é decode: token a token, memory-bound, e o custo cresce linear com o tamanho da saída.
Ou no dia em que o time decide trazer a inferência pra dentro, numa GPU própria, e a conta não fecha do jeito que a planilha prometia. A planilha quase sempre raciocina em FLOPs, porque FLOPs é o número que está na ficha técnica da placa. Mas a sua carga é memory-bound. Você dimensionou pelo músculo errado.
Saber dói menos que descobrir em produção. E descobrir em produção, num sistema onde latência vira dinheiro, é o tipo de lição que eu já vi custar caro.
conclusão: a conta tem uma física, e dá pra prever
Um token não é grátis, e agora você sabe exatamente onde o dinheiro vai. Ler o prompt é barato porque é compute-bound e paralelo. Gerar a resposta é caro porque é memory-bound e sequencial: cada token relê todos os pesos da memória, e a banda da GPU, não a sua engenhosidade de prompt, define o teto de velocidade.
Isso não é trivia acadêmica. É a base do modelo mental que sustenta a série inteira. Prefill e decode, KV cache, quantização, batching, p99: tudo que vem pela frente é consequência dessa assimetria entre ler e gerar. Quem internaliza os três limites (compute, memória, overhead) para de otimizar no escuro e passa a diagnosticar antes de gastar. É a diferença entre apertar parafuso aleatório e medir onde a peça range.
A galera de bolsa aprendeu isso do jeito difícil décadas atrás: você não conserta latência que não mediu, e não dimensiona capacidade pelo recurso errado. A IA está reaprendendo a mesma lição agora, com zeros a mais na fatura.
Insights & Takeaways
- Todo código de GPU está preso por um de três limites: compute-bound (a conta), memory-bound (mover dados) ou overhead-bound (CPU/launch). Diagnosticar o limite certo vale mais que qualquer micro-otimização.
- Ler o prompt (prefill) é compute-bound e paralelo, logo barato. Gerar a resposta (decode) é memory-bound e sequencial, logo caro: cada token relê todos os pesos do modelo da memória.
- O teto de geração é banda de memória dividida por bytes dos pesos. Num modelo 7B em FP16 (14 GB) numa GPU de ~3 TB/s, isso dá ~214 tokens/seg no máximo teórico, e nenhum código supera a física.
- Quantizar de FP16 pra INT8 corta os pesos pela metade e dobra o teto de banda sem trocar hardware. Quantização é alavanca de latência, e não apenas de VRAM como a maioria trata.
- A eficiência real não vem de gerar um token mais rápido, vem de atender muita gente lendo os pesos uma vez só (batching). O silício manda na conta, não o prompt.
Uma pergunta honesta pra fechar, no espírito de proteger o seu time antes do incidente: se o seu produto de IA dobrar o tamanho médio das respostas geradas, a sua conta de GPU dobra junto, ou explode? Se você não sabe responder de cabeça, vale medir antes que o mês 28 chegue com o print da fatura no Slack.
No próximo artigo da série a gente segue a viagem de um token do teclado até a GPU, etapa por etapa, e monta o mapa que todos os temas seguintes vão preencher.