IA de Alta Performance · Episódio 3
Gerar Texto é o Pior Trabalho Que Já Deram Pra Uma GPU
Prefill e decode usam a GPU de formas opostas: por que o decode deixa a placa ociosa, o que o MFU revela e qual alavanca acelera cada fase.
Neste artigo · 11 seções
- as duas fases, agora por dentro
- prefill: o trabalho dos sonhos da GPU
- decode: o pior trabalho do mundo pra uma placa dessas
- vamos medir, que o MFU não deixa mentir
- a mesma alavanca, efeitos opostos
- o que salva o decode: dividir a conta
- o diagrama: duas fases, dois destinos da placa
- meça as duas fases separado, ou não meça nada
- por que quem decide deveria ler isto
- conclusão: o gargalo tem duas caras
- Insights & Takeaways
Rode um monitor de GPU enquanto o seu modelo gera uma resposta e você vai ver um número que parece defeito. A utilização da placa travada num dígito só: 4%, 6%. Uma GPU de dezenas de milhares de dólares, mais de 90% ociosa, e a resposta ainda saindo devagar, palavra por palavra.
Não é defeito. É a natureza do trabalho.
A gente comprou a máquina mais paralela que a engenharia já produziu, milhares de núcleos feitos pra fazer milhares de contas ao mesmo tempo, e mandou ela escrever um texto. Uma palavra de cada vez. É como contratar mil pedreiros e pedir pra levantarem um muro passando um tijolo de mão em mão. Novecentos e noventa e nove ficam parados olhando um trabalhar.
Nos artigos anteriores desta série a gente viu a física, por que gerar é memory-bound, e o mapa, as seis etapas do caminho de um token. Agora vamos encarar a parte mais contraintuitiva de tudo. Uma inferência tem duas fases, e elas usam a GPU de formas tão opostas que o que acelera uma não faz absolutamente nada pela outra. Quem não separa as duas troca de placa esperando milagre e recebe a mesma lentidão, com uma fatura maior.
as duas fases, agora por dentro
Você já conhece os nomes do artigo do mapa. Prefill é a fase que lê o seu prompt. Decode é a fase que gera a resposta, token a token. O que a gente não abriu ainda é por que elas são tão diferentes a ponto de merecerem estratégias opostas. É isso que decide onde vale gastar.
A diferença mora numa razão que o pessoal de computação de alta performance vive medindo: quantas contas você faz para cada byte que traz da memória. Chamam de intensidade aritmética. É ela que diz se o seu gargalo vai ser o poder de cálculo ou a banda de memória. Guarde a ideia, porque as duas fases ficam em lados opostos dessa régua.
prefill: o trabalho dos sonhos da GPU
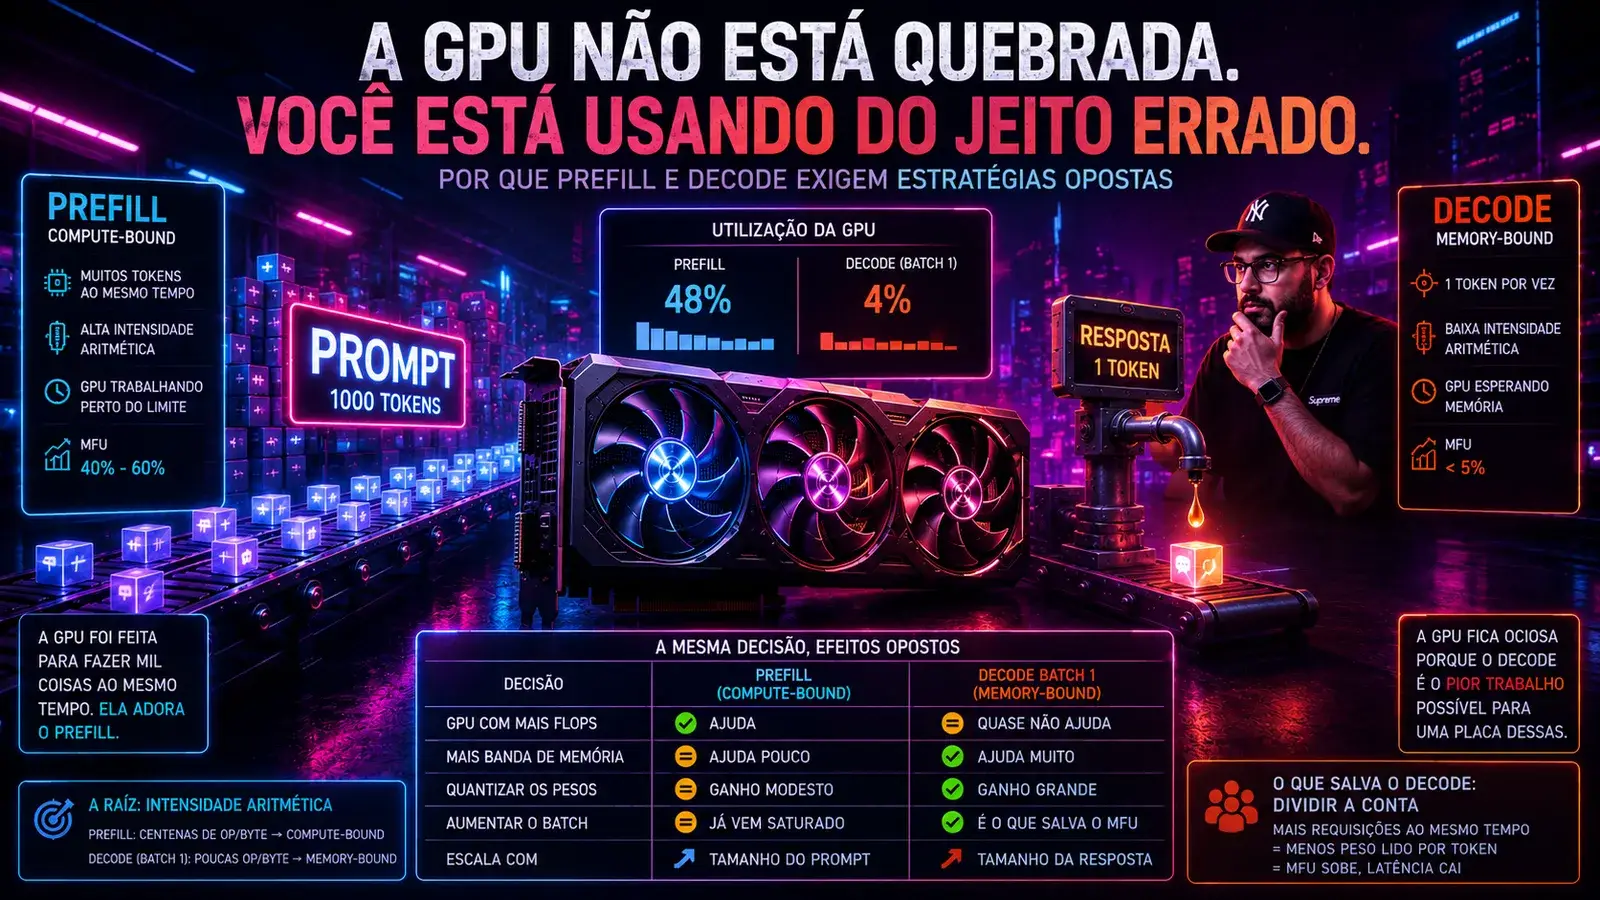
No prefill, todos os tokens do prompt entram juntos. Mil tokens de contexto atravessam as camadas do modelo no mesmo passo, em paralelo. E aqui está o ponto: os pesos do modelo são lidos uma vez da memória e reaproveitados para processar os mil tokens de uma tacada.
Isso enche a GPU de trabalho denso. Muita conta para cada byte trazido da memória, intensidade aritmética alta, os núcleos todos ocupados fazendo o que nasceram pra fazer. É trabalho compute-bound, e a placa opera perto do seu potencial. Se você já mediu quanto de um pregão chega na abertura, aquele estouro em que o book inteiro despenca de uma vez e o sistema tem que digerir um volume absurdo num átimo, é essa a sensação: um pico denso, paralelo, que satura tudo. A GPU adora prefill.
decode: o pior trabalho do mundo pra uma placa dessas
Aí começa a geração, e o jogo vira do avesso.
No decode o modelo produz um token por vez, e cada token depende do anterior. Não dá pra adivinhar a quinta palavra antes de decidir a quarta. Então a GPU processa um token só por passo. Um. E pra gerar esse único token, ela precisa reler todos os pesos do modelo da memória, os mesmos 14 gigabytes de um modelo de 7 bilhões de parâmetros que a gente já contou lá atrás.
Faça a razão: você traz 14 gigabytes de peso pra fazer a conta de um token só. A intensidade aritmética despenca pra um punhado de operações por byte. Os núcleos de cálculo ficam de braços cruzados, esperando o próximo carregamento de memória chegar. É trabalho memory-bound do começo ao fim, e a placa passa a maior parte do tempo esperando, não calculando. É o gotejar de ordens no resto do pregão, uma de cada vez, com a estrutura toda subdimensionada de propósito porque o pico já passou.
A ironia é cruel. Quanto mais poderosa a GPU, em termos de núcleos de cálculo, mais ela fica ociosa no decode. Você comprou paralelismo e a tarefa é sequencial por natureza.
vamos medir, que o MFU não deixa mentir
Existe uma métrica que expõe isso sem piedade: o MFU, Model FLOPs Utilization. É a fração do poder teórico da GPU que você de fato usa. Cem por cento seria a placa rendendo tudo que a ficha técnica promete.
No prefill, com prompt razoável, um serving bem feito chega a algo entre 40% e 60% de MFU. A placa suando. No decode com uma requisição só, o batch de tamanho um, o MFU costuma ficar abaixo de 5%. Às vezes 2%, 3%. Não é exagero de retórica, é o número que aparece quando você instrumenta. A mesma GPU, o mesmo modelo, dez vezes mais eficiente numa fase que na outra.
A raiz está na régua da intensidade aritmética. O ponto de virada das GPUs modernas, onde o gargalo deixa de ser memória e passa a ser cálculo, fica na casa das centenas de operações por byte. O prefill, com muitos tokens de uma vez, atravessa esse ponto e vira compute-bound. O decode com batch um vive lá embaixo, num punhado de operações por byte, cronicamente memory-bound. Mesma placa, dois mundos.
a mesma alavanca, efeitos opostos
Agora a parte que vale levar para a próxima reunião de arquitetura de IA. As duas fases respondem a otimizações diferentes, e vários times gastam dinheiro no lado errado por não perceber isso.
Comprar uma GPU com mais poder de cálculo acelera o prefill e quase não move o ponteiro do decode em batch um, porque lá o gargalo nunca foi cálculo. Mais banda de memória faz o caminho inverso: ajuda pouco o prefill, que já está saturado de trabalho, e ajuda muito o decode, que passa a vida esperando peso chegar da memória.
Quantizar os pesos segue a mesma lógica invertida: ganho modesto na velocidade do prefill, ganho grande na do decode, porque cortar os bytes lidos por token é atacar exatamente o gargalo dele. E aumentar o batch, que no prefill não muda nada porque ele já vem saturado, é justamente o que salva a utilização da placa no decode.
Tem ainda a diferença que mais confunde na hora de dimensionar: o custo do prefill escala com o tamanho do prompt, e o do decode escala com o tamanho da resposta. São duas variáveis diferentes, controladas por decisões de produto diferentes, e quase sempre tratadas como uma coisa só na planilha.
Repare no incômodo que isso gera. A mesma decisão de infraestrutura produz resultado oposto dependendo da fase que domina a sua carga. Otimizar sem saber qual delas pesa é apostar no escuro com o dinheiro da empresa.
o que salva o decode: dividir a conta
Se o problema do decode é ler 14 gigabytes de peso pra atender um token só, a saída é óbvia quando você a enxerga: atenda muitos tokens no mesmo carregamento.
É o batching. Se a GPU já vai pagar o pedágio de subir os pesos da memória, que ela gere o próximo token de dez, cinquenta, cem requisições ao mesmo tempo, todas reaproveitando aquela leitura. A intensidade aritmética do decode cresce proporcional ao tamanho do batch, e o MFU sobe junto, de um dígito pra algo respeitável. É assim, e só assim, que uma GPU serve muita gente sem quebrar a economia. Vou dedicar um artigo inteiro ao batching dinâmico mais à frente, porque o assunto tem uma sutileza deliciosa: como juntar requisições que chegam em momentos diferentes sem fazer ninguém esperar o lote fechar. Por ora, guarde a intuição: no decode, batch é sobrevivência, não luxo.
o diagrama: duas fases, dois destinos da placa
O desenho abaixo mostra o contraste. No prefill, muitos tokens entram juntos, os pesos sobem uma vez, os núcleos saturam. No decode, um token entra por vez, todos os pesos sobem de novo a cada volta, e os núcleos ficam esperando a memória.
meça as duas fases separado, ou não meça nada
Aqui está o erro de medição que esconde tudo o que a gente discutiu. Cronometrar só o tempo total da resposta joga prefill e decode na mesma média e apaga os dois regimes:
// ❌ mede só o tempo total: a média funde prefill e decode
var sw = Stopwatch.StartNew();
var resposta = await chat.CompleteAsync(prompt);
sw.Stop();
Log($"latência: {sw.ElapsedMilliseconds} ms");
// e agora, foi o prompt gigante ou a resposta longa que pesou? impossível saber
Separar o tempo do primeiro token do tempo entre tokens revela qual fase manda na sua conta:
// ✅ separa prefill (primeiro token) de decode (intervalo entre tokens)
var sw = Stopwatch.StartNew();
TimeSpan? primeiroToken = null;
var anterior = TimeSpan.Zero;
var intervalos = new List<double>();

await foreach (var token in chat.CompleteStreamingAsync(prompt))
{
    var agora = sw.Elapsed;
    if (primeiroToken is null) primeiroToken = agora;          // custo do prefill
    else intervalos.Add((agora - anterior).TotalMilliseconds); // custo do decode
    anterior = agora;
}

Log($"prefill ~{primeiroToken!.Value.TotalMilliseconds:F0} ms · " +
    $"decode ~{intervalos.Average():F1} ms por token");
O primeiro token carrega o custo do prefill, o intervalo entre os tokens seguintes é puro decode. Duas fases, duas métricas, e no próximo artigo elas ganham nome próprio, TTFT e ITL, o vocabulário sem o qual você não define um SLA de IA. Medir junto é como reportar a temperatura média de um paciente com um pé no gelo e outro no forno.
por que quem decide deveria ler isto
Você pode chamar uma API e deixar o provedor cuidar das duas fases. Justo, até a conta ou a reclamação chegarem. Aí o quadro vira decisão de produto.
Um recurso que enfia muito contexto no prompt, RAG com dez documentos, histórico longo de conversa, é uma carga pesada de prefill: o tempo até a primeira palavra sobe, e o usuário encara a tela parada. Um recurso que gera respostas longas é uma carga pesada de decode: o custo e o tempo crescem com cada token que sai. São duas alavancas de custo diferentes, e cada uma se resolve de um jeito. Cortar contexto ataca o prefill. Limitar o tamanho da resposta ataca o decode. Trocar de GPU pode não atacar nenhum dos dois, se você comprou músculo de cálculo pra uma carga que sofre de banda de memória.
Já escrevi nesta casa sobre o custo oculto de fazer o processador gastar ciclo com o trabalho errado quando falei de context switches. Aqui é a mesma família de problema numa escala bem mais cara: hardware caro parado, sem produzir trabalho útil. No decode esse desperdício vem embutido na natureza da tarefa, e o seu trabalho é diluí-lo com batch, não fingir que dá pra eliminar.
conclusão: o gargalo tem duas caras
Uma inferência não tem um perfil de custo, tem dois. O prefill é denso, paralelo e compute-bound, e satura a GPU. O decode é sequencial, esfomeado de memória e memory-bound, e deixa a GPU ociosa esperando os pesos subirem, um token por vez. A mesma placa rende dez vezes mais numa fase que na outra, e a otimização que resolve uma não encosta na outra.
Gerar texto é mesmo o pior trabalho que já deram pra uma GPU, e não tem conserto nenhum, tem gestão. Você mede as duas fases separado, descobre qual domina a sua carga, e escolhe a alavanca certa: batch e banda e quantização pro decode, poder de cálculo pro prefill. Quem trata as duas como se fossem a mesma coisa faz o que a bolsa aprendeu a nunca fazer, dimensionar o sistema pela média em vez de dimensionar pelos dois regimes que ele realmente tem.
Insights & Takeaways
- Uma inferência tem duas fases com perfis opostos: prefill (lê o prompt, paralelo, compute-bound, satura a GPU) e decode (gera token a token, sequencial, memory-bound, deixa a GPU ociosa).
- O MFU não deixa mentir: prefill chega a 40 a 60% de utilização real; decode com uma requisição só costuma ficar abaixo de 5%. A mesma GPU, dez vezes mais eficiente numa fase que na outra.
- A mesma otimização tem efeito oposto nas duas fases. Mais FLOPs aceleram o prefill e quase nada o decode; quantização e banda de memória aceleram o decode e pouco o prefill. Otimizar sem saber qual fase pesa é gastar no escuro.
- Batching é a salvação do decode: atender muitas requisições no mesmo carregamento de pesos faz o MFU sair de um dígito, porque dilui o custo de memória por token.
- Prompt longo é carga de prefill (sobe o tempo até o primeiro token); resposta longa é carga de decode (sobe custo e tempo total). São alavancas de custo diferentes, com soluções diferentes.
Uma pergunta honesta pra fechar, no espírito de proteger o time antes do incidente: você sabe, dos seus recursos de IA, quais sofrem de prefill e quais sofrem de decode? Se a resposta é "a gente mede a latência total e pronto", a sua próxima decisão de infraestrutura vai ser um chute caro, e o boleto chega antes da resposta.
No próximo artigo a gente dá nome ao que acabamos de medir: TTFT, ITL e tokens por segundo, o vocabulário de performance que separa quem define um SLA de IA de quem só torce pra dar certo.