IA de Alta Performance · Episódio 15
Seu Cliente Lê Mais Devagar do Que o Modelo Escreve
Cliente lento prende KV cache e derruba a capacidade da GPU. Como backpressure, cancelamento propagado e SSE no ASP.NET Core protegem o streaming de tokens.
Neste artigo · 8 seções
Existe um problema que todo sistema de tempo real encontra mais cedo ou mais tarde, e ele é anterior à IA em algumas décadas: o produtor é mais rápido que o consumidor.
Num feed de cotações, isso aparece no primeiro dia de mercado agitado. O motor publica atualizações num ritmo que a rede de alguns assinantes não acompanha, e a fila de saída daquele cliente começa a crescer. Se ninguém resolver, a memória do publicador vira refém do assinante mais lento da lista, e um cliente ruim degrada o serviço de todo mundo. A área aprendeu a lidar com isso faz tempo, e a solução clássica é elegante: descartar as atualizações intermediárias e mandar só a última, porque num livro de ofertas o preço novo torna o preço antigo irrelevante.
Agora troque o feed pelo seu endpoint de chat. O modelo gera tokens a uma velocidade que a série já colocou em números, na casa de dezenas por segundo, e do outro lado da conexão tem uma aba de navegador num 4G ruim, um aplicativo em segundo plano, ou um serviço que consome a resposta e escreve num banco lento. O produtor é mais rápido que o consumidor de novo.
Só que a solução do feed de cotações não serve aqui, e o motivo dessa diferença é o que faz este artigo existir.
por que descartar não é uma opção
Num feed de preços, as mensagens são substituíveis. A cotação das 10h32m18s torna obsoleta a das 10h32m17s, então pular uma atualização não é perda de informação, é economia. Esse mecanismo é o que permite ao publicador jogar fora o excesso quando o consumidor engasga.
Token não funciona assim. O token 41 não substitui o token 40; ele continua o 40. A saída é uma sequência ordenada e completa, ou não é uma resposta. Você não pode amostrar, não pode pular, não pode entregar o resumo do que se perdeu.
Some a isso a característica que torna o problema caro: enquanto a resposta não termina de sair, a sequência continua viva dentro do servidor de inferência. E sequência viva, depois de tudo que esta temporada mostrou, tem um preço bem definido.
o que realmente fica preso
A tentação é tratar cliente lento como problema de rede. Um socket ocupado, alguns kilobytes em buffer, nada que assuste.
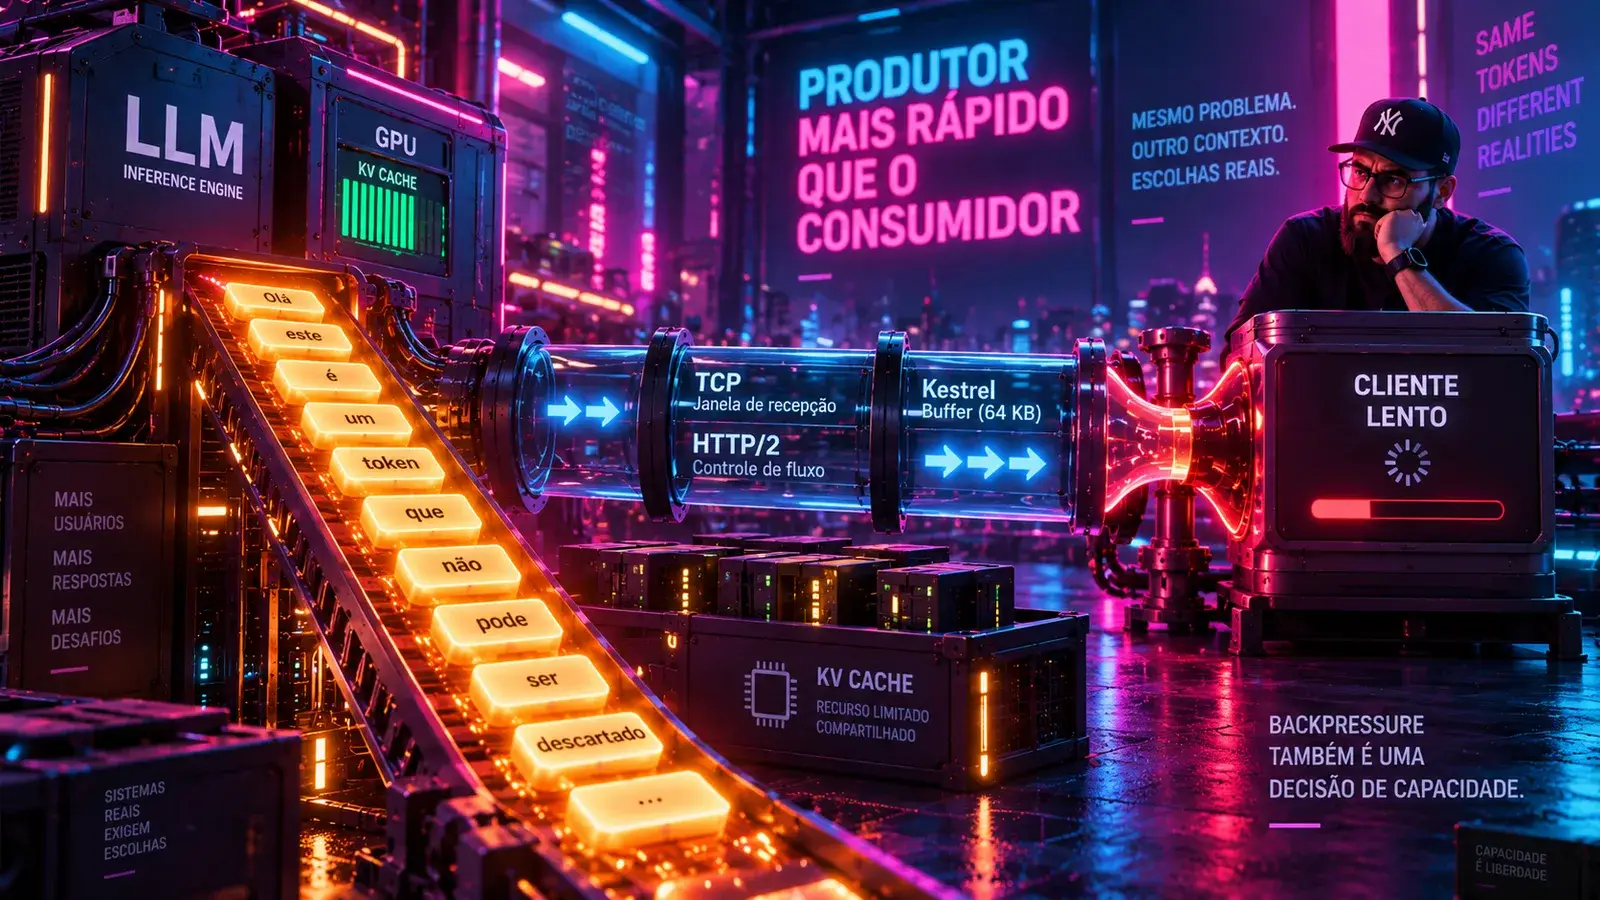
Só que num servidor de LLM o que fica preso é outra coisa. Enquanto aquela sequência não é encerrada, ela ocupa blocos de KV cache, e o artigo anterior sobre paginação mostrou que esses blocos são o recurso que decide quantas pessoas cabem na placa. O lote contínuo admite requisições novas enquanto houver memória livre; blocos presos por uma sequência que já terminou de ser calculada e está apenas esperando o cliente ler são blocos que não voltam para o pool.
Traduzindo para a linguagem que interessa: um punhado de clientes lentos derruba a capacidade da sua GPU sem aparecer em nenhuma métrica de GPU. A placa não está mais ocupada, a utilização não subiu, a fatura é a mesma. O que caiu foi quantas sequências novas você consegue admitir, e isso aparece na fila de entrada, longe do lugar onde a causa mora.
Por isso a decisão sobre backpressure num serving de IA não é uma decisão de camada de transporte. É uma decisão de capacidade.
a corrente que já existe, e onde ela costuma arrebentar
A boa notícia é que a pilha inteira embaixo do seu código já sabe fazer backpressure, e faz por padrão.
O TCP tem janela de recepção: se o cliente não lê, a janela fecha e o remetente para de transmitir. O HTTP/2 tem controle de fluxo próprio por stream, com o receptor anunciando quanto ainda aceita. E o Kestrel tem um buffer de resposta com limite padrão de 64 KB, ponto em que as escritas passam a devolver tarefas que só completam quando o buffer drena. Ou seja: se você escrever no corpo da resposta e esperar o resultado, o cliente lento vira naturalmente um await que demora, e o seu código para de produzir sozinho.
A corrente arrebenta quando alguém, com a melhor das intenções, coloca um balde no meio dela.
O balde mais comum é uma fila sem limite entre o laço que gera tokens e o laço que escreve na resposta. A intenção é boa, desacoplar geração de entrega para o modelo não ficar refém da rede. O efeito é que o backpressure do transporte deixa de chegar em quem produz: a fila absorve tudo, cresce em memória gerenciada, e o servidor troca "cliente lento" por "consumo de memória subindo até alguém reiniciar o pod". Já escrevi sobre as garantias que um canal producer-consumer oferece, e a diferença entre CreateBounded e CreateUnbounded é exatamente a diferença entre ter backpressure e ter esperança.
O segundo jeito de arrebentar a corrente é ignorar o cancelamento. O cliente fecha a aba, a conexão morre, e o laço de geração continua tocando porque ninguém propagou o sinal até ele. A GPU segue produzindo tokens para um destinatário que não existe mais, e os blocos de KV cache seguem alugados.
as três saídas de projeto
Descartada a opção de jogar token fora, sobram três desenhos possíveis, e a escolha entre eles é de produto tanto quanto de engenharia.
O primeiro é deixar o backpressure chegar até o decode. A geração acompanha o ritmo do consumidor, sem buffer intermediário além do mínimo. É o desenho mais simples e o mais honesto com a memória do servidor, e tem um efeito colateral desconfortável: o slot fica ocupado pelo tempo do cliente mais lento, então a capacidade do sistema passa a depender da qualidade da rede dos seus usuários.
O segundo é um buffer limitado com política explícita de descarte do cliente, não da mensagem. Enquanto o cliente acompanha, o buffer é folga que absorve microengasgos de rede. Quando ele estoura o limite por tempo demais, a conexão é encerrada com um erro claro em vez de degradar todo mundo em silêncio. É o desenho que eu defendo como padrão, porque protege a capacidade e transforma um problema difuso em um evento observável.
O terceiro é desacoplar de verdade, e ele só existe quando o produto permite. A geração roda até o fim na velocidade da GPU, o resultado vai para um armazenamento intermediário, e o cliente consome de lá, com direito a reconectar e retomar de onde parou. O slot de KV cache é liberado assim que o último token sai do modelo, não quando o último token chega ao usuário. Custa mais peça na arquitetura e ganha resiliência de verdade: numa reconexão, a resposta não é regerada nem perdida.
Os três desenhos respondem à mesma pergunta com prioridades diferentes: quem paga a diferença de velocidade, a GPU, a memória do servidor ou o armazenamento.
o ganho mais barato de todos
Antes de qualquer desses desenhos, tem uma linha de código que quase todo serving artesanal esquece: parar de gerar quando o cliente vai embora.
Em ASP.NET Core, o token de cancelamento da requisição dispara quando a conexão cai. Propagar esse token até o laço de inferência, e realmente conferir se ele foi acionado a cada passo, encerra a sequência, devolve os blocos ao pool e libera o slot no mesmo instante. Em produtos de chat, onde a pessoa lê metade da resposta e reformula a pergunta, essa devolução acontece o tempo todo.
É otimização de uma linha com efeito de capacidade. Vale medir quantas sequências por hora terminam por desconexão do cliente no seu sistema hoje; em interfaces conversacionais, o número costuma surpreender.
o protocolo é a decisão menos importante, mas vale acertar
Três opções, três casos.
Para navegador e resposta em texto, eventos enviados pelo servidor sobre HTTP resolvem, e viraram o padrão de fato das APIs de LLM. É unidirecional, é texto, atravessa proxy sem drama e traz reconexão com retomada por identificador de evento embutida no protocolo. O .NET 10 passou a expor isso direto na API mínima, com um resultado tipado que consome uma sequência assíncrona e cuida do enquadramento, o que elimina a colcha de retalhos de escrever o formato na mão.
Para comunicação entre serviços, streaming sobre gRPC entrega controle de fluxo por stream, mensagens tipadas e multiplexação, com backpressure que se propaga em vez de virar buffer.
Para bidirecional de verdade, WebSocket. E aqui existe um caso real que os outros dois não atendem bem: voz, onde o usuário interrompe a resposta no meio e o servidor precisa receber esse sinal enquanto envia áudio. Interromper cedo é, aliás, a forma mais eficiente de liberar GPU que existe.
dois detalhes que mudam o comportamento sob carga
O primeiro detalhe é o tipo do canal. O segundo é o token que ninguém passa adiante.
// ❌ o balde no meio da corrente
var canal = Channel.CreateUnbounded<string>();          // absorve tudo, esconde o cliente lento

_ = Task.Run(async () =>                                 // e ninguém observa esta tarefa
{
    await foreach (var token in modelo.GerarAsync(prompt))   // sem CancellationToken
        canal.Writer.TryWrite(token);                        // nunca falha, nunca espera
});

await foreach (var token in canal.Reader.ReadAllAsync())
    await resposta.WriteAsync($"data: {token}\n\n");     // sem flush explícito
// ✅ limite explícito, cancelamento propagado, entrega sob demanda
app.MapGet("/chat", (string prompt, HttpContext ctx) =>
{
var ct = ctx.RequestAborted; // o cliente sumiu? o decode para.
async IAsyncEnumerable<SseItem<string>> Gerar()
{
var canal = Channel.CreateBounded<string>(new BoundedChannelOptions(64)
{
FullMode = BoundedChannelFullMode.Wait // escrever ESPERA: o sinal sobe
});
var producao = Task.Run(async () =>
{
await foreach (var t in modelo.GerarAsync(prompt, ct))
await canal.Writer.WriteAsync(t, ct); // aqui o produtor sente o consumidor
canal.Writer.Complete();
}, ct);
await foreach (var t in canal.Reader.ReadAllAsync(ct))
yield return new SseItem<string>(t);
await producao; // falha do produtor não some no vazio
}
return TypedResults.ServerSentEvents(Gerar());
});O ponto não é a API, que muda a cada versão. É a forma: um limite no lugar onde a produção encontra a entrega, e um cancelamento que atravessa a pilha inteira até o laço que ocupa a GPU. Com esses dois, o cliente lento vira um await que demora, que é exatamente o que ele deveria ser. Sem eles, ele vira um vazamento de capacidade que aparece três camadas depois, no gráfico errado.
Insights & Takeaways
- Streaming de token é o problema clássico de produtor rápido com consumidor lento, mas sem a saída clássica: em feed de cotações a mensagem nova substitui a antiga e dá para descartar; token é sequência ordenada e completa, então descartar não é opção.
- O que um cliente lento prende num servidor de LLM não é socket, é slot: enquanto a resposta não termina de sair, os blocos de KV cache continuam alugados e o lote contínuo admite menos gente. A causa está na rede e o sintoma aparece na fila.
- A pilha já faz backpressure de graça (janela do TCP, controle de fluxo do HTTP/2, buffer de resposta com limite no Kestrel). Quem quebra a corrente costuma ser uma fila sem limite colocada no meio com a melhor das intenções.
- São três desenhos possíveis: deixar o backpressure chegar ao decode, usar buffer limitado com desconexão explícita do cliente teimoso, ou desacoplar geração de entrega com armazenamento intermediário. Eles diferem em quem paga a diferença de velocidade.
- O ganho mais barato é propagar o cancelamento: quando o cliente fecha a aba, a geração precisa parar e os blocos voltarem ao pool. Meça quantas sequências por hora terminam por desconexão antes de decidir que isso é detalhe.
Uma pergunta honesta pra fechar: se um único cliente entrar no seu endpoint de streaming e ler um token por segundo, o que acontece com o resto do sistema? Se a resposta for "nada", ótimo, a corrente está inteira. Se for "não sei", vale simular, porque esse teste custa dez minutos e revela se a sua capacidade de GPU depende da qualidade do 4G dos seus usuários.
No próximo artigo, a série encara o painel que todo mundo olha e quase ninguém interpreta: a placa marcando 100% de utilização enquanto entrega uma fração do que poderia. Vamos falar de utilização contra saturação, do joelho da curva onde adicionar carga piora a vida de todos, e de como fazer planejamento de capacidade de GPU do jeito que se faz com sistema de baixa latência de verdade.