IA de Alta Performance · Episódio 10
Nem Toda IA Precisa de Data Center
Um modelo de 3B em 4 bits gera 50 tokens por segundo num notebook. Quando a IA local ganha da nuvem, onde ela quebra e por que o desenho certo é híbrido.
Neste artigo · 9 seções
- a mesma fórmula, hardware de consumidor
- a peça nova: NPU
- por que o modelo pequeno virou utilizável
- os três argumentos que ninguém consegue rebater
- onde desanda, e desanda feio
- o diagrama: quando o local ganha
- a arquitetura que sai disso não é escolher um lado
- conclusão: fecha a temporada onde ela começou
- Insights & Takeaways
A conversa sobre IA em produção assume um data center no meio dela. Sempre. Alguém fala em modelo, e o desenho mental que aparece é um cluster de GPUs em algum lugar, uma API no meio do caminho e uma fatura no fim do mês.
Só que a mesma física que esta série vem usando para explicar por que a inferência é cara na nuvem explica, sem nenhuma adaptação, por que ela ficou barata no notebook que você está usando para ler isto.
Não é o mesmo trabalho, e eu vou ser honesto sobre onde a coisa desanda. Mas a fronteira entre "precisa de data center" e "roda aqui do lado" andou muito nos últimos dois anos, e andou para um lugar que muita arquitetura ainda não incorporou.
Este é o último artigo da temporada, então ele fecha a conta que abri no primeiro.
a mesma fórmula, hardware de consumidor
No primeiro artigo desta série eu montei a conta do teto de velocidade da geração de token, e ela é uma divisão só: a banda de memória disponível dividida pelos bytes de peso que precisam ser lidos a cada token. Vale para qualquer hardware, porque é uma propriedade da física do problema, não do fabricante.
Aplique num servidor. Um modelo de 7 bilhões em FP16 ocupa 14 gigabytes, e uma GPU de data center oferece banda na casa de 3 TB/s. Dá um teto ao redor de 214 tokens por segundo, número que fechei naquele artigo.
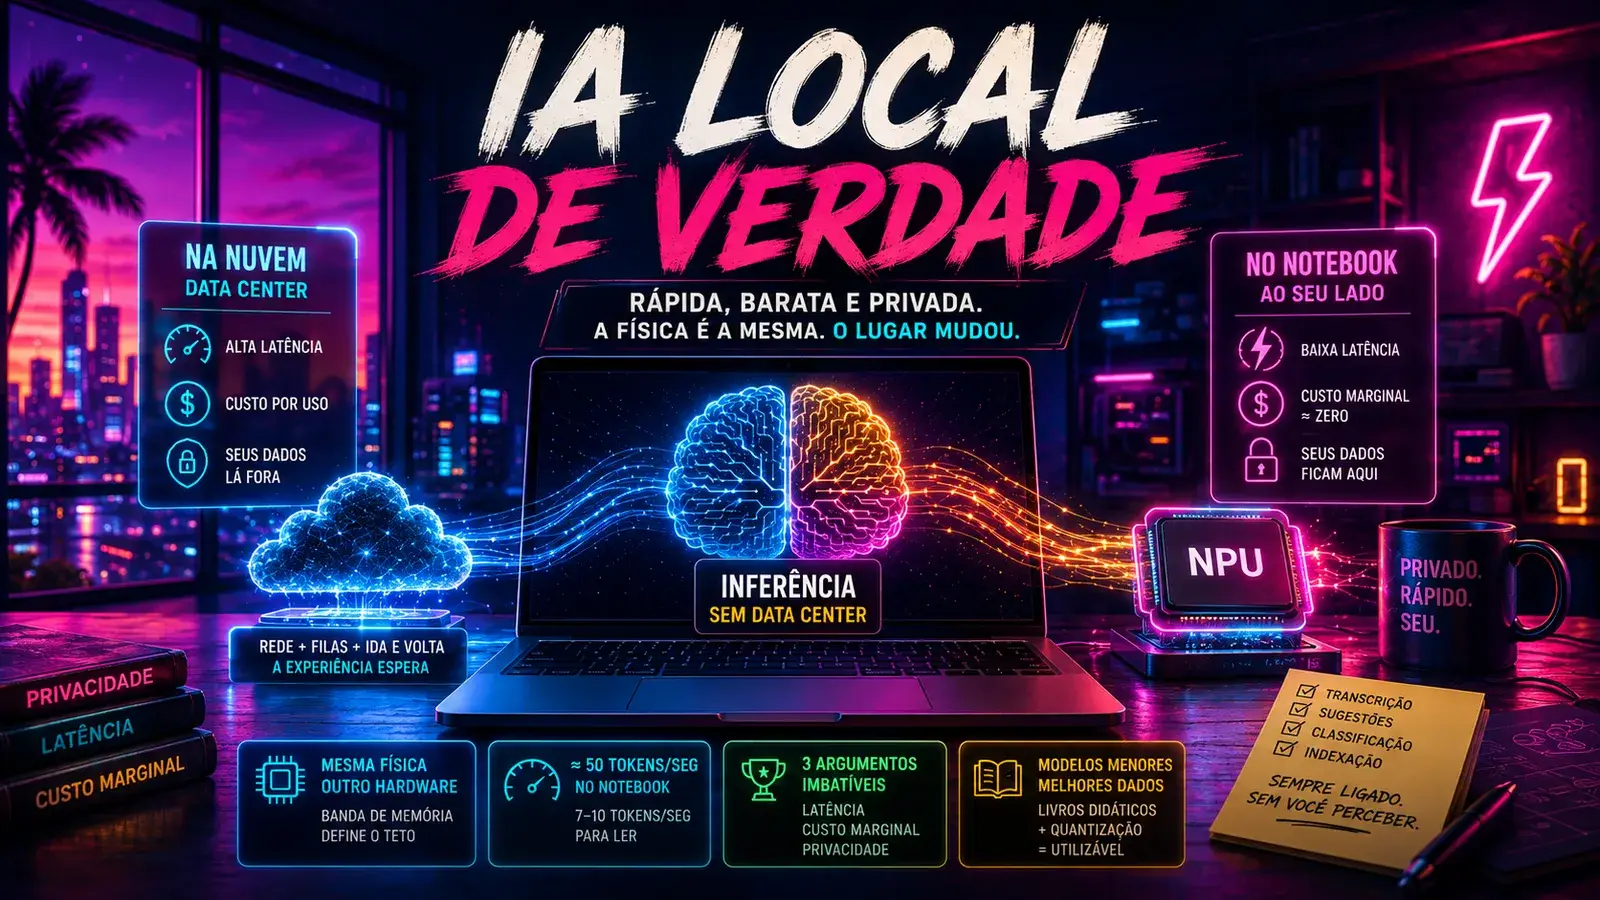
Agora aplique num notebook moderno. Um modelo de 3 bilhões quantizado em 4 bits ocupa por volta de 2 gigabytes. A memória unificada dessas máquinas entrega banda na ordem de 100 GB/s, com variação grande entre fabricantes:
teto de tokens/seg  =  banda de memória / bytes dos pesos
teto de tokens/seg  =  100 GB/s  /  2 GB por token
teto de tokens/seg  ≈  50 tokens/seg
Cinquenta tokens por segundo. Guarde esse número ao lado de outro que estabeleci no artigo sobre vocabulário de latência: uma pessoa lendo confortavelmente consome algo entre 7 e 10 tokens por segundo.
Ou seja, o notebook gera texto cinco vezes mais rápido do que você consegue ler. O gargalo da experiência deixou de ser a máquina.
E repare no motivo de o número não ser ridículo perto do servidor: a razão entre os dois tetos é de umas quatro vezes, para um hardware que custa cem vezes menos. Isso acontece porque os dois casos são limitados por banda de memória, e a diferença de banda entre eles é muito menor que a diferença de poder de cálculo. Toda a vantagem monstruosa de FLOPs da GPU de data center não aparece aqui, porque, como a série vem repetindo, gerar token não é um problema de cálculo.
A GPU cara ganha em outra coisa: atender muita gente ao mesmo tempo. No seu notebook, o lote é sempre um.
a peça nova: NPU
O componente que apareceu nos notebooks recentes e que quase ninguém sabe explicar é a NPU, e vale desfazer um mal-entendido comum sobre ela.
NPU não é uma GPU pequena, e o objetivo dela não é ser a coisa mais rápida da máquina. Ela é um bloco de silício dedicado a multiplicação de matrizes com precisão reduzida, projetado com uma métrica diferente na cabeça: trabalho por watt.
Isso muda o que ela resolve. Rodar um modelo na GPU integrada do notebook funciona e costuma ser mais rápido, mas esquenta, liga a ventoinha e come bateria em minutos. A NPU faz o mesmo trabalho consumindo uma fração da energia, o que permite uma coisa que a GPU não permite: manter o modelo rodando o tempo todo, em segundo plano, sem que o usuário perceba pelo barulho ou pela autonomia.
É por isso que a NPU importa. Ela não torna a IA local mais rápida. Ela torna a IA local aceitável de deixar ligada, e isso muda quais funcionalidades você pode construir. Transcrição contínua, sugestão enquanto se digita, classificação de tudo que chega, indexação em tempo real: são coisas que só fazem sentido se o custo de energia for próximo de zero.
por que o modelo pequeno virou utilizável
Nada disso funcionaria se o modelo de 3 bilhões fosse burro demais para servir para alguma coisa, e até pouco tempo atrás era.
A virada veio de uma tese que o pessoal da Microsoft defendeu com a família Phi, e que o título do paper resume melhor que qualquer explicação: livros didáticos são tudo que você precisa. A ideia é que boa parte do tamanho dos modelos grandes existe para compensar a qualidade ruim do texto com que foram treinados. Treinando um modelo pequeno com dados cuidadosamente selecionados, sintéticos e didáticos, você chega perto do desempenho de modelos várias vezes maiores nas tarefas que importam.
Some isso à quantização, que rendeu artigo próprio nesta série, e o resultado é o que temos hoje: um modelo de alguns bilhões de parâmetros, comprimido para 4 bits, que cabe em dois gigabytes e responde razoavelmente bem numa faixa ampla de tarefas úteis.
os três argumentos que ninguém consegue rebater
Quando o local ganha, ele ganha por motivos que não são de qualidade do modelo, e é importante separar isso.
O primeiro é latência, e ele é contraintuitivo. Uma chamada para a nuvem carrega ida e volta de rede, fila do provedor e o tempo de processar. O local não tem rede nem fila. Para respostas curtas, uma máquina local com modelo mediano frequentemente entrega a resposta completa antes de a nuvem terminar de estabelecer conversa, mesmo com um modelo muito melhor do outro lado. Quando o trabalho é classificar uma frase ou extrair três campos de um texto, o tempo de rede domina a conta inteira.
O segundo é custo marginal. Depois que o hardware está comprado, e ele já estava, cada inferência custa energia e nada mais. Não tem contador rodando, não tem surpresa no fim do mês, não tem alguém precisando explicar por que a fatura subiu 40%. Para funcionalidades de alto volume e baixo valor unitário, isso é a diferença entre existir e não existir.
O terceiro é privacidade, e é o que mais pesa no público que trabalha com dado sensível. O dado não sai da máquina. Não tem contrato de processamento, não tem discussão sobre retenção, não tem risco de vazamento em trânsito. Quando escrevi sobre IA em ambientes regulados, boa parte da complexidade que descrevi vinha justamente de mandar dado para fora. Processar local não resolve governança sozinho, mas apaga uma categoria inteira de problema, e apagar categoria de problema vale mais que otimizar dentro dela.
onde desanda, e desanda feio
O entusiasmo com IA local costuma ignorar dois limites duros, e eles são duros mesmo.
O primeiro é o contexto, e ele é o assassino silencioso. A memória do KV cache, aquela conta que fechei no artigo sobre o vilão da conta de GPU, não desaparece porque o hardware é menor: ela cresce com o tamanho do contexto exatamente igual. Num notebook com 16 gigabytes de memória total, compartilhada entre o sistema operacional, o navegador com quarenta abas e o modelo, a janela de contexto que sobra é modesta. Jogar um documento de cinquenta páginas ali dentro não é lento: é impossível. O modelo local é ótimo com entradas curtas e trava com entradas longas, e essa é a fronteira que mais gente descobre tarde.
O segundo é a qualidade em raciocínio aberto. Modelo pequeno é bom em tarefa fechada, com formato claro e resposta verificável: classificar, extrair, reescrever, resumir texto curto, completar código simples. Em cadeia longa de raciocínio ele degrada, e degrada do jeito perigoso que descrevi no artigo de quantização, ficando fluente e confiante enquanto erra. Se a sua funcionalidade precisa de julgamento, planejamento ou conhecimento de mundo profundo, o modelo de dois gigabytes não é a resposta e não vai ser tão cedo.
o diagrama: quando o local ganha
a arquitetura que sai disso não é escolher um lado
O desenho acima termina no híbrido de propósito, porque é o que funciona na prática e é a parte acionável deste artigo.
O padrão útil é usar o modelo local como triagem. Ele roda em tudo, de graça e rápido, e resolve os casos fáceis, que costumam ser a maioria. O que ele não dá conta, ou o que ele mesmo sinaliza como incerto, sobe para o modelo grande na nuvem. Você paga o modelo caro só pela fração que realmente precisa dele.
O efeito no custo é grande porque a distribuição de dificuldade das requisições reais é sempre torta: a maior parte do volume é trivial. Filtrar o trivial localmente derruba o volume que chega na API, e derrubar volume é a única forma de economia que não tem contrapartida em qualidade, ao contrário de trocar por um modelo pior ou cortar contexto.
E tem o ganho que não aparece na planilha: o sistema continua funcionando quando a API do fornecedor cai. Quem já viveu um incidente de provedor sabe o valor disso.
conclusão: fecha a temporada onde ela começou
Esta temporada começou com uma tese: o silício manda na conta, não o prompt. Dez artigos depois, este é o exemplo mais concreto dela.
Ninguém decidiu em reunião que a IA local ficaria viável. Aconteceram três coisas independentes: modelos pequenos ficaram bons porque foram treinados com dado melhor, a quantização amadureceu ao ponto de cortar quatro vezes sem estragar, e apareceu silício dedicado com consumo de energia baixo o suficiente para deixar tudo isso ligado o tempo todo. A soma dessas três coisas moveu a fronteira do que precisa de data center.
Quem entendeu a física entendeu a mudança antes, porque a conta é a mesma dos servidores: banda de memória dividida por bytes de peso. Quem só acompanhou o discurso de produto continua desenhando arquitetura como se toda inferência precisasse atravessar a internet.
Insights & Takeaways
- A fórmula do teto vale igual no notebook: um modelo de 3B em 4 bits ocupa 2 GB e, com banda de memória na casa de 100 GB/s, dá teto ao redor de 50 tokens por segundo. É cinco vezes mais rápido do que uma pessoa lê.
- A distância para a GPU de data center é de umas quatro vezes, não de cem, porque gerar token é limitado por banda e não por cálculo. Toda a vantagem de FLOPs do servidor serve para atender muita gente junto, não para responder mais rápido a uma pessoa.
- NPU não é GPU pequena: é silício de matriz otimizado para trabalho por watt. Ela não torna a IA local mais rápida, torna aceitável deixá-la ligada o tempo todo, e é isso que habilita funcionalidade contínua.
- O local ganha por latência sem rede, custo marginal quase nulo e dado que não sai da máquina. Perde em contexto longo, porque o KV cache não perdoa 16 GB compartilhados, e em raciocínio aberto, onde o modelo pequeno erra com fluência.
- A arquitetura que sai disso é híbrida: o modelo local faz triagem e resolve o caso fácil, que é a maioria do volume, e só o resto sobe para a nuvem. É a única economia que não cobra qualidade em troca.
Uma pergunta honesta pra fechar esta temporada: quanto do volume que você manda hoje para uma API paga é tarefa fechada, de entrada curta, que um modelo de dois gigabytes resolveria? Se você nunca separou o seu tráfego por dificuldade, essa é a medição de maior retorno que existe no seu backlog, e ela não custa nada além de olhar os logs que você já tem.
Aqui fecha a primeira temporada. A gente percorreu a física do token, o mapa da inferência, a assimetria entre ler e gerar, o vocabulário para medir, a memória que decide densidade, o stack .NET que ninguém conta, a compressão que não estraga, o trilema que governa toda decisão, a economia da placa ociosa e agora a fronteira do que nem precisa de data center.
Na próxima temporada eu abro a sala de máquinas do serving: como um servidor de inferência decente organiza fila, memória e lote para uma GPU atender dez vezes mais gente. Começando pelo jeito mais barato de servir uma resposta, que é não gerar ela de novo.