IA de Alta Performance · Episódio 4
Você Não Tem SLA de IA - Você Tem Esperança
TTFT, TPOT, ITL e tokens por segundo: o vocabulário para medir latência de LLM e escrever um SLA de IA com percentil, carga e tamanho de saída.
Neste artigo · 8 seções
Numa reunião de arquitetura alguém pergunta qual é o SLA da feature de IA. A resposta vem rápida, com aquela confiança de quem já mediu: "uns três segundos".
Três segundos até o quê? Até a primeira palavra aparecer na tela ou até a última? Com um prompt de duzentos tokens ou de quatro mil? Com um usuário sozinho no sistema ou com o pico de terça de manhã? E três segundos na média, no p95, no pior caso que o cliente reclamou ontem?
Nenhuma dessas perguntas é implicância. Cada uma muda a resposta por um fator que vai fácil de dez vezes. Quando você responde "uns três segundos", você não descreveu um comportamento, descreveu uma lembrança. E lembrança não é acordo de nível de serviço.
O artigo anterior terminou com um trecho de código que separava o tempo do primeiro token do intervalo entre os tokens seguintes. Aquilo já era o começo da solução, faltava a parte mais chata e mais útil: dar nome às coisas. É o que a gente faz aqui. Sem vocabulário você não escreve um SLO, e sem SLO você não tem garantia nenhuma, tem torcida organizada.
por que a média de latência mente na sua cara
Quem vem de sistema de baixa latência já traz o vício certo. Você não olha média, olha percentil, porque a média esconde exatamente o cliente que está gritando. Já escrevi sobre isso quando falei do custo oculto do context switch: o p99 é onde o sistema mostra quem ele é de verdade.
Em IA generativa a média mente duas vezes, e a segunda é sutil. Ela funde usuários diferentes, como qualquer média faz. E funde as duas fases da inferência, que como você viu no artigo passado têm perfis opostos. Uma latência total de três segundos pode ser meio segundo de prefill com dois e meio de geração, ou dois e meio de prefill com meio segundo de geração. São dois sistemas diferentes, com dois gargalos diferentes, com duas soluções diferentes. E os dois reportam três segundos.
O jeito de sair disso é decompor a linha do tempo de uma requisição e medir cada pedaço com um nome próprio.
o vocabulário mínimo
São quatro nomes. Depois deles você consegue escrever uma frase de SLA que sobrevive a uma auditoria.
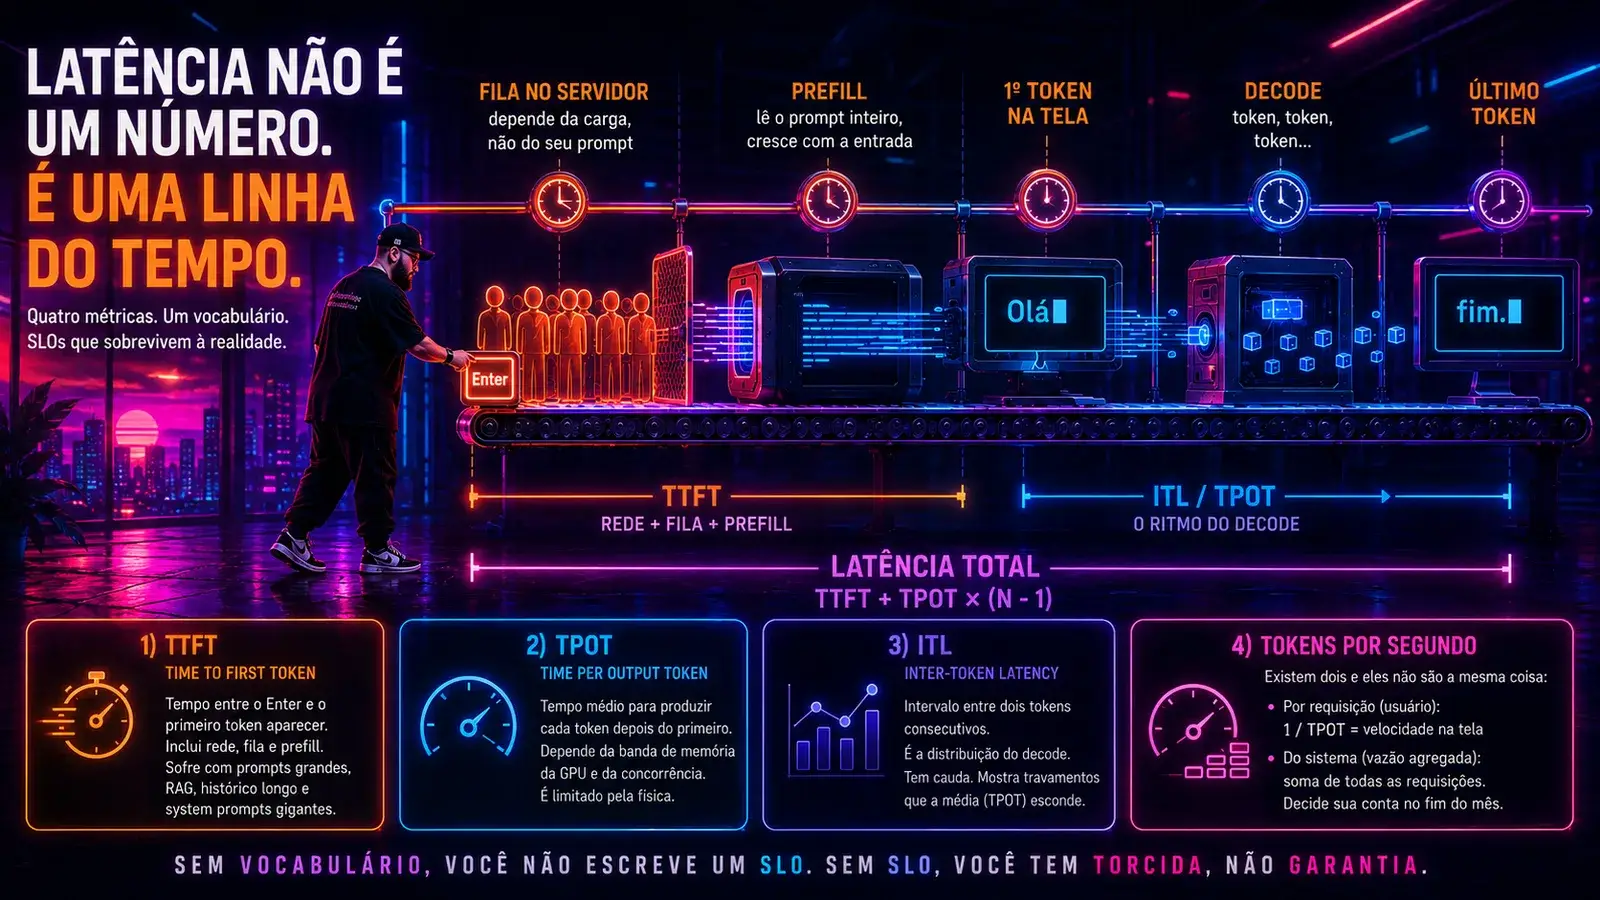
O primeiro é o TTFT, time to first token: o tempo entre o usuário apertar Enter e o primeiro token aparecer. Dentro dele mora tudo o que acontece antes da geração começar, ou seja, a viagem pela rede, o tempo na fila do servidor esperando um slot, e o prefill, que é a leitura do prompt inteiro. Como o prefill cresce com o tamanho da entrada, o TTFT é a métrica que sofre quando o seu produto enfia contexto no prompt. RAG com dez documentos, histórico longo de conversa, aquele system prompt de três mil tokens que ninguém revisa desde o ano passado: tudo isso vive aqui.
Depois vem o TPOT, time per output token, o tempo médio para produzir cada token depois do primeiro. É o ritmo do decode. Enquanto o TTFT depende do tamanho da entrada, o TPOT depende quase só da banda de memória da GPU e de quantas requisições dividem aquele carregamento de pesos. É o número que a física do primeiro artigo desta série limita por cima.
O terceiro é o ITL, inter-token latency, o intervalo entre dois tokens consecutivos, medido um a um. Muita gente usa ITL e TPOT como sinônimos, e numa conversa de corredor tudo bem. Para instrumentar não é a mesma coisa. TPOT é uma média sobre a resposta inteira; ITL é uma distribuição, e ela tem cauda. Uma resposta com TPOT de 40 milissegundos pode ter engasgado 900 milissegundos numa volta só, porque o servidor recebeu um lote novo de requisições e reagendou o seu batch. O usuário viu o texto travar. O TPOT não viu nada.
O quarto é tokens por segundo, o termo mais ambíguo do vocabulário e por isso o mais perigoso em reunião. Existem dois, e eles se movem em direções opostas. O tokens por segundo por requisição é a velocidade que o usuário sente, e é só o inverso do TPOT: quarenta milissegundos por token dão vinte e cinco tokens por segundo na tela. O tokens por segundo do sistema é a vazão agregada, a soma de todas as requisições sendo atendidas ao mesmo tempo, e é o número que decide a sua conta no fim do mês. Aumentar o batch melhora o segundo e piora o primeiro. Quem cita "tokens por segundo" sem dizer qual dos dois está comparando duas coisas que não são a mesma.
Com os quatro nomes na mão, a latência total de uma resposta vira uma conta, não um mistério:
latência total = TTFT + TPOT × (tokens de saída − 1)Repare no que essa fórmula te dá de graça. A latência do seu produto de IA não é uma propriedade do modelo, é uma função do tamanho da resposta. Uma feature que gera duzentos tokens e outra que gera dois mil, no mesmo modelo, na mesma GPU, com o mesmo TPOT, têm latências que diferem por um fator de dez. Prometer "três segundos" para as duas é prometer para uma e mentir para a outra.
o diagrama: onde cada métrica mora
O desenho abaixo é a linha do tempo de uma requisição, com o pedaço que cada métrica cobre. É o mapa do artigo em uma figura, e é o que vale colar na parede antes de escrever o próximo SLO.
Duas armadilhas moram nesse diagrama, e as duas já me custaram tempo.
A primeira é a fila. Ela entra no TTFT medido pelo cliente e some do TTFT medido pelo servidor. Quando o time de infra diz que o TTFT está em 300 milissegundos e o time de produto jura que está em dois segundos, quase sempre os dois estão certos: um mede a partir de quando a requisição foi agendada, o outro a partir de quando o usuário apertou Enter. Defina onde você mede antes de discutir o número, ou a reunião vira teatro.
A segunda é mais suja. Alguns servidores emitem um evento vazio ou um keepalive antes do primeiro token real, e o seu cliente registra aquilo como "primeiro token". O TTFT do dashboard fica lindo e o usuário continua encarando a tela parada. Se o número melhorou sozinho depois de uma atualização de biblioteca, desconfie e olhe o payload.
quanto é rápido o suficiente
Aqui está a parte que ninguém quer escrever, porque exige comprometimento: qual número colocar no SLO. A saída honesta não é copiar o benchmark de outra empresa, é derivar do que o usuário percebe.
Jakob Nielsen documentou em 1993 os três limites de tempo de resposta que valem até hoje, e ele mesmo já os tratava como conhecimento antigo, herdado de trabalhos dos anos 1960. Um décimo de segundo é o limite em que a reação parece instantânea. Um segundo é o limite para o pensamento do usuário não ser interrompido, embora ele já perceba a demora. Dez segundos é o limite da atenção; depois disso a pessoa vai fazer outra coisa. Esses três números não envelheceram porque quem envelhece é o hardware, não a percepção humana.
Do lado do decode, a régua é ainda mais direta: a velocidade de leitura. Um leitor adulto confortável faz algo entre 200 e 300 palavras por minuto, o que dá umas quatro ou cinco palavras por segundo. Como um token costuma ser um pedaço de palavra, você precisa de algo na casa de sete a dez tokens por segundo para que o texto apareça mais rápido do que a pessoa consegue ler. Passou disso, ninguém percebe a diferença, porque o gargalo virou o olho do usuário. É um teto de utilidade, e ele é uma notícia excelente: existe um ponto a partir do qual acelerar o decode é gastar dinheiro para impressionar um gráfico.
Junte as duas réguas e o cartão de SLA se escreve sozinho. Guarde este, que é o resumo do artigo:
CARTÃO DE SLA DE IA

TTFT   = Enter até o 1º token   (rede + fila + prefill)   sofre com prompt grande
TPOT   = tempo médio por token  (ritmo do decode)         sofre com banda e batch
ITL    = intervalo real entre tokens, com cauda           expõe o engasgo do batch
tok/s  = por requisição (o usuário sente)
       = do sistema     (a fatura sente)

latência total = TTFT + TPOT × (tokens de saída − 1)

faixas de referência, derivadas da percepção humana:
  chat interativo     TTFT abaixo de 1 s, ideal perto de 0,5 s | TPOT 50 a 100 ms
  autocomplete inline TTFT em centenas de ms, quanto menor melhor
  RAG e agentes       TTFT maior é tolerável se a espera for visível ao usuário
  batch e offline     TTFT irrelevante; medir tok/s do sistema e custo por milhão

todo SLO precisa de: métrica + percentil + carga + tamanho de saída
A última linha é a que separa o SLO do desejo. "TTFT p95 abaixo de 800 ms com prompt de até 2.000 tokens, a 50 requisições por segundo" é um acordo que dá para verificar, quebrar e cobrar. "Uns três segundos" é uma esperança com cara de compromisso.
vamos medir, que percentil não perdoa
O artigo anterior mostrou como separar prefill de decode no cliente. Agora a mesma medição, formalizada: os quatro nomes, o percentil, e a comparação com o alvo.
// ❌ a medição que não sustenta um SLO
var sw = Stopwatch.StartNew();
var resposta = await chat.CompleteAsync(prompt);
Log($"latência: {sw.ElapsedMilliseconds} ms");
// média de quê? sob qual prompt? sob qual carga? não dá pra prometer nada com isso
// ✅ TTFT, ITL com cauda, TPOT e tokens/seg da requisição
var sw = Stopwatch.StartNew();
TimeSpan? ttft = null;
var anterior = TimeSpan.Zero;
var intervalos = new List<double>();
var tokens = 0;
await foreach (var update in chat.CompleteStreamingAsync(prompt))
{
if (string.IsNullOrEmpty(update.Text)) continue; // ignora keepalive: TTFT honesto
var agora = sw.Elapsed;
if (ttft is null) ttft = agora;
else intervalos.Add((agora - anterior).TotalMilliseconds);
anterior = agora;
tokens++;
}
intervalos.Sort();
double p(int q) => intervalos[(int)Math.Ceiling(q / 100.0 * intervalos.Count) - 1];
Log($"TTFT {ttft!.Value.TotalMilliseconds:F0} ms · " +
$"ITL p50 {p(50):F0} ms · ITL p99 {p(99):F0} ms · " +
$"TPOT {intervalos.Average():F0} ms · " +
$"{1000 / intervalos.Average():F1} tokens/s na tela · {tokens} tokens");O detalhe que mais rende nesse trecho é a distância entre o ITL p50 e o ITL p99. Se o p50 está em 40 milissegundos e o p99 em 600, o seu TPOT médio parece saudável e o usuário está vendo o texto engasgar. Esse é o momento de olhar para o agendador do servidor de inferência, não para o modelo. Guarde a suspeita, porque o mecanismo por trás desses engasgos vai ter artigo próprio na sala de máquinas do serving.
o que isso muda para quem decide
Vocabulário não é preciosismo de engenheiro. Ele muda três decisões que custam dinheiro.
A primeira é o que otimizar. TTFT alto e TPOT bom significa que o seu problema é prefill ou fila: corte contexto, reaproveite prompt de sistema, aumente a capacidade de agendamento. TPOT alto e TTFT bom significa que o seu problema é banda de memória e batch: quantização e serving melhor, não uma GPU com mais poder de cálculo. São dois diagnósticos opostos que a métrica de latência total funde num número só, como já vimos na assimetria entre as duas fases.
A segunda é o contrato. Quando o TTFT vira uma linha do SLO, o produto para de tratar contexto como se fosse de graça. Cada documento a mais no prompt aparece no gráfico do dia seguinte. É a diferença entre uma decisão de produto com preço visível e uma que só aparece quando o cliente reclama.
A terceira é a mais estratégica: escolher a meta certa. Aumentar o batch melhora o tokens por segundo do sistema, derruba o custo por token e piora a latência de cada usuário. Existe até um nome para a métrica que resolve essa tensão, goodput, que conta só a vazão que atende o SLO, ignorando as requisições atendidas fora do prazo. É a métrica honesta para quem serve modelo: throughput sem SLO é vazão de trabalho que ninguém quis. Quando escrevi sobre levar IA de batch para tempo real, a discussão parou no orçamento de milissegundos da aplicação. Aqui a gente está um andar abaixo, olhando de onde esses milissegundos nascem e como cobrá-los de quem serve o modelo.
conclusão: nomear é o primeiro ato de engenharia
Um sistema de IA sem TTFT, TPOT, ITL e a distinção entre os dois tokens por segundo não tem SLA. Tem uma sensação coletiva de que "está rápido o suficiente", que dura exatamente até o primeiro cliente grande com prompt grande.
O ganho de nomear é bem concreto. Separar a fase que sofre de contexto da fase que sofre de memória aponta a alavanca certa antes de você gastar. A fórmula liga o tempo total ao tamanho da resposta, então latência vira conta e sai do território da impressão. E um SLO com percentil, carga e tamanho de saída ou é cumprido ou não é, sem espaço para interpretação criativa numa reunião de status.
A bolsa aprendeu isso décadas atrás, do jeito caro: você não gerencia o que não mede, e não mede direito o que não sabe nomear. A IA está repetindo a lição agora, com uma diferença incômoda. Lá, quem estourava o p99 perdia dinheiro na hora. Aqui, quem estoura o p99 costuma descobrir semanas depois, pelo churn.
Insights & Takeaways
- Latência de IA não é um número, é uma decomposição. TTFT cobre rede, fila e prefill; TPOT e ITL cobrem o ritmo do decode. Medir só o tempo total funde duas fases com gargalos opostos e apaga o diagnóstico.
- TPOT é média, ITL é distribuição. Um TPOT saudável convive com um ITL p99 dez vezes maior, e é esse p99 que o usuário enxerga como texto travando na tela.
- Tokens por segundo é ambíguo e caro: o da requisição é o que o usuário sente, o do sistema é o que a fatura sente, e aumentar o batch move os dois em direções opostas.
- A latência total é TTFT mais TPOT vezes os tokens de saída. Latência de produto de IA é função do tamanho da resposta, então prometer um número único para features que geram tamanhos diferentes é errar de propósito.
- O alvo se deriva da percepção, não do benchmark alheio: TTFT abaixo de um segundo para não quebrar o fluxo de pensamento, e algo em torno de sete a dez tokens por segundo já entrega texto mais rápido do que a pessoa lê. Acima disso, acelerar é gastar para impressionar gráfico.
Uma pergunta honesta pra fechar, no espírito de proteger o time antes do incidente: o SLA de IA que você prometeu para o negócio tem métrica, percentil, carga e tamanho de saída escritos em algum lugar? Se não tem os quatro, você não prometeu um nível de serviço. Prometeu que vai dar certo.
No próximo artigo a gente vai atrás do vilão que come a sua VRAM sem aparecer na ficha técnica de nenhum modelo: o KV cache, a memória de curto prazo que decide quantos usuários cabem na sua GPU.