IA de Alta Performance · Episódio 14
O Modelo Burro Que Acelera o Inteligente
Speculative decoding: um modelo pequeno rascunha, o grande confere, e a mesma resposta sai de 2 a 3 vezes mais rápido. Quando compensa e o que medir.
Neste artigo · 9 seções
- o desperdício que abre a porta
- como o palpite vira token de verdade
- por que a saída é comprovadamente a mesma
- de onde sai o número, e por que ele varia tanto
- onde entra o palpite
- a mesma aposta que o processador faz desde os anos 90
- o que a aposta cobra de volta
- as variantes que dispensam o segundo modelo
- Insights & Takeaways
Vou propor uma arquitetura que soa como piada de reunião: para o seu modelo de 70 bilhões de parâmetros responder mais rápido, coloque um modelo de 1 bilhão, reconhecidamente pior, para escrever a resposta antes dele.
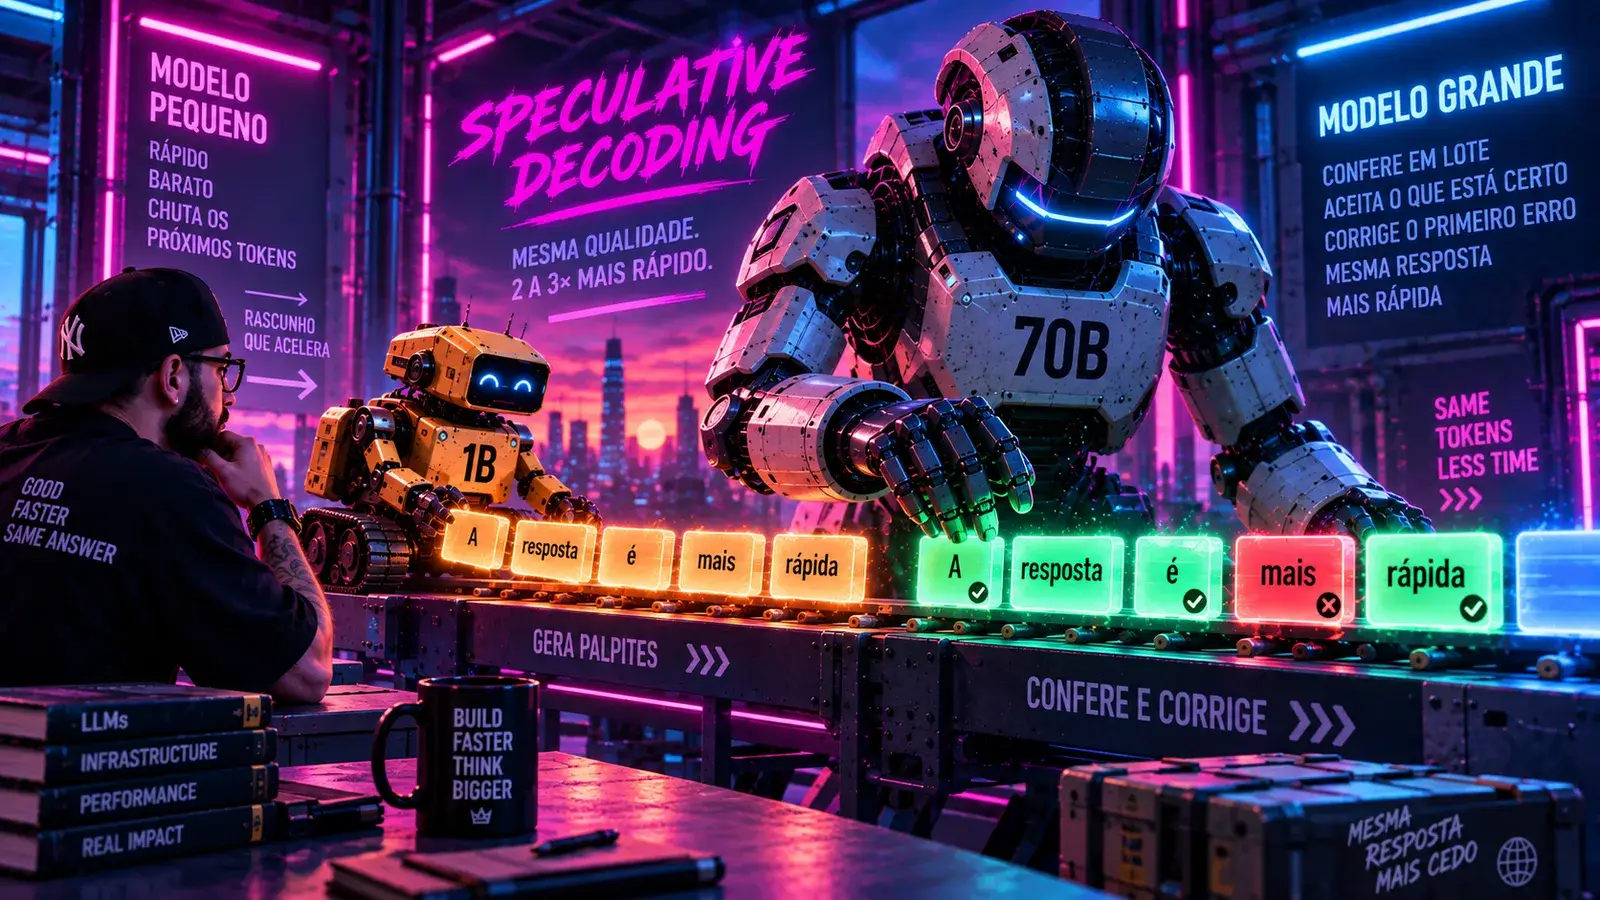
O modelo pequeno chuta os próximos cinco ou seis tokens. O grande olha o chute inteiro de uma vez, aceita o pedaço que estava certo, corrige o primeiro erro e devolve. A resposta que sai é, comprovadamente, a mesma que o modelo grande produziria sozinho, com a mesma distribuição de probabilidade. E ela sai de duas a três vezes mais rápido.
Não é aproximação com asterisco, nem heurística que degrada qualidade em troca de velocidade. É a mesma saída, mais cedo. A primeira vez que li isso achei que tinha entendido errado, e a explicação de por que funciona é o melhor exemplo de mechanical sympathy que apareceu nesta série até agora: a técnica só existe porque a inferência desperdiça um recurso específico, e alguém decidiu gastar exatamente esse recurso desperdiçado.
o desperdício que abre a porta
Vale reconstruir a física, porque tudo depende dela.
Para gerar um token, a GPU precisa ler todos os pesos do modelo saindo da memória e fazer uma quantidade ridícula de contas com cada byte lido. Um modelo de 70B em 16 bits são 140 GB atravessando o barramento para produzir uma palavra e meia. O terceiro artigo desta série tratou desse ponto: quem manda no decode é a banda de memória, e o poder de cálculo fica sobrando, com as unidades de multiplicação esperando dado chegar. O nono artigo colocou número nisso: a fração do poder computacional efetivamente usada no decode fica abaixo de 5%.
Dessa assimetria nasce uma propriedade que parece mágica e é só aritmética: processar um token ou processar oito tokens numa única passagem custa quase o mesmo tempo. O custo dominante é ler os pesos, e você lê os pesos uma vez nos dois casos. As contas extras entram na folga que já existia.
O continuous batching explorou essa propriedade na horizontal, colocando várias sequências diferentes no mesmo passo. O speculative decoding explora a mesma propriedade na vertical: vários tokens da mesma sequência no mesmo passo.
E aí bate o obstáculo óbvio. A geração é autorregressiva. O token 41 depende do 40, que depende do 39. Não dá para calcular dois tokens em paralelo, porque um é entrada do outro.
A menos que você já tenha um palpite do token 40. Porque com um palpite na mão, a operação deixa de ser geração e vira conferência. E conferir cinco posições de uma vez é exatamente o tipo de trabalho paralelo que sobra folga para fazer.
como o palpite vira token de verdade
O desenho tem duas peças. Um modelo de rascunho, pequeno e da mesma família do grande sempre que possível, e o modelo alvo, o que você realmente quer servir.
O rascunho gera alguns tokens do jeito antigo, um de cada vez, e isso é barato porque ele é dez ou vinte vezes menor. Digamos cinco tokens. Em seguida o modelo grande faz uma única passagem sobre o prompt mais esses cinco tokens, e nessa passagem ele calcula, para cada posição, qual distribuição de probabilidade ele mesmo teria produzido ali.
Agora vem a comparação, posição por posição. Enquanto o token que o rascunho escreveu for compatível com o que o modelo grande queria escrever, ele é aceito. No primeiro que não for, o token do rascunho é descartado, o modelo grande escreve o seu próprio no lugar, e todo o resto do rascunho vai fora, porque foi construído em cima de uma premissa que acabou de morrer.
Faça a conta do melhor caso: quatro tokens aceitos mais a correção significam cinco tokens avançados ao preço de uma passagem do modelo grande. E o pior caso é o que garante que a ideia nunca é ruim: se o primeiro token do rascunho for rejeitado, você avançou um token, que é exatamente o que teria avançado sem nada disso. Perdeu-se apenas o tempo do rascunho, que é a fração pequena da conta.
Nunca fica preso, nunca regride. Só varia o quanto ganha.
por que a saída é comprovadamente a mesma
Se a aceitação fosse "está parecido, deixa passar", isso seria mais uma técnica de aproximação e ninguém precisaria de um paper.
O truque está em como aceitar. O token do rascunho é aceito com probabilidade proporcional à razão entre o quanto o modelo grande queria aquele token e o quanto o rascunho queria. Quando a rejeição acontece, o token substituto não sai da distribuição original do modelo grande, e sim de uma distribuição residual, ajustada para compensar exatamente o viés que o rascunho introduziu.
Leviathan, Kalman e Matias provaram que o resultado dessa dança é uma amostra da distribuição do modelo grande. Não parecida. A mesma. O trabalho do DeepMind que popularizou a ideia no mesmo ano descreve o mecanismo como um esquema que "preserva a distribuição do modelo alvo dentro da numérica do hardware" (no original, "preserves the distribution of the target model within hardware numerics"), e mediu de 2 a 2,5 vezes de aceleração no Chinchilla de 70B.
Isso muda a natureza da conversa com o time de produto. Não existe negociação de qualidade aqui, não existe avaliação para rodar antes de ligar, não existe risco de o modelo ficar mais burro sob pressão. É a mesma saída, mais cedo.
de onde sai o número, e por que ele varia tanto
O ganho tem duas variáveis, e vale saber quais são antes de acreditar em qualquer promessa de fornecedor.
A primeira é a taxa de aceitação, quanto do rascunho costuma sobreviver. A segunda é o tamanho do rascunho, quantos tokens o modelo pequeno arrisca por rodada. A fórmula do paper diz que o número esperado de tokens por passagem do modelo grande é uma progressão geométrica truncada, e a intuição que ela carrega é direta: cada token adicional do rascunho só ajuda se todos os anteriores foram aceitos, então o retorno cai rápido.
Com aceitação de 80% e rascunhos de cinco tokens, cada passagem do modelo grande entrega perto de 3,7 tokens. Descontando o custo das passagens do modelo pequeno, sobra algo próximo de 3 vezes de aceleração. Com aceitação de 50%, os mesmos cinco tokens de rascunho entregam menos de 2 tokens por passagem, e o ganho líquido cai para a casa de 1,5.
A taxa de aceitação é a métrica que decide tudo, e ela não é uma constante do sistema: é uma propriedade do par de modelos e do texto que está sendo gerado. Código, respostas estruturadas e trechos que citam o contexto aceitam muito, porque são previsíveis. Texto criativo aceita pouco. Rascunho de outra família, com tokenizer diferente ou treinamento desalinhado, aceita mal mesmo sendo um modelo bom.
Se você ligar speculative decoding e não medir a taxa de aceitação em produção, com o seu tráfego, você não sabe se comprou 3 vezes ou 1,2.
onde entra o palpite
a mesma aposta que o processador faz desde os anos 90
Quem trabalha perto de hardware reconhece a família da ideia. O processador na sua frente prevê o resultado de um desvio, executa adiantado o caminho previsto e joga o trabalho fora quando erra. É a execução especulativa que aparece por baixo quando a gente discute reordenação de instruções e barreiras de memória. Mesma aposta, outra escala: gastar trabalho especulativo enquanto existe unidade parada, porque acertar adianta muito e errar custa pouco.
Na prática, o que muda no serviço é a forma do laço, não a biblioteca. O laço clássico pede um token por vez ao modelo caro. O laço especulativo pede um bloco ao modelo barato, manda o caro conferir o bloco inteiro numa passagem e anexa o prefixo que sobreviveu. A única instrumentação nova que a técnica exige é contar quantos tokens do rascunho passaram por rodada, e é essa contagem que diz se você comprou três vezes ou uma vez e pouco.
o que a aposta cobra de volta
Três custos, e o segundo é o que derruba a maioria das implementações.
O primeiro é memória. O modelo de rascunho ocupa VRAM, e VRAM ocupada por peso é VRAM que sai do KV cache. Depois do artigo anterior, essa conta ficou concreta: menos blocos livres significa menos sequências vivas, lote menor, throughput menor. Um rascunho de 1B ao lado de um 70B é troco; um rascunho de 7B já é uma decisão de capacidade.
O segundo é o regime de operação, e ele é o coração da coisa. O ganho vem de gastar folga de compute. Sob carga baixa e média, essa folga é enorme e o negócio é ótimo. Sob carga alta, com o lote cheio, o continuous batching já consumiu a folga colocando outras sequências ali dentro, e as passagens do rascunho passam a competir por um recurso que virou escasso. O ganho encolhe, e em saturação ele pode virar prejuízo.
Ou seja, speculative decoding é uma máquina de converter ociosidade em latência menor. O artigo do trilema mostrou que operar com folga é o preço de ter latência boa; essa técnica pega essa folga já paga e transforma em resposta mais rápida. Onde não existe folga, não existe o que converter.
O terceiro é operacional. São dois modelos para versionar, atualizar, avaliar e servir juntos, e o par precisa continuar alinhado quando um dos dois for trocado. Se a taxa de aceitação despencar numa atualização de rotina, o sistema fica silenciosamente mais lento, sem erro nenhum no log.
as variantes que dispensam o segundo modelo
Vale saber que a família cresceu, porque duas variantes eliminam o custo que mais incomoda.
A primeira usa o próprio contexto como rascunho. Em resumo de documento, edição de código ou resposta que cita o material recuperado pelo RAG, boa parte do texto que vai ser gerado já está no prompt. Um casador de padrões simples pega o trecho candidato e oferece como palpite, com custo de rascunho perto de zero. Em cargas de edição, onde a saída repete a entrada com pequenas mudanças, a taxa de aceitação é altíssima e o ganho é quase de graça.
A segunda coloca o rascunho dentro do próprio modelo, com cabeças adicionais treinadas para prever várias posições à frente numa passagem só. Sem segundo modelo para servir, sem par para manter alinhado, ao custo de mexer no modelo em vez de mexer só no servidor.
A escolha entre elas é a mesma escolha de sempre em engenharia: quanto de complexidade operacional você aceita carregar pelo ganho que sobra depois de descontar o seu regime real de carga.
Insights & Takeaways
- Speculative decoding acelera a inferência sem trocar qualidade: o modelo pequeno rascunha, o grande confere o bloco inteiro numa passagem, e o mecanismo de aceitação garante que a distribuição de saída é a do modelo grande. De 2 a 3 vezes menos latência, com a mesma resposta.
- Ela só existe por causa da assimetria do decode: como o custo dominante é ler os pesos, conferir cinco tokens custa quase o mesmo que gerar um. O palpite transforma geração sequencial em conferência paralela.
- A taxa de aceitação é a métrica que decide o ganho, e ela varia com o par de modelos e com o tipo de texto. Código e resposta estruturada aceitam muito; texto criativo aceita pouco. Sem medir aceitação em produção, você não sabe se comprou 3 vezes ou 1,2.
- O ganho vem de gastar folga de compute, então ele encolhe conforme o lote enche. É otimização de latência para regime de folga, não remédio para servidor saturado.
- O rascunho pode vir do próprio contexto (ótimo para resumo, edição e RAG, com custo quase zero) ou de cabeças extras dentro do modelo, que eliminam o segundo modelo em troca de mexer no modelo.
Uma pergunta honesta pra fechar: em que regime as suas GPUs operam no horário em que a latência importa de verdade? Se as suas GPUs operam com folga justamente no horário nobre, porque alguém dimensionou para o pico, existe aí uma ociosidade paga todo mês que pode virar resposta mais rápida sem custar um centavo a mais nem um ponto de qualidade.
No próximo artigo, a série sai de dentro da GPU e vai para o fio: o que acontece quando o modelo gera token mais rápido do que o cliente consegue ler. É o problema mais antigo de qualquer feed de dados em tempo real aparecendo com roupa nova, e ele decide quanto da sua capacidade fica presa esperando gente lenta.