JDI: como construir um workflow lean pra agentes de IA (sem cerimônia, sem alucinação, sem queimar token)
Como fazer Spec-Driven Development com agentes de IA sem teatro: contexto fresco, especialistas por projeto e Ralph Loop com kill switch, gastando menos token.
Neste artigo · 13 seções
- O harness é fino de propósito
- Research que não vira big-design-upfront
- Fresh context por agente: o que isso realmente custa
- Ralph Loop: o circuito que converge sozinho
- Agentes customizáveis: por que specialist vence agent genérico
- Por que teste de unidade virou o oxigênio do JDI
- Por que code design é o que separa workflow útil de workflow caro
- O fluxo, do começo ao deploy
- O que o JDI escolhe não fazer
- Conclusão
- Por trás do JDI, e um convite
- Pra rodar
- Insights & Takeaways
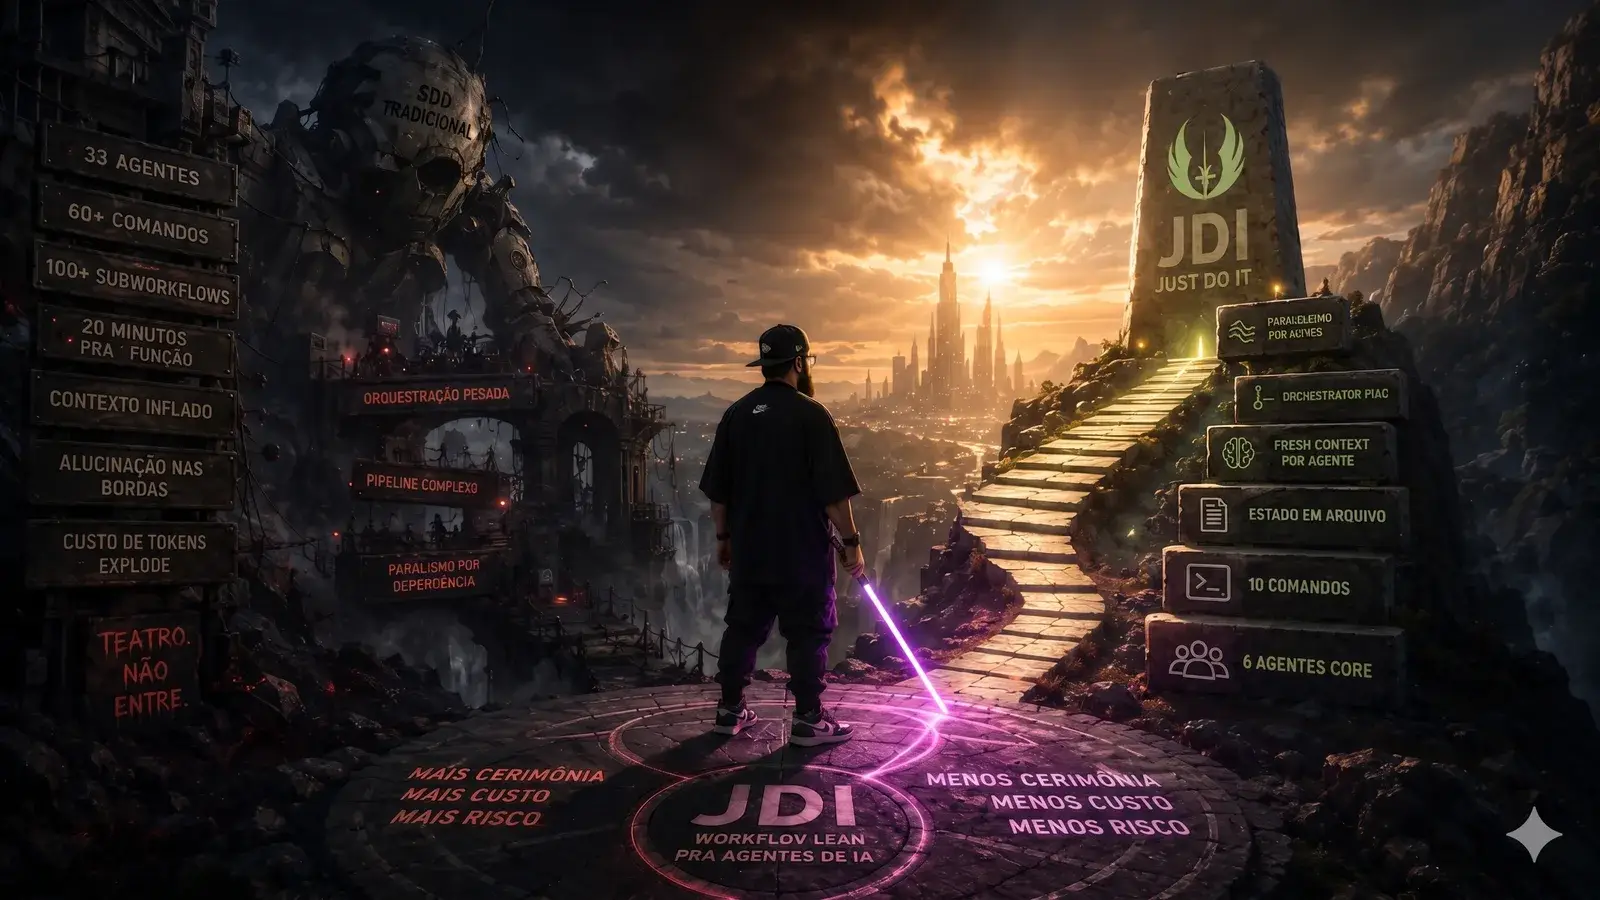
SDD virou hype. Cada framework novo de Spec-Driven Development pra agentes promete pipeline robusto, rastreabilidade do requisito até o teste, dezenas de agentes especializados, governança no nível de auditoria SOX. Aí você roda na prática. 33 agentes, 60+ comandos, 100+ subworkflows. Vinte minutos de orquestração pra escrever uma função. O custo de token explode. E o pior: como cada agente carrega contexto inflado, ele alucina nas bordas. Você acaba revisando código gerado por IA com mais paranoia do que código de júnior.
A pergunta que ficou foi simples. Dá pra fazer SDD sem o teatro?
JDI nasceu dessa pergunta. Lean por opção, não por preguiça. Funcional, rápido, barato em tokens. Os princípios são poucos e duros: fresh context por agente, orchestrator fino, estado em arquivo, especialistas gerados por projeto, paralelismo por waves. O resultado cabe em 6 agentes core, 10 comandos, zero dependência além do Node stdlib. Roda em 4 runtimes (Claude Code, Copilot, OpenCode, Antigravity) com o mesmo motor.
O nome carrega duas camadas, e elas importam pra entender a filosofia. A primeira é literal: JDI = Just Do It. Chega de cerimônia, faz a coisa. A segunda é puxada na orelha: soa exatamente como "JeDI", e a analogia com Star Wars não é acaso. Você é o cavaleiro; os agentes são o sabre de luz. Sabre é ferramenta poderosa, mas só corta certo se você guia. Largado sozinho, ele decepa o pé do dono. JDI é desenhado pra você manter o controle o tempo todo, não pra rodar autopilot achando que IA pensa por você.
Esse artigo destrincha como tudo foi construído. Harness, research inicial, Ralph Loop, agentes customizáveis, fluxo end-to-end. Os trade-offs interessantes não estão no que JDI faz; estão no que ele se recusa a fazer.
O harness é fino de propósito
A primeira decisão arquitetural foi a mais radical. Comando não pensa. Comando carrega contexto, valida pré-condições, despacha o agente certo, roteia o output. Acabou.
Isso parece trivial até você abrir o código da maioria dos frameworks SDD hoje. Eles enfiam lógica de negócio dentro do prompt do comando. Você lê CONTEXT.md, gera PLAN.md, valida acceptance criteria, escreve SUMMARY.md, tudo dentro do mesmo agente, que vai inflando até bater 180k tokens e começar a confundir nome de variável com nome de fase.
JDI inverte isso. Cada comando segue um padrão fixo: lê .jdi/STATE.md pra saber onde o projeto está, valida os gates (PLAN existe? doer registrado? veredito da fase anterior não está BLOCKED?), e despacha um Agent() com contexto mínimo. O agente roda em janela limpa, escreve o artefato no disco, retorna. Se o comando precisa de dois agentes (caso do /jdi-loop), são dois spawns separados, cada um com sua própria janela fresca.
O motivo é técnico, não estético. Context rot é real, e a pesquisa da Anthropic e da Chroma de 2025 mostrou que recall degrada bem antes da janela encher. Manter o orchestrator fino é a forma mais barata de evitar isso. Você paga o custo de spawnar agentes novos em troca de qualidade que não despenca com o tamanho da sessão.
Aí está outra escolha contraintuitiva: o JDI restringe leitura por distância. Phases anteriores à atual não têm o corpo lido; só o frontmatter com status e veredito. Phases anteriores a duas só existem como entrada de ls. Isso é regra dura no orchestrator, não sugestão. Cache hit fica alto, prefix estável, custo baixo.
Research que não vira big-design-upfront
A primeira ação num projeto novo é /jdi-new. Esse comando spawna um único agente, o jdi-researcher rodando em Opus, que faz quatro perguntas chave e gera dois arquivos: PROJECT.md (visão, stack, code-design escolhido) e ROADMAP.md (fases do MVP).
Quatro perguntas, não quarenta. Visão em uma frase. Stack (com sugestão baseada no tipo de projeto). Code design (DDD, Vertical Slice, Clean, Hexagonal, Onion, The Method). Escopo do MVP. É isso.
O ponto-chave aqui é que essas decisões são locked. PROJECT.md vira imutável depois que sai do researcher. Não é convenção, é regra de comando. Os comandos seguintes recusam rodar se você tentar alterar manualmente o code-design no meio do projeto. Quem já viu equipe trocar de Clean pra Hexagonal na fase 4 sabe o estrago.
Pra projetos existentes, o equivalente é /jdi-adopt. Ele escaneia os manifestos (package.json, pyproject.toml, go.mod, *.csproj, pom.xml), infere a stack e o code-design pela estrutura de pastas, lê o README pra capturar a visão, e confirma tudo com você antes de gravar. O detalhe importante: ele registra o hash do commit no momento da adoção (D-2 em DECISIONS.md), e o reviewer passa a exigir cobertura de teste só nos arquivos criados depois desse hash. Brownfield real não exige 80% de cobertura no legado do dia zero. Exigir isso quebra a adoção em 5 minutos.
O researcher também tem orçamento de pesquisa duro. Máximo dois lookups via context7 (ou WebSearch quando disponível). Isso é proposital. O agente não vai gastar 30 minutos rascunhando uma arquitetura de microsserviços pra um TODO app. Output é caro em tempo e em token; restringir entrada é o controle mais barato.
Fresh context por agente: o que isso realmente custa
Vale destrinchar a economia disso. Cada Agent() call em Claude Code custa o prompt inteiro do agente mais o contexto explícito que o orchestrator injeta. Spawnar dois agentes em vez de um agente grande parece desperdício, mas a conta muda quando você considera que:
Primeiro, agentes especialistas têm prompts mais curtos. O jdi-doer-{slug} já sabe que o projeto é .NET 8 com xUnit e cobertura mínima de 80%. Ele não precisa redescobrir isso a cada task. O jdi-reviewer-{slug} já sabe quais comandos de build/test/lint rodar; eles vivem no template do specialist, gerado quando você roda /jdi-bootstrap.
Segundo, contexto fresco evita o efeito sanfona da janela. Um agente único que roda planejamento, execução, e revisão na mesma sessão acumula histórico, decisões intermediárias, output de comando, mensagem de erro. O modelo passa a competir consigo mesmo por atenção. Sessões longas em SDD são onde a alucinação aparece, não no primeiro turno.
Terceiro, separação de geradores e juízes (padrão clássico generator-judge) só funciona se o juiz não viu o gerador trabalhar. Reviewer no JDI é read-only by design. Ele tem Read e Bash, mas não tem Write nem Edit. Não pode corrigir. Só roda gates. Se algo falha, o veredito é BLOCKED, e o doer (em janela nova) é quem corrige na próxima iteração.
Ralph Loop: o circuito que converge sozinho
Aí entra a peça mais interessante: /jdi-loop. O nome vem do padrão Ralph (descrito por Geoffrey Huntley e formalizado depois no ASDLC), e a ideia é simples. Você não precisa rodar /jdi-do e /jdi-verify manualmente vinte vezes. Deixa o loop fazer.
Cada iteração é doer + reviewer. Cada um em janela limpa. O loop sai sozinho quando o veredito é APPROVED ou APPROVED_WITH_WARNINGS. Até aí, ok, qualquer um faz.
A coisa fica boa nos detalhes. Cap default é 5 iterações por rodada, com máximo de 3 resets, totalizando 15 iterações como kill switch absoluto. Não dá pra rodar pra sempre nem por acidente nem de propósito. Custo cresce, mas é bounded.
Mais importante: o JDI faz oscillation detection. Toda iteração, o reviewer escreve os findings em REVIEW.md. O loop pega a seção de Blockers e Warnings, normaliza (remove timestamps, lowercase, dedupe), e gera um hash sha256 curto. Se duas iterações consecutivas têm o mesmo hash, o loop sabe que o doer está corrigindo a mesma coisa e gerando o mesmo erro de novo. Aí ele para e te pergunta o que fazer. Continuar, abortar, ou pausar pra ajustar o PLAN.
Esse é o tipo de detalhe que separa loop útil de loop caro. Sem oscillation detection, agentes ficam em deadlock semântico: corrige A, quebra B, corrige B, quebra A. Você gasta 15 iterações e $40 de token até notar.
Cada iteração também produz commits atômicos. Doer commita seu trabalho, reviewer commita o REVIEW.md. Git vira o audit trail. Se o loop converge no iter 7, você tem 14 commits granulares mostrando exatamente o que mudou em cada passo. Bisect e blame ficam triviais.
O estado do loop vive em LOOP.md dentro da pasta da fase, com frontmatter (iter, total_resets, status) e histórico append-only. Crash de sessão no meio? Rodar /jdi-loop de novo retoma de onde parou, baseado no status: running que ficou gravado. Não tem estado em memória; tudo é file-based.
Agentes customizáveis: por que specialist vence agent genérico
Frameworks SDD grandes têm uma pilha de agentes genéricos: code-writer, code-reviewer, test-generator, doc-writer, security-auditor, integration-checker, performance-analyzer. Cada um precisa, em todo spawn, descobrir do zero qual stack o projeto usa, qual framework de teste, qual linter, qual code-design.
JDI fez o oposto. O /jdi-bootstrap gera, no mínimo, um par jdi-doer-{slug} + jdi-reviewer-{slug} por projeto. Eles nascem sabendo. Stack injetada como placeholder substituído. Comandos de build, test, lint, coverage gravados no prompt. Code-design carregado como skill obrigatória (se você escolheu DDD, o skill ddd é parte do prompt do doer e do reviewer; ele não pode ignorar).
Mas é aí que entra a escala interessante: o bootstrap não está limitado a um par. Em monorepo com várias frentes, ele aceita quantos pares forem necessários, cada um com seu stack_label e file_glob. Você pode ter, por exemplo, quatro pares cobrindo todas as frentes do projeto:
- Backend (
**/*.{cs,csproj,sln}): doer que conhece a stack .NET, padrão de injeção de dependência, framework de teste; reviewer que rodadotnet build,dotnet test, checa cobertura via Coverlet, valida que regra de negócio não vaza pro controller. - Frontend (
**/*.{ts,tsx,jsx,css,scss}): doer que conhece o framework de UI escolhido, convenções de componente, hooks; reviewer que roda Vitest/Jest, Playwright + axe-core no gate 7, valida WCAG 2.2 AA, checa que token não vai pro localStorage. - Infra (
**/*.{tf,tfvars,yaml,yml}): doer que conhece Terraform, módulos, naming convention de recurso; reviewer que rodaterraform validate,tflint,checkovoutfsecpra security misconfig, valida que recurso crítico está com tag e backup. - Cyber security (
**/*.{secrets,policies,sec.yml}ou outro glob específico): doer focado em policy, controle de acesso, hardening de configuração; reviewer que roda scanner de SAST, valida que nenhum secret está em texto puro, checa que CSP/CORS/headers estão de acordo com o baseline da equipe.
Cada par tem papel fundamental e escopo bem delimitado pelo glob. Backend não tenta revisar Terraform; frontend não opina sobre policy de IAM; security não palpita sobre componente React. Cada um cuida do que entende.
O planner mapeia tasks pra specialists pelo glob automaticamente, e o /jdi-do spawna o specialist certo por task. Tasks que cruzam dois globs são quebradas em subtasks (uma task que mexe em .cs e .tsx vira duas: uma pro doer backend, outra pro doer frontend). Tasks com globs disjuntos dentro da mesma wave rodam em paralelo, e specialists diferentes podem trabalhar simultaneamente sem pisar um no outro.
Reviewer multi-stack roda em cadeia (sequencial, porque port de build e lock de arquivo se atropelam quando você tenta rodar dotnet build e npm run build em paralelo na mesma máquina), e o veredito final é o pior caso. Um BLOCK em qualquer reviewer trava o ship. Se backend passa mas security flagou um header CSP frouxo, ship trava. Se infra valida limpo mas frontend tem violação de acessibilidade crítica, ship trava. É AND lógico entre os pares, não OR.
Esse modelo é o que torna o JDI viável em monorepo real. Sem ele, você cairia em duas armadilhas. Ou um doer único genérico que tenta entender 4 stacks e alucina em todas, ou um doer manual por frente que você roda alternando contexto na mão. JDI evita as duas pelo bootstrap declarativo: você fala uma vez quais frentes existem, ele gera os specialists, e o resto do fluxo (/jdi-plan, /jdi-do, /jdi-verify, /jdi-loop) roteia sozinho.
Outro detalhe: skills. O JDI carrega cinco princípios de programação universal (dry, kiss, yagni, solid, clean-code) automaticamente no doer e no reviewer. Não é texto fluff. São checklist objetivos que o reviewer usa como gate. Se o projeto tem frontend (detectado pelo bootstrap via package.json), entra também o skill frontend-rules (WCAG 2.2 AA, Nielsen, Material/Apple HIG) e o gate 7 do reviewer, que roda Playwright + axe-core num browser real, captura screenshots, valida contraste, navegação por teclado, estado de loading/empty/error/success.
Esse gate frontend é onde o JDI passa de framework genérico pra ferramenta com unhas. Ele detecta o package manager pelo lockfile, sobe o dev server, espera ficar pronto (60s timeout), roda axe-core em cada rota crítica em mobile (375x667) e desktop (1280x720), captura console errors e network failures, mata o servidor sempre (mesmo em erro). Output em JSON em .jdi/cache/ui-findings.json, que é gitignored por padrão.
A severidade dos findings é clara. Console error em qualquer rota = BLOCK. 5xx em rota crítica = BLOCK. A11y violation critical ou serious = BLOCK. Scroll horizontal em mobile = BLOCK. Nada de bloquear em falha técnica (dev server timeout, Playwright não instalado): isso vira INCONCLUSIVE ou SKIPPED. Você nunca trava no ship por causa de infra; só por achado real.
Por que teste de unidade virou o oxigênio do JDI
Gate 2 do reviewer é Tests. Gate 3 é Coverage, default 80%, ajustável em PROJECT.md. Pode parecer overkill pra projeto solo. Não é, e o motivo mudou na era da IA.
Antes, teste de unidade era seguro contra regressão. Cobertura baixa significava bug volta. Razão técnica suficiente, mas só isso. Agora teste virou outra coisa: é o oracle que diz se o código gerado por agente faz o que deveria fazer. O doer escreve, compila, passa no lint. Falta saber se a função está correta. Sem teste, ninguém sabe. Você lê o diff achando que sabe, dá ok no PR, e três semanas depois o cliente reporta que o cálculo de imposto tá errado em 0.5% dos casos de borda.
JDI obriga o doer a rodar o test command depois de cada task. Falhou? Tenta corrigir uma vez. Falhou de novo? Marca blocked e segue. Sem teste, não tem como aplicar essa regra. O loop ficaria preso na ilusão de "compilou, passou lint, deve estar bom". É o tipo de falha silenciosa que faz workflow de IA queimar credibilidade em três semanas.
A lição é direta: cobertura pra código gerado por IA tem que ser maior, não menor, do que cobertura de código escrito à mão. Você está terceirizando o pensamento; o teste é o controle pra checar se a IA pensou direito. Cortar teste pra ganhar velocidade é a forma mais eficiente de transformar agente útil em gerador de bug com confiança alta.
Por que code design é o que separa workflow útil de workflow caro
Lembra que o /jdi-new pergunta o code design no minuto zero e trava a escolha pro resto da vida do projeto? Não é cerimônia.
Code design não é estética. É gestão de risco de mudança. Se alterar uma regra simples vira cirurgia, o design falhou. Isso já era verdade há décadas; na era da IA virou regra dura.
Três coisas mudam quando agente escreve código. Primeiro, o agente precisa saber onde colocar o que está criando. Sem code-design definido, o doer joga regra de negócio no controller na task 1, no service na task 2, no DTO na task 3. Caos previsível. Segundo, IA é boa em código novo, péssima em código velho embolado. Se o design isola mudança em poucos arquivos previsíveis (Clean coloca regra no domínio, The Method coloca em Manager/Engine), o agente mexe com risco baixo. Se a regra está num God Service de 2000 linhas, o agente propõe mudanças que quebram em cascata. Terceiro, code-design dá vocabulário compartilhado entre doer e reviewer. "Está em Resource Access mas é regra de negócio" vira gate de revisão objetivo. Sem padrão declarado, o reviewer não tem critério; vira opinião contra opinião.
Por isso o JDI carrega o skill correspondente (ddd, vertical-slice, clean-architecture, hexagonal, onion, the-method) automaticamente no doer e no reviewer. Não é decoração; é a régua que orienta onde o código vai parar e o gate que valida se parou no lugar certo. Sem esse skill ativo, os dois agentes voam cego.
Aí está o ponto que muita gente perde: na era da IA, princípios clássicos de engenharia (SOLID, DRY, KISS, YAGNI, code design escolhido conscientemente) ficaram mais importantes, não menos. Agente não tem julgamento autônomo; ele segue o padrão exposto no contexto. Se o padrão é "vale tudo", o resultado é vale-tudo. Se o padrão é "regra de negócio sempre em Manager, infraestrutura sempre em Resource Access", o resultado vira previsível. Previsível é o que separa workflow que escala de workflow que vira manutenção full-time.
Pra aprofundar especificamente o porquê de code design ser gestão de risco de mudança (e não estética), abordei o tema em outro artigo, antes do JDI existir: Code design não é sobre código bonito. Lá tem o destrinchado de MVC, Clean Architecture, The Method, e como cada padrão muda a previsibilidade de onde aplicar mudança. Vale como leitura complementar a esse texto; o JDI é a aplicação prática daqueles princípios dentro de um workflow de agentes.
O fluxo, do começo ao deploy
Junta tudo e o ciclo é esse:
/jdi-discuss é o asker. Ele lê PROJECT.md, ROADMAP.md, DECISIONS.md, e até dois CONTEXT.md de fases anteriores. Identifica três a cinco gray areas específicas da fase atual (não categorias genéricas; coisa real do tipo "vamos usar JWT ou cookies pra esse endpoint?"). Pergunta uma por vez. Max 5 perguntas, max 5 decisões locked novas por sessão. Cada resposta vira D-XX em DECISIONS.md (formato D-YYYY-MM-DD-slug-seq na v2 do schema, que evita colisão quando dois devs rodam JDI em branches paralelas no mesmo projeto).
/jdi-plan é o decompositor. Ele lê todo o contexto carregado até ali e produz PLAN.md com tasks. Cada task tem campos obrigatórios: files_modified, acceptance (mensurável), dependencies, test, e (em multi-stack) specialist. Máximo 8 tasks por fase. Passou disso, o planner refuses e pede pra você quebrar a fase em duas. Wave grouping é automático: tasks que não dependem da wave anterior podem rodar em paralelo se os files_modified não colidem. Overlap detectado vira sequencial automático.
/jdi-do é onde o doer executa. Por task: lê acceptance, implementa, roda o test command, commita atomicamente com feat({phase-slug}): {task summary}, append em SUMMARY.md, próxima task. Sem --no-verify, sem skip de teste, sem amend. Falhou três vezes seguidas? Marca como blocked e segue. Pior do que falhar é fingir que passou.
/jdi-verify é o reviewer rodando os seis gates: Build, Tests, Coverage, Lint/Format, Security/Perf (sem secrets, sem localStorage pra token, sem TODO sem issue link), Plan consistency (commits batem com files_modified). Veredito em três níveis: APPROVED, APPROVED_WITH_WARNINGS, BLOCKED.
/jdi-ship atualiza ROADMAP, avança a fase, opcionalmente cria tag. Único gate que ele checa: veredito não pode ser BLOCKED.
E entre quaisquer dois comandos, /jdi-status te dá um snapshot read-only de onde o projeto está. Schema, fase atual, status, veredito, último artefato, último commit, próximo passo. Útil pra quando você volta no projeto depois de duas semanas e esqueceu onde parou.
O que o JDI escolhe não fazer
A elegância do JDI tá na lista de coisas que ele se recusa a implementar.
Não tem stakeholder approval workflow. Você não é uma fortune 500. Você é um dev solo ou time pequeno tocando o projeto.
Não tem rastreabilidade requisito-até-teste estilo MIL-STD-498. CONTEXT.md guarda decisões locked, PLAN.md tem acceptance criteria, commit message referencia o slug da fase. É auditável o suficiente pra revisão de PR e bisect; não é auditável o suficiente pra agência reguladora. Quem precisa do segundo nível usa ferramenta dedicada de governança. JDI é workflow de dev, não governança.
Não tem DB. Tudo é Markdown com frontmatter YAML. .jdi/ versionado no git. Decisão locked vira append em DECISIONS.md (immutable, append-only). Schema migration via /jdi-migrate-phases, que adiciona schema_version: 2 mas nunca renomeia pastas existentes (preserva histórico de git).
Não tem hot-reload de agente, marketplace, plugin store. Você quer estender? Roda /jdi-create dentro do source do JDI, que spawna o jdi-architect em modo create, que gera um novo agent ou skill em core/ com integração automática. Pra customizar um specialist depois do bootstrap, você edita o .jdi/agents/jdi-doer-{slug}.md direto. É só Markdown.
Não tem retry exponencial mágico. O doer tenta corrigir uma falha de teste uma vez. Falhou de novo, marca blocked e segue. Você decide depois se vale a pena.
Esse é o ponto que vale fixar: simplicidade aqui não é só estética, é controle de custo. Cada agente novo, cada comando novo, cada workflow novo é token recorrente. Frameworks com 60+ comandos são frameworks com 60+ chances de blow-up em produção do seu workflow. JDI cabe na cabeça em uma tarde, e a curva de degradação por sessão longa é rasa porque o orchestrator não acumula contexto.
Conclusão
A tese do JDI é que SDD pra dev solo e time pequeno não precisa do peso de SDD pra org regulada. Você pode ter spec-driven o suficiente (CONTEXT.md locked, PLAN.md com acceptance, commits atômicos por task, gate de verificação automatizado) sem importar a ceremônia de stakeholder sign-off e rastreabilidade tripla.
A combinação que faz funcionar é a junção de quatro coisas: orchestrator fino que não acumula contexto, agentes em janela fresca por spawn, especialistas gerados que já sabem a stack, e Ralph Loop com kill switch absoluto e oscillation detection. Tira qualquer uma dessas pernas e o resultado vira ou caro demais (sem fresh context), ou alucinatório (sem specialists), ou infinito (sem kill switch), ou parado em deadlock semântico (sem oscillation detection).
Pra quem tá pensando em adotar um framework de agentes pro próprio fluxo, vale a pergunta inversa: quantos agentes você consegue justificar nominalmente, agente por agente, contra um specialist único bem gerado? Se a resposta tá abaixo de 10, JDI cabe. Se tá acima, talvez você precise mesmo do framework grande, mas vai pagar caro pelo privilégio.
Por trás do JDI, e um convite
JDI é a tentativa concreta de transformar a forma como acredito que código deve ser feito, com flexibilidade real pra cada caso. Os specialists customizados (doer e reviewer gerados por projeto, expansíveis em N frentes pra monorepo) são exatamente essa ideia tomando forma. Você descreve o seu mundo uma vez; o workflow respeita o seu mundo dali em diante.
A divisão de trabalho que eu queria sempre foi essa: a IA automatiza a parte mecânica, que é escrever código, rodar teste, validar gate. E devolve pra mim o que ela não faz bem mesmo, pensar arquitetura, pensar engenharia, pensar segurança, decidir trade-off de design. Doer escreve, reviewer checa o básico, eu fico com o que importa. Não é IA fazendo no meu lugar. É IA tirando da minha frente o que eu não precisava estar fazendo.
Nos testes que venho rodando em ambiente produtivo, o JDI tem sido uma ajuda incrível. Ciclo curto, contexto limpo, gates objetivos, commits atômicos rastreáveis. Phase que antes levava uma tarde inteira de digitação e validação manual fecha em um par de horas, com cobertura de teste maior do que eu teria feito sozinho na pressa. Mas isso é amostra de um. Pra valer a pena enquanto ferramenta, precisa rodar em fluxos diferentes do meu, em stacks diferentes, em times de outros tamanhos.
Aí entra o convite. Se você é tech lead, arquiteto, engenheiro sênior, PM técnico tocando projeto pessoal ou time pequeno, instala o JDI e roda numa phase real. Não num hello world. Numa phase de verdade do seu próximo projeto ou de um brownfield que você já mantém via /jdi-adopt. Depois me manda feedback: o que funcionou, o que travou, o que faltou, o que sobrou, qual gate fez sentido, qual atrapalhou. Quanto mais gente testando em stack diferente, mais rápido o JDI deixa de ser experimento pessoal e vira ferramenta sólida que aguenta peso real.
Pra rodar
cd /caminho/do/seu/projeto
npx jdi-cli@latest install claude     # ou copilot, opencode, antigravity, all
Pacote, flags, doctor e instruções completas em jdi-cli no npm. Node 18+ e git instalados é o que precisa. Em 30 segundos você tem o JDI plugado no runtime e pronto pro /jdi-new.
Sabre na mão. Que a Força esteja com você.
Insights & Takeaways
- Orchestrator fino vence orchestrator inteligente. Comando deve carregar contexto, despachar agente, rotear output. Lógica de negócio no comando é antipattern. Cada spawn de agente é uma chance de janela limpa; aproveita.
- Fresh context por agente é o controle mais barato contra context rot. Spawnar dois agentes pequenos custa menos em qualidade do que um agente grande que acumula histórico ao longo da sessão. Generator-judge separation só funciona se o judge não viu o generator trabalhar.
- Specialist per-project bate agent genérico em SDD prático. Doer e reviewer gerados com stack, framework de teste e code-design já injetados eliminam descoberta redundante a cada spawn. Cinco minutos de bootstrap economizam horas de janela inflada.
- Ralph Loop sem oscillation detection é só um while loop caro. Hash de findings entre iterações é a diferença entre converger em 7 iterações ou queimar 15 corrigindo a mesma coisa em ciclo. Kill switch absoluto (max_iter × max_resets) é não-negociável.
- Princípios clássicos de engenharia ficaram mais importantes na era da IA, não menos. Agente sem teste é gerador de bug com confiança alta. Agente sem code design declarado distribui regra de negócio em três pastas diferentes na mesma fase. SOLID, DRY, code design escolhido conscientemente e cobertura de teste alta são pré-requisito, não luxo, quando você terceiriza o pensamento pro agente.