Cache Lines e False Sharing: Otimizações de Performance em Nível de Hardware com .NET
Como cache lines de 64 bytes e o protocolo MESI causam false sharing em código multithread .NET, como detectar e como corrigir com padding e dados por thread.
Neste artigo · 11 seções
Introdução
No universo da programação de alta performance, existe um inimigo silencioso que pode reduzir drasticamente a eficiência de aplicações multithread: o false sharing. Este fenômeno, que ocorre no nível mais fundamental da hierarquia de memória do processador, representa um dos gargalos mais sutis e devastadores em sistemas modernos. Diferentemente de problemas óbvios como deadlocks ou race conditions, o false sharing opera de forma invisível, degradando performance sem gerar erros ou sintomas aparentes no código.
Para desenvolvedores .NET que buscam extrair máxima performance de hardware multicore moderno, compreender cache lines e false sharing tornou-se fundamental. Este conhecimento permite não apenas identificar e corrigir problemas existentes, mas também projetar arquiteturas que naturalmente evitam esses gargalos desde o início. A diferença entre código que sofre de false sharing e código otimizado pode facilmente representar melhorias de performance de 3 a 10 vezes, transformando aplicações que mal conseguem aproveitar múltiplos cores em sistemas verdadeiramente escaláveis.
Fundamentos de Cache Lines
A Hierarquia de Memória Moderna
Para compreender false sharing, primeiro devemos entender como processadores modernos organizam a memória. Entre os registradores ultra-rápidos da CPU e a memória principal relativamente lenta, existe uma hierarquia cuidadosamente projetada de caches que tentam manter dados frequentemente acessados próximos ao processador.
Esta hierarquia tipicamente consiste em três níveis principais. O cache L1, dividido entre dados e instruções, oferece latência de 1-2 nanosegundos mas capacidade limitada de 32-64KB por core. O cache L2, com 256KB-1MB por core, fornece latência de 3-5 nanosegundos. O cache L3, compartilhado entre todos os cores do processador, pode ter dezenas de megabytes mas latência de 10-20 nanosegundos. Além destes, a memória principal (RAM) oferece gigabytes de capacidade mas latência de 50-100 nanosegundos.
A unidade fundamental de transferência entre estes níveis não é o byte individual, mas sim a cache line - tipicamente 64 bytes em processadores x86/x64 modernos. Quando o processador precisa de um único byte, toda a cache line contendo esse byte é carregada. Esta decisão de design aproveitava-se da localidade espacial: dados próximos na memória tendem a ser acessados juntos.
Cache Lines em Ação
// Demonstração prática de cache lines
public static class CacheLineInfo
{
    public const int CACHE_LINE_SIZE = 64; // bytes

    public static void PrintMemoryLayout<T>(ref T instance) where T : struct
    {
        unsafe
        {
            fixed (T* ptr = &instance)
            {
                IntPtr address = new IntPtr(ptr);
                long addressValue = address.ToInt64();

                Console.WriteLine($"Endereço: 0x{addressValue:X16}");
                Console.WriteLine($"Cache line: {addressValue / CACHE_LINE_SIZE}");
                Console.WriteLine($"Offset na cache line: {addressValue % CACHE_LINE_SIZE} bytes");
            }
        }
    }
}
Este código utilitário permite visualizar como dados são organizados em cache lines, revelando quando múltiplas variáveis compartilham a mesma linha de cache - a precondição necessária para false sharing.
O Protocolo MESI: Mantendo Coerência de Cache
Estados de Cache Line
Para que múltiplos cores possam ter caches privados sem perder consistência de dados, processadores implementam protocolos de coerência de cache. O mais comum é o protocolo MESI, que define quatro estados possíveis para cada cache line:
Modified (M): A cache line foi modificada apenas neste cache e difere da memória principal. Este core tem a única cópia válida e deve eventualmente escrever de volta para memória.
Exclusive (E): A cache line existe apenas neste cache mas corresponde à memória principal. Pode ser lida sem comunicação com outros cores e pode transicionar diretamente para Modified.
Shared (S): A cache line pode existir em múltiplos caches e corresponde à memória principal. Qualquer modificação requer primeiro invalidar todas as outras cópias.
Invalid (I): A cache line não contém dados válidos.
Transições e Overhead
O protocolo MESI funciona através de mensagens enviadas via barramento de sistema sempre que um core precisa modificar uma cache line. Se o Core A quer escrever em uma cache line que está em estado Shared nos Cores B e C, ele deve primeiro enviar mensagens de invalidação. Apenas após receber confirmação que todas as outras cópias foram invalidadas, pode proceder com a modificação.
Este mecanismo, embora garantindo correção, introduz latência significativa. Em sistemas NUMA (Non-Uniform Memory Access), onde cores podem estar em sockets diferentes conectados por interconexões mais lentas, o overhead pode ser ainda maior.
False Sharing: O Problema Invisível
Definição e Mecanismo
False sharing ocorre quando threads diferentes modificam dados logicamente independentes que residem na mesma cache line. Embora as threads não compartilhem dados de forma lógica, elas compartilham inadvertidamente a mesma unidade física de cache, causando invalidações desnecessárias.
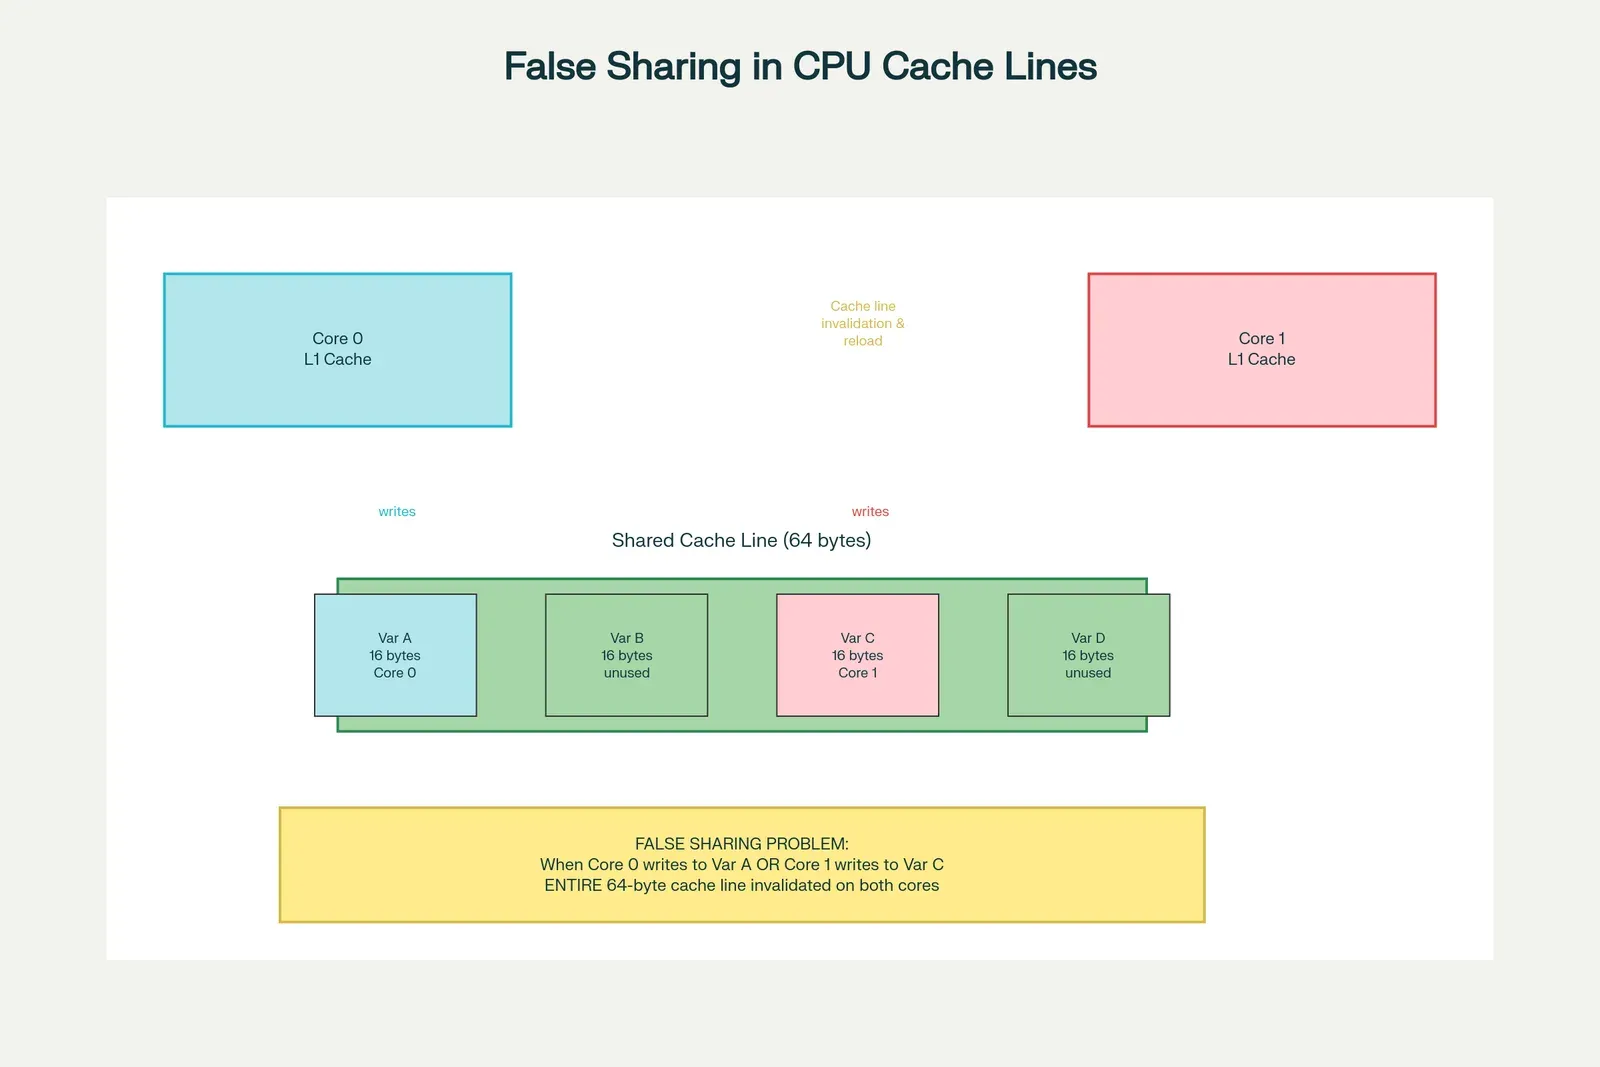
False Sharing: Como diferentes cores invalidam cache lines compartilhadas
Considere este exemplo problemático:
// Estrutura problemática - false sharing garantido
[StructLayout(LayoutKind.Sequential)]
public class ProblematicCounters
{
    public long Counter1;    // Thread 1 modifica (8 bytes)
    public long Counter2;    // Thread 2 modifica (8 bytes)
    public long Counter3;    // Thread 3 modifica (8 bytes)
    public long Counter4;    // Thread 4 modifica (8 bytes)

    // Total: 32 bytes < 64 bytes (cache line)
    // Todas as threads competem pela mesma cache line!
}
Quando a Thread 1 incrementa Counter1, toda a cache line contendo os quatro contadores é marcada como Modified no cache do Core 1. Se simultaneamente a Thread 2 (executando no Core 2) tentar incrementar Counter2, ela descobrirá que sua cópia da cache line está Invalid, forçando uma transferência custosa da linha modificada do Core 1 para o Core 2.
Impacto na Performance
O impacto de false sharing pode ser dramaticamente severo. Benchmarks controlados demonstram degradação de 3-10x na performance quando false sharing está presente:
// Resultados típicos de benchmark:
// COM FALSE SHARING:      3,500ms  (11.4 milhões ops/sec)
// SEM FALSE SHARING:        850ms  (47.1 milhões ops/sec)
// Melhoria: 4.1x mais rápido!
Esta degradação não é linear com o número de threads. Sistemas com mais cores sofrem proporcionalmente mais, pois há mais competição pela mesma cache line. Em processadores com 32+ cores, false sharing pode efetivamente serializar operações que deveriam ser paralelas.
Condições Necessárias
False sharing requer três condições simultâneas:
- Dados compartilhados: Múltiplas threads acessando dados na mesma cache line
- Pelo menos uma escrita: Se todas as operações fossem leituras, não haveria invalidações
- Acesso frequente: O overhead só se torna significativo com alta frequência de acesso
Notavelmente, dados read-only nunca causam false sharing, pois múltiplos cores podem manter cópias Shared sem invalidações.
Técnicas de Detecção de False Sharing
Ferramentas de Hardware
Processadores Intel modernos fornecem contadores de performance específicos para detectar false sharing:
- MEM_LOAD_UOPS_L3_HIT_RETIRED_XSNP_HITM: Cache hits em outro core no mesmo socket
- MEM_LOAD_UOPS_L3_MISS_RETIRED_REMOTE_HITM: Cache hits em core de socket remoto
O Intel VTune Amplifier pode coletar estes eventos e correlacioná-los com código fonte, facilitando identificação precisa de hotspots de false sharing.
Perf C2C no Linux
Para sistemas Linux, a ferramenta perf c2c (Cache-to-Cache) oferece análise detalhada de contenção de cache lines:
# Coletar dados
perf c2c record -a ./sua_aplicacao

# Analisar resultados
perf c2c report --stdio
A ferramenta identifica cache lines com maior contenção, mostra quais threads estavam acessando quais offsets, e até correlaciona com linha de código fonte. Um indicador chave é a porcentagem de "LLC Misses to Remote cache (HITM)" - valores altos indicam false sharing severo.
Profiling em .NET
Para aplicações .NET, ferramentas como JetBrains dotTrace podem identificar hotspots de performance relacionados a contenção de memória:
public class PerformanceMonitor
{
    public static void DetectContentionPatterns()
    {
        // Usar dotTrace Timeline profiling para identificar:
        // - Threads bloqueadas aguardando cache lines
        // - Padrões de contenção em operações atômicas
        // - Hotspots de performance em código concorrente

        using (DotTrace.BeginCollecting())
        {
            // Código suspeito de false sharing
            RunConcurrentOperations();
        }
    }
}
O Timeline profiling do dotTrace é particularmente útil pois mostra contenção temporal entre threads, revelando quando threads estão sendo bloqueadas por invalidações de cache.
Estratégias de Otimização
Padding Explícito
A solução mais direta é garantir que dados acessados por threads diferentes residam em cache lines separadas:
// Solução com padding explícito
[StructLayout(LayoutKind.Explicit, Size = 256)] // 4 cache lines
public class OptimizedCounters
{
    [FieldOffset(0)]   public long Counter1;    // Cache line 1
    [FieldOffset(64)]  public long Counter2;    // Cache line 2
    [FieldOffset(128)] public long Counter3;    // Cache line 3
    [FieldOffset(192)] public long Counter4;    // Cache line 4
}

// Alternativa usando padding com campos dummy
public class PaddedCounter
{
    public long Value;
    // 56 bytes de padding (64 - 8 = 56)
    private readonly long _pad1, _pad2, _pad3, _pad4, _pad5, _pad6, _pad7;
}
Thread-Local Storage
Uma estratégia elegante é evitar compartilhamento completamente usando thread-local storage:
public class ThreadLocalOptimized
{
    [ThreadStatic]
    private static int _localCounter;

    private static long _globalSum;

    public static void IncrementLocal()
    {
        _localCounter++; // Cada thread tem sua própria cópia
    }

    public static void FlushToGlobal()
    {
        if (_localCounter > 0)
        {
            Interlocked.Add(ref _globalSum, _localCounter);
            _localCounter = 0;
        }
    }
}
Esta abordagem elimina completamente false sharing durante incrementos, consolidando resultados apenas periodicamente.
Particionamento Inteligente
Para estruturas mais complexas, particionamento baseado em cache lines pode ser efetivo:
public class PartitionedCounters
{
    private const int CACHE_LINE_SIZE = 64;
    private const int PARTITIONS = Environment.ProcessorCount;

    [StructLayout(LayoutKind.Explicit, Size = CACHE_LINE_SIZE)]
    private struct PaddedLong
    {
        [FieldOffset(0)]
        public long Value;
    }

    private readonly PaddedLong[] _partitions;

    public PartitionedCounters()
    {
        _partitions = new PaddedLong[PARTITIONS];
    }

    public void Increment()
    {
        int partitionIndex = Thread.CurrentThread.ManagedThreadId % PARTITIONS;
        Interlocked.Increment(ref _partitions[partitionIndex].Value);
    }

    public long GetTotal()
    {
        long total = 0;
        for (int i = 0; i < PARTITIONS; i++)
        {
            total += _partitions[i].Value;
        }
        return total;
    }
}
Padrões Arquiteturais Avançados
NUMA Awareness
Em sistemas NUMA, false sharing pode ser ainda mais custoso quando ocorre entre sockets diferentes. Estratégias incluem:
public class NumaAwareDataStructure
{
    private readonly int _currentSocket;
    private readonly ConcurrentDictionary<int, LocalPartition> _socketPartitions;

    public NumaAwareDataStructure()
    {
        _currentSocket = GetCurrentNumaNode();
        _socketPartitions = new ConcurrentDictionary<int, LocalPartition>();
    }

    public void PerformOperation()
    {
        var partition = _socketPartitions.GetOrAdd(_currentSocket,
            _ => new LocalPartition());

        // Operações mantidas locais ao socket
        partition.DoWork();
    }
}
Lock-Free Data Structures
Estruturas de dados lock-free bem projetadas naturalmente evitam false sharing:
public class LockFreeStack<T>
{
    private volatile Node _head;

    // Cada nó ocupa sua própria cache line
    [StructLayout(LayoutKind.Explicit, Size = 64)]
    private class Node
    {
        [FieldOffset(0)] public volatile Node Next;
        [FieldOffset(8)] public T Value;
        // Padding implícito completa os 64 bytes
    }

    public void Push(T item)
    {
        var newNode = new Node { Value = item };

        do
        {
            newNode.Next = _head;
        } while (Interlocked.CompareExchange(ref _head, newNode, newNode.Next) != newNode.Next);
    }
}
Array Access Patterns
Para arrays grandes acessados por múltiplas threads, padrões de acesso podem ser otimizados:
public class OptimizedArrayProcessing
{
    public static void ProcessArray(int[] array, int threadCount)
    {
        int elementsPerCacheLine = 64 / sizeof(int); // 16 elementos
        int stride = elementsPerCacheLine * threadCount;

        Parallel.For(0, threadCount, threadId =>
        {
            // Cada thread processa elementos separados por cache line boundaries
            for (int i = threadId * elementsPerCacheLine; i < array.Length; i += stride)
            {
                // Processa elementos [i, i+15] que estão na mesma cache line
                int endIndex = Math.Min(i + elementsPerCacheLine, array.Length);
                for (int j = i; j < endIndex; j++)
                {
                    array[j] = ProcessElement(array[j]);
                }
            }
        });
    }
}
Considerações de Design em .NET
Garbage Collector e Cache Lines
O .NET Garbage Collector pode inadvertidamente criar false sharing ao compactar objetos:
// Potencial problema: GC pode colocar objetos adjacentes
public class GCConsideration
{
    // Estes objetos podem acabar em cache lines adjacentes após GC
    private readonly AtomicCounter _counter1 = new();
    private readonly AtomicCounter _counter2 = new();
}

// Solução: Usar arrays com padding garantido
public class GCOptimized
{
    [StructLayout(LayoutKind.Explicit, Size = 128)]
    private struct PaddedAtomicCounter
    {
        [FieldOffset(0)] public long Value;
    }

    private readonly PaddedAtomicCounter[] _counters = new PaddedAtomicCounter[2];
}
ValueTypes vs Reference Types
Value types alocados na stack naturalmente evitam alguns problemas de false sharing, mas podem criar outros:
public void CompareApproaches()
{
    // Abordagem 1: Reference types (heap) - mais controle de layout
    var heapCounters = new OptimizedCounters();

    // Abordagem 2: Value types (stack) - sem controle de posicionamento
    Span<long> stackCounters = stackalloc long[4];

    // stackCounters[0-3] provavelmente estão na mesma cache line!
}
Medindo o Impacto Real
Benchmarking Sistemático
public class FalseSharingBenchmark
{
    [Benchmark]
    public void WithFalseSharing()
    {
        var problematic = new ProblematicCounters();

        Parallel.For(0, Environment.ProcessorCount, threadId =>
        {
            var counter = GetCounterForThread(problematic, threadId);
            for (int i = 0; i < 1_000_000; i++)
            {
                Interlocked.Increment(ref counter);
            }
        });
    }

    [Benchmark]
    public void WithoutFalseSharing()
    {
        var optimized = new OptimizedCounters();

        Parallel.For(0, Environment.ProcessorCount, threadId =>
        {
            var counter = GetCounterForThread(optimized, threadId);
            for (int i = 0; i < 1_000_000; i++)
            {
                Interlocked.Increment(ref counter);
            }
        });
    }
}
BenchmarkDotNet fornece métricas detalhadas incluindo alocações de memória, permitindo correlacionar performance com padrões de acesso a memória.
Monitoramento de Produção
public class ProductionMonitoring
{
    private static readonly PerformanceCounter _cacheHitRatio =
        new("Processor", "% Cache Hit Ratio", "_Total");

    public static void MonitorCachePerformance()
    {
        var initialHitRatio = _cacheHitRatio.NextValue();

        // Execute operações suspeitas
        PerformConcurrentOperations();

        var finalHitRatio = _cacheHitRatio.NextValue();
        var degradation = initialHitRatio - finalHitRatio;

        if (degradation > 5.0) // 5% degradation threshold
        {
            Logger.LogWarning("Significant cache hit ratio degradation detected: {Degradation}%",
                             degradation);
        }
    }
}
Conclusão
False sharing representa um dos desafios mais sutis e impactantes na programação de alta performance para sistemas multicore. Sua natureza silenciosa - causando degradação severa sem sintomas óbvios - torna essencial o conhecimento profundo de como processadores modernos gerenciam memória e cache lines.
A compreensão do protocolo MESI e das implicações de cache lines de 64 bytes permite aos desenvolvedores .NET projetar estruturas de dados que naturalmente evitam false sharing. Técnicas como padding explícito, thread-local storage, e particionamento inteligente transformam código que sofre contenção severa em implementações verdadeiramente escaláveis.
Ferramentas de profiling especializadas, desde Intel VTune até perf c2c no Linux, fornecem visibilidade essencial para identificar problemas existentes. Para desenvolvedores .NET, dotTrace oferece insights valiosos sobre padrões de contenção temporal que podem indicar false sharing.
O investimento em otimizações de cache line frequentemente resulta em melhorias de performance de ordem de magnitude - não percentuais modestos, mas multiplicadores de 3-10x. Em uma era onde aumentos de clock frequency estagnaram e paralelismo tornou-se fundamental, dominar estas otimizações de baixo nível representa uma vantagem competitiva significativa.
À medida que processadores evoluem para ter ainda mais cores e hierarquias de cache mais complexas, a importância de compreender e evitar false sharing apenas aumentará. Desenvolvedores que dominam estes conceitos estarão preparados para extrair máxima performance de hardware presente e futuro, construindo aplicações que verdadeiramente aproveitam o poder da computação paralela moderna.
Insights & Takeaways
Cache lines de 64 bytes são a unidade fundamental de coerência, não bytes individuais: Processadores transferem e invalidam dados em blocos de 64 bytes, independentemente de quantos bytes são realmente acessados. Esta granularidade fixa é o que torna possível false sharing entre dados logicamente independentes.
False sharing pode degradar performance mais severamente que locks mal otimizados: Enquanto locks criam contenção óbvia, false sharing pode serializar completamente operações que parecem paralelas, resultando em degradação de 3-10x sem sintomas aparentes no código.
Thread-local storage é frequentemente mais eficiente que padding para eliminar false sharing: Embora padding resolva o problema técnico, thread-local storage elimina completamente o compartilhamento, reduzindo tanto false sharing quanto tráfego de coerência de cache legítimo.
Ferramentas especializadas são essenciais para detectar false sharing em código complexo: Intel VTune, perf c2c, e recursos de timeline profiling no dotTrace fornecem visibilidade em fenômenos que são invisíveis a profilers tradicionais focados em tempo de CPU.
O Garbage Collector .NET pode inadvertidamente criar false sharing durante compactação: Objetos que não compartilhavam cache lines inicialmente podem acabar adjacentes após coleta de lixo, criando false sharing em runtime que não existia durante alocação inicial.