System.Threading.Channels: Producer-Consumer Patterns Modernos
Como usar System.Threading.Channels no .NET para produtor-consumidor assíncrono: bounded e unbounded, backpressure, completion e pipelines em estágios.
Neste artigo · 11 seções
- Introdução
- Fundamentação Teórica: O Padrão Produtor-Consumidor
- Arquitetura e Conceitos Fundamentais
- Padrões Fundamentais de Uso
- Pipeline Patterns e Processamento em Estágios
- Comparação com Alternativas Legadas
- Boas Práticas e Padrões Avançados
- Aplicações Reais e Cenários
- Métricas de Performance e Considerações de Escalabilidade
- Conclusão
- Insights & Takeaways
Introdução
A comunicação entre threads em aplicações .NET multithread sempre foi um desafio fundamental. Desenvolvedores historicamente recorreram a primitivas de sincronização como locks, semáforos e eventos para coordenar trabalho entre threads. Contudo, essas abordagens tradicionais frequentemente resultam em código complexo, propenso a deadlocks, e com performance limitada quando múltiplas threads competem por recursos compartilhados.
O System.Threading.Channels, introduzido no .NET Core 3.0 como parte nativa da plataforma, oferece uma abstração moderna para o padrão produtor-consumidor que transcende as limitações das abordagens legadas. Channels implementa FIFO (First-In-First-Out) assíncrono com gerenciamento robusto de backpressure, permitindo que produtores e consumidores funcionem de forma desacoplada sem bloqueio de threads da thread pool.
Para desenvolvedores .NET, dominar channels representa um salto qualitativo em capacidade de construir sistemas concorrentes de alto desempenho. Este artigo explora os fundamentos de channels, seus padrões de uso distintos, e como aproveitá-los para criar aplicações que escalam elegantemente quando submetidas a variações dinâmicas de carga.
Fundamentação Teórica: O Padrão Produtor-Consumidor
Definição e Relevância
O padrão produtor-consumidor fundamenta-se em um conceito simples mas poderoso: desacoplar entidades que produzem dados de entidades que os consomem através de uma fila intermediária. Ao invés de produtor e consumidor interagirem diretamente - situação que força sincronização complexa e frequentemente resulta em espera - ambos interagem apenas com a fila, que gerencia coordenação assincronamente.
Essa desconexão oferece benefícios multifacetados. Produtores podem operar em velocidades independentes de consumidores. Se um produtor gera dados mais rapidamente que consumidores conseguem processar, dados acumulam-se na fila até que consumidores fiquem disponíveis. Inversamente, consumidores lentos não retardam produtores - simplesmente aguardam na fila. Múltiplos produtores ou consumidores podem compartilhar a mesma fila sem interferência mútua, permitindo paralelismo real.
Evolução Histórica em .NET
Antes de channels, a solução padrão em .NET era BlockingCollection<T>, que utiliza internamente ConcurrentQueue<T> mas adiciona semântica de bloqueio. Contudo, BlockingCollection<T> sofre de limitações críticas: opera sincronamente, bloqueando threads da thread pool enquanto aguardam; oferece granularidade limitada de controle sobre backpressure; e tem overhead de sincronização não-negligenciável para operações de alta throughput.
Channels, por contraste, foi construído desde o início para async/await. Não bloqueia threads - ao invés disso, usa ValueTask<T> (um struct que evita alocação heap quando a operação completa sincronamente) e async/await nativo para permitir que thread pool execute outros trabalho enquanto channels aguardam operações de I/O. O resultado é throughput dramàticamente superior, frequentemente excedendo 1 milhão de mensagens por segundo em benchmarks reais.
Arquitetura e Conceitos Fundamentais
Bounded vs. Unbounded Channels
Channels oferece duas topologias fundamentais, determinadas em tempo de criação:
Unbounded channels crescem dinamicamente sem limite máximo de itens que podem conter, restrito apenas pela memória disponível. Criar um unbounded channel é simples: Channel.CreateUnbounded<T>(). Produtores podem sempre escrever sem bloqueio, pois sempre há espaço. Este tipo é apropriado para cenários onde você com confiança pode afirmar que consumidores nunca ficarão significativamente atrás de produtores, ou onde dados chegam em explosões controladas.
Bounded channels limitam o número máximo de itens que podem ser buffered simultaneamente. Quando criado via Channel.CreateBounded<T>(capacity), o canal respeitará a capacidade especificada. Quando está cheio e um produtor tenta adicionar outro item, o produtor é suspenso de forma assíncrona até que consumidor retire itens suficientes para liberar espaço. Este é o padrão recomendado para a maioria dos cenários de produção, pois oferece backpressure automática que previne consumo descontrolado de memória mesmo quando consumidores ficam significativamente atrasados.
Backpressure: O Mecanismo Invisível
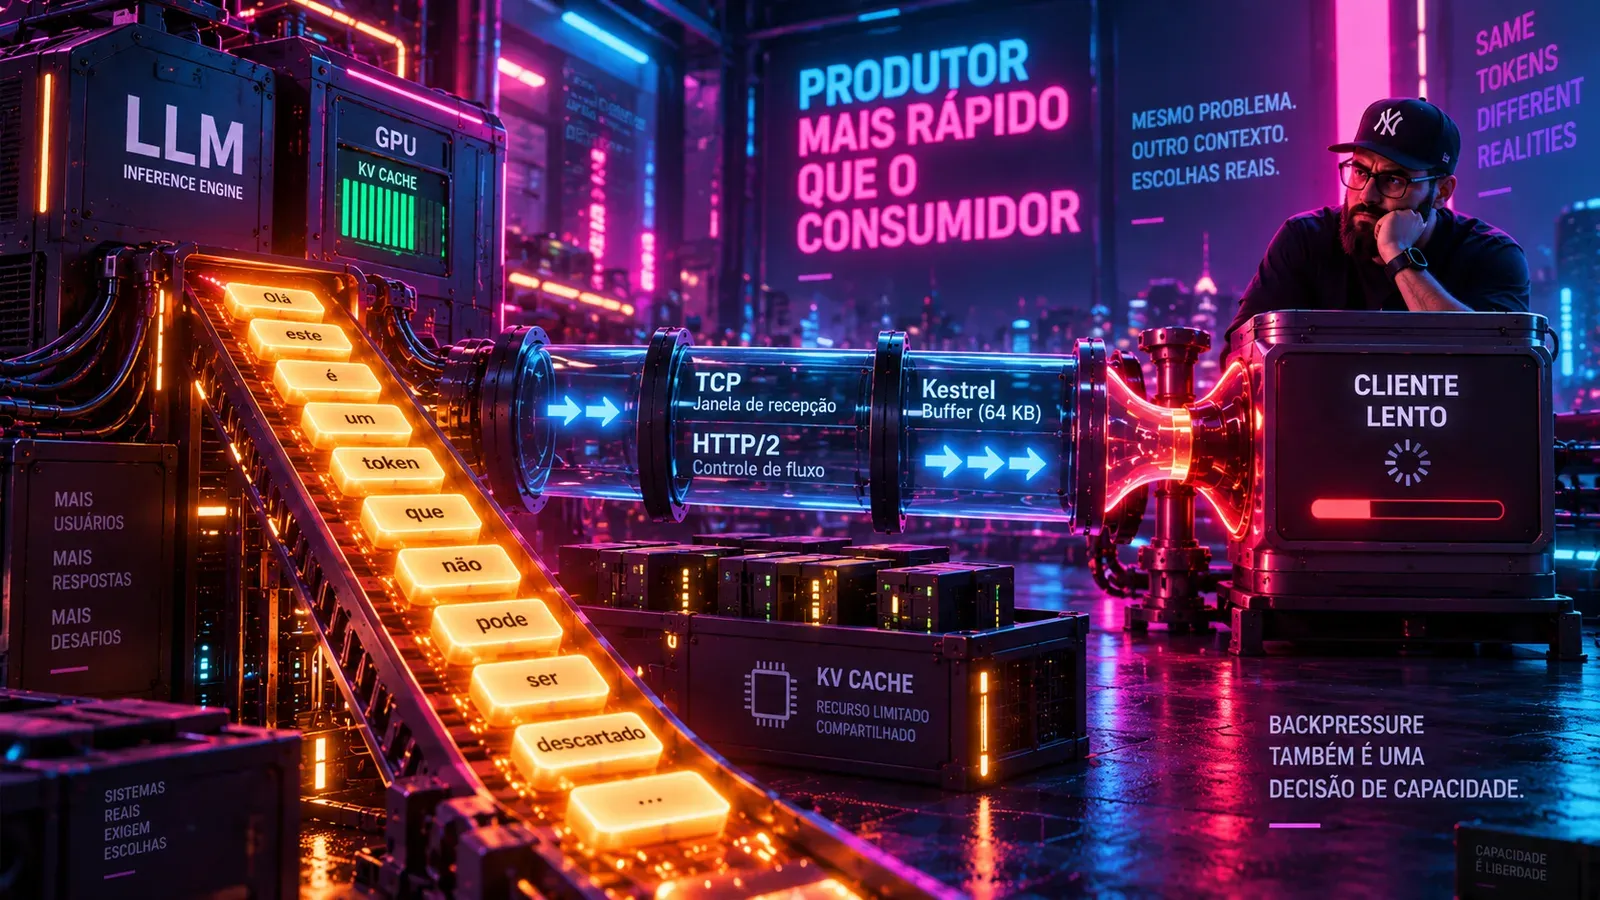
Backpressure é o conceito mais crítico para compreender channels. Quando um bounded channel está cheio, a call para WriteAsync() do produtor não retorna imediatamente - ao invés disso, retorna uma ValueTask que não se completa até que espaço esteja disponível. Isso força produtores a desacelerar naturalmente, sem necessidade de código explícito de throttling.
A beleza dessa abordagem é sua elegância: não requer lógica especial no produtor. O próprio ato de chamar WriteAsync() em um canal cheio fornece o freio necessário. Em aplicações reais, isso significa que sistemas dinâmicos se auto-equilibram - quando consumidores ficam congestionados, produtores ralentam automaticamente até que throughput se estabilize.
Completion: Sinalizando Finitude
Um aspecto essencial de channels é a capacidade de sinalizar que não há mais dados. Quando um produtor finaliza, chama writer.Complete() ou writer.TryComplete(exception). Esta chamada sinaliza aos consumidores que leitura está terminada. Consumidores iterando via await foreach automaticamente saem do loop quando recebem completion.
Handling correto de completion é crítico: se um produtor esquece de chamar Complete(), consumidores esperarão indefinidamente por mais dados. Conversamente, chamar Complete() prematuramente - antes de todos os dados serem escritos - resultará em dados perdidos.
Padrões Fundamentais de Uso
Single Producer, Single Consumer
O padrão mais simples envolve exatamente um produtor escrevendo dados e um consumidor processando-os. Esse cenário permite otimizações específicas na criação do channel:
var options = new UnboundedChannelOptions
{
    SingleReader = true,   // Apenas um leitor
    SingleWriter = true    // Apenas um escritor
};
var channel = Channel.CreateUnbounded<int>(options);
Ao indicar SingleReader e SingleWriter, o channel pode evitar certas sincronizações e locks internos necessários para múltiplos acessores simultâneos. O resultado é latência e throughput ligeiramente melhorados. Esse padrão é comum em pipelines simples: um stage produz dados, o próximo stage os consome.
Multiple Producers, Single Consumer
Frequentemente, múltiplas fontes de dados (múltiplos produtores) precisam ser agregadas para processamento por um único consumidor. Um exemplo seria múltiplos sensores enviando dados a um data logger centralizado. Neste cenário, múltiplos produtores podem chamar WriteAsync() concorrentemente no mesmo channel writer.
Como múltiplos produtores podem competir, especifique SingleWriter = false durante criação do channel. Também é necessário coordenar quando o channel está completo - ou você centraliza completion em um local, ou múltiplos produtores precisam coordenar para chamar Complete() apenas quando todos terminarem.
Single Producer, Multiple Consumers
O inverso é igualmente comum: um produtor rápido gera dados que são processados em paralelo por múltiplos consumidores lentos. Por exemplo, um servidor recebendo requisições (um produtor de requisições) as distribui a múltiplos worker threads (múltiplos consumidores) para processamento paralelo.
Neste caso, múltiplos consumidores chamam ReadAsync() ou iterarão via ReadAllAsync() no mesmo channel reader. O channel garante que cada item é processado exatamente uma vez - nunca duplicado, nunca perdido. Especifique SingleReader = false durante criação.
Multiple Producers, Multiple Consumers
O cenário mais complexo envolve múltiplos produtores e consumidores. Um exemplo é um sistema de processamento de mensagens onde múltiplas instâncias recebem mensagens de uma fila compartilhada e múltiplas instâncias as processam. Especifique tanto SingleReader = false quanto SingleWriter = false. Enquanto o channel mantém segurança thread (cada item é processado exatamente uma vez), complexidade de coordenação aumenta significativamente, particularmente em torno de completion - como saber quando todos os produtores realmente terminaram?
Pipeline Patterns e Processamento em Estágios
Composição de Múltiplos Canais
Um padrão poderoso emerge quando canais são compostos sequencialmente, formando pipelines de processamento. Um produtor enche o primeiro canal, que é consumido por um processor que enche um segundo canal, que é consumido por outro processor, e assim sucessivamente, até um consumidor final.
A vantagem de pipelines é que cada estágio pode operar em paralelo com outros, proporcionando throughput máximo quando estágios são balanceados em velocidade. Se um estágio é mais lento que outros, itens acumulam no canal antecedente até esse estágio desacelerar o pipeline inteiro, aplicando backpressure através de todo o pipeline.
Implementação típica:
// Stage 1: Produtor -> Canal1
var channel1 = Channel.CreateBounded<int>(3);
await foreach (var item in source)
{
    await channel1.Writer.WriteAsync(item);
}
channel1.Writer.Complete();

// Stage 2: Canal1 -> Processador -> Canal2
var channel2 = Channel.CreateBounded<string>(3);
_ = Task.Run(async () =>
{
    await foreach (var item in channel1.Reader.ReadAllAsync())
    {
        var processed = item * 2;
        await channel2.Writer.WriteAsync(processed.ToString());
    }
    channel2.Writer.Complete();
});

// Stage 3: Canal2 -> Consumidor
await foreach (var item in channel2.Reader.ReadAllAsync())
{
    Console.WriteLine($"Final result: {item}");
}
Vantagens de Pipelines com Channels
Pipelines oferecem benefícios significativos comparado a processamento sequencial. Em processamento sequencial, cada item é produzido, processado, e consumido antes do próximo começar. Em pipelines, enquanto o consumidor processa o item N, o processador está trabalhando em item N+1, e o produtor está gerando item N+2 - paralelismo verdadeiro. O throughput agregado pode ser múltiplos da velocidade de um único estágio, contanto que estágios não sejam drasticamente desbalanceados.
Comparação com Alternativas Legadas
BlockingCollection vs. Channels
BlockingCollection<T> bloqueava threads enquanto aguardava. Se um consumidor tentava ler de uma BlockingCollection vazia, a thread bloqueava até que dados ficassem disponíveis. Isso é problemático com thread pools limitados - múltiplos consumidores bloqueados podem exhaust a thread pool, deixando tarefas enfileiradas aguardando threads que nunca se tornam disponíveis.
Channels evita esse problema usando async/await nativo. Quando um consumidor executa await channel.Reader.ReadAsync() em um canal vazio, a tarefa simplesmente aguarda de forma assíncrona, liberando sua thread. Essa thread pode então processar outras tarefas enfileiradas. O consumidor retoma quando dados ficam disponíveis.
O resultado prático: channels oferecem throughput muito superior. Benchmarks mostram channels processando 1-5 milhões de mensagens por segundo enquanto BlockingCollection típicamente atinge apenas 100k-500k/segundo.
Performance Characteristics
Channels são otimizados para throughput e latência. Usos agressivos de structs como ValueTask<T> evitam alocações heap quando operações completam sincronamente (cenário comum quando produtor e consumidor têm velocidades similares). Operações são mostly allocation-free, resultando em pressure mínimo no garbage collector.
Boas Práticas e Padrões Avançados
Tratamento de Erros Robusto
Ao trabalhar com múltiplos produtores em um bounded channel, é essencial gerenciar completion adequadamente. Um padrão comum é usar um contador de referência para rastrear quantos produtores ainda estão ativos:
public class MultiProducerCoordinator<T>
{
    private readonly ChannelWriter<T> writer;
    private int producerCount;

    public void RegisterProducer()
    {
        Interlocked.Increment(ref producerCount);
    }

    public void UnregisterProducer()
    {
        if (Interlocked.Decrement(ref producerCount) == 0)
        {
            writer.TryComplete();
        }
    }
}
Quando um produtor falha, deve sinalizar erro através de writer.TryComplete(exception) ao invés de apenas writer.Complete(). Consumidores receberão a exceção quando iterarem e poderão responder apropriadamente.
Cancellation Tokens
Channels integra-se elegantemente com cancellation. Tanto WriteAsync() quanto ReadAsync() aceitam CancellationToken. Se cancelation é solicitado enquanto aguardando, a operação lança OperationCanceledException imediatamente. Isso permite shutdown gracioso de pipelines complexos.
Bounding Strategies
Beyond simples FullMode = BoundedChannelFullMode.Wait, bounded channels oferecem alternativas quando cheio:
DropWrite descarta o item novo, mantendo canal cheio. Apropriado para cenários onde itens novos são menos valiosos que itens antigos (e.g., leitura de sensores em tempo real).
DropOldest remove o item mais antigo do buffer para fazer espaço para o novo. Apropriado para streaming de dados onde eventos recentes são mais relevantes.
Wait bloqueia o produtor até que espaço esteja disponível - a opção padrão e mais comumente usada.
Aplicações Reais e Cenários
Data Processing Pipelines
Um cenário clássico é processamento de log files em paralelo. Estágio 1 lê linhas do arquivo, Estágio 2 parseia linhas, Estágio 3 valida dados, Estágio 4 persiste em banco de dados. Com channels, cada estágio executa em paralelo, melhorando throughput significativamente comparado a processamento sequencial.
Real-Time Event Processing
Sistemas que precisam processar eventos em tempo real (stocks, IoT, monitoramento) frequentemente enfrentam rajadas de eventos. Um bounded channel absorve rajadas sem crescimento descontrolado de memória. Consumidores processam eventos em ritmo sustentável enquanto backpressure automática descacelera produtores durante picos.
Microservices Communication
Em arquiteturas de microserviços, channels podem ser usados internamente para comunicação assíncrona entre componentes. Por exemplo, um serviço de API poderia usar channels para desacoplar recebimento de requisições (produtor) de processamento (consumidor), permitindo escalabilidade independente.
Métricas de Performance e Considerações de Escalabilidade
Quando Usar Channels
Channels são ideais quando: você necessita assíncrono produtor-consumidor com baixa latência, backpressure é crítico para evitar crescimento ilimitado de memória, ou throughput de alta taxa (100k+ mensagens/segundo) é requerido. Evite channels para cenários síncronos simples onde lock adequadamente suficiente.
Sizing Bounded Channels
A escolha de tamanho de buffer para bounded channels envolve trade-off entre memória utilizada e latência de espera de produtor. Buffers muito pequenos causam produtores bloquearem frequentemente, reduzindo throughput. Buffers muito grandes consomem memória desnecessária e mascaram problemas de consumidor lento. Uma heurística prática é usar tamanho aproximadamente 10-100 itens, ajustando baseado em memória de item e observações de produção.
Multi-core Scaling
Channels escalam bem com múltiplos cores. Cada consumidor em seu próprio core pode processar itens em paralelo sem contenção severa. Backpressure automática previne um core sendo inundado enquanto outros cores inativos, mantendo utilização balanceada.
Conclusão
System.Threading.Channels representa modernização fundamental em como .NET implementa comunicação produtor-consumidor. Ao ser construído nativamente para async/await, oferece performance superior a abordagens legadas enquanto mantendo API intuitiva. Backpressure automática remove uma classe inteira de bugs comuns onde sistemas ficam overwhelmed por acúmulo de dados não-processados.
Para aplicações que necessitam comunicação assíncrona entre componentes - particularmente aquelas que enfrentam variações dinâmicas de carga - channels deveria ser a primeira escolha arquitetural. Sua flexibilidade em suportar padrões de single-to-many, many-to-single, e many-to-many, combinada com pipeline capabilities, oferece um alicerce sólido para construir sistemas concorrentes altamente escaláveis.
O investimento em compreender channels profundamente retorna dividendos toda vez que uma aplicação necessita processar dados assincramente. Código escrito com channels é não apenas mais performático, mas também mais robusto, elegante, e maintível comparado a alternativas que requerem sincronização manual complexa.
Insights & Takeaways
Backpressure automática em bounded channels é mecanismo invisível porém poderoso que força produtores a desacelerar naturalmente quando consumidores não conseguem acompanhar, eliminando crescimento descontrolado de memória sem necessidade de lógica explicita de throttling no código de produção.
Channels foi projetado especificamente para async/await, evitando bloqueio de threads da thread pool ao usar ValueTask<T> e async primitivas, resultando em throughput de 5-20 vezes superior comparado a BlockingCollection<T> síncrona em cenários de alta taxa de mensagens.
Pipeline patterns com múltiplos canais conectados sequencialmente permitem paralelismo verdadeiro entre estágios, onde cada estágio processa item N enquanto o próximo estágio processa item N+1, aumentando throughput agregado multiplicativamente quando estágios são balanceados.
SingleReader e SingleWriter flags durante criação de channel habilitam otimizações críticas eliminando certos locks internos, fornecendo ganhos de performance mensuráveis para cenários comuns de um-para-um que não justificam overhead de múltiplos acessadores concorrentes.
Completion handling em cenários multi-produtor requer coordenação explícita usando técnicas como contadores de referência ou coordinators centralizados para garantir que Complete() é chamado apenas quando todos os produtores realmente terminaram, prevenindo consumidores esperando indefinidamente por dados que nunca virão.