Memory Barriers e Reordenação de Instruções: Controle de Execução em Processadores Modernos
Por que CPUs e compiladores reordenam instruções e como memory barriers, volatile, Interlocked e lock garantem a ordem certa em código concorrente .NET.
Neste artigo · 12 seções
- Introdução
- O Problema: Por Que Instruções São Reordenadas
- Modelos de Memória: O Contrato Entre Hardware e Software
- Memory Barriers: Controlando a Ordem de Execução
- Semântica Acquire-Release
- Volatile: Garantias e Limitações
- Happens-Before: A Formalização da Ordenação
- Ferramentas Práticas em .NET
- Padrões e Anti-Padrões
- Performance e Trade-offs
- Conclusão
- Insights & Takeaways
Introdução
Em programação concorrente, existe uma ilusão reconfortante que a maioria dos desenvolvedores mantém: a crença de que o código executa exatamente na ordem em que foi escrito. Esta suposição, embora válida para programas single-threaded simples, desmorona completamente quando entramos no universo da programação multithread moderna. Processadores e compiladores, em sua busca incessante por performance, reorganizam instruções de maneiras que podem produzir resultados aparentemente impossíveis.
Memory barriers e reordenação de instruções representam um dos aspectos mais fundamentais e contra-intuitivos da programação de alto desempenho. Para desenvolvedores .NET que trabalham com concorrência, compreender estes mecanismos deixou de ser conhecimento avançado opcional para tornar-se essencial. Um código que funciona perfeitamente em testes pode falhar de formas misteriosas em produção, não por bugs óbvios, mas por violações sutis do modelo de memória que apenas se manifestam sob condições específicas de timing e hardware.
Este artigo explora em profundidade como processadores modernos reordenam operações de memória, por que isso acontece, e como memory barriers fornecem as ferramentas necessárias para controlar esse comportamento quando a correção do programa depende de ordem específica de execução.
O Problema: Por Que Instruções São Reordenadas
Otimizações de Performance
Processadores modernos são máquinas extraordinariamente complexas, capazes de executar múltiplas instruções simultaneamente através de pipelines profundos, execução especulativa e out-of-order execution. Para extrair máxima performance, tanto compiladores quanto CPUs reorganizam instruções de maneiras que preservam a semântica do programa single-threaded, mas podem violar expectativas em contextos multithreaded.
O compilador C# pode reordenar atribuições se determinar que isso melhora o uso de registradores ou permite melhor agendamento de instruções. A CPU, por sua vez, pode executar instruções fora de ordem se recursos necessários (como dados de memória) ainda não estiverem disponíveis, processando instruções posteriores que já podem executar. Caches e buffers internos adicionam outra camada de complexidade, onde escritas podem ser bufferizadas e leituras podem ser servidas de caches locais sem consultar memória principal.
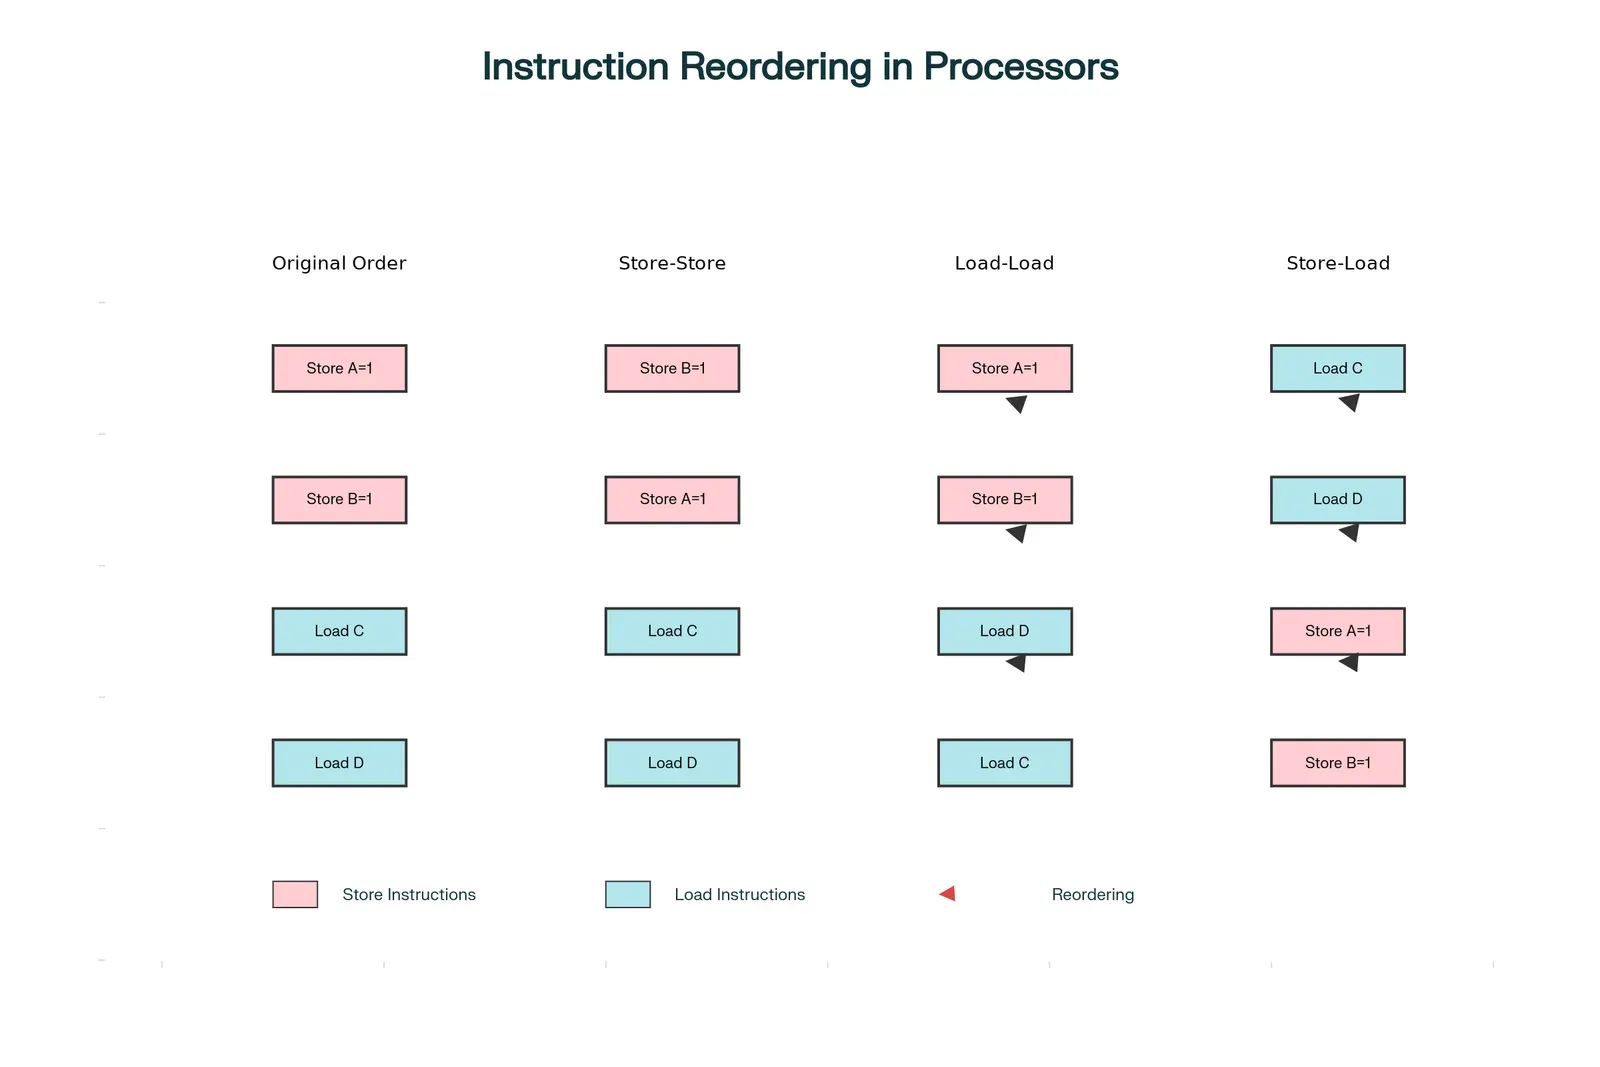
Tipos de reordenação de instruções permitidos por processadores modernos
O Exemplo Clássico: Resultados Impossíveis
Consider o seguinte código aparentemente trivial, executado por duas threads diferentes:
// Variáveis compartilhadas, inicialmente 0
private static int x = 0;
private static int y = 0;
private static int a = 0;
private static int b = 0;

// Thread 1
x = 1;
a = y;

// Thread 2
y = 1;
b = x;
Intuitivamente, existem quatro possíveis resultados considerando diferentes interleavings:
- Thread 1 executa completamente, depois Thread 2:
a=0, b=1 - Thread 2 executa completamente, depois Thread 1:
a=1, b=0 - Escritas executam antes das leituras:
a=1, b=1 - Leituras parcialmente interleaved com escritas: variações de
a=0, b=1oua=1, b=0
Contudo, em hardware real, um quinto resultado impossível aparece com frequência surpreendente: a=0, b=0. Este resultado sugere que ambas as leituras ocorreram antes de ambas as escritas, violando completamente a ordem do programa como escrito.
Este resultado só é possível através de reordenação: as CPUs moveram as leituras (a = y e b = x) para antes das escritas (x = 1 e y = 1) dentro de cada thread. Para cada thread individualmente, essa reordenação não altera o comportamento observável - Thread 1 não usa o valor de x depois de escrevê-lo, então a CPU pode reordenar livremente. Mas quando threads interagem, essa "otimização" inocente produz comportamento incorreto.
Modelos de Memória: O Contrato Entre Hardware e Software
Consistência Sequencial: O Modelo Intuitivo
O modelo de memória mais simples e intuitivo é a consistência sequencial. Neste modelo, todas as operações de memória de todas as threads aparecem em alguma ordem total global, e operações de cada thread aparecem nessa ordem na sequência especificada pelo programa. É como se tivéssemos um único processador executando instruções de todas as threads em algum interleaving aleatório mas consistente.
Consistência sequencial é o modelo que a maioria dos programadores assume intuitivamente. Infelizmente, nenhuma arquitetura de processador moderna fornece consistência sequencial por padrão, pois as restrições de ordenação necessárias são muito custosas em termos de performance.
Modelos Relaxados: A Realidade dos Processadores Modernos
Processadores reais implementam modelos de memória relaxados, permitindo vários tipos de reordenação para melhorar performance. O processador x86/x64, por exemplo, implementa um modelo de memória relativamente forte (Total Store Ordering - TSO), mas ainda permite reordenação Store-Load: uma leitura pode ser movida antes de uma escrita anterior.
Arquiteturas como ARM e PowerPC permitem reordenações ainda mais agressivas, incluindo Store-Store (escritas em ordem diferente) e Load-Load (leituras em ordem diferente). Estas arquiteturas exigem uso explícito de memory barriers para garantir qualquer ordenação específica.
O Modelo de Memória .NET
O .NET CLR fornece um modelo de memória específico que desenvolvedores podem depender. Este modelo garante:
- Leituras e escritas de tipos primitivos são atômicas (exceto long/double em 32-bit)
- Escritas não podem ser reordenadas com escritas anteriores (StoreStore ordering)
- Leituras não podem ser reordenadas com leituras anteriores (LoadLoad ordering)
- Locks fornecem acquire-release semantics completas
Contudo, o .NET permite Store-Load reordering: uma leitura pode ser movida antes de uma escrita não relacionada. Esta é a fonte do resultado impossível no exemplo anterior.
Memory Barriers: Controlando a Ordem de Execução
O Que São Memory Barriers
Um memory barrier (também chamado de fence, membar, ou barreira de memória) é uma instrução especial que restringe a reordenação de operações de memória. Conceitualmente, um barrier cria um ponto no programa onde certas garantias de ordenação devem ser respeitadas.
Memory barriers funcionam em dois níveis. No nível do compilador, previnem otimizações que moveriam operações de memória através do barrier. No nível do hardware, forçam flush de buffers internos e garantem que operações anteriores sejam globalmente visíveis antes de operações posteriores prosseguirem.
Tipos de Memory Barriers
Memory barriers não são todos iguais. Diferentes barriers fornecem diferentes garantias de ordenação:
LoadLoad Barrier: Garante que todas as leituras antes do barrier completem antes de qualquer leitura após o barrier. Impede que leituras posteriores sejam especulativamente executadas com dados potencialmente obsoletos.
StoreStore Barrier: Garante que todas as escritas antes do barrier sejam visíveis globalmente antes de qualquer escrita após o barrier. Essencial quando a ordem de atualização de múltiplas variáveis importa.
LoadStore Barrier: Garante que todas as leituras antes do barrier completem antes de qualquer escrita após o barrier. Menos comum mas necessário em alguns padrões de sincronização.
StoreLoad Barrier: O mais custoso - garante que todas as escritas antes do barrier sejam visíveis globalmente antes de qualquer leitura após o barrier. Frequentemente requer flush completo de pipelines e buffers.
Full Barrier: Combina todos os tipos acima, impedindo qualquer reordenação de operações de memória através do barrier. Thread.MemoryBarrier() em .NET é um full barrier.
Store Buffer e Invalidate Queue
Para compreender por que memory barriers são necessários, devemos entender otimizações internas da CPU. Quando uma CPU escreve para memória que não está em seu cache local, ela não espera sincronamente pela conclusão da operação. Em vez disso, a escrita é colocada em um store buffer e a CPU continua executando.
O store buffer permite que a CPU proceda sem esperar acknowledgments de outros cores, mas introduz um problema: a própria CPU pode ler sua store buffer (via store forwarding), mas outras CPUs não podem. Isso cria inconsistências onde uma thread vê suas próprias escritas imediatamente, mas outras threads as veem com atraso.
Simetricamente, quando um core recebe uma mensagem de invalidação (indicando que outra CPU modificou dados compartilhados), processar a invalidação imediatamente seria custoso. Em vez disso, a invalidação é colocada em uma invalidate queue e um acknowledgment é enviado imediatamente. A invalidação real é processada depois.
Memory barriers forçam flush destes buffers: um write barrier drena o store buffer, e um read barrier processa a invalidate queue, garantindo que todas as operações pendentes completem antes de prosseguir.
Semântica Acquire-Release
Conceitos Fundamentais
Acquire-release semantics fornecem um meio-termo entre full barriers (muito custosos) e nenhuma ordenação (muito perigoso). Estas semânticas são projetadas especificamente para padrões de sincronização onde uma thread "libera" ownership de dados e outra "adquire" esse ownership.
Release semantics aplicam-se a escritas: garantem que todas as operações de leitura e escrita antes do release sejam completadas e visíveis antes que o release em si seja visível. Conceitualmente, o release "publica" todas as modificações anteriores.
Acquire semantics aplicam-se a leituras: garantem que todas as operações de leitura e escrita após o acquire não possam ser movidas antes dele. O acquire "consome" dados publicados por um release anterior.
Relação com Locks e Sincronização
Locks fornecem acquire-release semantics naturalmente. Quando uma thread adquire um lock, ela obtém acquire semantics: todas as operações dentro do lock veem dados atualizados. Quando libera o lock, obtém release semantics: todas as modificações dentro do lock são publicadas para outras threads.
// Lock fornece acquire-release automático
private readonly object _lock = new object();
private int _sharedData = 0;

public void UpdateData(int value)
{
    lock (_lock)  // Acquire: vê modificações anteriores
    {
        _sharedData = value;
        // Outras operações...
    }  // Release: publica modificações
}
Esta é a razão pela qual código dentro de locks funciona intuitivamente: as semânticas de ordenação necessárias são fornecidas automaticamente.
Implementação Eficiente
Acquire-release é mais eficiente que full barriers porque permite alguma reordenação:
- Release permite que operações posteriores sejam movidas para antes do release (mas não o contrário)
- Acquire permite que operações anteriores sejam movidas para depois do acquire (mas não o contrário)
Esta flexibilidade permite que processadores realizem mais otimizações mantendo correção. Em ARM, por exemplo, operações acquire-release mapeiam para instruções leves (ldacquire/strelease) enquanto full barriers requerem instruções DMB mais custosas.
Volatile: Garantias e Limitações
O Que Volatile Faz
A palavra-chave volatile em C# adiciona memory barriers específicos:
- Leitura volatile atua como acquire: nenhuma leitura/escrita posterior pode ser movida antes dela
- Escrita volatile atua como release: nenhuma leitura/escrita anterior pode ser movida depois dela
- Força acesso direto à memória: previne caching da variável em registradores
// Flag volatile garante visibilidade
private volatile bool _shouldStop = false;

public void Worker()
{
    while (!_shouldStop)  // Leitura volatile - acquire semantics
    {
        DoWork();
    }
}

public void Stop()
{
    _shouldStop = true;  // Escrita volatile - release semantics
}
O Que Volatile NÃO Faz
Volatile é frequentemente mal compreendido. Crucialmente, volatile não fornece atomicidade. Operações compostas como incremento (_count++) não são atômicas mesmo com volatile:
private volatile int _count = 0;

// ❌ NÃO É THREAD-SAFE!
_count++;  // Três operações: read, increment, write - não atômicas

// ✅ THREAD-SAFE
Interlocked.Increment(ref _count);
Volatile também permite Store-Load reordering. No exemplo clássico apresentado anteriormente, mesmo com todas as variáveis volatile, o resultado a=0, b=0 ainda é possível porque volatile não impede que leituras sejam movidas antes de escritas.
Quando Usar Volatile
Volatile é apropriado para casos específicos:
- Flags booleanas simples de start/stop
- Estados enumerados que mudam atomicamente
- Double-checked locking (combinado com locks)
- Publicação de referências imutáveis
Para qualquer caso mais complexo, use mecanismos mais robustos como Interlocked, lock, ou collections concurrent.
Happens-Before: A Formalização da Ordenação
Definindo Happens-Before
A relação happens-before formaliza quando uma operação é garantida ser visível para outra. Se operação A happens-before operação B, então:
- A completa antes de B começar (ordenação temporal)
- Os efeitos de A são visíveis para B (ordenação de visibilidade)
- Esta relação é transitiva: se A happens-before B e B happens-before C, então A happens-before C
A relação happens-before é construída a partir de:
- Program order: Dentro de uma thread, operações ocorrem em ordem de programa
- Synchronizes-with: Operações de sincronização (release-acquire) criam happens-before entre threads
- Transitivity: Se A happens-before B e B happens-before C, então A happens-before C
Aplicação Prática
// Exemplo de happens-before chain
private int _data = 0;
private volatile bool _ready = false;

// Thread 1 (Producer)
public void Produce()
{
    _data = 42;        // (1)
    _ready = true;     // (2) volatile write - release
}

// Thread 2 (Consumer)
public void Consume()
{
    while (!_ready);   // (3) volatile read - acquire
    Console.WriteLine(_data);  // (4)
}

/*
 * Happens-before chain:
 * (1) happens-before (2) - program order + volatile release
 * (2) synchronizes-with (3) - release-acquire pair
 * (3) happens-before (4) - program order + volatile acquire
 *
 * Portanto: (1) happens-before (4)
 * Garantia: Consumer sempre vê _data = 42
 */
Esta formalização permite raciocínio rigoroso sobre correção de código concorrente.
Ferramentas Práticas em .NET
Thread.MemoryBarrier()
Thread.MemoryBarrier() é o full barrier mais explícito em .NET:
private static int x = 0;
private static int y = 0;

// Thread 1
x = 1;
Thread.MemoryBarrier();  // Full fence
int localY = y;

// Thread 2
y = 1;
Thread.MemoryBarrier();  // Full fence
int localX = x;

// Garante que não veremos localX=0 E localY=0
Use Thread.MemoryBarrier() quando precisar de garantias absolutas de ordenação, mas esteja ciente do custo: full barriers são operações relativamente lentas que podem custar dezenas de nanosegundos.
Interlocked: Atomicidade com Barriers Implícitos
Todas as operações Interlocked fornecem barriers implícitos:
// Interlocked.Exchange: atomic + full barrier
Interlocked.Exchange(ref _value, newValue);

// Interlocked.CompareExchange: atomic + acquire-release
var original = Interlocked.CompareExchange(ref _value, newValue, comparand);

// Interlocked.Increment: atomic + full barrier
Interlocked.Increment(ref _counter);
Esta é frequentemente a escolha ideal: você obtém atomicidade (que volatile não fornece) e barriers necessários (que operações normais não fornecem) em uma operação otimizada.
Lock: A Abstração de Alto Nível
O statement lock fornece acquire no início e release no fim:
private readonly object _lock = new object();
private int _sharedValue = 0;

public void UpdateValue(int value)
{
    lock (_lock)  // Acquire barrier
    {
        // Todas as operações aqui são protegidas
        _sharedValue = value;
        // Nenhuma reordenação cruza as boundaries do lock
    }  // Release barrier
}
Locks são a ferramenta correta quando você precisa proteger múltiplas operações relacionadas ou manter invariantes complexos. O overhead de locks (tipicamente 10-50 nanosegundos) é desprezível comparado ao custo de bugs sutis de concorrência.
Padrões e Anti-Padrões
Double-Checked Locking: O Caso Clássico
Double-checked locking é o exemplo canonical de por que memory barriers importam:
// ❌ ERRADO: Sem volatile
private static object _instance;
private static readonly object _lock = new object();

public static object Instance
{
    get
    {
        if (_instance == null)  // Check #1 - sem sincronização
        {
            lock (_lock)
            {
                if (_instance == null)  // Check #2 - com sincronização
                {
                    _instance = new object();
                }
            }
        }
        return _instance;  // PROBLEMA: pode ver objeto parcialmente construído!
    }
}

// ✅ CORRETO: Com volatile
private static volatile object _instanceCorrect;
// ... resto igual ...

// ✅ MELHOR: Lazy<T>
private static readonly Lazy<object> _instanceLazy = new Lazy<object>();
public static object Instance => _instanceLazy.Value;
Sem volatile, _instance pode ser visível para outras threads antes que o construtor complete, devido a reordenação. Volatile adiciona o release necessário na escrita e acquire na leitura.
Publisher-Subscriber Pattern
// Padrão seguro para publicar dados
public class SafePublisher<T> where T : class
{
    private volatile T _data;

    // Publisher
    public void Publish(T data)
    {
        // Prepara completamente os dados
        var fullyConstructedData = PrepareData(data);

        // volatile write - release
        // Garante que PrepareData() completa antes da publicação
        _data = fullyConstructedData;
    }

    // Subscribers
    public T Subscribe()
    {
        // volatile read - acquire
        // Garante que vemos dados completos
        return _data;
    }
}
Spin-Wait com Backoff
public class SpinWaitExample
{
    private volatile bool _available = false;
    private int _data = 0;

    public void WaitForData()
    {
        var spinner = new SpinWait();

        while (!_available)  // volatile read - acquire
        {
            spinner.SpinOnce();  // Backoff exponencial
        }

        // volatile acquire garante que vemos _data atualizado
        UseData(_data);
    }

    public void PublishData(int data)
    {
        _data = data;
        _available = true;  // volatile write - release
    }
}
Performance e Trade-offs
O Custo de Memory Barriers
Memory barriers não são gratuitos. Custos típicos:
- Compiler barrier: Previne optimizações - custo zero em runtime
- LoadLoad/StoreStore: 1-5 ciclos em x86, mais em ARM
- Full barrier (StoreLoad): 10-100+ ciclos dependendo da arquitetura
- Lock acquire/release: 10-50 nanosegundos em x86
Em loops tight ou hot paths, estes custos podem acumular significativamente.
Quando Otimizar
Otimização prematura de memory barriers é perigosa. A hierarquia correta é:
- Correção primeiro: Use locks, eles são rápidos o suficiente
- Perfil depois: Identifique gargalos reais
- Otimize seletivamente: Substitua locks por técnicas lock-free apenas onde necessário
- Documente extensivamente: Memory barriers sem documentação são bombas-relógio
Medindo o Impacto
public class BarrierBenchmark
{
    private const int ITERATIONS = 10_000_000;

    [Benchmark]
    public void NoBarrier()
    {
        int localValue = 0;
        for (int i = 0; i < ITERATIONS; i++)
        {
            localValue++;
        }
    }

    [Benchmark]
    public void WithMemoryBarrier()
    {
        int localValue = 0;
        for (int i = 0; i < ITERATIONS; i++)
        {
            localValue++;
            Thread.MemoryBarrier();  // Adiciona custo significativo
        }
    }

    [Benchmark]
    public void WithVolatile()
    {
        for (int i = 0; i < ITERATIONS; i++)
        {
            _volatileValue++;  // volatile read + write
        }
    }

    private volatile int _volatileValue = 0;
}

// Resultados típicos (x86):
// NoBarrier: 5ms
// WithMemoryBarrier: 250ms (50x mais lento!)
// WithVolatile: 180ms (36x mais lento)
Conclusão
Memory barriers e reordenação de instruções representam a interseção entre o modelo mental abstrato que desenvolvedores mantêm e a realidade brutal do hardware moderno. Processadores reordenam operações agressivamente para maximizar throughput, e essas otimizações funcionam perfeitamente enquanto permanecemos em código single-threaded. Mas no momento em que múltiplas threads começam a interagir através de memória compartilhada, essas mesmas otimizações podem produzir resultados aparentemente impossíveis.
O modelo de memória do .NET fornece um contrato claro entre hardware e software, especificando quais reordenações são permitidas e quais ferramentas existem para controlar ordenação quando necessário. Volatile, Thread.MemoryBarrier, Interlocked, e locks fornecem um spectrum de opções, cada uma com diferentes garantias e custos de performance.
A chave para programação concurrent correta não é evitar memory barriers completamente - isso é impossível - mas compreendê-los suficientemente para usá-los apropriadamente. Comece com abstrações de alto nível como locks e collections concurrent. Apenas quando profiling identificar gargalos reais, considere otimizações lock-free que exigem reasoning detalhado sobre ordenação de memória.
Finalmente, documente extensivamente qualquer código que depende de memory barriers específicos. Futuras manutenções ou portabilidade para diferentes arquiteturas podem quebrar suposições sutis sobre ordenação. Um comentário explicando por que um volatile é necessário pode salvar horas de debugging meses depois. Em um domínio onde bugs podem ser não-determinísticos e reproduzir-se apenas sob condições específicas de carga, investir em clareza e documentação não é opcional - é essencial para manter código correct e maintainable ao longo do tempo.
Insights & Takeaways
Processadores reordenam instruções agressivamente para performance, violando intuições de ordem de programa: Operações aparentemente sequenciais podem executar out-of-order, com leituras ocorrendo antes de escritas precedentes. Isto produz resultados "impossíveis" que só aparecem sob condições específicas de timing e hardware.
Volatile fornece acquire-release semantics, mas NÃO garante atomicidade: Um equívoco comum é assumir que volatile torna operações thread-safe. Volatile garante visibilidade e ordena certas operações, mas operações compostas como _count++ continuam não-atômicas mesmo com volatile.
Acquire-release semantics são mais eficientes que full barriers e suficientes para maioria dos padrões de sincronização: Enquanto full barriers impedem todas as reordenações (custoso), acquire-release permite alguma flexibilidade mantendo correção. Locks naturalmente fornecem acquire-release, tornando-os frequentemente a escolha correta.
A relação happens-before formaliza quando uma operação é garantida ser visível para outra: Compreender happens-before permite reasoning rigoroso sobre correção de código concurrent. Se A happens-before B, então efeitos de A são sempre visíveis para B, independentemente de reordenações permitidas.
Memory barriers têm custo significativo e devem ser usados judiciosamente após profiling identificar gargalos reais: Full barriers podem custar 50-100x mais que operações normais. A hierarquia correta é: correção primeiro (use locks), profile depois, otimize seletivamente apenas hot paths identificados, e documente extensivamente qualquer código dependente de ordenação específica.