Código nunca foi commodity · Episódio 4
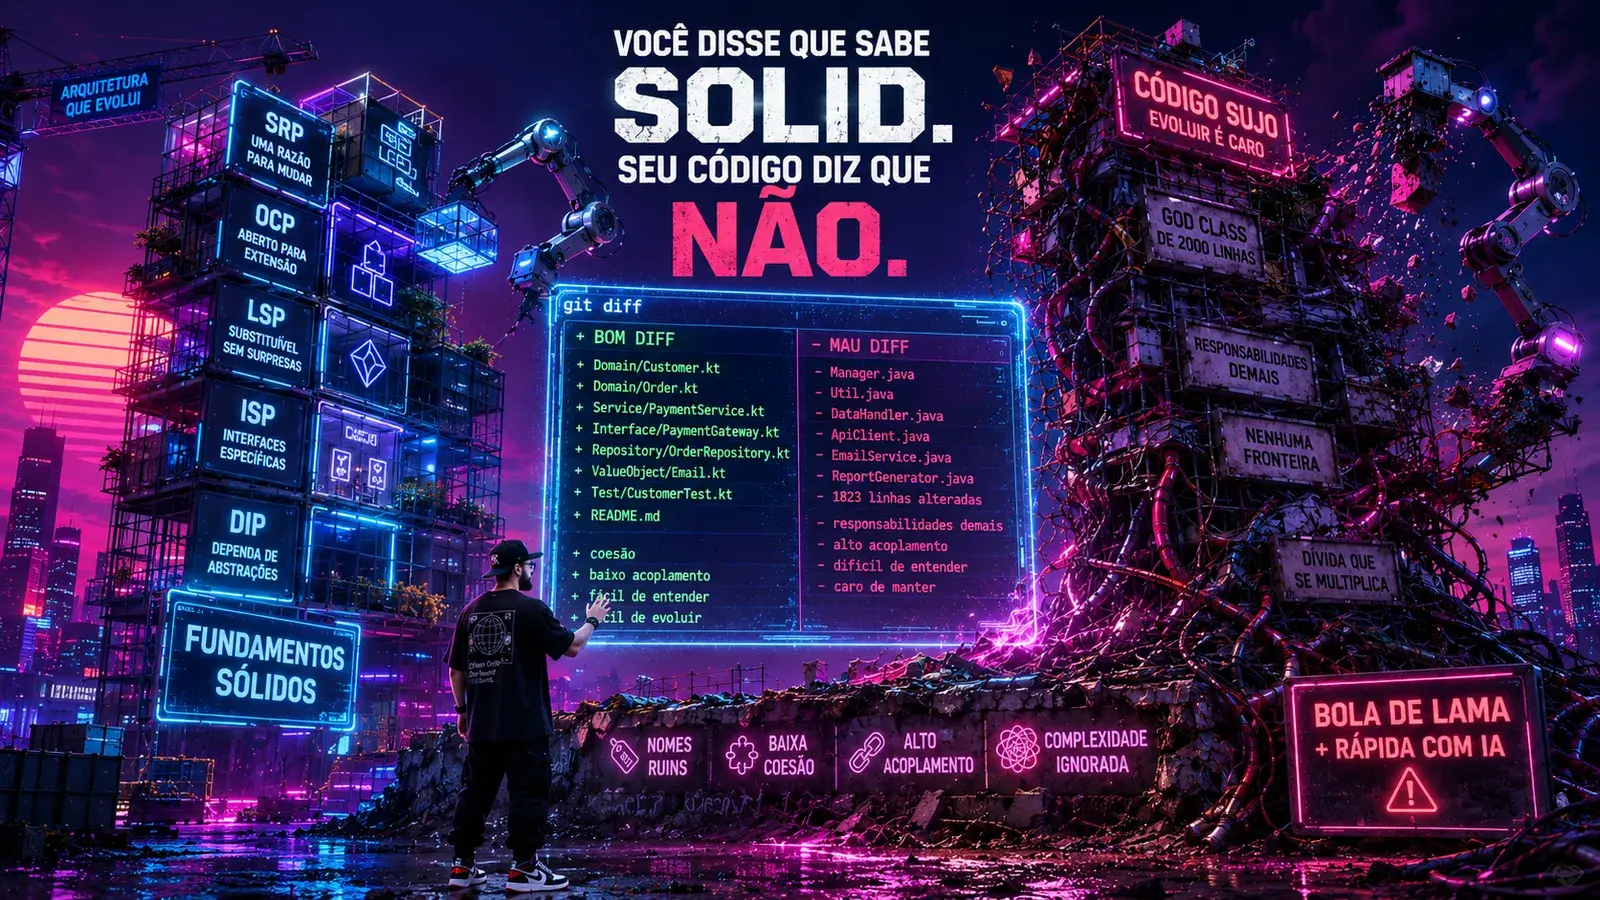
Você disse que sabe SOLID. Seu código diz que não.
Fundamento se prova no diff, não na entrevista: como SOLID, nomes e complexidade decidem o custo da mudança, e por que a IA acelera a bola de lama.
Neste artigo · 8 seções
Em entrevista, todo mundo sabe SOLID. Pergunta o que é o S, vem a resposta decorada. Pergunta de DDD, vem "linguagem ubíqua, bounded context", tudo no lugar certo. O candidato manda bem, é contratado, e seis meses depois você abre o repositório que ele construiu. God class de duas mil linhas. Um Manager que faz dezoito coisas. Nenhuma fronteira de domínio à vista. Na sala, recita. No git, não aplica.
A tese deste artigo é incômoda de propósito: fundamento não é enfeite acadêmico que você cita pra parecer sênior. É o que separa software que evolui barato de uma bola de lama frágil, cara e insegura. E a IA está subindo bola de lama mais rápido do que a gente conseguia antes.
a única forma de ir rápido é não sujar o caminho
Robert Martin abre o Clean Code com a frase que devia estar na parede de quem decide prazo: "O único jeito de cumprir o prazo, o único jeito de ir rápido, é manter o código o mais limpo possível o tempo todo" (no original, "The only way to make the deadline, the only way to go fast, is to keep the code as clean as possible at all times."). Não é estética. É a régua da velocidade.
O contrário ele desenha numa curva. Conforme a bagunça cresce, "a produtividade do time continua caindo, aproximando-se assintoticamente de zero" (no original, "the productivity of the team continues to decrease, asymptotically approaching zero."). Traduz pro board: cada mudança quebra duas outras, nada é trivial, e a capacidade de entrega do time vai pra perto de zero enquanto o custo da folha continua igual. Sujeira não é dívida que você quita depois. É juros que você paga todo sprint.
saber SOLID se prova no diff, não na fala
Dos cinco princípios do SOLID, o S é o mais simples de enunciar e o mais traído na prática. Martin não poupa: "curiosamente, o SRP é com frequência o princípio de design de classes mais violado" (no original, "oddly, SRP is often the most abused class design principle."). A regra cabe numa linha: "uma classe ou módulo deve ter uma, e apenas uma, razão para mudar" (no original, "a class or module should have one, and only one, reason to change."). Fácil de recitar. Difícil de sustentar quando o prazo aperta e parece mais rápido jogar mais um método na classe que já existe.
E aqui está o que separa discurso de fundamento. Martin diz, com todas as letras, que "ser capaz de reconhecer código limpo de código sujo não significa que sabemos escrever código limpo" (no original, "being able to recognize clean code from dirty code does not mean that we know how to write clean code!"). Reconhecer é barato. Escrever sob pressão é o que prova o fundamento. Por isso "sei SOLID" não se verifica na entrevista; se verifica no diff. Eu mesmo escrevi o que considero um guia definitivo sobre SOLID, e justamente por isso afirmo: ter lido o guia, ou tê-lo escrito, não é a mesma coisa que aplicá-lo às duas da manhã. O teste é o commit, não o vocabulário.
a IA otimiza os 10% que não importam
Tem um número no Clean Code que muda como você olha pra produtividade. "A proporção de tempo gasto lendo versus escrevendo é bem maior que 10 para 1" (no original, "the ratio of time spent reading vs. writing is well over 10:1."). A gente passa dez vezes mais tempo lendo código velho pra conseguir escrever código novo do que digitando. E o que torna a leitura barata? Nome. "Os nomes no software são 90 por cento do que torna o software legível" (no original, "Names in software are 90 percent of what make software readable.").
Junta as duas e a ponte pra IA aparece sozinha. Os livros são anteriores à IA generativa; essa ponte é minha, não dos autores. A IA otimiza com brilho os 10% baratos: escrever. Ela cospe função em segundos. Mas se o que sai tem nome ruim, responsabilidade demais e zero coesão, ela inflou os 90% caros: ler e entender depois. O gargalo nunca foi a digitação. Era, e segue sendo, o julgamento humano sobre legibilidade e design. Acelerar o lado barato piorando o lado caro não é produtividade. É a curva da produtividade indo pra zero, só que mais rápido.
a bagunça se espalha sozinha
Hunt e Thomas, no Pragmatic Programmer, deram nome ao que acontece quando se tolera uma sujeira: "Quando a desordem aumenta no software, os programadores chamam isso de software rot" (no original, "When disorder increases in software, programmers call it 'software rot.'"). E veio a metáfora que pegou: a janela quebrada. Uma janela quebrada que ninguém conserta avisa o time todo que ali ninguém liga, e a decadência acelera. A regra deles é tolerância zero: "Não conviva com janelas quebradas (designs ruins, decisões erradas ou código porco) sem conserto" (no original, "Don't leave 'broken windows' (bad designs, wrong decisions, or poor code) unrepaired.").
O detalhe pra quem decide: zelo não se terceiriza. Os autores chamam de "claramente ridícula" (no original, "clearly ridiculous") a ideia de nomear um "quality officer" pra cuidar da qualidade no lugar do time, porque qualidade só vem da contribuição de cada um. Vale pro cargo e vale pra IA. Plugar um modelo pra gerar volume e esperar que a qualidade brote sozinha é a mesma fantasia, com fatura maior. E dívida que ninguém encara não some, se multiplica.
o fundamento que some e vira fatura
Tem fundamento que desaparece sem fazer barulho e reaparece como custo. Complexidade computacional é o caso clássico. Pega o Fibonacci. Escrito do jeito "natural", copiando a definição recursiva, ele custa cerca de 1,618 elevado a n passos: exponencial. Reescrito com uma tabelinha que guarda o que já foi calculado, custa O(n): linear. Mesmo problema. As duas versões "funcionam" no laptop com n pequeno. Uma delas trava o servidor quando o n cresce.
A tradução pra quem decide é direta. As duas passam no review distraído porque as duas "funcionam". A diferença, invisível pra quem não tem o fundamento, é a diferença entre responder em milissegundos e derrubar a instância no pico. Como resume um livro-texto de algoritmos, "o que realmente importa é o coeficiente de maior ordem" (no original, "What really matters is the highest-order coefficient."). Não é microotimização de constante; é a classe de complexidade, e ela decide se a sua conta de nuvem cresce linear ou quadrática quando o tráfego dobra. Em baixa latência, no hot path de um sistema de trading, isso não é discussão acadêmica: é o p99 estourando na hora errada.
A camada de design tem o mesmo destino. Juval Löwy é taxativo: "A maioria das pessoas decompõe sistemas da pior forma possível" (no original, "Most people decompose systems in the worst possible way"), e o pior jeito é decompor por função, por feature, por "o que o sistema faz". A frase que arremata é a mais dura do livro: "Sistemas projetados fora da área de custo mínimo já fracassaram antes de alguém ter escrito a primeira linha de código" (no original, "Systems designed outside the area of minimum cost have already failed before anyone has written the first line of code."). O fracasso é decidido no desenho, que é exatamente a parte que a IA não faz por você. Gerar código mais rápido sobre uma decomposição errada só acelera a chegada no buraco. O problema quase nunca é a linha; é a fronteira que alguém desenhou errada, ou nem desenhou.
E aqui mora o risco específico da era atual. A IA gera a versão exponencial e a linear com a mesma confiança, com o mesmo tom de "pronto, aqui está". Só quem domina custo computacional sabe qual das duas recusar. Tira essa pessoa da sala e sobra um gerador que produz as duas e não sabe diferenciar.
a bola de lama agora tem número
Até pouco tempo isso era argumento de quem tem cicatriz. Agora tem medição. A GitClear vasculhou centenas de milhões de linhas e achou a digital da erosão: a fatia de código refatorado, reaproveitado, movido pra um lugar melhor, caiu de 25% em 2021 pra menos de 10% em 2024, enquanto blocos duplicados de cinco linhas ou mais cresceram cerca de oito vezes, e o churn, código reescrito em menos de duas semanas, subiu de 3,1% pra 5,7%. Menos reaproveitamento, mais copiar e colar, mais retrabalho. A bola de lama saiu da anedota e virou gráfico.
O lado da segurança é pior. Um estudo de Stanford liderado por Dan Boneh mediu que participantes usando assistente de IA escreveram código significativamente menos seguro, em especial em criptografia e injeção de SQL, e, o detalhe que assusta, ficaram mais propensos a acreditar que o código estava seguro. Menos seguro e mais confiante ao mesmo tempo. A IA não te entrega o fundamento que você não tem; ela tampa o buraco com um sorriso. O antídoto não é proibir a ferramenta; é dar uma espinha a ela, especificar antes de gerar, como defendi em RIP VIBE CODE: Por Que Spec-Driven Development é o Futuro do Desenvolvimento de Software.
o teste é o código
Repara que tudo até aqui é fundamento de construção: nome, responsabilidade, complexidade, decomposição. Mas fundamento, sozinho, ainda é frágil. Saber escrever a classe certa não te impede de quebrá-la na próxima mudança. O que deixa você mudar sem medo é uma rede de segurança, e essa rede tem nome: testes. É o tema do próximo artigo desta série, então fico no gancho: fundamento sem teste é equilibrista sem rede. Já toquei na disciplina em TDD: Repensando a Forma de Desenvolver com Simplicidade e Autonomia, e o caso completo vem no próximo artigo. Funciona, até o dia que não funciona.
Volto pro começo. A distância entre "sei SOLID" e "meu código mostra que sei" é a distância entre a entrevista e o git. Fundamento é o que torna a mudança barata, e mudança barata é o que mantém um produto vivo. Quem não tem, paga: na produtividade que tende a zero, na bagunça que se espalha sozinha, na fatura de nuvem que cresce na classe errada de complexidade, na falha de segurança que ninguém viu.
A IA não muda essa conta. Ela acelera os dois lados: multiplica quem tem fundamento e multiplica o lixo de quem não tem. Por isso a pergunta de quem decide não é "o time sabe SOLID?". É "abre o repositório e me mostra". Você disse que sabe. Seu código é quem responde.
Insights & Takeaways
- Fundamento não é enfeite de currículo; é o que torna a mudança barata. Sem ele, a produtividade tende assintoticamente a zero, e isso é capacidade de entrega do time, não estética.
- "Saber SOLID" se prova no diff, não na entrevista. Reconhecer código limpo não é o mesmo que escrevê-lo sob pressão, e o SRP é o mais citado e o mais violado.
- A IA otimiza os 10% baratos (escrever) e infla os 90% caros (ler e entender). Nome ruim e responsabilidade demais produzem código que "funciona" e ninguém mantém.
- A complexidade errada vira fatura. A mesma solução em versão exponencial e linear parece "código que funciona"; a IA gera as duas com a mesma confiança, e só o fundamento sabe qual recusar.
- A bola de lama agora tem número: a GitClear mostra refatoração caindo e duplicação explodindo; Stanford mostra código de IA menos seguro e com mais falsa confiança.