SOLID: O Guia Definitivo para Código de Qualidade e Design de Software
Os cinco princípios SOLID para devs .NET iniciantes: o problema que cada um resolve, o que dá errado sem ele e exemplos em C# do erro e da correção.
Neste artigo · 8 seções
- Por Que os Princípios SOLID São Essenciais?
- Single Responsibility Principle (SRP) - Princípio da Responsabilidade Única
- Open/Closed Principle (OCP) - Princípio Aberto/Fechado
- Liskov Substitution Principle (LSP) - Princípio da Substituição de Liskov
- Interface Segregation Principle (ISP) - Princípio da Segregação de Interface
- Dependency Inversion Principle (DIP) - Princípio da Inversão de Dependência
- Benefícios Práticos dos Princípios SOLID
- Conclusão: SOLID Como Filosofia de Desenvolvimento
Os princípios SOLID representam um dos pilares fundamentais para a construção de software de qualidade. Criados por Robert C. Martin, também conhecido como "Uncle Bob", no início dos anos 2000, esses cinco princípios não são apenas conceitos teóricos, mas sim diretrizes práticas que transformam a forma como desenvolvemos aplicações orientadas a objetos. Este artigo foi desenvolvido especialmente para desenvolvedores estagiários e juniores da plataforma .NET, mas os conceitos são aplicáveis a qualquer linguagem de programação orientada a objetos.
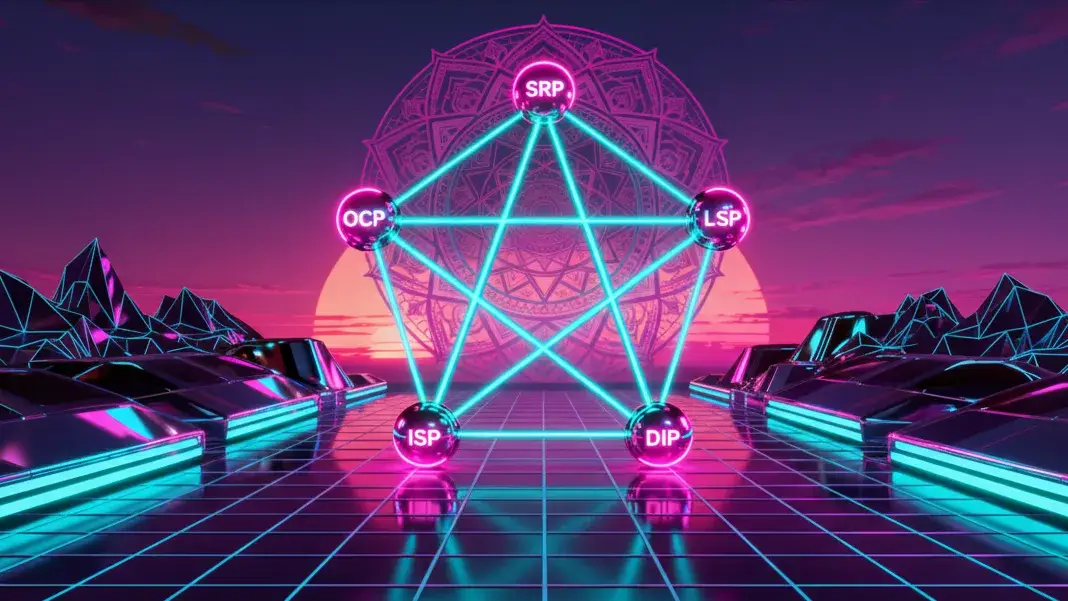
SOLID é um acrônimo onde cada letra representa um princípio fundamental: Single Responsibility Principle (Princípio da Responsabilidade Única), Open/Closed Principle (Princípio Aberto/Fechado), Liskov Substitution Principle (Princípio da Substituição de Liskov), Interface Segregation Principle (Princípio da Segregação de Interface) e Dependency Inversion Principle (Princípio da Inversão de Dependência). Quando aplicados corretamente, esses princípios eliminam problemas comuns no desenvolvimento de software, conhecidos como "code smells" (maus cheiros de código), e promovem a criação de sistemas mais robustos, flexíveis e fáceis de manter.
Por Que os Princípios SOLID São Essenciais?
Antes de mergulharmos em cada princípio individualmente, é crucial compreender o contexto que motivou sua criação e os problemas que eles se propõem a resolver. Robert C. Martin observou que, ao longo do tempo, o software tende a se deteriorar e se tornar cada vez mais difícil de modificar. Essa degradação natural do código acontece por diversos motivos: prazos apertados, falta de planejamento, mudanças frequentes nos requisitos e a falta de boas práticas de desenvolvimento.
O resultado dessa deterioração é o que chamamos de "código espaguete" - um emaranhado confuso de lógica entrelaçada, onde cada modificação se torna uma tarefa arriscada e demorada. Esse tipo de código apresenta características facilmente identificáveis: rigidez (dificuldade extrema de modificação), fragilidade (uma mudança quebra múltiplas partes do sistema), imobilidade (impossibilidade de reutilizar componentes em outros projetos), viscosidade (fazer a coisa errada é mais fácil que fazer a coisa certa) e complexidade desnecessária. Todos esses sintomas indicam um design problemático que, se não tratado, pode levar ao colapso completo da manutenibilidade do sistema.
Os princípios SOLID foram criados especificamente para combater esses problemas. Eles promovem o baixo acoplamento (redução de dependências entre componentes), alta coesão (cada componente faz apenas uma coisa bem-feita), separação de responsabilidades e facilidade de extensão. Ao seguir essas diretrizes, você cria código que é mais fácil de entender, testar, manter e evoluir ao longo do tempo. Além disso, esses princípios facilitam o trabalho em equipe, pois estabelecem um padrão comum de comunicação entre desenvolvedores.
Single Responsibility Principle (SRP) - Princípio da Responsabilidade Única
O Princípio da Responsabilidade Única estabelece que uma classe deve ter apenas uma razão para mudar. Em outras palavras, cada classe deve ter uma única responsabilidade bem definida dentro do sistema. Este princípio é, na verdade, uma perspectiva diferente sobre o conceito fundamental de coesão na programação orientada a objetos.
O Problema que o SRP Resolve
Quando uma classe tem múltiplas responsabilidades, ela se torna difícil de compreender, modificar e reutilizar. Imagine uma classe Pedido que não apenas gerencia os dados do pedido, mas também é responsável por salvá-lo no banco de dados, enviar e-mails de confirmação, gerar relatórios em PDF e calcular impostos. Essa classe viola claramente o SRP, pois tem pelo menos quatro razões distintas para mudar: mudanças na estrutura de dados do pedido, mudanças no mecanismo de persistência, mudanças no sistema de e-mail, mudanças no formato de relatório ou mudanças na legislação tributária.
As consequências dessa violação são graves e se manifestam de várias formas. Primeiro, há o alto acoplamento: a classe tem um número excessivo de dependências, tornando-se frágil e suscetível a mudanças em outras partes do sistema. Segundo, há a dificuldade de manutenção: qualquer desenvolvedor que precise modificar essa classe precisa entender todas as suas responsabilidades, mesmo que precise alterar apenas uma delas. Terceiro, há a impossibilidade de reutilização: se outro sistema precisa apenas da lógica de cálculo de impostos, não é possível reutilizar apenas essa parte sem carregar todo o resto. Quarto, há a dificuldade de teste: testar uma classe com múltiplas responsabilidades requer a configuração de todos os seus aspectos, tornando os testes complexos e lentos.
Exemplo Prático em C#: Violando o SRP
Vamos analisar um exemplo concreto de violação do SRP em C#:
public class GerenciadorPedido
{
    public void ProcessarPedido(Pedido pedido)
    {
        // Responsabilidade 1: Validar o pedido
        if (pedido.Itens.Count == 0)
        {
            throw new Exception("Pedido sem itens");
        }

        // Responsabilidade 2: Calcular totais
        decimal total = 0;
        foreach (var item in pedido.Itens)
        {
            total += item.Preco * item.Quantidade;
        }
        pedido.Total = total;

        // Responsabilidade 3: Salvar no banco de dados
        using (var conexao = new SqlConnection("connection_string"))
        {
            conexao.Open();
            var comando = new SqlCommand(
                "INSERT INTO Pedidos (ClienteId, Total) VALUES (@ClienteId, @Total)",
                conexao);
            comando.Parameters.AddWithValue("@ClienteId", pedido.ClienteId);
            comando.Parameters.AddWithValue("@Total", pedido.Total);
            comando.ExecuteNonQuery();
        }

        // Responsabilidade 4: Enviar e-mail de confirmação
        var emailCliente = new SmtpClient("smtp.servidor.com");
        emailCliente.Send("pedidos@empresa.com",
                          pedido.EmailCliente,
                          "Confirmação de Pedido",
                          $"Seu pedido foi confirmado. Total: {pedido.Total:C}");
    }
}
Neste exemplo, a classe GerenciadorPedido viola flagrantemente o SRP ao ter quatro responsabilidades distintas: validação, cálculo, persistência e notificação. Se precisarmos mudar o banco de dados de SQL Server para PostgreSQL, teremos que modificar esta classe. Se precisarmos alterar o servidor de e-mail, novamente teremos que modificar esta mesma classe. Se as regras de cálculo mudarem, a classe precisa ser alterada novamente. Isso representa um risco enorme de introduzir bugs, pois uma mudança destinada a resolver um problema pode inadvertidamente quebrar outra funcionalidade.
Solução: Aplicando o SRP
Para corrigir essa violação, devemos separar cada responsabilidade em sua própria classe:
// Responsabilidade: Validar pedidos
public class ValidadorPedido
{
    public void Validar(Pedido pedido)
    {
        if (pedido.Itens.Count == 0)
        {
            throw new Exception("Pedido sem itens");
        }
    }
}

// Responsabilidade: Calcular totais
public class CalculadoraPedido
{
    public void CalcularTotal(Pedido pedido)
    {
        decimal total = 0;
        foreach (var item in pedido.Itens)
        {
            total += item.Preco * item.Quantidade;
        }
        pedido.Total = total;
    }
}

// Responsabilidade: Salvar pedidos
public class RepositorioPedido
{
    private readonly string _connectionString;

    public RepositorioPedido(string connectionString)
    {
        _connectionString = connectionString;
    }

    public void Salvar(Pedido pedido)
    {
        using (var conexao = new SqlConnection(_connectionString))
        {
            conexao.Open();
            var comando = new SqlCommand(
                "INSERT INTO Pedidos (ClienteId, Total) VALUES (@ClienteId, @Total)",
                conexao);
            comando.Parameters.AddWithValue("@ClienteId", pedido.ClienteId);
            comando.Parameters.AddWithValue("@Total", pedido.Total);
            comando.ExecuteNonQuery();
        }
    }
}

// Responsabilidade: Enviar notificações
public class NotificadorEmail
{
    private readonly string _servidorSmtp;

    public NotificadorEmail(string servidorSmtp)
    {
        _servidorSmtp = servidorSmtp;
    }

    public void EnviarConfirmacao(Pedido pedido)
    {
        var emailCliente = new SmtpClient(_servidorSmtp);
        emailCliente.Send("pedidos@empresa.com",
                          pedido.EmailCliente,
                          "Confirmação de Pedido",
                          $"Seu pedido foi confirmado. Total: {pedido.Total:C}");
    }
}

// Orquestração: Coordena as responsabilidades
public class ServiçoPedido
{
    private readonly ValidadorPedido _validador;
    private readonly CalculadoraPedido _calculadora;
    private readonly RepositorioPedido _repositorio;
    private readonly NotificadorEmail _notificador;

    public ServiçoPedido(
        ValidadorPedido validador,
        CalculadoraPedido calculadora,
        RepositorioPedido repositorio,
        NotificadorEmail notificador)
    {
        _validador = validador;
        _calculadora = calculadora;
        _repositorio = repositorio;
        _notificador = notificador;
    }

    public void ProcessarPedido(Pedido pedido)
    {
        _validador.Validar(pedido);
        _calculadora.CalcularTotal(pedido);
        _repositorio.Salvar(pedido);
        _notificador.EnviarConfirmacao(pedido);
    }
}
Agora, cada classe tem uma única razão para mudar. Se precisarmos alterar a forma como salvamos pedidos, modificamos apenas RepositorioPedido. Se o servidor de e-mail mudar, alteramos apenas NotificadorEmail. Cada classe é pequena, focada e fácil de entender. Além disso, podemos testar cada responsabilidade isoladamente, o que torna os testes mais simples e rápidos.
Open/Closed Principle (OCP) - Princípio Aberto/Fechado
O Princípio Aberto/Fechado estabelece que entidades de software (classes, módulos, funções) devem estar abertas para extensão, mas fechadas para modificação. Isso significa que devemos ser capazes de adicionar novas funcionalidades ao sistema sem alterar o código existente que já funciona e foi testado.
O Problema que o OCP Resolve
Quando precisamos modificar código existente toda vez que queremos adicionar uma nova funcionalidade, corremos o risco de introduzir bugs em partes do sistema que antes funcionavam perfeitamente. Imagine um sistema de cálculo de frete que inicialmente suporta apenas entrega normal. Quando surge a necessidade de adicionar entrega expressa, entrega agendada e entrega internacional, se tivermos que modificar a classe original a cada vez, estaremos violando o OCP e aumentando exponencialmente o risco de quebrar funcionalidades existentes.
As consequências dessa violação foram documentadas em um caso real onde um desenvolvedor modificou o retorno de uma função usada em 13 endpoints diferentes. Sem perceber o impacto, ele quebrou todos os 13 endpoints simultaneamente, causando instabilidade massiva no sistema. Esse é um exemplo clássico de como a violação do OCP pode causar efeitos em cascata devastadores. Outras consequências incluem: necessidade de reescrever testes existentes, impossibilidade de reutilizar código em diferentes contextos, aumento do tempo de desenvolvimento e dificuldade de manter contratos estabelecidos com outras partes do sistema.
Exemplo Prático em C#: Violando o OCP
Vejamos um exemplo típico de violação do OCP:
public enum TipoFrete
{
    Normal,
    Expresso,
    Agendado
}

public class CalculadoraFrete
{
    public decimal CalcularFrete(decimal peso, TipoFrete tipo)
    {
        if (tipo == TipoFrete.Normal)
        {
            return peso * 5.00m;
        }
        else if (tipo == TipoFrete.Expresso)
        {
            return peso * 10.00m;
        }
        else if (tipo == TipoFrete.Agendado)
        {
            return peso * 7.50m;
        }

        throw new NotImplementedException("Tipo de frete não suportado");
    }
}
Este código viola o OCP porque, toda vez que precisarmos adicionar um novo tipo de frete (como "Internacional" ou "Same Day"), teremos que modificar a classe CalculadoraFrete. Isso significa reabrir uma classe testada e funcional, adicionar mais condicionais (aumentando a complexidade ciclomática), reescrever os testes e correr o risco de introduzir bugs nas lógicas já existentes.
Solução: Aplicando o OCP
Para aderir ao OCP, utilizamos polimorfismo e abstrações:
// Abstração que define o contrato
public interface ICalculadoraFrete
{
    decimal CalcularFrete(decimal peso);
}

// Implementação para frete normal
public class FreteNormal : ICalculadoraFrete
{
    public decimal CalcularFrete(decimal peso)
    {
        return peso * 5.00m;
    }
}

// Implementação para frete expresso
public class FreteExpresso : ICalculadoraFrete
{
    public decimal CalcularFrete(decimal peso)
    {
        return peso * 10.00m;
    }
}

// Implementação para frete agendado
public class FreteAgendado : ICalculadoraFrete
{
    public decimal CalcularFrete(decimal peso)
    {
        return peso * 7.50m;
    }
}

// Nova implementação para frete internacional - SEM modificar código existente
public class FreteInternacional : ICalculadoraFrete
{
    public decimal CalcularFrete(decimal peso)
    {
        return peso * 25.00m;
    }
}

// Classe que utiliza a calculadora
public class ServiçoEntrega
{
    private readonly ICalculadoraFrete _calculadora;

    public ServiçoEntrega(ICalculadoraFrete calculadora)
    {
        _calculadora = calculadora;
    }

    public decimal ObterCustoFrete(decimal peso)
    {
        return _calculadora.CalcularFrete(peso);
    }
}

// Uso
var servicoNormal = new ServiçoEntrega(new FreteNormal());
var custoNormal = servicoNormal.ObterCustoFrete(10);

var servicoExpresso = new ServiçoEntrega(new FreteExpresso());
var custoExpresso = servicoExpresso.ObterCustoFrete(10);

var servicoInternacional = new ServiçoEntrega(new FreteInternacional());
var custoInternacional = servicoInternacional.ObterCustoFrete(10);
Agora, quando precisamos adicionar um novo tipo de frete, simplesmente criamos uma nova classe que implementa ICalculadoraFrete. O código existente permanece intocado, não há necessidade de reescrever testes, e o risco de introduzir bugs é praticamente eliminado. A classe está fechada para modificação (não alteramos código existente) mas aberta para extensão (podemos adicionar novos comportamentos criando novas implementações).
Liskov Substitution Principle (LSP) - Princípio da Substituição de Liskov
O Princípio da Substituição de Liskov, formulado pela cientista da computação Barbara Liskov em 1987, estabelece que objetos de uma classe derivada devem poder substituir objetos da classe base sem alterar a correção do programa. Em termos mais simples: se seu código funciona com a classe pai, ele também deve funcionar com qualquer classe filha, sem surpresas ou comportamentos inesperados.
O Problema que o LSP Resolve
Quando uma subclasse não consegue substituir adequadamente sua classe base, o comportamento do sistema se torna imprevisível e propenso a erros. O código cliente que espera um comportamento específico da classe base pode receber resultados completamente diferentes quando uma subclasse é usada, levando a bugs sutis e difíceis de rastrear.
O exemplo clássico que ilustra a violação do LSP é o problema do Retângulo-Quadrado. Matematicamente, um quadrado é um retângulo (todos os quadrados são retângulos). No entanto, em termos de comportamento de software, essa relação de herança causa problemas sérios. As consequências da violação incluem: comportamento inesperado ao substituir classes, violação de contratos estabelecidos, necessidade de verificações de tipo em tempo de execução (usando instanceof ou is), e erros que aparecem apenas em situações específicas, tornando-os difíceis de reproduzir e corrigir.
Exemplo Prático em C#: Violando o LSP
Vejamos o famoso exemplo do Retângulo-Quadrado:
public class Retangulo
{
    public virtual int Largura { get; set; }
    public virtual int Altura { get; set; }

    public int CalcularArea()
    {
        return Largura * Altura;
    }
}

public class Quadrado : Retangulo
{
    // Violação: modificamos o comportamento para manter largura = altura
    public override int Largura
    {
        get { return base.Largura; }
        set
        {
            base.Largura = value;
            base.Altura = value;  // Efeito colateral inesperado!
        }
    }

    public override int Altura
    {
        get { return base.Altura; }
        set
        {
            base.Altura = value;
            base.Largura = value;  // Efeito colateral inesperado!
        }
    }
}

// Código cliente que espera comportamento de Retangulo
public void TestarRetangulo(Retangulo r)
{
    r.Largura = 5;
    r.Altura = 10;

    // Esperamos que a área seja 50 (5 * 10)
    Assert.AreEqual(50, r.CalcularArea());
}

// Uso
var retangulo = new Retangulo();
TestarRetangulo(retangulo);  // Funciona! Área = 50

var quadrado = new Quadrado();
TestarRetangulo(quadrado);  // FALHA! Área = 100, não 50!
O problema aqui é que Quadrado não pode substituir Retangulo sem quebrar a expectativa do código cliente. Quando definimos a largura como 5, esperamos que apenas a largura mude. No entanto, o Quadrado modifica também a altura, violando a expectativa estabelecida pela classe base. Este é um exemplo perfeito de violação do LSP: a subclasse não é verdadeiramente substituível pela classe base.
Solução: Aplicando o LSP
Para respeitar o LSP, devemos redesenhar a hierarquia de classes:
// Abstração comum
public interface IForma
{
    int CalcularArea();
}

// Retângulo como implementação independente
public class Retangulo : IForma
{
    public int Largura { get; set; }
    public int Altura { get; set; }

    public int CalcularArea()
    {
        return Largura * Altura;
    }
}

// Quadrado como implementação independente
public class Quadrado : IForma
{
    public int Lado { get; set; }

    public int CalcularArea()
    {
        return Lado * Lado;
    }
}

// Código cliente trabalha com a abstração
public void CalcularAreaTotal(List<IForma> formas)
{
    int total = 0;
    foreach (var forma in formas)
    {
        total += forma.CalcularArea();
    }
    return total;
}

// Uso - ambos podem ser usados intercambiavelmente
var formas = new List<IForma>
{
    new Retangulo { Largura = 5, Altura = 10 },
    new Quadrado { Lado = 5 }
};

var areaTotal = CalcularAreaTotal(formas);  // Funciona perfeitamente!
Agora, tanto Retangulo quanto Quadrado implementam a interface IForma sem violar expectativas de comportamento. Cada classe mantém sua própria semântica: retângulos têm largura e altura independentes, quadrados têm apenas um lado. Não há relação de herança problemática, e o código cliente pode trabalhar com qualquer implementação de IForma sem surpresas.
Interface Segregation Principle (ISP) - Princípio da Segregação de Interface
O Princípio da Segregação de Interface estabelece que clientes não devem ser forçados a depender de interfaces que não usam. Em vez de criar interfaces grandes e genéricas (conhecidas como "fat interfaces"), devemos criar múltiplas interfaces menores e mais específicas, cada uma atendendo a um conjunto coeso de funcionalidades.
O Problema que o ISP Resolve
Quando criamos interfaces muito amplas, forçamos as classes implementadoras a fornecer implementações para métodos que podem não fazer sentido no seu contexto. Isso leva a classes poluídas com métodos vazios, métodos que lançam NotImplementedException, ou implementações "fake" que apenas satisfazem o compilador mas não têm significado real.
Um exemplo clássico vem da própria biblioteca .NET: antes do .NET 4.5, desenvolvedores eram forçados a usar IList<T> mesmo quando precisavam apenas de acesso somente leitura a uma coleção. Isso significava que métodos como Add() e Remove() estavam disponíveis mesmo quando não faziam sentido. A Microsoft reconheceu essa violação do ISP e introduziu IReadOnlyList<T>, segregando a interface em uma versão mais específica. As consequências da violação incluem: implementação de métodos desnecessários que poluem a classe, potencial para uso incorreto (chamando métodos que não deveriam existir), dificuldade de compreensão (qual método realmente faz parte da responsabilidade da classe?) e violação do SRP indiretamente.
Exemplo Prático em C#: Violando o ISP
Vejamos um exemplo de uma interface que viola o ISP:
// Interface muito ampla - viola ISP
public interface IImpressora
{
    void Imprimir(string documento);
    void Escanear(string documento);
    void Enviarfax(string documento);
    void ImprimirDuplex(string documento);
}

// Impressora multifuncional - sem problemas
public class ImpressoraMultifuncional : IImpressora
{
    public void Imprimir(string documento)
    {
        Console.WriteLine($"Imprimindo: {documento}");
    }

    public void Escanear(string documento)
    {
        Console.WriteLine($"Escaneando: {documento}");
    }

    public void Enviarfax(string documento)
    {
        Console.WriteLine($"Enviando fax: {documento}");
    }

    public void ImprimirDuplex(string documento)
    {
        Console.WriteLine($"Imprimindo duplex: {documento}");
    }
}

// Impressora básica - PROBLEMA! Forçada a implementar métodos que não usa
public class ImpressoraBasica : IImpressora
{
    public void Imprimir(string documento)
    {
        Console.WriteLine($"Imprimindo: {documento}");
    }

    // Métodos forçados que não fazem sentido para impressora básica
    public void Escanear(string documento)
    {
        throw new NotImplementedException("Esta impressora não suporta escaneamento");
    }

    public void Enviarfax(string documento)
    {
        throw new NotImplementedException("Esta impressora não suporta fax");
    }

    public void ImprimirDuplex(string documento)
    {
        throw new NotImplementedException("Esta impressora não suporta impressão duplex");
    }
}
Neste exemplo, ImpressoraBasica é forçada a implementar métodos que não fazem parte de suas capacidades. Isso é um sinal claro de violação do ISP. Além disso, o código cliente agora precisa lidar com exceções NotImplementedException, o que indica um design problemático.
Solução: Aplicando o ISP
Para respeitar o ISP, segregamos a interface grande em interfaces menores e mais específicas:
// Interfaces segregadas - cada uma com responsabilidade específica
public interface IImpressao
{
    void Imprimir(string documento);
}

public interface IEscaneamento
{
    void Escanear(string documento);
}

public interface IFax
{
    void EnviarFax(string documento);
}

public interface IImpressaoDuplex
{
    void ImprimirDuplex(string documento);
}

// Impressora básica - implementa apenas o que precisa
public class ImpressoraBasica : IImpressao
{
    public void Imprimir(string documento)
    {
        Console.WriteLine($"Imprimindo: {documento}");
    }
}

// Impressora avançada - implementa mais funcionalidades
public class ImpressoraAvancada : IImpressao, IImpressaoDuplex
{
    public void Imprimir(string documento)
    {
        Console.WriteLine($"Imprimindo: {documento}");
    }

    public void ImprimirDuplex(string documento)
    {
        Console.WriteLine($"Imprimindo duplex: {documento}");
    }
}

// Impressora multifuncional - implementa todas as interfaces
public class ImpressoraMultifuncional : IImpressao, IEscaneamento, IFax, IImpressaoDuplex
{
    public void Imprimir(string documento)
    {
        Console.WriteLine($"Imprimindo: {documento}");
    }

    public void Escanear(string documento)
    {
        Console.WriteLine($"Escaneando: {documento}");
    }

    public void EnviarFax(string documento)
    {
        Console.WriteLine($"Enviando fax: {documento}");
    }

    public void ImprimirDuplex(string documento)
    {
        Console.WriteLine($"Imprimindo duplex: {documento}");
    }
}

// Código cliente usa apenas a interface que precisa
public class GerenciadorImpressao
{
    private readonly IImpressao _impressora;

    public GerenciadorImpressao(IImpressao impressora)
    {
        _impressora = impressora;
    }

    public void ImprimirDocumento(string documento)
    {
        _impressora.Imprimir(documento);
    }
}

// Uso
var basica = new ImpressoraBasica();
var gerenciador = new GerenciadorImpressao(basica);
gerenciador.ImprimirDocumento("Documento.pdf");  // Funciona perfeitamente!
Agora, cada classe implementa apenas as interfaces que realmente fazem sentido para ela. Não há métodos vazios, não há exceções NotImplementedException, e o código é muito mais claro e seguro. O cliente (GerenciadorImpressao) depende apenas da interface IImpressao, não sendo afetado por funcionalidades que não precisa.
Dependency Inversion Principle (DIP) - Princípio da Inversão de Dependência
O Princípio da Inversão de Dependência é o último e talvez mais poderoso dos princípios SOLID. Ele estabelece que módulos de alto nível não devem depender de módulos de baixo nível. Ambos devem depender de abstrações. Além disso, abstrações não devem depender de detalhes. Detalhes devem depender de abstrações.
O Problema que o DIP Resolve
Quando módulos de alto nível (que contêm a lógica de negócio e as políticas importantes) dependem diretamente de módulos de baixo nível (detalhes de implementação como acesso a banco de dados, sistemas de arquivos, APIs externas), criamos um acoplamento rígido que torna o sistema inflexível, difícil de testar e impossível de reutilizar em diferentes contextos.
Imagine um sistema de processamento de pagamentos que depende diretamente da implementação do PayPal. Quando surge a necessidade de adicionar suporte para Stripe, toda a lógica de negócio precisa ser modificada. Isso viola o OCP e torna o sistema frágil. As consequências da violação do DIP incluem: impossibilidade de testar componentes isoladamente (você precisa de um banco de dados real, um servidor de e-mail real, etc.), dificuldade de reutilizar módulos de alto nível em outros contextos, rigidez no design (mudanças em implementações de baixo nível afetam toda a cadeia de dependências) e violação do OCP (adicionar novas implementações requer modificar código existente).
Exemplo Prático em C#: Violando o DIP
Vejamos um exemplo típico de violação do DIP:
// Módulo de baixo nível - implementação concreta
public class MySQLDatabase
{
    public void SalvarDados(string dados)
    {
        Console.WriteLine($"Salvando no MySQL: {dados}");
        // Lógica específica do MySQL
    }
}

// Módulo de alto nível - DEPENDE DIRETAMENTE da implementação concreta
public class ServicoCliente
{
    private readonly MySQLDatabase _database;

    public ServicoCliente()
    {
        _database = new MySQLDatabase();  // Acoplamento rígido!
    }

    public void CriarCliente(string nome)
    {
        // Lógica de negócio
        var dados = $"Cliente: {nome}";

        // Depende diretamente de MySQLDatabase
        _database.SalvarDados(dados);
    }
}
Este código viola o DIP porque ServicoCliente (módulo de alto nível) depende diretamente de MySQLDatabase (módulo de baixo nível). Se quisermos mudar para PostgreSQL ou MongoDB, teremos que modificar ServicoCliente. Além disso, testar ServicoCliente isoladamente é impossível - sempre precisaremos de uma instância real de MySQLDatabase.
Solução: Aplicando o DIP
Para respeitar o DIP, introduzimos uma abstração entre os módulos de alto e baixo nível:
// Abstração - não depende de detalhes de implementação
public interface IDatabase
{
    void SalvarDados(string dados);
}

// Módulo de baixo nível - implementação concreta do MySQL
public class MySQLDatabase : IDatabase
{
    public void SalvarDados(string dados)
    {
        Console.WriteLine($"Salvando no MySQL: {dados}");
        // Lógica específica do MySQL
    }
}

// Módulo de baixo nível - implementação concreta do PostgreSQL
public class PostgreSQLDatabase : IDatabase
{
    public void SalvarDados(string dados)
    {
        Console.WriteLine($"Salvando no PostgreSQL: {dados}");
        // Lógica específica do PostgreSQL
    }
}

// Módulo de baixo nível - implementação para testes
public class InMemoryDatabase : IDatabase
{
    public List<string> Dados { get; } = new List<string>();

    public void SalvarDados(string dados)
    {
        Dados.Add(dados);
        Console.WriteLine($"Salvando em memória: {dados}");
    }
}

// Módulo de alto nível - DEPENDE DA ABSTRAÇÃO, não da implementação
public class ServicoCliente
{
    private readonly IDatabase _database;

    // Injeção de dependência - recebe a abstração
    public ServicoCliente(IDatabase database)
    {
        _database = database;
    }

    public void CriarCliente(string nome)
    {
        // Lógica de negócio
        var dados = $"Cliente: {nome}";

        // Usa a abstração, não sabe qual implementação concreta está sendo usada
        _database.SalvarDados(dados);
    }
}

// Uso - podemos trocar implementações facilmente
var servicoComMySQL = new ServicoCliente(new MySQLDatabase());
servicoComMySQL.CriarCliente("João");

var servicoComPostgreSQL = new ServicoCliente(new PostgreSQLDatabase());
servicoComPostgreSQL.CriarCliente("Maria");

// Em testes - usamos implementação em memória
var servicoParaTestes = new ServicoCliente(new InMemoryDatabase());
servicoParaTestes.CriarCliente("Teste");
Agora, ServicoCliente depende apenas da abstração IDatabase. Podemos trocar a implementação concreta sem modificar uma linha sequer de ServicoCliente. Nos testes, podemos usar InMemoryDatabase para testar a lógica de negócio isoladamente, sem necessidade de um banco de dados real. Este é o poder do DIP: desacoplar módulos de alto nível dos detalhes de implementação de baixo nível.
Benefícios Práticos dos Princípios SOLID
Quando aplicados corretamente e em conjunto, os princípios SOLID transformam radicalmente a qualidade do código e a produtividade da equipe de desenvolvimento. Vamos explorar os benefícios concretos e mensuráveis que essas práticas trazem.
Manutenibilidade e Evolução do Sistema
O benefício mais imediato e tangível dos princípios SOLID é a melhoria drástica na manutenibilidade do código. Código que segue SOLID é mais fácil de ler, entender e modificar. Cada classe tem uma responsabilidade clara (SRP), as modificações são feitas por extensão e não por alteração (OCP), as hierarquias de herança são consistentes (LSP), as interfaces são enxutas e focadas (ISP), e as dependências são desacopladas através de abstrações (DIP). Isso significa que, quando um bug é encontrado ou uma nova feature precisa ser implementada, o desenvolvedor consegue localizar rapidamente onde fazer as mudanças, entender o impacto dessas mudanças e implementá-las com confiança mínima de quebrar outras partes do sistema.
Testabilidade e Qualidade
Os princípios SOLID, especialmente o DIP, tornam o código extremamente testável. Quando as dependências são injetadas através de abstrações, podemos facilmente substituir implementações reais por mocks ou stubs durante os testes. Isso permite testar cada componente isoladamente, sem necessidade de configurar bancos de dados reais, servidores de e-mail ou APIs externas. Classes que seguem o SRP são naturalmente mais fáceis de testar porque fazem apenas uma coisa, reduzindo a complexidade dos cenários de teste. O resultado é uma suite de testes mais rápida, mais confiável e mais abrangente, o que leva a um software de maior qualidade com menos bugs chegando à produção.
Redução da Dívida Técnica
A dívida técnica é o custo acumulado de decisões de design ruins ou atalhos tomados durante o desenvolvimento. Código que viola os princípios SOLID acumula dívida técnica rapidamente: cada nova feature fica mais difícil de implementar, cada bug fica mais difícil de corrigir, e eventualmente o sistema atinge um ponto onde qualquer mudança se torna arriscada e cara. Ao seguir SOLID desde o início, você previne essa acumulação de dívida técnica. O código permanece limpo, organizado e flexível mesmo conforme o sistema cresce em tamanho e complexidade. Isso significa menos tempo gasto em refatorações massivas, menos bugs relacionados a efeitos colaterais inesperados, e uma base de código que permanece produtiva por anos, não por meses.
Colaboração em Equipe
Os princípios SOLID estabelecem um vocabulário comum e um conjunto de expectativas compartilhadas entre desenvolvedores. Quando toda a equipe entende e aplica esses princípios, a colaboração se torna muito mais eficiente. Um desenvolvedor pode pegar o código escrito por outro e entendê-lo rapidamente porque segue padrões conhecidos e estabelecidos. Code reviews ficam mais produtivos porque há critérios objetivos para avaliar a qualidade do design. Novos membros da equipe conseguem se integrar mais rapidamente porque o código segue princípios universalmente reconhecidos.
Escalabilidade e Reutilização
Código que segue SOLID é naturalmente mais modular e reutilizável. Classes com responsabilidade única (SRP) podem ser facilmente extraídas e reutilizadas em outros projetos. Abstrações bem definidas (DIP) permitem que módulos de alto nível sejam reutilizados com diferentes implementações de baixo nível. Extensibilidade através de polimorfismo (OCP) significa que você pode adicionar novas funcionalidades sem reescrever código existente. Tudo isso contribui para um ecossistema de software mais escalável, onde componentes podem ser combinados e recombinados de formas novas e criativas.
Conclusão: SOLID Como Filosofia de Desenvolvimento
Os princípios SOLID não são apenas um conjunto de regras técnicas a serem seguidas mecanicamente - eles representam uma filosofia completa de desenvolvimento de software. Eles refletem décadas de experiência coletiva da comunidade de engenharia de software, destilada em cinco diretrizes fundamentais que, quando aplicadas com discernimento, levam a sistemas mais robustos, flexíveis e sustentáveis.
É importante entender que SOLID são princípios, não leis absolutas. Há situações onde aplicar rigorosamente todos os princípios pode levar a over-engineering (excesso de engenharia) e complexidade desnecessária. O segredo está em usar bom senso e entender o contexto do seu projeto. Para aplicações pequenas e de curta duração, alguns princípios podem ser relaxados. Para sistemas grandes e de longo prazo que exigem manutenibilidade e escalabilidade, SOLID se torna absolutamente essencial.
Para desenvolvedores estagiários e juniores, dominar os princípios SOLID é um diferencial competitivo importante. Eles demonstram maturidade técnica e compreensão profunda de design de software orientado a objetos. Mais importante ainda, eles fornecem ferramentas práticas para escrever código do qual você pode se orgulhar - código que é claro, testável, mantível e que outros desenvolvedores vão agradecer por trabalhar com ele.
Comece aplicando um princípio de cada vez. Pratique o SRP primeiro, garantindo que suas classes tenham uma única responsabilidade. Depois, incorpore o OCP usando polimorfismo e abstrações. Gradualmente, adicione LSP, ISP e DIP ao seu toolkit. Com o tempo e a prática, esses princípios se tornarão segunda natureza, e você naturalmente escreverá código de melhor qualidade sem precisar pensar conscientemente sobre cada princípio.
Lembre-se: código limpo não é sobre perfeição, mas sobre intenção. É sobre se importar com a qualidade do seu trabalho, respeitar os desenvolvedores que virão depois de você (incluindo você mesmo no futuro), e construir software que resista ao teste do tempo. Os princípios SOLID são sua bússola nessa jornada - use-os sabiamente e você construirá sistemas dos quais poderá se orgulhar.