Código nunca foi commodity · Episódio 5
Testes não são burocracia. São a sua apólice.
Teste é apólice, não custo: resistência à refatoração, cobertura como métrica de vaidade e o teste como oráculo independente do código gerado por IA.
Neste artigo · 7 seções
Reunião de priorização. Alguém pergunta o prazo, o time responde, e vem a frase, dita com o tom de quem está sendo maduro sobre trade-off: "não vai dar tempo de testar, a gente testa depois". Todo mundo balança a cabeça. Parece gestão responsável de escopo. É o contrário.
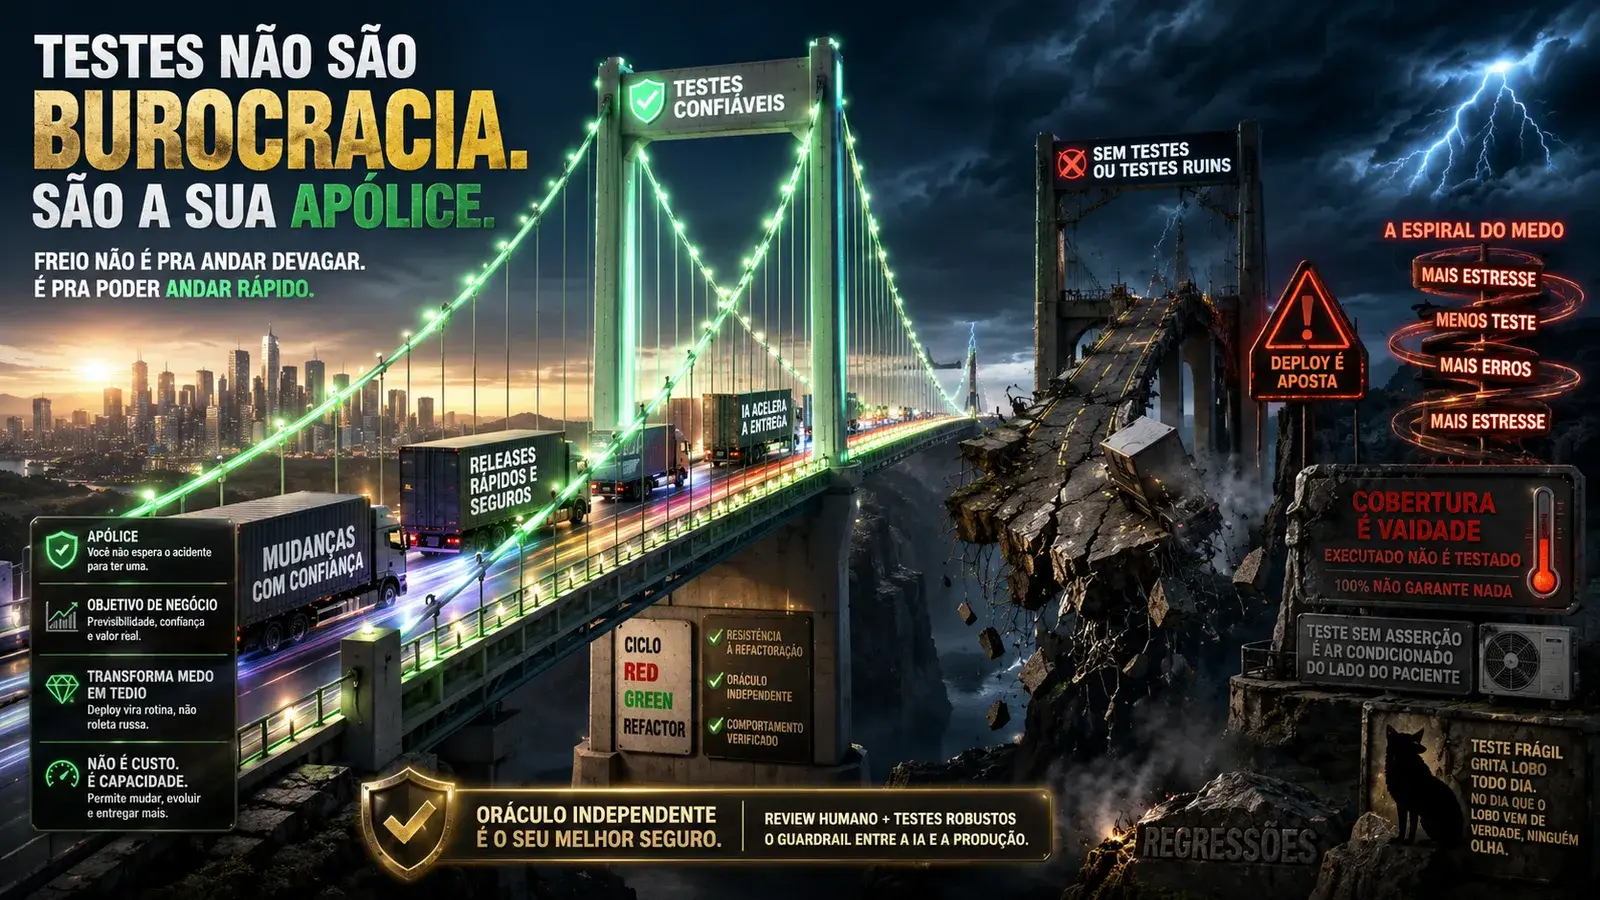
"Não tem tempo pra teste" é o mesmo que "não tem tempo pra freio". E freio não existe pra você andar devagar. Existe pra você poder andar rápido. Tira o freio do carro e você não anda mais depressa. Anda até a primeira curva.
No artigo anterior desta série, Você disse que sabe SOLID. Seu código diz que não., fiquei devendo: fundamento sem teste é equilibrista sem rede. Aqui está o caso completo. Teste é a rede que deixa o time mudar com confiança. Sem ela, todo deploy é aposta. E com a IA cuspindo volume de código como nunca, a rede parou de ser luxo de time maduro e virou pré-condição pra deixar a máquina chegar perto da produção.
clean code that works é objetivo de negócio
Kent Beck abre o TDD by Example com um objetivo que não é técnico: "Código limpo que funciona... é o objetivo do Desenvolvimento Guiado por Testes" (no original, "Clean code that works... is the goal of Test-Driven Development"). A frase "código limpo que funciona" é de Ron Jeffries, adotada por Beck como meta. Parece slogan de engenheiro, mas é objetivo de negócio disfarçado: previsibilidade de quando a coisa está pronta, e um time que confia no próprio código o suficiente pra mudá-lo sem rezar.
A primeira história do livro fala a língua de quem decide: dinheiro. A WyCash era um sistema financeiro que precisava passar a suportar múltiplas moedas, e o design não aguentava. Numa base frágil, seria projeto de meses. Com uma suíte de testes confiável dando cobertura, o time de Ward Cunningham estendeu a fundação em dois dias. Beck resume o efeito no negócio: "Em dois dias, o mercado potencial foi multiplicado várias vezes, multiplicando o valor da WyCash várias vezes. A capacidade de criar tanto valor de negócio tão rápido, porém, não foi acidente" (no original, "In two days, the potential market was multiplied several fold, multiplying the value of WyCash several fold. The ability to create so much business value so quickly was no accident, however."). Não foi sorte. Foi talento, experiência e disciplina, e uma rede de testes que transformou uma reescrita arriscada em trabalho de dois dias.
Essa disciplina tem uma mecânica concreta, o ciclo red-green-refactor, que já destrinchei em TDD: Repensando a Forma de Desenvolver com Simplicidade e Autonomia. O foco aqui não é a mecânica. É o que ela compra: virar uma mudança grande em dias, não em meses, sem detonar o que já funcionava. Chamar isso de custo é ler a conta ao contrário.
a espiral do medo
Beck tem a melhor imagem do livro pra isso: "Testes são a Pedra Filosofal do Programador, transmutando medo em tédio" (no original, "Tests are the Programmer's Stone, transmuting fear into boredom."). A pedra transformava chumbo em ouro; o teste transforma medo em tédio, e tédio, na hora do deploy, é exatamente o que você quer sentir.
Sem essa rede, roda um loop que todo diretor já viu numa crise de produção: "Quanto mais estresse você sente, menos testes você faz. Quanto menos testes você faz, mais erros você comete" (no original, "The more stress you feel, the less testing you will do. The less testing you do, the more errors you will make."). Mais erro, mais estresse, menos teste ainda. A espiral aperta sozinha, e sempre no pior momento, quando a pressão já está no talo.
A coragem do time pra subir uma mudança no pico não vem de pep talk nem do temperamento do sênior. Vem da suíte. Em bolsa, banco ou exchange isso é literal: subir sem rede é apostar com dinheiro de cliente na mesa. Ninguém tem coragem pra isso. Tem inconsequência.
ter teste não basta
Beck te vende a rede. Vladimir Khorikov, no Unit Testing, avisa que rede mal esticada derruba o equilibrista do mesmo jeito. Ele é seco sobre a ilusão de que ter qualquer teste já resolve: "O resultado final para projetos com testes ruins ou sem testes é o mesmo: estagnação ou um monte de regressões a cada novo release" (no original, "The end result for projects with bad tests or no tests is the same: either stagnation or a lot of regressions with every new release."). Teste ruim e nenhum teste chegam no mesmo lugar. Deixa essa assentar antes de aprovar a próxima meta de cobertura.
O atributo que separa um do outro é a resistência à refatoração: "o grau em que um teste consegue sustentar uma refatoração do código de aplicação sem ficar vermelho, ou seja, sem falhar" (no original, "Resistance to refactoring is the degree to which a test can sustain a refactoring of the underlying application code without turning red (failing)."). Você mexe na tripa do código sem mudar o comportamento, e o teste continua verde. Se ele fica vermelho só porque você renomeou um método, não está testando comportamento; está testando implementação. Khorikov trata esse atributo como inegociável, e binário: ou o teste te deixa mudar a estrutura, ou vira freio de mão puxado.
E teste que dispara à toa tem um custo que ninguém coloca na planilha: treina o time a ignorar. Khorikov descreve o efeito: "depois de um tempo, você começa a ignorar as falhas legítimas também, deixando que escorreguem pra produção" (no original, "After a while, you start ignoring legitimate failures, too, allowing them to slip into production."). É o menino que gritou lobo. O teste frágil grita lobo toda semana por um refactor inocente, o time aprende a silenciar o vermelho no reflexo, e no dia que o lobo aparece de verdade ninguém olha. Rede que dispara sozinha o tempo todo não é rede. É barulho que o time desliga.
cobertura é métrica de vaidade
Aí entra a métrica que todo board adora porque cabe num slide: cobertura de testes. É o exemplo perfeito de métrica de vaidade. Khorikov não deixa dúvida: "mesmo 100% de cobertura não é garantia de que você tem uma suíte de testes de boa qualidade" (no original, "even 100% coverage isn't a guarantee that you have a good-quality test suite."). O motivo é simples: cobertura mede linha executada, não comportamento verificado. Executado não é testado. Como indicador negativo ela serve, número baixo denuncia buraco; como positivo é péssima, número alto não prova nada.
Khorikov conta um causo que devia estar em todo treinamento de gestão. Uma empresa impôs, de cima pra baixo, meta de 100% de cobertura. Resultado: "os desenvolvedores começaram a buscar formas de burlar o sistema" (no original, "developers started to seek ways to game the system."). Passaram a escrever testes que executam o código sem nenhuma asserção, embrulhados num try/catch que engole qualquer erro. O teste nunca falha, a linha conta como coberta, o número bate 100%, e não se verifica nada. Meta cumprida, objetivo traído. Quando você transforma o indicador em meta, o time otimiza o indicador, nunca o objetivo.
A analogia dele é médica e cruel: um hospital que mede a saúde do paciente pela temperatura no termômetro, e faz de "baixar o número" a meta, pode acabar com "a solução rápida e 'eficiente' de instalar um ar-condicionado do lado do paciente" (no original, "the hospital might end up with the quick and 'efficient' solution of installing an air conditioner next to the patient."). O termômetro melhora, o paciente continua doente. Cobertura de 100% com teste sem asserção é o ar-condicionado do lado do paciente.
Khorikov escreveu isso em 2020, sobre cobertura, sem falar de IA; a ponte é minha, e o mecanismo é idêntico. Já tem time medindo "produtividade de IA" por linha gerada. Mesma armadilha, sinal trocado: linha gerada não é problema resolvido, igual a linha executada não é comportamento testado. Você faz do volume uma meta e ganha volume; o objetivo, software que funciona e evolui barato, fica pra trás.
a IA precisa de um oráculo que não seja ela mesma
Beck escreveu em 2002, Khorikov em 2020; nenhum dos dois viu um assistente de código na vida. O que vem agora é ponte minha, não opinião deles. O curioso é que esses princípios envelheceram ao contrário: valem mais hoje do que no dia em que foram impressos.
Lembra do estudo de Stanford que citei no artigo anterior? Participantes com assistente de IA escreveram código mensuravelmente menos seguro e, o detalhe que devia assustar quem decide, ficaram mais convictos de que estava seguro. Menos seguro e mais confiante. A IA não te entrega o julgamento que você não tem; te entrega certeza, que é pior. O antídoto pra falsa confiança tem nome antigo: um oráculo independente de quem gerou a resposta. Em software, esse oráculo é o teste. A segunda opinião que não confia na primeira.
Só que aqui mora uma armadilha nova. Se você pede pra IA gerar o código e pra mesma IA, da mesma ideia, gerar o teste, você não tem oráculo independente. Tem eco. O teste concorda com o código porque nasceu da mesma cabeça, com o mesmo erro embutido nos dois. Khorikov já tinha descrito esse teste que espelha a implementação: "Testes assim não têm chance de diferenciar falhas legítimas de falsos positivos" (no original, "Such tests don't have a chance of differentiating legitimate failures from false positives."). E deu a regra que virou ouro na era da IA: "O importante, com os valores fixos, é pré-calculá-los usando algo que não seja o próprio sistema sob teste, idealmente com a ajuda de um especialista de domínio" (no original, "The important part with the hardcoded values is to precalculate them using something other than the SUT, ideally with the help of a domain expert."). O valor esperado tem que vir de fora do sistema, de um humano que entende o domínio. Que é exatamente o que "é só pedir pro Claude gerar o teste também" remove da conta.
E isso tem medição em escala. O relatório DORA de 2024, já na era dos assistentes, foi direto: melhorar o processo não melhora a entrega sozinho, "não sem a devida aderência aos fundamentos de uma entrega bem-sucedida, como lotes pequenos e mecanismos de teste robustos" (no original, "not without proper adherence to the basics of successful software delivery, like small batch sizes and robust testing mechanisms."). Mecanismo de teste robusto aparece, na maior base de dados de entrega que existe, como o fundamento que a IA pressupõe. Não substitui.
A big tech reagiu, e a reação diz tudo. Depois de uma série de incidentes de alto raio de impacto ligados a mudanças assistidas por IA, incluindo uma IA que, segundo o relato, "decidiu apagar e recriar um sistema voltado ao cliente, causando um outage de 13 horas" (no original, "decided to delete and recreate a customer-facing system, causing a 13-hour outage."), a Amazon passou a exigir aprovação de um engenheiro sênior em todo código assistido por IA, tratando o sênior como filtro humano. Review e teste são a mesma coisa aqui: um oráculo independente entre o gerador e a produção, um humano e o outro automatizado, os dois pra não deixar a saída da IA chegar sozinha no cliente. E a urgência tem número: na mesma matéria, 96% dos desenvolvedores dizem não confiar no código gerado por IA, mas só 48% verificam antes de subir. Esse vão entre desconfiar e verificar é onde o teste vive. É o cinto de segurança que defendi pra LLM em Guardrails: Colocando Cinto de Segurança em LLM Antes Que o Jurídico Descubra, agora apontado pro código que a própria LLM escreve.
a apólice
Volto pro freio. O nome mais certo do que o teste faz talvez nem seja freio. É apólice. Ninguém paga seguro do carro esperando bater; paga porque não dá pra absorver o custo da batida de uma vez. Pagar seguro é aritmética: o custo do acidente é maior do que o caixa aguenta num susto só. Teste é isso pro software. Você não escreve teste porque acha o time ruim; escreve porque um bug em produção, num sistema que move dinheiro, custa caro demais. O defeito que a rede pega no commit custa centavos; o mesmo em produção custa o outage, o cliente, a manchete.
E a conta muda de figura com a IA no circuito. Quando o volume de mudança que chega perto da produção multiplica, porque um gerador cospe código em minutos, andar sem apólice deixou de ser economia de tempo. Virou decisão de risco tomada por omissão, por quem nunca sentou pra decidir que ia correr aquele risco. "A gente testa depois" não é priorização. É apostar sem perceber que apostou.
Teste não é o que atrasa a entrega. É o que deixa a próxima entrega existir. Quem corta a rede pra ganhar uma semana devolve essa semana com juros na primeira vez que o deploy virar aposta e a aposta der errado. Com a IA subindo o volume, a primeira vez chega mais rápido. O freio nunca foi sobre andar devagar. Sempre foi sobre poder correr de novo amanhã.
Insights & Takeaways
- Teste é apólice, não custo. Ninguém paga seguro por pessimismo; paga porque o custo do acidente em produção é maior do que a empresa absorve de uma vez. "Não temos tempo pra teste" é "não temos tempo pra freio", e freio existe pra você poder correr.
- "Clean code that works" (frase de Ron Jeffries, adotada por Beck) é objetivo de negócio: previsibilidade e um time que muda com confiança. No caso WyCash, disciplina mais suíte confiável multiplicaram o valor de mercado em dois dias.
- Ter teste não basta. Resistência à refatoração é o atributo inegociável e binário: teste que fica vermelho quando você só renomeia coisa não testa comportamento, vira menino que gritou lobo e treina o time a ignorar a falha de verdade.
- Cobertura é métrica de vaidade: 100% não garante nada, executado não é testado, e meta de cobertura imposta vira teste sem asserção. É o mesmo erro de medir "produtividade de IA" por linha gerada.
- Com IA no circuito, a rede virou pré-condição. O teste é o oráculo independente que a IA não te dá, desde que o valor esperado venha de fora do gerador, não da mesma IA. Depois de outages, a Amazon voltou a exigir sênior como filtro humano: review e teste são o mesmo guardrail.