Homelab · Episódio 1
Meu Homelab Tem Infra Melhor Que a de Muita Empresa (e Eu Não Preciso de Metade Dela)
Um homelab de peças que sobraram, com Proxmox, K3s, GitOps e túnel da Cloudflare sem porta aberta: o que ele tem que muita empresa não tem, e o que sobra.
Neste artigo · 7 seções
Em setembro eu arrumei um hobby novo. Juntei umas peças que estavam sobrando aqui em casa e montei um servidor, que hoje mora dentro de um armário: um Core i7-6700K de 2015 numa ASUS ROG Maximus VIII Formula, 32 GB de DDR4, três SSDs Samsung 850 EVO (um de 250 GB para o sistema, um de 1 TB para as máquinas virtuais e outro de 250 GB só para backup), um water cooler Corsair H100i e uma fonte Cooler Master V1100 SFX Platinum.
Nada ali foi escolhido para ser servidor, e dá para perceber. A fonte é de 1100 W e alimenta uma máquina que, pela minha estimativa, consome entre 50 e 70 W; o selo Platinum é medido a partir de 20% de carga, e ela passa o dia bem abaixo disso. O water cooler resfria um processador que fica quase sempre ocioso, a 1 GHz. Peça que sobrou é assim, você não escolhe.
A ideia era ter onde hospedar qualquer coisa que eu quisesse testar, sem conta de nuvem chegando no fim do mês. E, de quebra, praticar o que no trabalho eu quase sempre vejo pelo lado da decisão: rede, infraestrutura, DevOps, segurança, GitOps, CI/CD, teste automatizado, redundância e o próprio desenvolvimento de software.
Dinheiro novo, só o domínio, comprado na Cloudflare: uns R$ 100 por dois anos. A luz conta, claro, e pela minha estimativa fica entre R$ 30 e R$ 45 por mês com a máquina ligada direto. Para ser justo, dois serviços entraram depois, nenhum deles de hospedagem: o GitHub Pro, de US$ 4 por mês, quando eu quis regra de proteção de branch em repositório privado, e o plano do provedor de modelo que os agentes de IA da casa usam.
Três semanas e 380 commits depois, espalhados em quatro repositórios, eu tenho uma infraestrutura que muita empresa não tem. E não preciso de metade dela.
a planta, do cabo da operadora até o pod
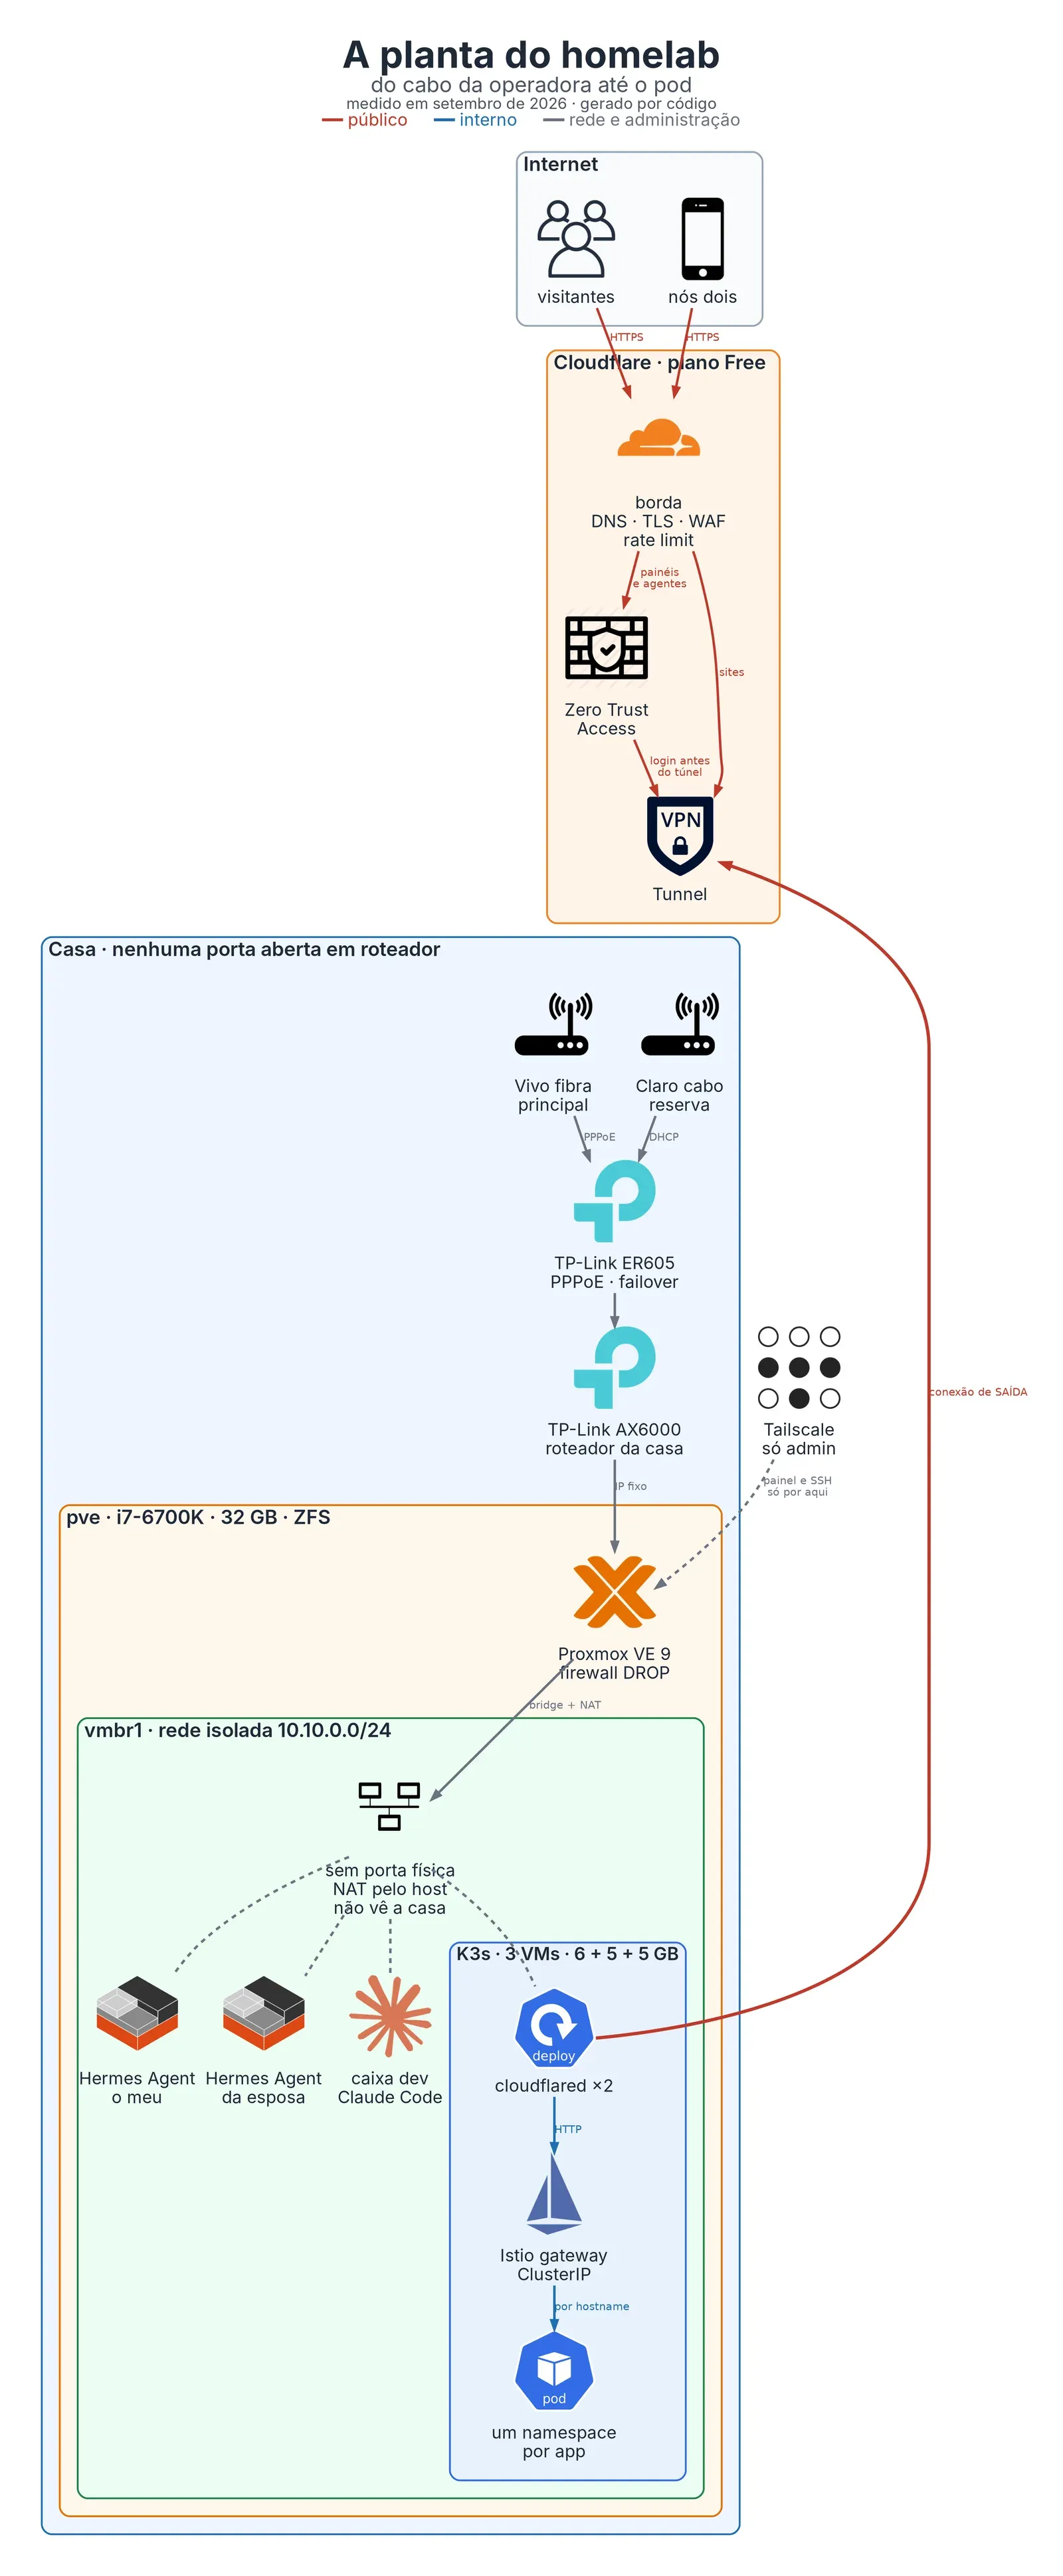
A internet chega por duas operadoras. A Vivo, por fibra, é o link principal; a Claro, por cabo, fica de reserva. Os dois modems estão em modo bridge, e quem conversa com as operadoras é um TP-Link ER605, que faz o PPPoE da fibra e passa tudo para o outro link sozinho quando um cai. Atrás dele, um Archer AX6000 é o roteador da casa. O servidor fica nessa rede, com IP fixo, rodando Proxmox VE.
Dentro do Proxmox existem duas redes. Uma é a de casa. A outra é uma bridge sem porta física nenhuma, a vmbr1, na faixa 10.10.0.0/24, com NAT pelo próprio host, e é nela que mora tudo o que pode ser exposto: três VMs Debian 13 formando um cluster K3s, dois containers LXC com os agentes de IA (um meu, outro da minha esposa) e um terceiro container onde eu programo. Dali se chega à internet, mas não à casa: nem à rede de casa, nem à tailnet, nem ao próprio Proxmox. O script que monta o cluster prova isso com testes negativos, que tentam alcançar esses destinos de dentro de uma VM e só passam quando a tentativa falha. Isolamento que ninguém testou é só intenção.
Agora, o detalhe que segura todo o resto: nenhum roteador da casa tem porta aberta. Com duas operadoras e um IP público que muda conforme o link ativo, port-forward seria frágil por definição, então quem abre a conexão é o cluster. O cloudflared roda lá dentro, em duas réplicas, e disca para a Cloudflare de dentro para fora. A Cloudflare responde pelo domínio, termina o TLS, filtra com WAF e rate limit e devolve o tráfego por esse túnel. Se a operadora muda, o túnel cai e reconecta pela outra em segundos, e quem acessa nunca soube qual era o IP da casa.
Lá dentro, o túnel entrega tudo para um gateway do Istio, que olha o hostname e roteia para o app certo. O gateway é ClusterIP, e o K3s sobe sem o balanceador embutido, para que um type: LoadBalancer distraído não abra porta em lugar nenhum. Cada app mora no próprio namespace, com Pod Security em restricted, mTLS obrigatório entre os serviços e NetworkPolicy negando tudo o que não foi declarado.
A administração não passa por nada disso. O painel do Proxmox e o SSH do host só respondem na rede de casa e na tailnet do Tailscale, que é como eu entro quando estou fora. O exit node fica desmarcado de propósito, senão toda a navegação dos meus dispositivos sairia pela internet de casa.
E tudo o que existe dentro do cluster nasceu de um commit, em quatro repositórios: os scripts idempotentes que constroem host, rede e K3s; o estado desejado que o ArgoCD aplica sozinho; um chart opinado que transforma vinte linhas de values num app publicado; e a esteira de CI/CD que qualquer repositório meu chama com um único uses:.
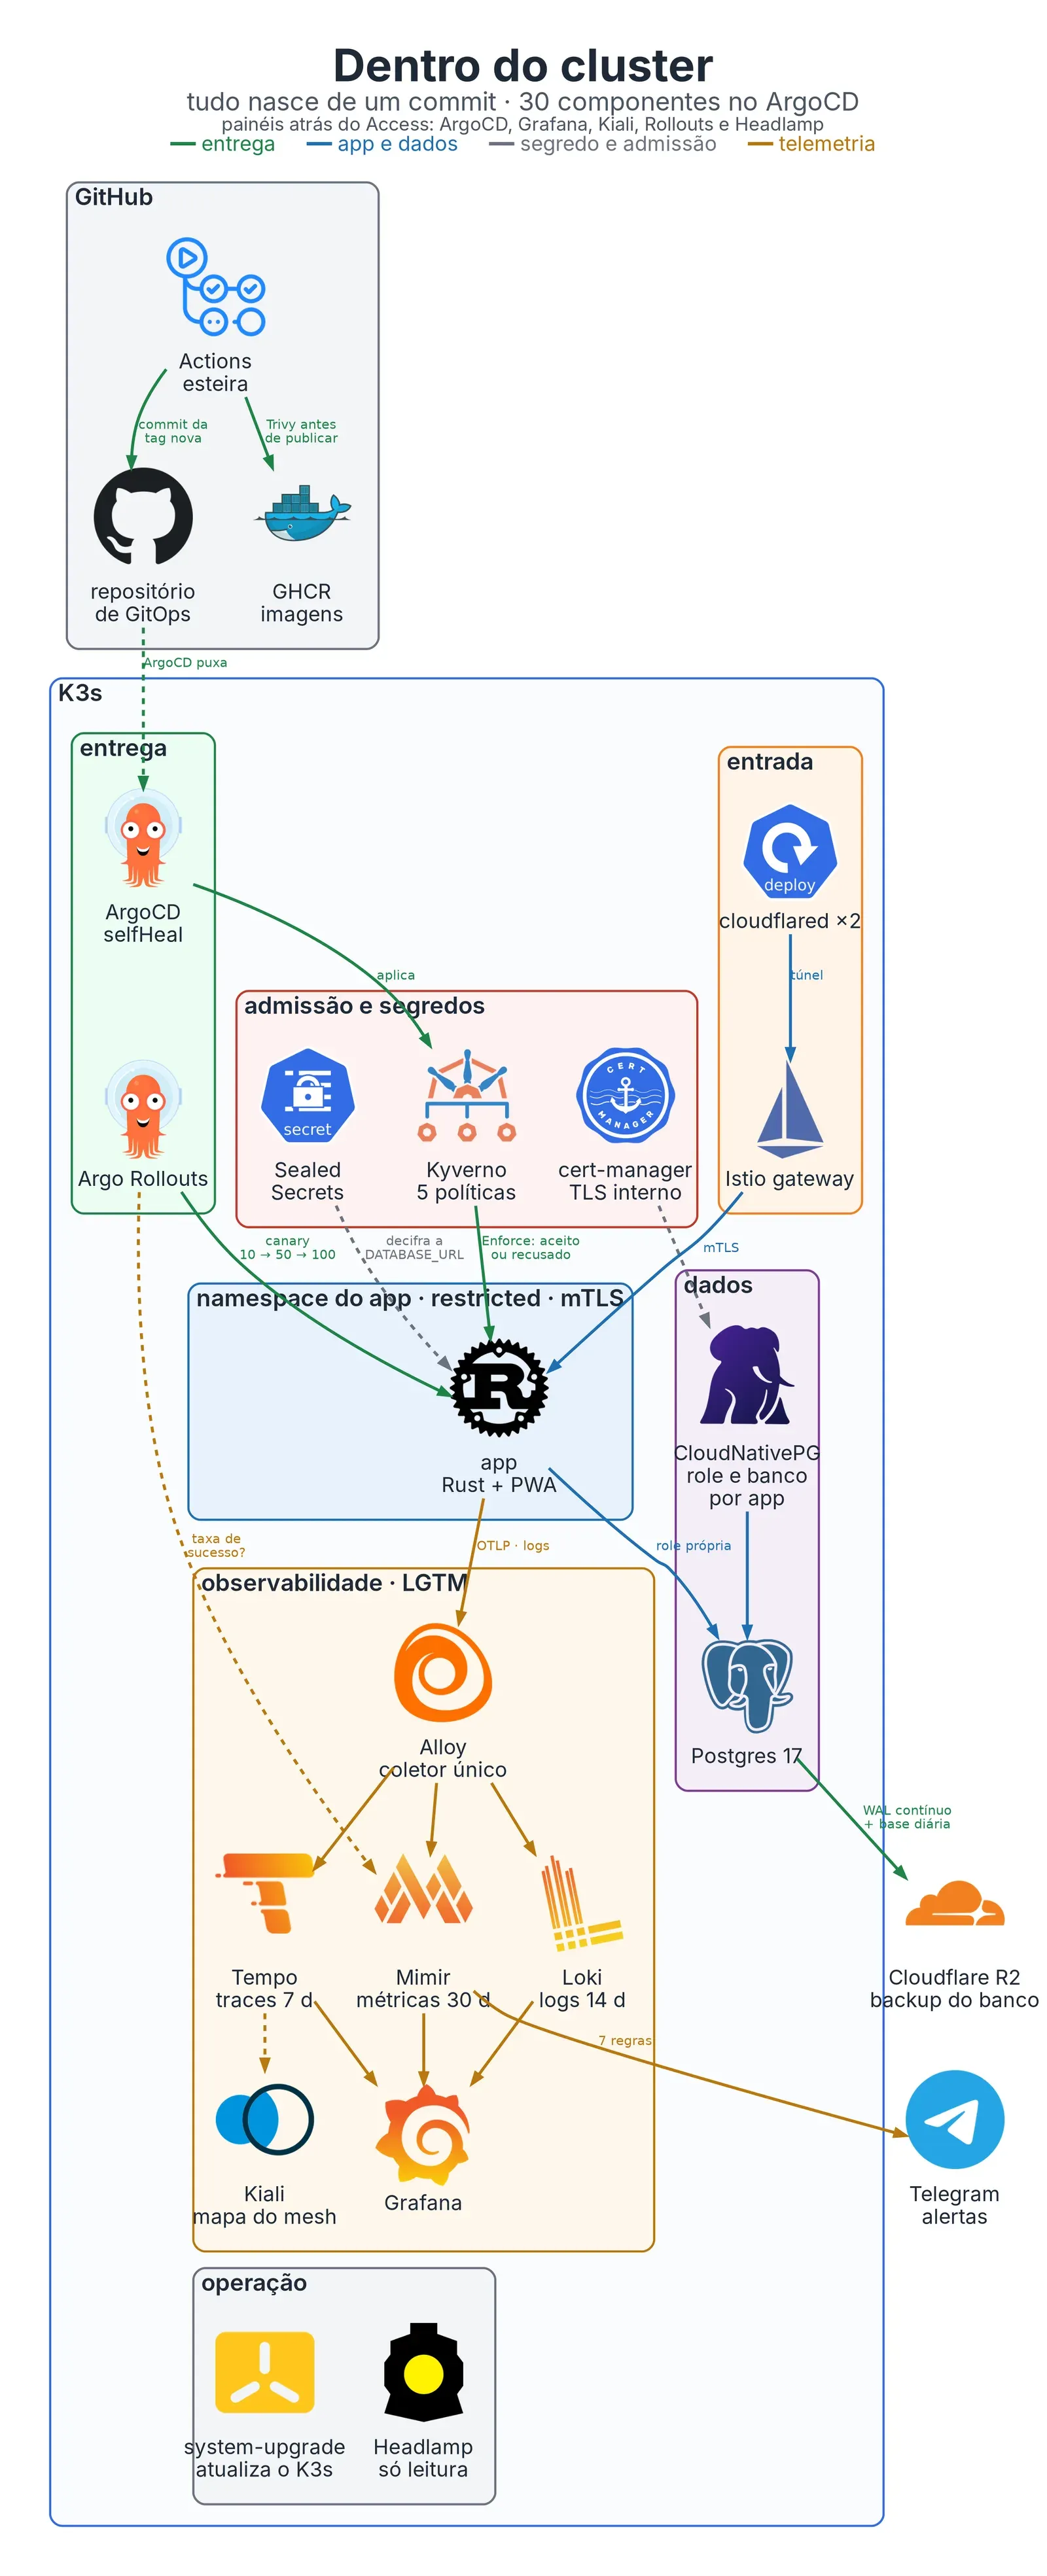
Os dois diagramas são gerados por código, a partir do que está medido. Já defendi aqui que desenho é ferramenta de arquitetura; o homelab me ensinou o complemento, que diagrama feito à mão envelhece em silêncio. Meu repositório já teve documento dizendo que uma política estava em auditoria uma semana depois de ela estar bloqueando.
o que tem aqui que muita empresa não tem
Parece provocação, mas dá para conferir item por item, e eu vou contar onde cada um quase deu errado.
Nenhum painel administrativo está aberto para a internet, e isso eu aprendi do jeito difícil. No dia em que o túnel entrou, o DNS curinga publicou no mesmo instante tudo o que tinha rota no gateway, e por alguns minutos quatro painéis ficaram expostos: o ArgoCD e o Grafana com tela de login, o Kiali sem login nenhum, mostrando a topologia inteira do mesh, e o do Argo Rollouts, também sem login, capaz de promover ou abortar um deploy. Saíram do ar na hora e voltaram no mesmo dia atrás de três camadas. A primeira é o Cloudflare Access, que exige login na borda antes de encaminhar qualquer pacote. A segunda fica no gateway, que valida a assinatura do token do Access e nega quem não trouxer a audiência daquele hostname, de modo que cada painel aceita só o token emitido para ele. A terceira, que eu só descobri depois, é uma NetworkPolicy por painel contra o caminho lateral: um pod qualquer do cluster falando direto com o serviço do painel, sem passar pelo gateway. Esse caminho respondia 200. E tinha de ser NetworkPolicy, porque os painéis não estão no mesh, e uma política do Istio neles não teria quem a aplicasse. A URL deixou de ser secreta para ser irrelevante.
O cluster também se defende de mim. O ArgoCD sincroniza com prune e selfHeal ligados, então mudar alguma coisa por kubectl funciona por uns sessenta segundos, até ele desfazer. Toda versão de chart e de imagem é fixa, e uma política de admissão do Kyverno recusa qualquer imagem com tag latest. São cinco políticas em modo de bloqueio, e uma delas me ensinou que segurança testada só na forma fácil prova só a forma fácil: o Kyverno estende as regras escritas para Pod aos controladores nativos do Kubernetes, mas não ao Rollout do Argo, que é justamente como todo app daqui é publicado. Um Rollout com imagem latest, sem limite de recurso e de um registro proibido passava liso, até cada política ganhar uma regra irmã para ele.
Ninguém conhece a senha do banco de nenhuma aplicação daqui, nem eu. Um comando sorteia 32 caracteres e sela a senha duas vezes com a chave pública do cluster: uma cópia no namespace do banco, para o operador do Postgres criar a role, e outra no namespace do app, para o pod ler. O cifrado vai para o git, e só o cluster decifra, cada cópia só no namespace para o qual foi selada; é isso que impede um app de ler o segredo do outro. O pod recebe a connection string pronta, em duas formas: DATABASE_URL e ConnectionStrings__Default, que o IConfiguration do .NET entende sem uma linha de configuração. Esse caminho vai ganhar um episódio só dele.
Já o backup, esse foi restaurado. O Postgres roda no cluster com o CloudNativePG, manda o WAL continuamente para um bucket R2 da Cloudflare e tira uma base por dia, de madrugada. No mesmo dia em que isso entrou, fiz o restore duas vezes: escrevi uma linha conhecida, criei um cluster novo a partir do backup e conferi se a linha voltava com o mesmo timestamp. Voltou nas duas. Backup que nunca foi restaurado é hipótese.
No deploy, pelo padrão do chart, a versão nova recebe 10% do tráfego, depois 50%, depois tudo, e antes de cada passo uma análise pergunta ao Mimir qual é a taxa de sucesso dela. Abaixo de 99%, o rollout aborta e o tráfego volta para a versão estável sem ninguém encostar; testei nos dois sentidos, promovendo e abortando de propósito. E qualquer pull request pode ganhar um ambiente efêmero só dele, com banco próprio, num endereço atrás do Access. Basta uma label no PR: o ambiente nasce em uns dois minutos e some, com namespace e banco, uns dois minutos depois de o PR fechar.
A esteira trata a cadeia de suprimentos como superfície de ataque. Roda lint, testes com piso de cobertura, sete varreduras de segurança e Sonar com quality gate, e só publica a imagem depois de o Trivy varrer e aprovar. Toda action de terceiro está fixada por SHA, e não por tag, porque tag é ponteiro móvel; foi por aí que o comprometimento do tj-actions/changed-files alcançou milhares de pipelines em 2025. A versão sai sozinha das mensagens de commit, e o CI nunca fala com o cluster: ele escreve a tag nova no repositório de GitOps e vai embora.
Por cima de tudo, uma trava mede isso contra o cluster vivo: um script com 73 verificações, positivas e negativas, que pergunta "o que acontece quando eu tento?" em vez de "o manifesto existe?". Os agentes de IA têm a deles, com 329.
eu não preciso de metade disso
Agora a parte que equilibra a anterior. Os usuários desta infraestrutura são eu, minha esposa e os nossos dois agentes. Tráfego, quase nenhum.
A prova mais engraçada está no próprio canary. Ele decide pela taxa de sucesso medida no Mimir, e sem requisição não existe série para medir; uma consulta sem série não aprova nada, ela erra, e o rollout aborta um deploy perfeitamente saudável. Resultado: no app principal, a análise do canary está desligada até existir tráfego de verdade. No app de demonstração, que existe para exercitar a esteira, um pod faz uma requisição a cada 0,3 segundo só para o canary ter o que medir. O comentário no manifesto chama esse pod de muleta, e é exatamente o que ele é.
Istio com mTLS para dois apps é exagero, e uma stack completa de logs, métricas e traces para um hobby também. Três nós de Kubernetes na mesma máquina física não são alta disponibilidade, são um laboratório de alta disponibilidade. O control plane é um só. O pool ZFS é de disco único, sem redundância, e quem protege os dados é o backup no disco separado (e, para o banco, no R2). O processador é de 2015 e não tem memória ECC, e a casa tem queda de luz e de internet como qualquer casa (mesmo conectado em um nobreak de 3200VA). Para portfólio, projeto pessoal e aprendizado, isso basta. Para algo que não pode cair, o lugar continua sendo um provedor.
Fiz porque podia. E porque o único jeito de conhecer um modo de falha é passar por ele.
Quase toda camada daqui me ensinou alguma coisa pela mesma porta, um painel verde mentindo. O operador do OpenTelemetry tinha um webhook com certificado inválido e failurePolicy: Ignore; os pods subiam, o ArgoCD ficava verde e nenhum trace era exportado. As consultas de trace apontavam para a porta do Loki em vez da do Tempo, e a conclusão fácil era "não tem trace nenhum". Eu já tinha escrito que o painel diz 100% e isso não quer dizer nada; aqui eu colecionei versões caseiras da mesma coisa.
A lição mais útil para o trabalho, porém, veio de um backup. O plano do cluster dizia, desde o primeiro dia, que as VMs entravam num job diário do Proxmox. Seis dias depois, montando os agentes, descobri que a configuração de jobs estava vazia, e a pasta de backup também: nenhuma das três VMs tinha uma única cópia. Documentação que descreve o que se pretendia fazer é indistinguível, na leitura, de documentação que descreve o que foi feito, e a diferença só aparece quando alguém mede. As travas existem por causa disso.
o que mora em cima
O inquilino principal é um aplicativo que eu estou construindo: backend em Rust, frontend React como PWA, os dois numa imagem só, login pelo Auth0 e Postgres por trás. Ele usa a infraestrutura pelo values do chart. Com database.enabled: true, o cluster cria um banco e uma role só dele e entrega a credencial selada como DATABASE_URL; as sondas de saúde ficam num listener interno que a internet não alcança; e cada pull request pode ganhar o próprio ambiente, logando no tenant de teste do Auth0. Da versão 0.1.0 à 1.4.0 foram dezesseis dias e 28 deploys, todos pelo mesmo caminho.
Sobre o Rust, o motivo é besta. Tenho muito mais estrada em C# do que em Rust e não troquei por desempenho nem por controle de memória, troquei pelo tamanho da imagem Docker. As imagens ficam no registry do GitHub, cuja tabela de cotas do plano gratuito fala em 500 MB para pacotes privados, e eu medi as bases, comprimidas: o aspnet:10.0 da Microsoft tem 95,9 MB; o distroless/cc, que é tudo de que o binário Rust precisa, tem 9,2 MB. Para ser honesto com o C#, o runtime-deps chiseled, base de um binário Native AOT, tem 5,8 MB, com o preço que o AOT cobra em reflection e trimming. E a documentação do GitHub diz que "o armazenamento e a banda do registry de containers são, por enquanto, gratuitos" (no original, "Container image storage and bandwidth for the Container registry is currently free"). Eu prefiro não construir em cima de um "por enquanto". Isso vira episódio próprio, e a tribo do .NET está convidada a discordar.
Os agentes de IA são dois Hermes Agent, do projeto da Nous Research, cada um no seu container e ligado ao Telegram do seu dono: um meu, outro da minha esposa. No dia a dia, eles leem e resumem e-mail, respondem pergunta trivial, guardam lembrete e tocam rotina. O que eu mais gosto aqui é o desenho de privacidade. O Hermes oferece perfis para separar pessoas, só que perfis dividem o mesmo sistema de arquivos e o mesmo painel, e quem entra no painel lê as sessões e a memória do outro. Por isso são dois containers, que custaram uns 500 MB de RAM para os dois. Cada bot aceita um único ID de Telegram, e a trava deles tenta, de dentro de um container, alcançar as portas do outro, passando só quando não consegue. O limite também está escrito: o modelo roda na nuvem, então o texto das conversas sai de casa até o provedor. Já escrevi sobre a distância entre o agente brinquedo e o operador real de processo; em casa, ela virou uma regra simples: ler é livre, mandar qualquer coisa para fora pede confirmação.
O terceiro container é onde eu programo. O Claude Code roda lá dentro com root, mas root dentro de uma caixa, nunca no Proxmox. As sessões do Remote Control sobem como serviço do sistema, então eu começo pelo desktop, desligo o computador e continuo pelo celular. A caixa alcança a internet e a API do cluster, e nada da casa; no cluster, entra com uma ServiceAccount de nome próprio, e o Kyverno continua valendo para ela, porque política de admissão não se contorna com RBAC.
o que vem nesta série
Isso tudo não cabe num artigo, e eu nem vou tentar. Nos próximos, eu abro cada camada pelo que deu errado nela: a borda e o dia em que o cluster ficou público, o Rust contra o C# medido em megabytes, a rede com duas operadoras, a senha que ninguém conhece, o painel verde que mentiu, a esteira, o ambiente por pull request e os agentes da casa, entre outras.
o que fica
Se esse hobby me mostrou uma coisa, é que infraestrutura boa não depende de orçamento. Depende de poder quebrar sem medo e de medir em vez de presumir. Em empresa, quebrar custa caro, então ninguém quebra de propósito, e aí o restore fica sem teste, o isolamento fica sem prova e o painel fica verde sem ninguém saber por quê. Em casa, quebrar é o hobby. Sai uma infraestrutura exagerada para o que hospeda, e honesta sobre o que não tem.
Insights & Takeaways
- Nenhuma porta aberta é decisão de desenho: o túnel aberto de dentro para fora sobrevive a duas operadoras e a IP dinâmico sem regra nenhuma no roteador.
- Isolamento, backup e permissão só existem depois de um teste que tenta quebrar e falha. Documentação de intenção se lê igual à de fato.
selfHeal, versão fixa e admissão em modo de bloqueio deixam o cluster reconstruível a partir do git e imune aokubectlapressado, inclusive o meu.- Canary decidido por métrica precisa de tráfego: sem série no Mimir, a análise aborta deploy saudável.
- Motivo besta também se mede: 9,2 MB de base contra 95,9 MB. E o Native AOT do .NET chega a 5,8 MB.
Uma pergunta honesta para fechar: quantos desses itens a infraestrutura onde você trabalha tem hoje? Nenhuma porta aberta, painel atrás de Zero Trust, restore testado, canary que volta sozinho, ambiente por pull request, action fixada por SHA. Me conta nos comentários os que tem e, principalmente, os que faltam.