Homelab · Episódio 2
O Dia Em Que Meu Cluster Ficou Público Por Alguns Minutos
Um DNS curinga expôs quatro painéis do meu cluster na internet. As três trancas que fecharam a porta: Cloudflare Access, JWT no gateway e NetworkPolicy.
Neste artigo · 10 seções
Doze de setembro. O túnel da Cloudflare tinha acabado de subir, e o primeiro teste deu exatamente o que eu queria: o whoami, um app de exemplo, respondendo 200 de qualquer lugar, com certificado válido e nenhuma porta aberta em casa. A mesma rodada de testes trouxe o resto.
O ArgoCD respondeu 200, com a tela de login à mostra e o usuário admin ainda habilitado. O Grafana mostrou a tela de login dele. O Kiali respondeu 200 sem pedir nada, com a topologia inteira do mesh legível para quem quisesse olhar. E o painel do Argo Rollouts, aquele que promove e aborta deploy, também abriu sem login nenhum. Os quatro saíram do ar em minutos, renomeados para .pending no repositório de GitOps, e voltaram no mesmo dia atrás de três trancas, cada uma tampando o furo que a anterior deixava.
No primeiro episódio desta série eu contei a planta inteira do homelab. Este aqui é sobre a borda, e começa pelo pedaço da planta que eu mais gostava: publicar um app novo não exigia tocar em nada.
o curinga publica tudo
O desenho é simples. Um único registro DNS curinga, *.<domínio>, aponta para o túnel, com o proxy da Cloudflare ligado, que é o que põe WAF, proteção contra DDoS e rate limit no caminho. O túnel entrega todo hostname para o gateway do Istio dentro do cluster, e o gateway olha o Host e procura o VirtualService que responde por ele. Ou seja, publicar um app é escrever um valor no values do chart, sem DNS para criar, regra no túnel para mexer ou ticket para abrir.
Só que o interruptor que publica app é o mesmo que publica painel. Os VirtualService dos painéis já existiam no repositório desde antes do túnel. Sem túnel, eles respondiam só para quem estava dentro. Com o túnel no ar, passaram a responder para a internet no instante em que o ArgoCD sincronizou. Nenhum arquivo de painel mudou nesse dia; o que mudou foi o mundo que conseguia chegar até eles.
A lição que ficou foi sobre ordem. Num cluster com DNS curinga, o VirtualService é a última coisa a entrar, nunca a primeira, porque é ele que torna o serviço visível. O resto do artigo é o que tem de estar no lugar antes dele.
tranca 1: o Access, na borda
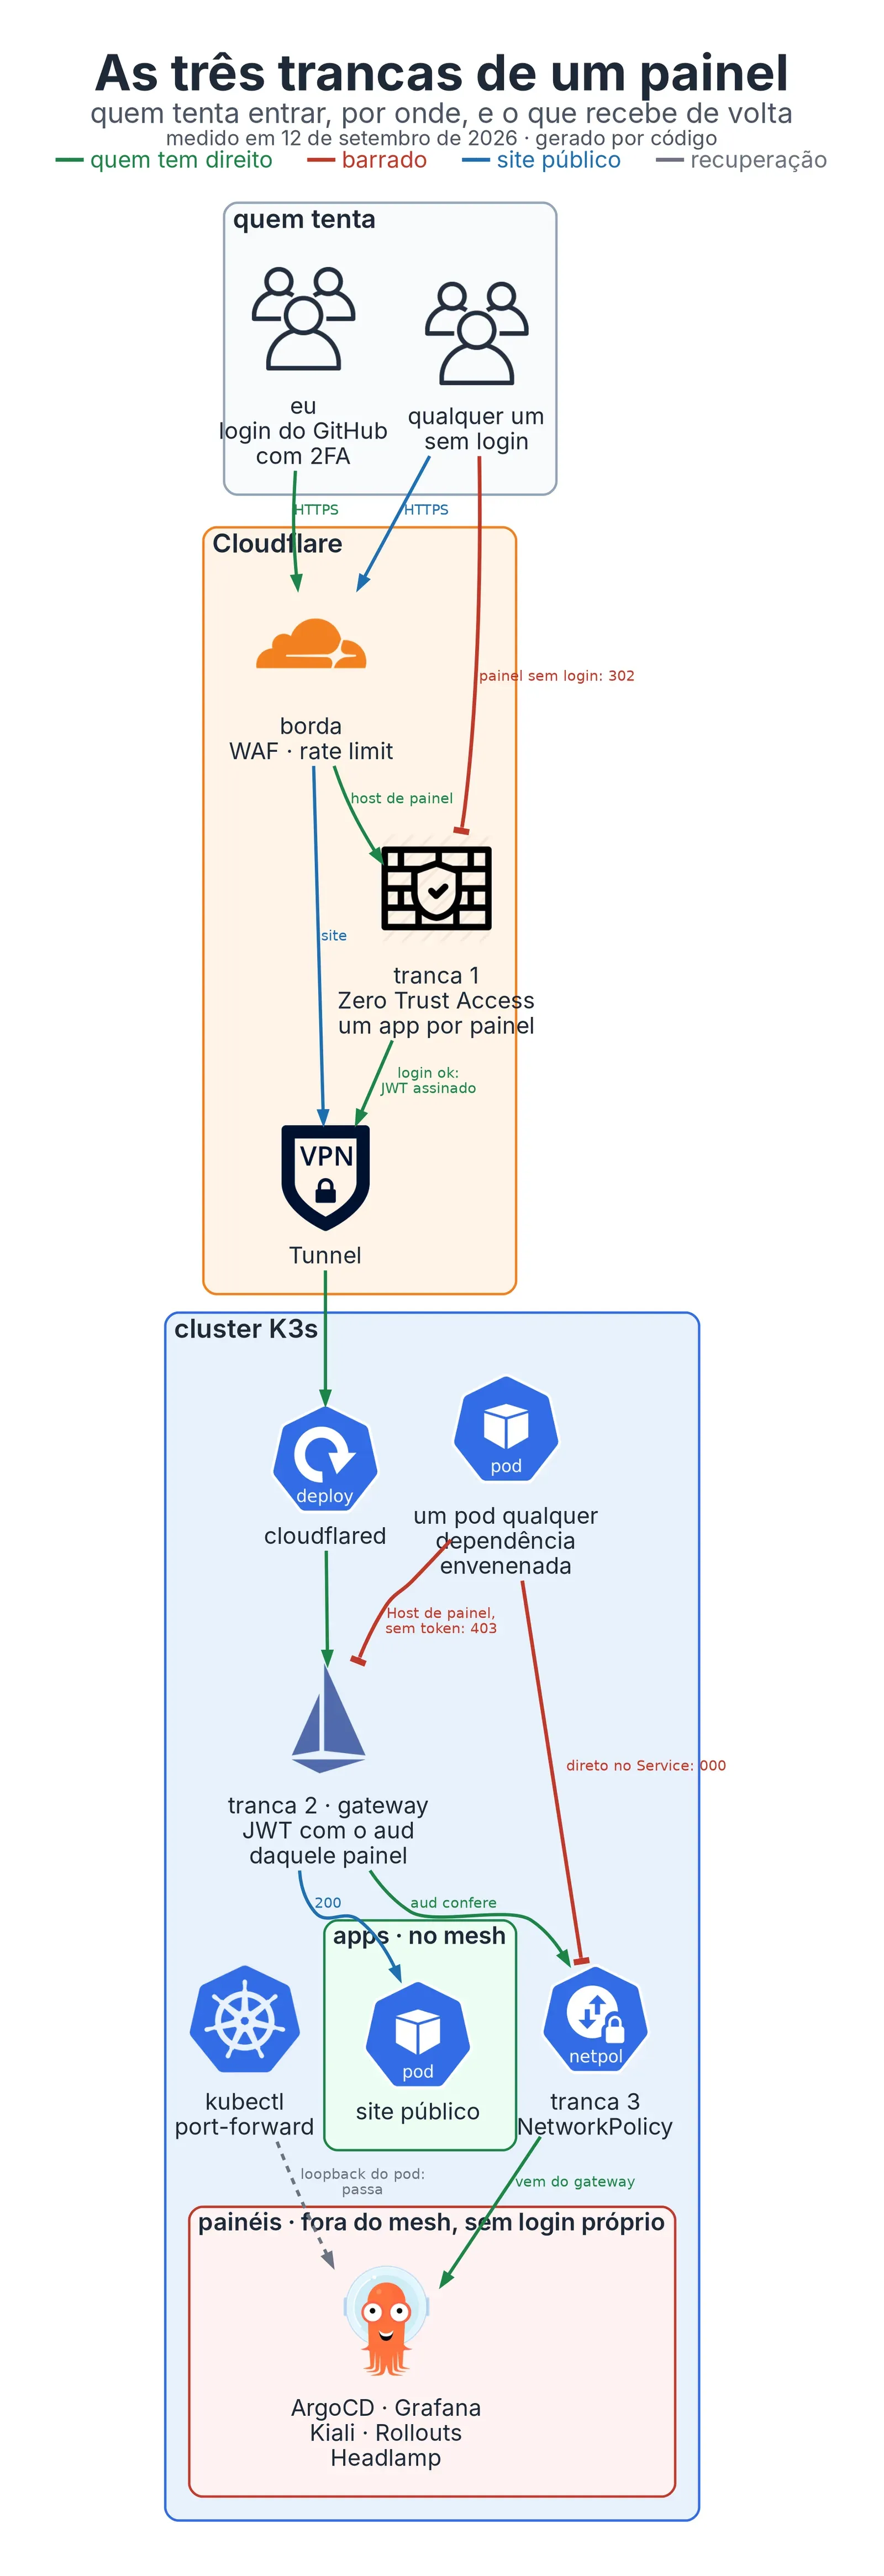
A primeira tranca é o Cloudflare Access, que no plano Zero Trust gratuito atende até 50 usuários sem custar nada. Ele pede login antes de encaminhar qualquer pacote para o túnel. Cada painel virou uma aplicação própria no Access, e não uma aplicação com cinco hostnames, porque cada aplicação tem um identificador de audiência, o AUD, e é esse identificador que a segunda tranca confere. Uma política só, reutilizada por todas, diz quem passa: um e-mail, sessão de 24 horas.
O login dos painéis é o da conta da Cloudflare, que no meu caso entra pelo SSO do GitHub, com o segundo fator dele. E aqui veio a primeira armadilha, que só apareceu dias depois. Quando habilitei o login por código de e-mail para quem não tem conta na Cloudflare, descobri que uma aplicação com a lista de provedores de identidade vazia não significa "nenhum além do padrão". Significa "todos". Se eu não tivesse fixado os painéis no login da conta antes, eles teriam herdado o código por e-mail naquele mesmo instante, e ninguém notaria. Nada quebra. A porta só fica mais fácil de abrir.
Medido depois da configuração, os quatro hostnames devolveram 302 para a tela de login, cada um com o parâmetro kid igual ao AUD da própria aplicação. É a confirmação de que a aplicação certa está na frente do hostname certo, e é um teste que roda sem precisar de login.
por que uma tranca só não basta
O Access roda na Cloudflare, e protege o que passa pela Cloudflare. Um pod comprometido dentro do cluster, digamos, um app com uma dependência envenenada, não passa pela borda. Ele pode chamar o gateway direto, de dentro, com o Host de um painel no cabeçalho, e a borda não está no caminho para dizer não. Uma tranca que só existe na entrada da casa não ajuda contra quem já está na sala.
tranca 2: o token conferido no gateway
O Access, depois do login, põe em cada requisição um JWT assinado no cabeçalho Cf-Access-Jwt-Assertion. A segunda tranca confere esse token dentro do cluster, no gateway, em duas peças do Istio. A primeira, RequestAuthentication, ensina o gateway a reconhecer o token: quem é o emissor e onde buscar as chaves públicas para validar a assinatura. Sozinha, ela não exige nada, e uma requisição sem token passa intacta. Quem exige é a segunda peça:
apiVersion: security.istio.io/v1
kind: AuthorizationPolicy
metadata:
  name: paineis-exigem-access
  namespace: istio-system
spec:
  selector:
    matchLabels:
      istio: ingressgateway
  action: DENY
  rules:
    # uma regra por painel, cada uma com o AUD da aplicação DELE
    - to:
        - operation:
            hosts: ["argocd.<domínio>", "argocd.<domínio>:*"]
      when:
        - key: request.auth.claims[aud]
          notValues: ["<AUD do argocd>"]
    # ... a mesma regra para grafana, kiali, rollouts e headlamp
O detalhe que faz isso funcionar está no notValues. Uma requisição sem token não tem claim aud, e um claim ausente não está na lista de valores aceitos, então a condição casa e o DENY se aplica. Requisição sem token é negada por construção, sem precisar de uma regra separada para ela. E como cada host exige o AUD da sua própria aplicação, um token válido do Grafana não abre o ArgoCD.
Duas coisas que o plano não previa e entraram no manifesto. Cada host aparece também na forma host:*, porque um Host com porta explícita é, para o Istio, outra string, e a regra não casaria. E o istiod busca as chaves públicas do Access pela internet, saindo pela NAT da rede isolada; se essa saída fechar, todo painel passa a devolver 401. A tranca depende de uma conexão de saída, e falha fechada quando ela some, que é o lado certo para falhar.
A escolha por DENY, e não ALLOW, tem preço, e vale dizer qual. Uma política ALLOW exigiria listar tudo o que pode passar pelo gateway, inclusive cada app público futuro, e esquecer um deixaria esse app fora do ar. Com DENY por painel, o esquecimento custa o contrário: um painel novo sem regra fica aberto. Eu aceitei esse risco porque ele tem dono, a regra de ordem do começo do artigo, e porque existe uma terceira tranca atrás.
Antes de religar qualquer painel, o teste de dentro do cluster, sem token e com o Host de cada painel, deu argocd=403 grafana=403 kiali=403 rollouts=403 whoami=200. Só então os VirtualService voltaram. A ordem era dependência dura: religar antes da política valer devolveria o problema que derrubou os painéis. É essa tranca que transforma "a URL é secreta" em "a URL é irrelevante".
tranca 3: a que não estava no plano
Com as duas primeiras no lugar, faltava testar um caminho que nenhuma delas cobre: um pod qualquer do cluster falando direto com o Service do painel, sem passar pelo gateway. O resultado, medido de um pod comum, foi argocd=200 grafana=302 kiali=200 rollouts=302. O Kiali entregava a topologia do mesh, e o painel que promove rollout respondia, para qualquer pod do cluster. O whoami, um site público, estava mais protegido lateralmente do que eles, porque já tinha uma NetworkPolicy negando tudo o que não foi declarado.
A primeira tentativa de conserto foram quatro AuthorizationPolicy, uma em cada namespace de painel, e elas não fizeram efeito nenhum. Faz sentido, depois que se vê: os painéis rodam fora do mesh, sem sidecar, então não existe um Envoy ali para aplicar a regra. Uma AuthorizationPolicy num namespace sem sidecar é um arquivo sem ninguém para cumpri-lo. Fora do mesh, quem barra pacote é a NetworkPolicy.
Então ficou uma NetworkPolicy por painel, liberando a porta da interface só para os pods do gateway. E ela tem a sua própria pegadinha: no bloco from, dois seletores em itens separados se somam com OU, e no mesmo item se combinam com E. A primeira versão liberava o namespace istio-system inteiro, o que deixava entrar também o istiod, o Kiali e o istio-cni, que moram lá. O certo é o seletor de namespace e o de pod no mesmo item: o namespace do gateway e, dentro dele, só os pods do gateway.
O ArgoCD guardava mais uma. O chart oficial cria uma NetworkPolicy para o servidor com ingress: [{}], ou seja, aberta para o cluster todo, e NetworkPolicy é aditiva: uma restritiva ao lado não aperta nada. Desligar a dele também não era óbvio, porque server.networkPolicy.create: false quer dizer "herde o valor global", e não "não crie". A saída foi desligar no global e trazer as políticas para o repositório, com a do servidor restrita. Depois disso, o mesmo teste lateral voltou 000 nos quatro.
O que essa tranca não bloqueia, e de propósito, é o kubectl port-forward. Ele entra pelo loopback do pod e não cruza a rede do cluster. É o caminho de recuperação para o dia em que o Access estiver fora do ar ou mal configurado, que é exatamente o dia em que ninguém quer descobrir que não existe outro caminho.
o painel que já nasceu certo
O Headlamp entrou no mesmo dia, depois dos outros, e foi o primeiro a seguir a ordem desde o início. Primeiro a aplicação no Access. Depois a regra com o AUD dele no gateway. Depois a NetworkPolicy. E só então o VirtualService. Entre a terceira etapa e a quarta, dois testes tinham de falhar: pelo gateway, sem token, 403; de um pod qualquer, direto no Service, nada. Depois da quarta, da internet, 302 para o login.
O Headlamp ainda ensinou que o padrão de fábrica de um chart é parte da superfície de ataque. Ele vem configurado para usar uma ServiceAccount com cluster-admin, e como o painel não tem login próprio, quem passa pelo Access é essa conta: lê todo Secret do cluster e pode apagá-lo. O papel view do Kubernetes, que seria a escolha óbvia, não serve, porque não enxerga nó, volume nem recurso personalizado; um painel de cluster com view nasce cego para metade do cluster. Ficou um papel próprio, que lê tudo o que interessa, não lê Secret e não escreve nada.
Os logins também foram uma decisão. O Kiali roda em modo anônimo e o painel do Rollouts não tem login, de propósito: quem os protege são as três trancas, e dois sistemas de login para o mesmo painel só servem para um deles ficar desatualizado. O Grafana lê o mesmo JWT do Access e entra sozinho, com a senha de admin guardada para recuperação. O ArgoCD passou a aceitar só o login do GitHub, com a política padrão vazia, de modo que alguém que autentique e não esteja mapeado não vê nem a lista de aplicações. O admin local só foi desligado depois de medir, com can-i, que a conta do GitHub tinha todo o poder que precisava. Desligar sem essa medida seria tirar a escada depois de subir.
o rate limit que me bloqueou
No plano gratuito, a Cloudflare dá uma regra de rate limit. Eu comecei com 100 requisições a cada 10 segundos por IP, valendo para todo o domínio, e no dia seguinte o contador dela estava em 19.680 eventos. O log do gateway mostrou quem era o atacante: em 30 minutos, 353 de 372 requisições externas tinham saído do IP de casa, quase todas do Headlamp. Cada abertura do painel dispara de 60 a 70 chamadas em poucos segundos, e ele continua consultando o cluster enquanto a aba estiver aberta. Um celular com a aba aberta e um desktop carregando estouravam 100 em 10 segundos. O sintoma era uma faixa vermelha avisando que a conexão com o cluster tinha caído e, no navegador, o erro 1015 da Cloudflare. Até o meu script de verificação tomou 429.
A correção foi tirar os painéis da regra, porque eles já têm três trancas, e subir o limite para 1.000 a cada 10 segundos, o que ainda barra varredura. A regra virou uma lista de exclusão, e não de inclusão, de propósito: todo app novo publicado pelo chart ganha um hostname que cai na regra sem ninguém precisar lembrar dele. Quando a mudança entrou, o contador estava em 73.390, porque cada painel bloqueado tentava de novo em loop e cada nova tentativa era mais um bloqueio. Depois dela, 600 chamadas seguidas ao Grafana, a 44 por segundo, passaram todas.
Um detalhe dessa história que eu gosto de contar: quem mudou a regra fui eu, à mão, no painel da Cloudflare. A camada de permissões do Claude Code, que me ajudou a diagnosticar o bloqueio, se recusou a alterar uma regra de segurança. E é assim que deve ser.
o que não passa pela borda, de jeito nenhum
O painel do Proxmox nunca passa pelo túnel, e a avaliação que eu fiz antes de decidir isso deixa o motivo claro. A porta 8006 não é mais um painel. Quem entra nela cria, apaga e restaura qualquer VM, abre um console de teclado e vídeo em cada uma sem precisar da senha do sistema, lê os backups, roda comando como root no host e desfaz, de dentro, todo o isolamento de rede. Comparado a isso, o ArgoCD exposto foi um arranhão: ele mexe no que está no cluster, e o cluster é recriável a partir do git. O host não é.
Hoje o túnel nem tem como alcançar o Proxmox. De um pod do cluster, a porta 8006 do host não responde, nem pela rede de casa nem pelo gateway da rede isolada, e isso é uma propriedade a preservar, não um obstáculo a remover. Quem administra o host entra pela tailnet do Tailscale, onde a porta simplesmente não existe para quem está de fora. A comparação que decidiu foi uma linha só: se a conta do provedor cair, com o Tailscale eu perco acesso; com o túnel, outras pessoas ganham acesso. É o tipo de decisão que eu prefiro registrar com o custo escrito, do jeito que defendi em decisões arquiteturais com informação imperfeita: dá para publicar, o desenho mínimo é este, o risco que sobra é aquele, e a recomendação continua sendo não publicar. Até o 404 que o hostname devolve hoje é informação; publicar o painel contaria ao mundo que existe um Proxmox ali.
o que fica
Nenhuma das três trancas é suficiente sozinha, e o desenho não depende de nenhuma delas ser perfeita. O Access não enxerga dentro do cluster. O gateway não enxerga o caminho lateral. A NetworkPolicy não enxerga o port-forward, e esse furo é mantido de propósito, porque no dia em que o Access cair ele é a única porta. É o modelo do queijo suíço, de James Reason: cada fatia tem furos, e a defesa existe porque os furos de uma não se alinham com os da outra.
No fim, quem fez a diferença foi a ordem. O curinga publica tudo no instante do sync, então o VirtualService entra por último, depois da aplicação no Access, da regra no gateway e da NetworkPolicy. Os quatro painéis só ficaram expostos porque essa ordem estava invertida, e o Headlamp, que veio depois, nunca ficou.
Insights & Takeaways
- DNS curinga com túnel publica o serviço no instante do sync. A regra que segura isso é de ordem: o
VirtualServiceentra por último, depois das trancas. - Tranca na borda não enxerga quem já está dentro. Valide o JWT do Access no gateway, uma audiência por painel; com
notValues, a requisição sem token é negada por construção. AuthorizationPolicysó vale onde existe sidecar. Fora do mesh, quem barra é a NetworkPolicy, e nofromela soma itens separados com OU e combina seletores do mesmo item com E.- Padrão de fábrica é superfície de ataque: a NetworkPolicy aberta do chart do ArgoCD, o
cluster-admindo Headlamp e a lista vazia de provedores no Access, que significa "todos". - O hipervisor fica fora da internet. O cluster se recria a partir do git e o host não; e entre "perco acesso" e "outros ganham acesso", a escolha é fácil.
Uma pergunta para levar para a segunda-feira: se um pod qualquer do seu cluster chamar hoje o Service do ArgoCD direto, sem passar pelo ingress, o que ele recebe?