Compare-and-Swap em .NET: a instrução invisível que limita (ou destrava) a escalabilidade
Como o Compare-and-Swap funciona no .NET com Interlocked.CompareExchange, o problema ABA e por que a contenção em CAS loops trava a escalabilidade.
Neste artigo · 9 seções
- Introdução
- O que é Compare-and-Swap (CAS) em termos práticos
- Onde CAS aparece no seu código .NET
- O ciclo de CAS (CAS loop) e a escalabilidade
- ABA: quando o valor volta a ser o mesmo, mas a história foi outra
- Quando CAS começa a virar gargalo
- Diagnóstico e alternativas pragmáticas
- Conclusão
- Insights & Takeaways
Introdução
Você aumenta o número de threads, sobe o número de instâncias, coloca a aplicação em uma máquina com mais núcleos de CPU e, mesmo assim, o throughput insiste em não crescer. A CPU está alta, o banco de dados está saudável, a rede não é o problema. Quando você abre o profiler, aparece uma cena curiosa: métodos minúsculos, muitas vezes envolvendo Interlocked, consumindo uma fatia desproporcional de CPU.
Esse tipo de comportamento é comum em sistemas .NET que vivem sob alta concorrência. Em muitos casos, o ponto de estrangulamento está em algo que raramente aparece nos diagramas de arquitetura: a forma como operações atômicas são usadas por baixo dos panos. No centro dessa história está uma única instrução de hardware, discreta, mas decisiva para a escalabilidade: Compare-and-Swap, ou simplesmente CAS.
O objetivo deste artigo é olhar para CAS com os olhos de quem desenvolve em .NET: entender o que essa operação realmente faz, onde ela aparece no seu código, por que ela pode se tornar um gargalo e quais alternativas práticas fazem mais sentido quando o sistema começa a “bater no teto”.
O que é Compare-and-Swap (CAS) em termos práticos
Compare-and-Swap é uma operação atômica que trabalha com três elementos: um endereço de memória, um valor esperado e um novo valor. A lógica é direta. A operação lê o valor atual naquele endereço, compara com o valor esperado e, se ainda forem iguais, troca o valor pelo novo. Todo esse processo acontece de forma indivisível na visão dos outros núcleos: ou a troca acontece inteira, ou não acontece.
Em C#, a ideia conceitual pode ser representada assim:
public static int CasConceitual(ref int location, int expected, int newValue)
{
    var old = location;

    if (old == expected)
    {
        // Em uma implementação real, essa escrita seria atômica
        location = newValue;
    }

    return old; // quem chamou decide se deu certo comparando com expected
}
Na implementação real, essa comparação seguida de escrita é garantida por instruções especiais da CPU, como CMPXCHG com prefixo de lock em x86/x64 ou load/store exclusivos em ARM. O detalhe importante é que não existe um “estado intermediário” visível para outras threads. Nenhuma delas consegue observar um valor parcialmente atualizado.
Esse comportamento é o que permite construir algoritmos lock-free corretos. Sem atomicidade, a sequência “ler, comparar e escrever” estaria sujeita a condições de corrida em que duas threads enxergam o mesmo valor, fazem cálculos em cima dele e acabam sobrescrevendo o trabalho uma da outra.
Onde CAS aparece no seu código .NET
Em .NET, você raramente chama uma instrução de hardware diretamente. Em vez disso, trabalha com APIs que encapsulam esse comportamento. A mais explícita delas é Interlocked.CompareExchange, que oferece a semântica de Compare-and-Swap para tipos primitivos e referências.
Um uso típico fica assim:
int anterior = Interlocked.CompareExchange(ref contador, novoValor, valorEsperado);

if (anterior == valorEsperado)
{
    // Atualização atômica bem-sucedida
}
else
{
    // Outro thread chegou primeiro; 'anterior' mostra o valor real
}
Esse padrão se espalha por boa parte da biblioteca base. As coleções em System.Collections.Concurrent usam CAS em estruturas internas para garantir integridade sob concorrência. Outras primitivas de sincronização e algoritmos lock-free também se apoiam em Compare-and-Swap para evitar locks em determinados caminhos.
Enquanto poucas threads disputam o mesmo dado, o CAS passa a maior parte do tempo de primeira, e o custo da sincronização fica pequeno. É quando muitos threads passam a brigar pelo mesmo endereço de memória ao mesmo tempo que o comportamento muda de figura.
O ciclo de CAS (CAS loop) e a escalabilidade
Na prática, a maior parte dos algoritmos lock-free não usa CAS isoladamente. Eles se estruturam em torno de um padrão conhecido como CAS loop. A ideia é simples: ler o valor atual, calcular um novo valor, tentar aplicar a mudança com CompareExchange e, se alguém tiver alterado a variável no meio do caminho, recomeçar o ciclo com o estado mais recente.
Um exemplo clássico é o incremento atômico de um contador:
private static int _contador;

public static void Incrementar()
{
    int antigo, novo;

    do
    {
        antigo = _contador;
        novo = antigo + 1;
    }
    while (Interlocked.CompareExchange(ref _contador, novo, antigo) != antigo);
}
Enquanto o número de threads disputando esse contador é baixo, a maioria das tentativas de CAS é bem-sucedida logo na primeira rodada. O loop praticamente não gira, e o comportamento é excelente.
Podemos visualizar esse fluxo com um diagrama simples:
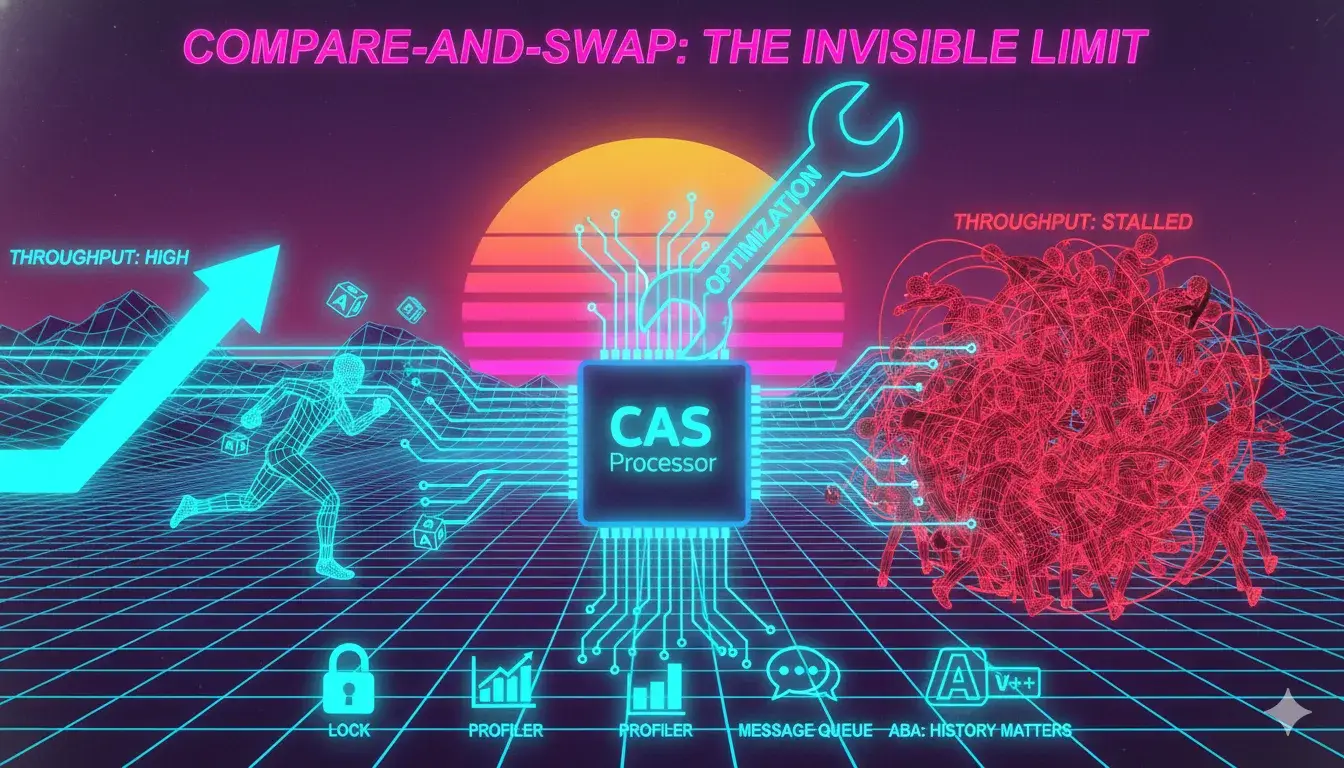
O problema aparece quando o número de threads aumenta. Com muitas threads tentando atualizar a mesma variável, as falhas no CAS se tornam muito mais frequentes. O diagrama passa a percorrer o caminho de falha vezes seguidas, e uma parte significativa do tempo de CPU é gasta apenas em tentativas e re-tentativas.
ABA: quando o valor volta a ser o mesmo, mas a história foi outra
Em estruturas simples, como contadores, o CAS só precisa comparar valores e isso costuma ser suficiente. Em estruturas mais complexas, como pilhas e filas lock-free, o cenário é diferente. O problema ABA nasce justamente do fato de que Compare-and-Swap não guarda histórico: ele só enxerga o valor atual.
Imagine uma pilha onde _topo aponta para um nó A. Um thread lê o topo, vê A e começa a calcular sua operação. Nesse meio tempo, outro thread faz uma série de operações: remove A, remove mais alguns nós, reaproveita a memória de A para outro propósito e, depois de várias mudanças, volta a colocar A no topo da pilha. Quando o primeiro thread chega ao CAS, ele pergunta: “o topo ainda é A?”. A resposta é sim. A comparação passa, o CAS troca o valor, mas o objeto concreto que ele pensa estar manipulando não é mais o mesmo que estava ali no começo.
A operação atômica cumpriu sua promessa: ela garantiu que, se o valor observado ainda fosse o esperado, a troca aconteceria. O problema está no fato de que o mesmo valor reapareceu após uma série de alterações intermediárias. Em algoritmos lock-free baseados em referências para nós, isso pode levar a corrupção sutil de estrutura, justamente porque a semântica de “igual” passa a ser mais rica do que apenas “o mesmo ponteiro”.
Uma técnica clássica para reduzir esse risco é associar um contador de versão ao valor. Em vez de guardar apenas uma referência, o algoritmo guarda um par contendo a referência e um número de versão. A cada modificação relevante, essa versão é incrementada. O CAS deixa de comparar apenas o endereço, passando a comparar o conjunto referência + versão. Mesmo que a mesma referência reapareça mais tarde, a versão diferente denuncia que houve alterações no meio do caminho.
Quando CAS começa a virar gargalo
Até aqui, CAS parece uma ferramenta sofisticada, mas razoável. Ele garante atomicidade, permite detectar interferência de outras threads e evita estados intermediários inconsistentes. O problema começa quando a contenção entra em cena.
Considere novamente o contador compartilhado. Com poucas threads, o ganho de throughput ao adicionar núcleos é visível. Com o aumento da concorrência, o ganho começa a achatar. Em algum ponto, adicionar mais threads quase não muda a taxa de trabalho útil e, em casos mais extremos, pode até piorar a latência.
O que está acontecendo por trás dessas métricas é uma espécie de “pedágio invisível”. Cada thread que tenta atualizar o contador entra no CAS loop. Uma delas consegue, todas as outras descobrem que perderam a corrida, relêem o valor, recalculam e tentam de novo. Quando isso se repete milhões de vezes por segundo, boa parte da CPU é gasta apenas na negociação de quem tem o direito de escrever em uma única variável.
Esse comportamento costuma aparecer com clareza no profiler. Métodos minúsculos, que em teoria “só incrementam um número” ou “só atualizam um campo interno”, aparecem no topo do consumo de CPU. Muitas vezes, esses métodos são precisamente os pontos onde CAS está sendo aplicado em alta contenção.
O contraste com lock fica interessante justamente aqui. Em cenários de contenção intensa, um código simples com lock pode oferecer um throughput melhor do que um algoritmo lock-free baseado em CAS. Threads que não conseguem entrar na região crítica podem ser suspensas ou realocadas para outras tarefas pelo scheduler, em vez de ficarem girando dentro de loops de Compare-and-Swap.
Diagnóstico e alternativas pragmáticas
Identificar que CAS está limitando a escalabilidade não exige ler assembly, mas exige observar o comportamento do sistema à medida que a concorrência aumenta. Se o throughput cresce bem com poucos threads e depois bate em um platô, se a CPU fica alta e se o profiler aponta para métodos pequenos com Interlocked no topo da lista, há um bom motivo para suspeitar de contenção em operações atômicas.
A partir desse diagnóstico, a questão deixa de ser “como remover CAS do sistema” e passa a ser “como reduzir a disputa em torno de determinados pontos”. Em alguns casos, a solução é redesenhar o fluxo para evitar que todos os threads dependam do mesmo contador global. Uma alternativa simples é usar contadores locais com agregação periódica: cada thread acumula seus próprios eventos em memória local e, em intervalos definidos, agrega o valor acumulado em um contador compartilhado usando uma única operação atômica.
Em outros casos, vale particionar os dados para que diferentes grupos de threads trabalhem sobre partes distintas do estado, reduzindo a chance de colisão em estruturas centrais. Também pode fazer sentido trocar compartilhamento de estado por passagem de mensagens, de forma que atualizações críticas ocorram em um único lugar, alimentado por filas ou canais.
O ponto central é que CAS não é um objetivo em si. Ele é uma ferramenta. Em muitos cenários, um lock bem colocado, uma estrutura concorrente de alto nível ou um modelo de passagem de mensagens oferecem um equilíbrio melhor entre simplicidade, previsibilidade e performance do que um algoritmo lock-free escrito à mão.
Conclusão
Compare-and-Swap é uma daquelas peças de infraestrutura que quase nunca aparecem no topo do diagrama, mas que definem o comportamento real de sistemas concorrentes. Em .NET, ele está presente em Interlocked, em coleções concorrentes e em diversas primitivas de sincronização, muitas vezes sem chamar atenção. Quando o sistema está em um regime de baixa contenção, CAS é um aliado poderoso. Ele permite reduzir o uso de locks, diminuir a latência e explorar melhor o paralelismo.
À medida que o número de threads cresce e a disputa por determinados valores se intensifica, a situação muda. O que era ferramenta passa a se comportar como gargalo. A CPU sobe, o throughput não acompanha e pequenas funções ligadas a Compare-and-Swap começam a dominar o perfil de execução. Entender esse movimento, reconhecer os sinais e saber quando vale insistir em CAS ou quando vale simplificar o desenho é parte importante do trabalho de quem constrói serviços .NET de alta performance.
Se você já viu uma aplicação ficar mais lenta ao aumentar o número de threads, já encontrou Interlocked no topo do profiler ou já se deparou com bugs estranhos de concorrência em estruturas lock-free, essa discussão não é abstrata. Ela diz respeito às decisões de arquitetura que você precisa tomar na próxima refatoração ou no próximo projeto que precisa escalar.
Insights & Takeaways
- Compare-and-Swap é a operação atômica que sustenta boa parte das primitivas de sincronização modernas, inclusive em .NET.
- O padrão de CAS loop funciona muito bem em baixa contenção, mas pode consumir uma quantidade significativa de CPU quando muitas threads disputam o mesmo dado.
- O problema ABA mostra que, em estruturas lock-free sofisticadas, comparar apenas o valor atual não é suficiente, exigindo técnicas como versionamento ou “tagged pointers”.
- Em cenários de alta contenção, soluções mais simples, como
lock, particionamento de dados e contadores locais com agregação periódica, muitas vezes entregam melhor equilíbrio entre complexidade e performance. - Medir o comportamento do sistema, em vez de assumir que “lock-free é sempre mais rápido”, é fundamental para decidir quando CAS é aliado e quando ele se torna o gargalo.