Como a IA me Ajudou a Documentar mais de 100 Projetos em uma Tarde
Como documentei mais de 20 solutions e 100 projetos .NET sem documentação usando IA: higiene do código, prompts por etapa, Mermaid e ontologia do domínio.
Neste artigo · 9 seções
Chegou no meu colo um daqueles desafios que todo Tech Lead conhece bem: assumir um projeto complexo, crítico para o negócio, e descobrir que a única documentação disponível é... o próprio código. Mais de 20 soluções, 100+ projetos, sistema de alta performance, e eu precisava absorver tudo rapidamente para conseguir apoiar minha equipe.
O Cenário: Quando a Realidade Bate na Porta
Trabalho com sistemas web há mais de 15 anos. Já passei por tudo: ASP.NET Full Framework 2.5, Web Forms, MVC, Web API, gRPC, jQuery, Angular, React, WebSockets. Sempre acostumado com o usuário acessando pelo navegador, seja ele o saudoso IE6 ou o moderno Chrome.
Mas dessa vez era diferente. O sistema tinha uma parte client-side em Windows Forms - sim, aqueles sistemas instalados na máquina que eu não mexia há mais de 15 anos. E fazia total sentido para o contexto: mercado financeiro, onde cada microssegundo importa e muito. Estamos falando de sistemas para bancos e empresas do mercado financeiro, onde existe uma equipe específica responsável pelo deploy em cada máquina de operador.
Do lado server-side, eram microserviços se comunicando com o client através de rede privada, além de outros serviços integrados via protocolo FIX. O sistema é responsável por de trocas de ativos - não estamos falando do day-trade do seu primo que investe mil reais e perde 30%. São trades profissionais, movimentando valores que eu nunca sonhei ganhar na vida.
A Busca por um "SIM"
Quando o projeto chegou pra mim, fiz o de sempre pra juntar as infos. Como alguns materiais ainda estavam entrando no fluxo interno — documentação, especificação e testes — e a galera estava em onboarding. Pra não travar, fui atrás de um ‘SIM’ que destravasse o caminho. Consegui: acesso ao código-fonte. Com isso em mãos, segui tocando o trabalho enquanto o resto ia sendo plugado.
Essa situação é mais comum do que gostaríamos. Sempre aparece um espertinho dizendo que "a documentação é o código". E é uma verdade absoluta, o problema é a complexidade de extrair contexto de mais de 250 mil linhas de código espalhadas por diversos repositórios e pastas diferentes.
Extraindo Contexto com Inteligência Artificial
Quando falamos de IA, o que importa para ser assertivo é a qualidade da informação para gerar contexto. Não adianta alimentar a IA com dados ruins - o resultado sempre ficará a desejar e ela alucina mais facilmente. No meu caso, eu tinha a informação mais fiel e bruta possível: o próprio código.
Para entender como aproveitei isso, preciso explicar rapidamente como um LLM trabalha. As LLMs que usamos não têm memória persistente. Toda vez que enviamos um prompt, o chat manda o prompt atual junto com TODO o conteúdo da conversa anterior. Quanto mais sofisticada a LLM, mais eficiente é esse processo de manutenção de contexto.
Higienizando os Dados
Como disse, precisamos de informações de qualidade. Mesmo com as soluções corretas, podemos ter dados que poluem nosso contexto. Fiz um trabalho braçal, mas necessário: abri todas as solutions e validei se não havia projetos marcados como "unload" ou arquivos "removed". Esses status informam ao compilador para ignorar na hora do build, então são apenas ruído.
Removi todos os arquivos binários - basta apagar as pastas "bin" e "obj", que são arquivos gerados pelo compilador. Como tinha diversos repositórios e precisava gerar contexto do produto inteiro, criei uma pasta única e copiei todos os repositórios para lá, removendo pastas ocultas como .git. Mantive apenas os arquivos necessários.
Agora tinha uma "super solution" pronta para a IA.
O Prompt que Mudou Tudo
Abri meu editor favorito com boa integração de IA - no meu caso, usando a integração com Claude . Criei então o prompt mais importante de todo o processo:
Analise cada pasta que contem um arquivo .sln, para cada Solution encontrada entenda o proposito da solution, e crie um documento README.md no diretório "DOCUMENTATION" na raiz da pasta, contendo de forma rica e detalhada da Visão geral do projeto, arquitetura da solution, responsabilidade, dependências, configurações, fluxo de dados, se o projeto é um pacote NuGet.

Faça isso para cada projeto no mesmo arquivo README.md

No termino crie um documento de arquitetura referente a todos os projetos, deve ser detalhado com Resumo executivo, desenhos de arquitetura, Diagrama de sequencia, fluxogramas, inventario de software, stack de tecnologia por camada, arquitetura de implantação, padrões de integração, Arquitetura de segurança, Considerações de escalabilidade, Recuperação de Desastres, Monitoramento e Observabilidade, Diretrizes de Desenvolvimento, Melhorias Futuras, e Conclusão.

Todos os diagramas e desenhos devem ser usado o Mermaid, sem exceção.

Analise solution por solution, ao terminar a criação do readme.md de um projeto, me pergunte se pode passar para o próximo.
Se você leu o prompt, sim é isso mesmo que você pensou - eu estava abusando da IA! O Terminator irá vir na minha residência, e eu serei o primeiro a virar "camiseta de saudades" pela IA!
Brincadeiras à parte, vou explicar minha intenção nesse prompt. Minha ideia era extrair o máximo de informação. Como não conhecia nada do produto, quanto mais informação conseguisse extrair, melhor. Confesso que estava um pouco cético e com medo de alucinação, mas o resultado foi melhor do que esperava.
Na primeira parte do prompt, estou pedindo para ele localizar todas as .sln, criando uma memória de qual pasta está cada Solution. Com isso, peço para fazer uma análise e extrair documentação detalhada com informações relevantes para qualquer arquiteto e desenvolvedor. No trecho seguinte, falo o que quero no final - um documento maior e mais denso. Por que solicitei isso só no final? Para ele acumular contexto de cada projeto.
Especifiquei que todos os desenhos devem ser feitos com Mermaid - uma ferramenta de "diagram as code". Isso é extremamente importante, pois como o gráfico é feito com texto, fica barato para criar um novo chat ou usar esse conhecimento em outra LLM, gerando uma memória persistente.
No fim, peço para ele "ir com calma", fazer um por um. Isso me permite validar o output e corrigir ou adicionar mais instruções ao prompt se necessário.
Resultados Surpreendentes
O resultado foi muito bom. Ele conseguiu identificar vendors externos como Bloomberg, e outros, criou muitos gráficos de sequência detalhados, e mapeou toda a arquitetura sem alucinações significativas.
Mas ainda não acabou - aqui vai a cereja do bolo. Como a única informação que eu tinha era que teríamos algoritmos de trade, usei a Perplexity.ai para fazer um laboratório (uma busca profunda) para entender o que são esses algoritmos.
Segue um trecho da análise, para notar a riqueza:
O VWAP (Volume Weighted Average Price) constitui um dos algoritmos mais amplamente utilizados na indústria financeira, projetado para executar ordens em linha com o perfil de volume histórico ou previsto do mercado. A implementação técnica divide ordens grandes em tranches menores, submetendo cada porção proporcionalmente ao volume observado ou predito, mascarando efetivamente a presença de grandes transações no mercado. O algoritmo calcula continuamente o VWAP em tempo real usando a fórmula: VWAP = Σ(Preço × Volume) / Σ(Volume), ajustando dinamicamente o ritmo de execução baseado em desvios do benchmark.

O TWAP (Time Weighted Average Price) adota uma abordagem fundamentalmente diferente, distribuindo ordens uniformemente ao longo de um período específico, independentemente das condições de volume do mercado. Esta estratégia é particularmente efetiva em instrumentos com baixa liquidez ou padrões de volume imprevisíveis, onde métodos baseados em volume podem resultar em execução inadequada. A implementação técnica quebra ordens em lotes de tamanho igual submetidos em intervalos regulares, frequentemente com randomização de ±10% no timing e tamanho para evitar detecção.

O algoritmo POV (Percentage of Volume) oferece flexibilidade dinâmica, ajustando a taxa de execução baseada em um percentual pré-definido do volume de mercado em tempo real. Quando o volume de mercado aumenta, o algoritmo acelera a execução; quando diminui, reduz correspondentemente a atividade. Esta abordagem é especialmente útil para ordens que precisam ser completadas dentro de janelas temporais específicas, mas podem tolerar variações na velocidade de execução baseadas em condições de liquidez.
A Cereja do Bolo: Ontologia Automatizada
Com isso, extraí a análise inteira como markdown, coloquei na pasta e usei essa análise de mercado junto com o contexto acumulado do prompt anterior. Mandei o seguinte prompt:
Extrair a Ontologia dos projetos e do arquivo @analisedealgoritimo.md, crie duas tabelas:
Tabela 1 (Glossário): Uma lista de Conceitos e suas Descrições.
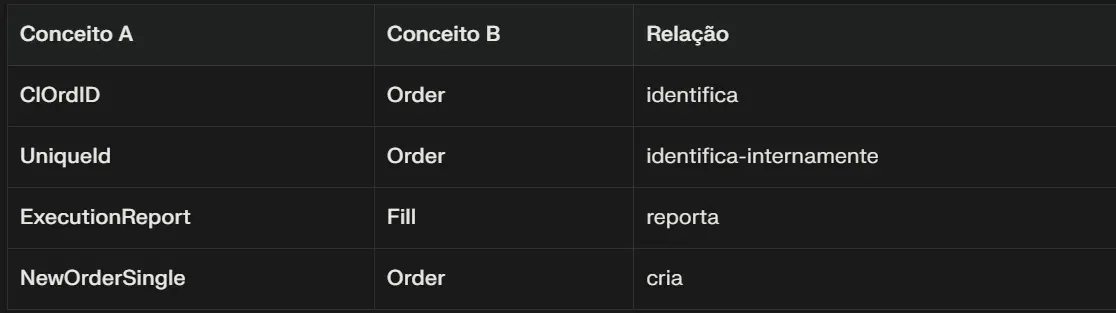
Tabela 2 (Relações): Uma tabela com as colunas Conceito A, Conceito B e a Relação entre eles.
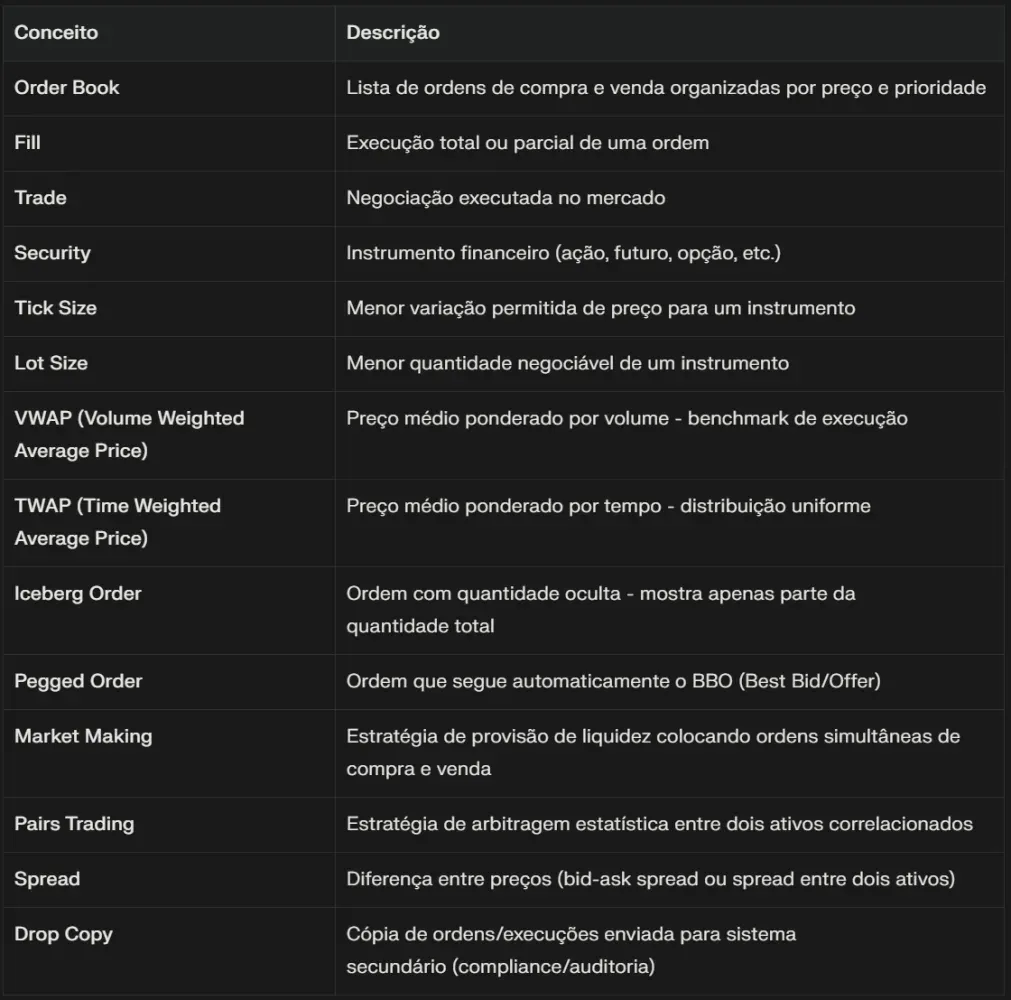
Esse simples e poderoso prompt me extraiu uma lista rica com termos e suas descrições - isso daria um trabalho gigantesco para criar esse glossário, que irá me ajudar a criar uma linguagem ubíqua.
Um breve trecho do glossário:
A segunda tabela me gera relacionamentos entre elas, facilitando meu entendimento, e nem preciso dizer que inteligência para mim é inteligência para IA:
Conclusão
Em uma única tarde, consegui extrair documentação completa de um sistema complexo que levaria semanas para ser produzida manualmente. A IA não substituiu meu conhecimento técnico - ela potencializou minha capacidade de absorver e organizar informações de forma estruturada.
O segredo está na qualidade dos dados fornecidos e na estruturação adequada dos prompts. Quando bem direcionada, a IA se torna uma ferramenta poderosa para acelerar processos que tradicionalmente consomem muito tempo, permitindo que nos foquemos nas decisões estratégicas e arquiteturais que realmente fazem diferença.
Com esse processo, criei uma memória persistida com os arquivos markdown. Quando preciso dar contexto para a LLM, não preciso mais analisar tudo novamente - é só entregar esses arquivos. Isso economiza muitos tokens e deixa as respostas mais assertivas. A experiência me mostrou que, mais do que temer a substituição pela IA, devemos abraçar sua capacidade de nos tornar mais eficientes e estratégicos em nossas funções.
Insights & Takeaways
-
Qualidade dos dados é fundamental: Higienizar o código removendo arquivos desnecessários melhora significativamente a qualidade do contexto gerado pela IA.
-
Prompts estruturados geram melhores resultados: Dividir o trabalho em etapas e solicitar validação entre elas reduz alucinações e permite correções direcionais.
-
Mermaid como padrão para diagramas: Usar "diagram as code" mantém a documentação versionável e reutilizável em diferentes contextos.
-
Ontologia automatizada acelera o aprendizado: Extrair glossários e relacionamentos entre conceitos cria rapidamente uma linguagem ubíqua para a equipe.
-
Contexto acumulado é poderoso: Manter uma única conversa permite que a IA construa conhecimento progressivo sobre todo o sistema, não apenas partes isoladas.